Big-O là thứ ai học lập trình cũng gặp, học thuộc để qua phỏng vấn, rồi quên — vì nó được dạy như một khái niệm toán học trừu tượng: giới hạn, hằng số, ký hiệu Θ và Ω. Nhưng với một kỹ sư đang viết code chạy production, Big-O không trừu tượng chút nào. Nó là câu trả lời cho một câu hỏi rất cụ thể: khi dữ liệu lớn gấp đôi, code của tôi chậm đi bao nhiêu lần? Và câu hỏi đó thì đo được.
Đây là bài mở đầu loạt "Giải thuật nâng cao: đo thật độ phức tạp và đánh đổi". Thay vì chứng minh giới hạn, cả loạt này sẽ chạy code thật trong container, đo bằng time.Since, và đọc con số. Bài đầu tiên làm điều căn bản nhất: biến Big-O từ công thức trên giấy thành thứ bạn nhìn thấy khi N tăng.
Mẹo đọc Big-O: phép thử "nhân đôi N"
Có một cách cực kỳ thực dụng để nhận ra độ phức tạp của một đoạn code mà không cần giải toán: cho N gấp đôi, xem thời gian nhân lên mấy lần. Mỗi lớp độ phức tạp có một "dấu vân tay" riêng:
| Độ phức tạp | N gấp đôi → thời gian | Ví dụ điển hình |
|---|---|---|
| O(log n) | gần như không đổi (+ một hằng số) | binary search |
| O(n) | × 2 | duyệt mảng một lần |
| O(n log n) | × ~2,1 | sort tốt (quicksort/mergesort) |
| O(n²) | × 4 | hai vòng lặp lồng nhau |
Lý do rất trực giác: nếu thời gian tỉ lệ với n, thì 2n cho gấp đôi. Nếu tỉ lệ với n², thì (2n)² = 4n² — gấp bốn. Còn log(2n) = log n + 1 — chỉ cộng thêm một hằng số, nên gần như phẳng. Ba hàm dưới đây mỗi hàm đại diện một lớp:
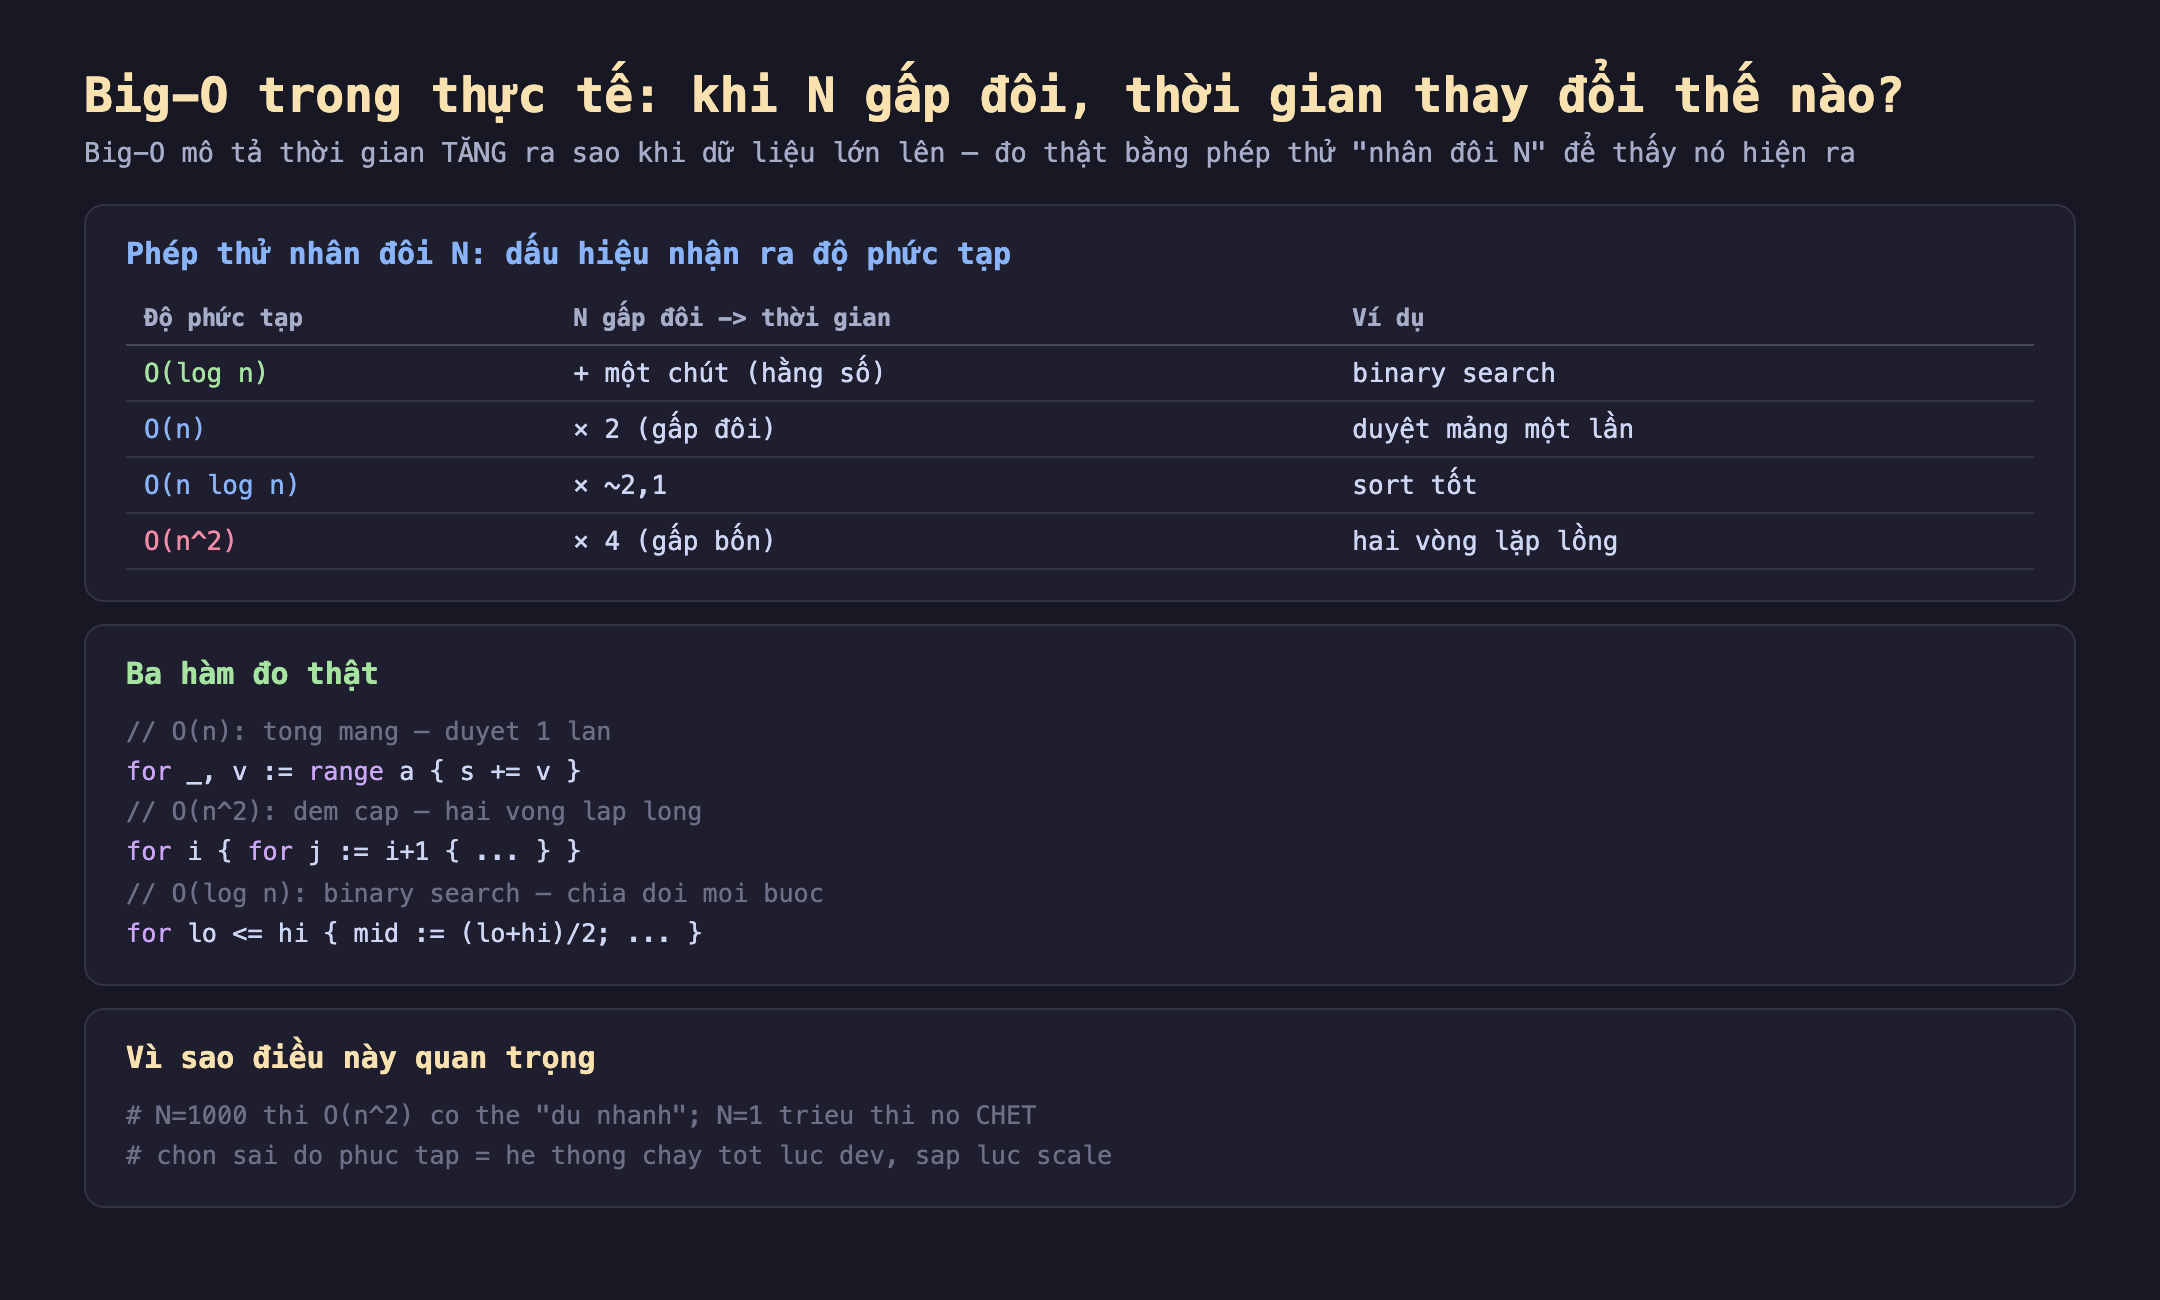
Hình 1: Phép thử nhân đôi N và ba hàm đại diện. linearSum duyệt một lần (O(n)); countPairs hai vòng lặp lồng (O(n²)); binSearch chia đôi mỗi bước (O(log n)). Big-O mô tả thời gian TĂNG ra sao khi N lớn lên, không phải thời gian tuyệt đối.
// O(n): duyet 1 lan
func linearSum(a []int) int {
	s := 0
	for _, v := range a {
		s += v
	}
	return s
}

// O(n^2): hai vong lap long nhau
func countPairs(a []int) int {
	c := 0
	for i := 0; i < len(a); i++ {
		for j := i + 1; j < len(a); j++ {
			if (a[i]+a[j])%2 == 0 {
				c++
			}
		}
	}
	return c
}

// O(log n): chia doi khong gian tim kiem moi buoc
func binSearch(a []int, target int) int {
	lo, hi := 0, len(a)-1
	for lo <= hi {
		mid := (lo + hi) / 2
		if a[mid] == target {
			return mid
		}
		if a[mid] < target {
			lo = mid + 1
		} else {
			hi = mid - 1
		}
	}
	return -1
}
Đo thật: cho N gấp đôi bốn lần
Mình chạy cả ba hàm trên các N = 1.000, 2.000, 4.000, 8.000 trong go-lab (Go 1.23). linearSum quá nhanh nên lặp 1.000 lần lấy trung bình; countPairs chạy một lần (đã đủ lâu); binSearch lặp 1 triệu lần vì một lần tìm chỉ tốn vài chục nano giây. Đây là kết quả thật:
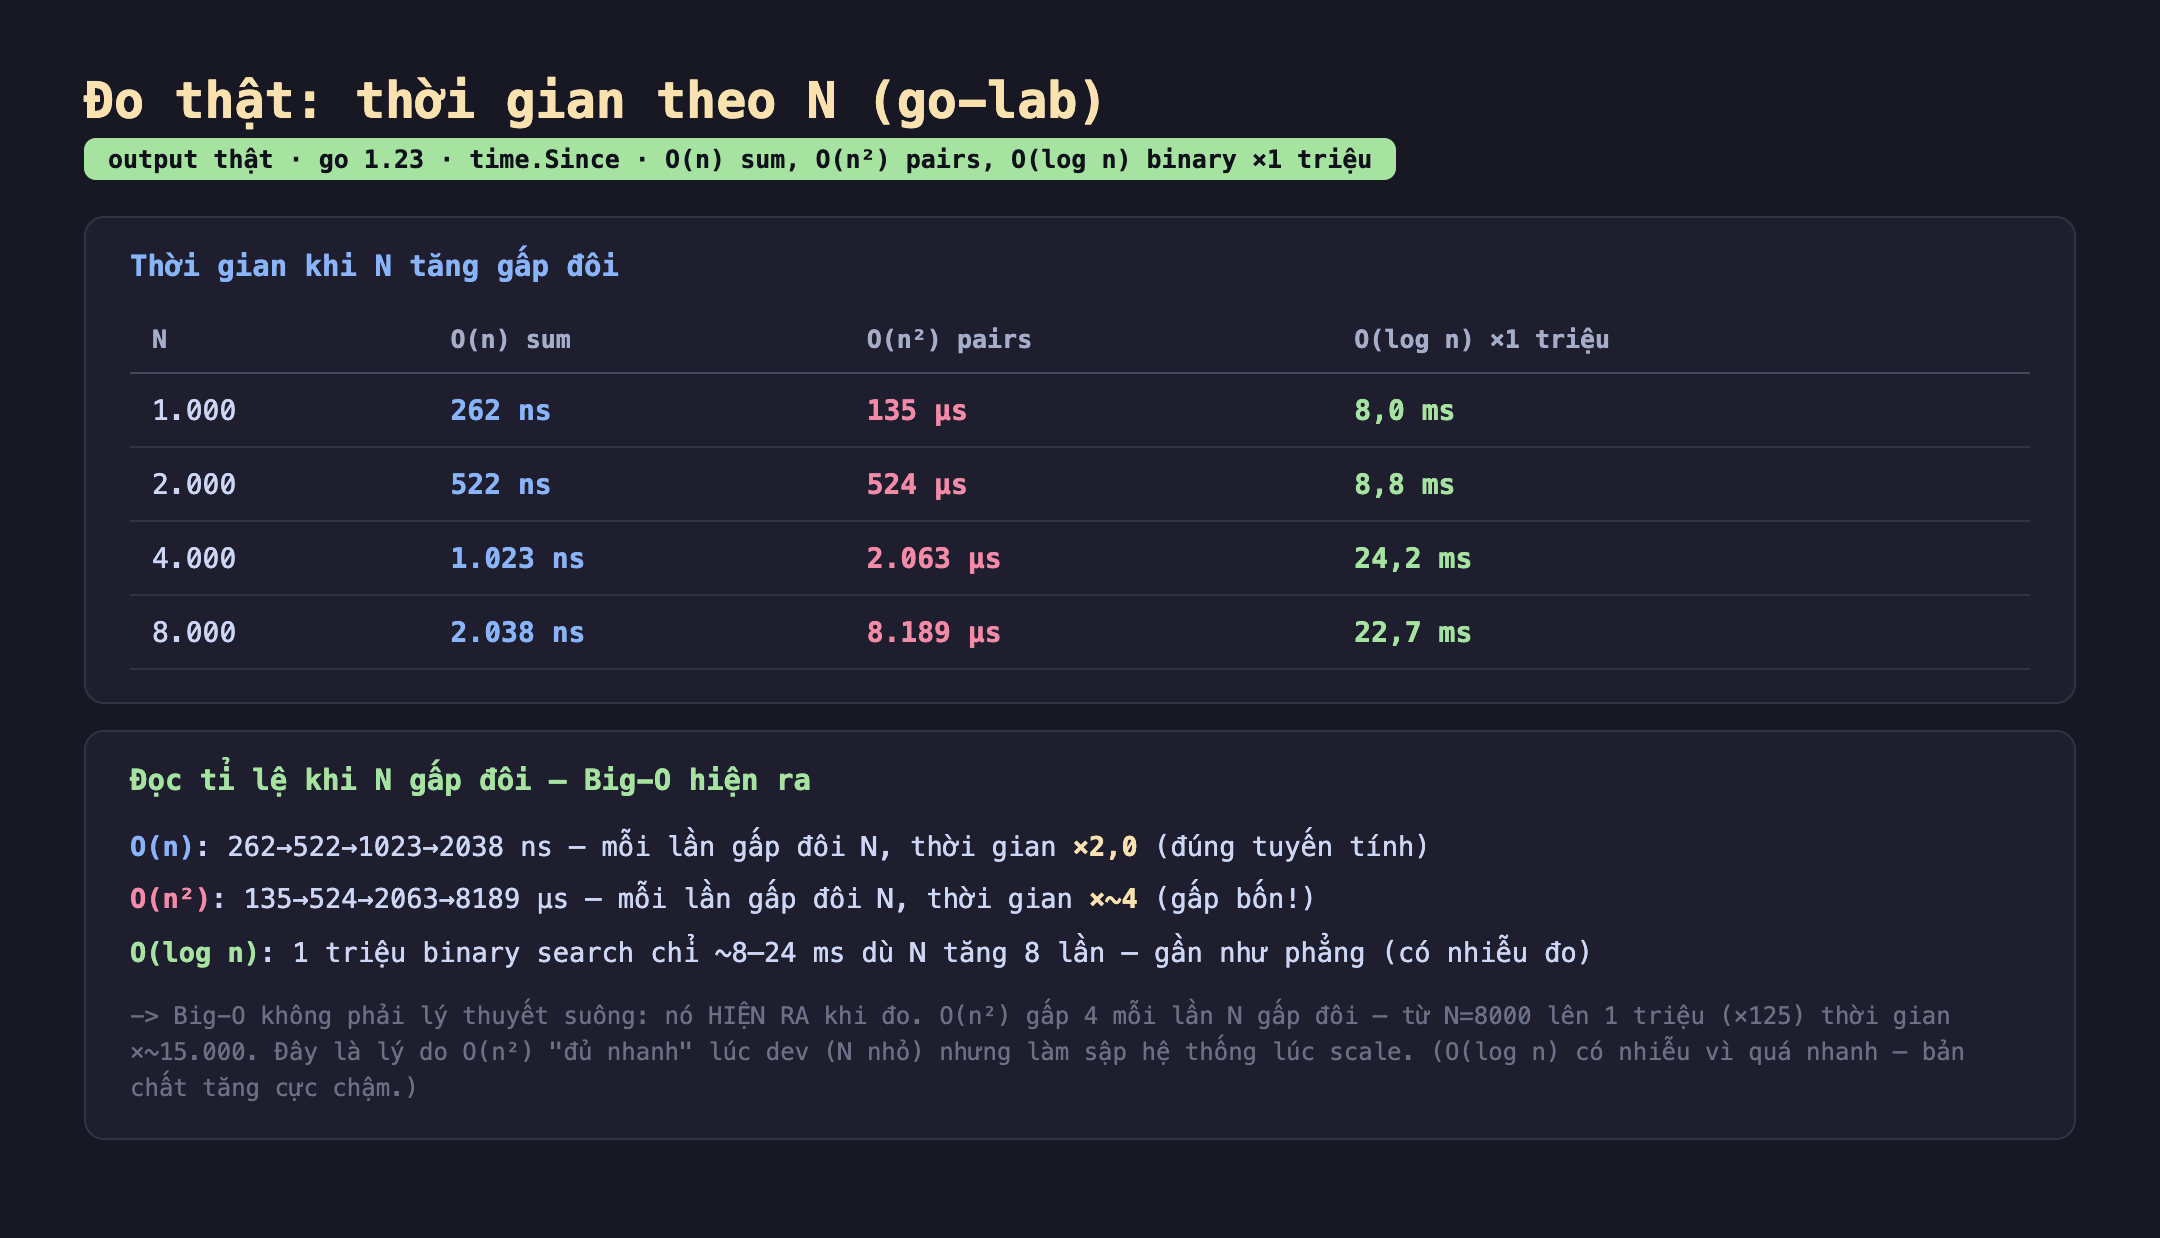
Hình 2: Kết quả thật. O(n) nhân đúng 2,0 mỗi lần N gấp đôi; O(n²) nhân ~4; O(log n) gần như đứng yên dù N tăng 8 lần (có nhiễu đo vì quá nhanh).
Đọc từng dòng, Big-O hiện ra rõ mồn một:
- O(n) —
linearSum: 262 → 522 → 1.023 → 2.038 ns. Mỗi lần N gấp đôi, thời gian ×2,0. Tuyến tính chính xác đến mức gần như hoàn hảo. - O(n²) —
countPairs: 135 → 524 → 2.063 → 8.189 µs. Mỗi lần N gấp đôi, thời gian ×~4 (3,9 → 3,9 → 3,97). Đây là dấu vân tay không thể nhầm của độ phức tạp bậc hai. - O(log n) —
binSearch: 1 triệu lần tìm chỉ tốn ~8–24 ms dù N tăng 8 lần. Về lý thuyếtlog₂(8000)/log₂(1000) ≈ 1,3lần, nhưng ở quy mô vài chục nano giây mỗi lần tìm, nhiễu đo (cache, phân nhánh, GC) át mất tín hiệu. Điều rõ ràng: nó gần như phẳng so với hai hàm kia.
Để thấy sức nặng của con số: chú ý rằng ở N=8.000, countPairs chạy một lần mất 8.189 µs — còn binSearch chạy một triệu lần cũng chỉ ~22 ms. Khác biệt độ phức tạp lớn hơn mọi hằng số.
Vì sao điều này quan trọng với code production
Phép ngoại suy mới là chỗ Big-O trở nên đáng sợ. countPairs nhân 4 mỗi lần N gấp đôi. Từ N=8.000 lên N=1.000.000 là tăng 125 lần — tức khoảng 7 lần gấp đôi (2⁷=128). Mỗi lần gấp đôi ×4, nên thời gian tăng 4⁷ ≈ 16.000 lần. Cái hàm chạy 8 mili giây ở N=8.000 sẽ mất khoảng 130 giây ở một triệu phần tử.
Đây chính là cơ chế của một lớp sự cố production kinh điển: code chạy mượt suốt quá trình phát triển (N nhỏ, O(n²) vẫn dưới mili giây), qua hết test, lên production — rồi khi dữ liệu thật lớn dần, nó đột ngột "sập" mà không ai đổi một dòng code nào. Thủ phạm là một vòng lặp lồng ai đó viết lúc N còn nhỏ. Hàm O(n) thì tăng 125 lần — khó chịu nhưng sống được; hàm O(n²) tăng 16.000 lần — chết hẳn.
Đánh đổi cần cân nhắc
Big-O bỏ qua hằng số — và hằng số có thể thắng ở N nhỏ. O(n²) với vòng lặp cực gọn có thể nhanh hơn O(n log n) với hằng số lớn khi N nhỏ. Thư viện sort thực tế (kể cả sort của Go) chuyển sang insertion sort O(n²) cho mảng con nhỏ chính vì lý do này. Big-O cho bạn biết cái gì thắng khi N đủ lớn, không phải ở mọi N. Luôn hỏi "N thực tế của tôi lớn cỡ nào?" trước khi tối ưu.
Đo một lần ở một N không nói lên độ phức tạp. Một con số đơn lẻ (ví dụ "hàm này chạy 5 ms") vô nghĩa về mặt scale. Chỉ khi đo ở nhiều N và nhìn tỉ lệ tăng bạn mới biết đó là O(n), O(n log n) hay O(n²). Phép thử nhân đôi chính là cách biến một phép đo thành một chẩn đoán độ phức tạp.
Nhiễu đo là có thật, nhất là với hàm nhanh. O(log n) của mình cho kết quả không sạch (8→24→22 ms) vì mỗi thao tác quá nhanh, cache và dự đoán nhánh chi phối. Khi đo hàm nhanh, phải lặp nhiều lần lấy trung bình (mình lặp 1 triệu lần binary search), và vẫn phải chấp nhận rằng tín hiệu có thể bị nhiễu lấn át — báo cáo trung thực thay vì làm đẹp số liệu.
Ba ý mang về
- Big-O là thứ đo được, không chỉ là toán. Chạy thật trong go-lab: khi N gấp đôi, O(n) cho ×2,0 và O(n²) cho ×~4 — đọc tỉ lệ đó là nhận ra ngay độ phức tạp của code mình.
- Phép thử nhân đôi N là công cụ chẩn đoán thực dụng. Không cần giải giới hạn: cho N gấp đôi, xem thời gian nhân mấy lần. ×2 là tuyến tính, ×4 là bậc hai, gần như không đổi là logarit.
- Khác biệt độ phức tạp áp đảo mọi hằng số khi scale. O(n²) nhân 4 mỗi lần gấp đôi, nên từ N=8.000 lên 1 triệu nó chậm đi ~16.000 lần — lý do một hàm chạy ngon lúc dev lại làm sập hệ thống lúc dữ liệu lớn.
Nguồn
- Go docs — package time: https://pkg.go.dev/time
- Wikipedia — Big O notation: https://en.wikipedia.org/wiki/Big_O_notation
- Go source — sort/sort.go (ngưỡng chuyển insertion sort): https://cs.opensource.google/go/go/+/refs/tags/go1.23.0:src/sort/sort.go
Phần sau ta đo đối đầu linear search và binary search: vì sao một thuật toán O(log n) thắng tuyệt đối ở mảng lớn, nhưng chi phí sắp xếp trước và yếu tố cache khiến linear search không phải lúc nào cũng thua như lý thuyết nói.
