Suốt mười một bài, loạt "Giải thuật nâng cao" này theo đuổi đúng một nguyên tắc: không nói lý thuyết suông, mà đo thật trong Docker. Mỗi bài chạy code Go trong container go-lab, đo bằng time.Since, và đọc con số — kể cả khi con số đó ngược với trực giác hay khiêm tốn hơn kỳ vọng. Bài cuối này không giới thiệu khái niệm mới. Nó làm một việc: nối tất cả lại thành một khung tư duy bạn có thể dùng khi đứng trước một lựa chọn thiết kế thật.
Toàn bộ số liệu đã đo, trên một bảng
Trước khi rút ra nguyên tắc, hãy nhìn lại bức tranh toàn cảnh — mọi con số dưới đây đều là đo thật, đã chụp trong từng bài:
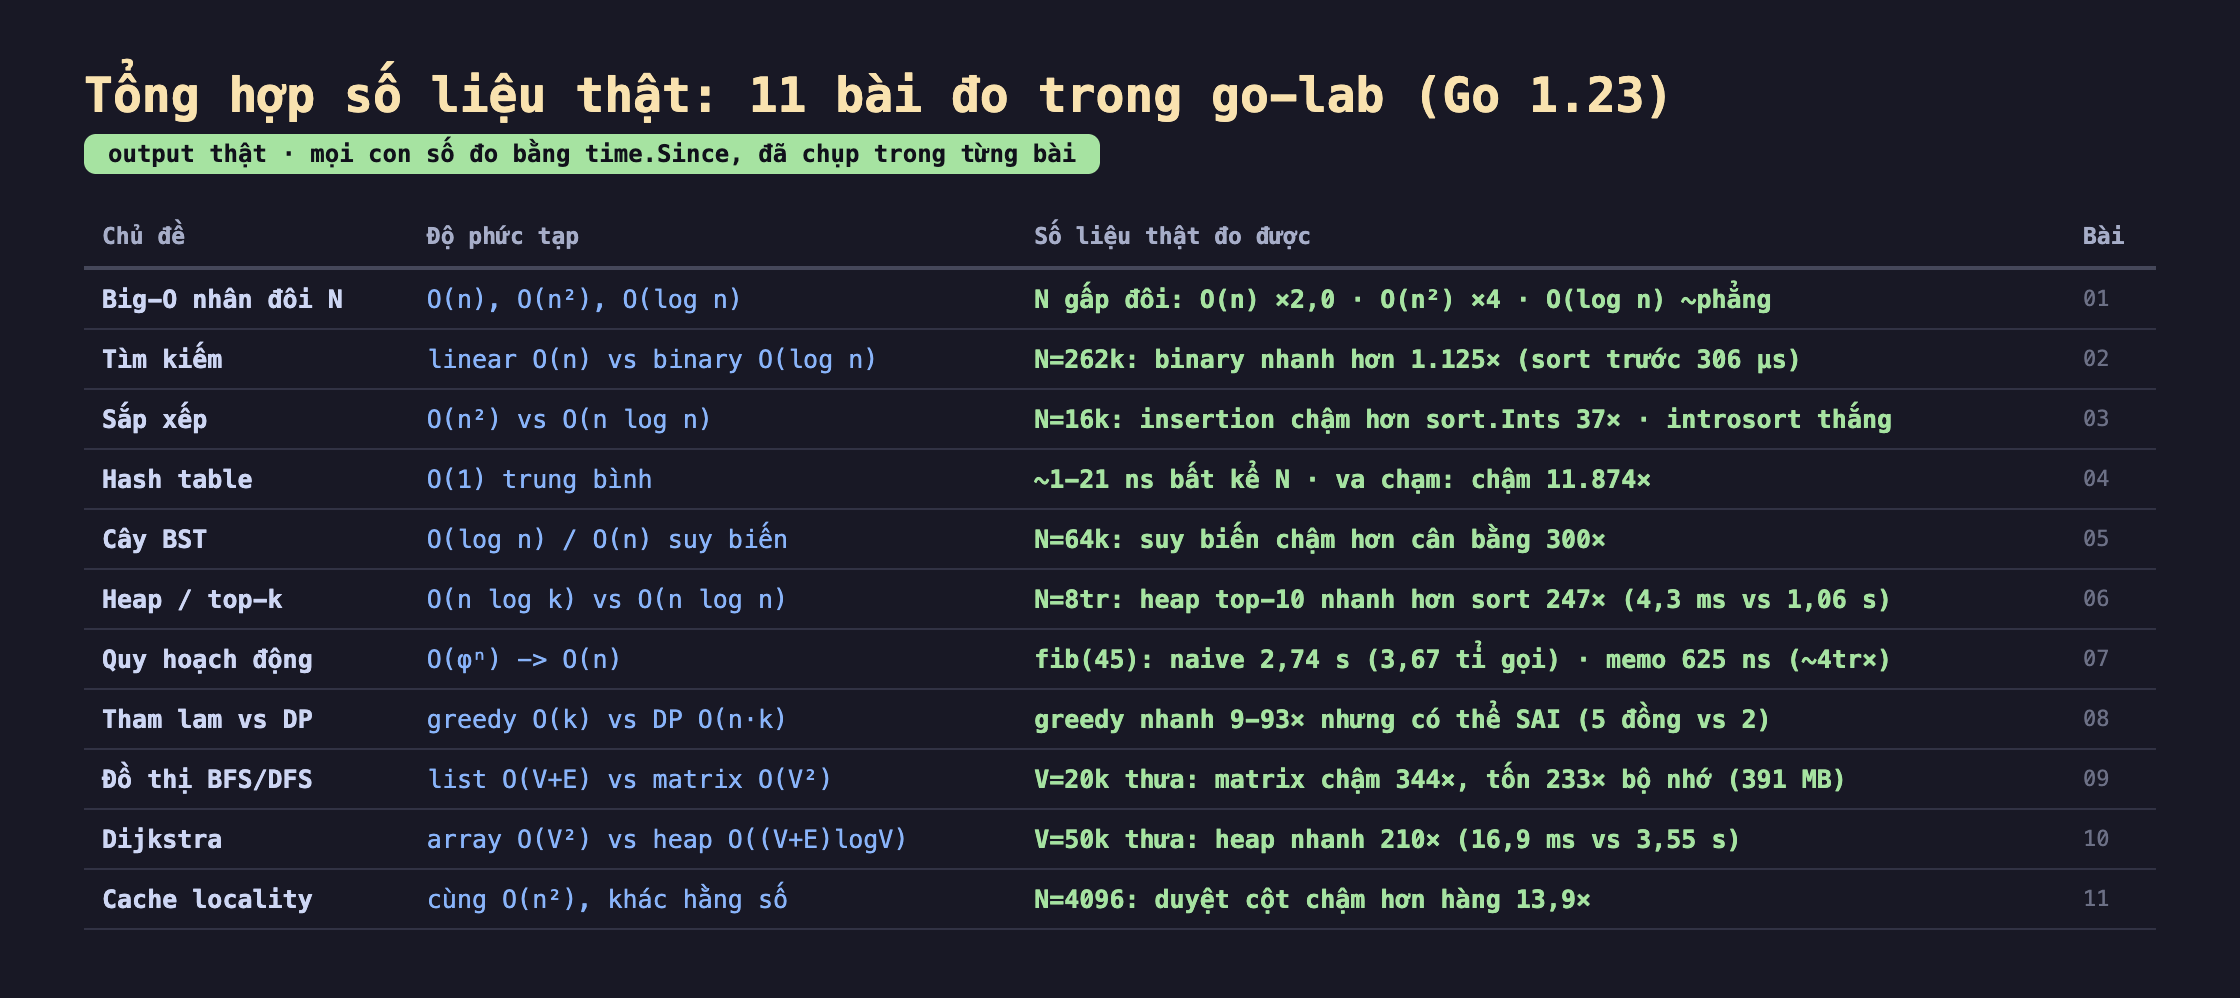
Hình 1: Mười một phép đo thật trong go-lab. Mỗi dòng là một chủ đề, độ phức tạp, và con số đo được — bằng chứng cho mọi kết luận của loạt bài.
Nhìn bảng này, ba kiểu "khoảng cách" hiện ra rõ: khoảng cách khổng lồ do chọn sai độ phức tạp (247×, 210×, 4 triệu×), khoảng cách đáng kể do chi tiết thực thi trong cùng một lớp Big-O (14×, cache), và những chỗ mà "tối ưu" lý thuyết không tạo khác biệt (AoS/SoA ~1,0×). Khung tư duy nằm ở chỗ biết mình đang ở kiểu nào.
Checklist: cần gì thì dùng gì
Phần lớn quyết định thiết kế bắt đầu từ câu hỏi "tôi cần làm gì với dữ liệu này?". Dưới đây là ánh xạ từ nhu cầu sang cấu trúc, rút ra từ các bài đã đo:
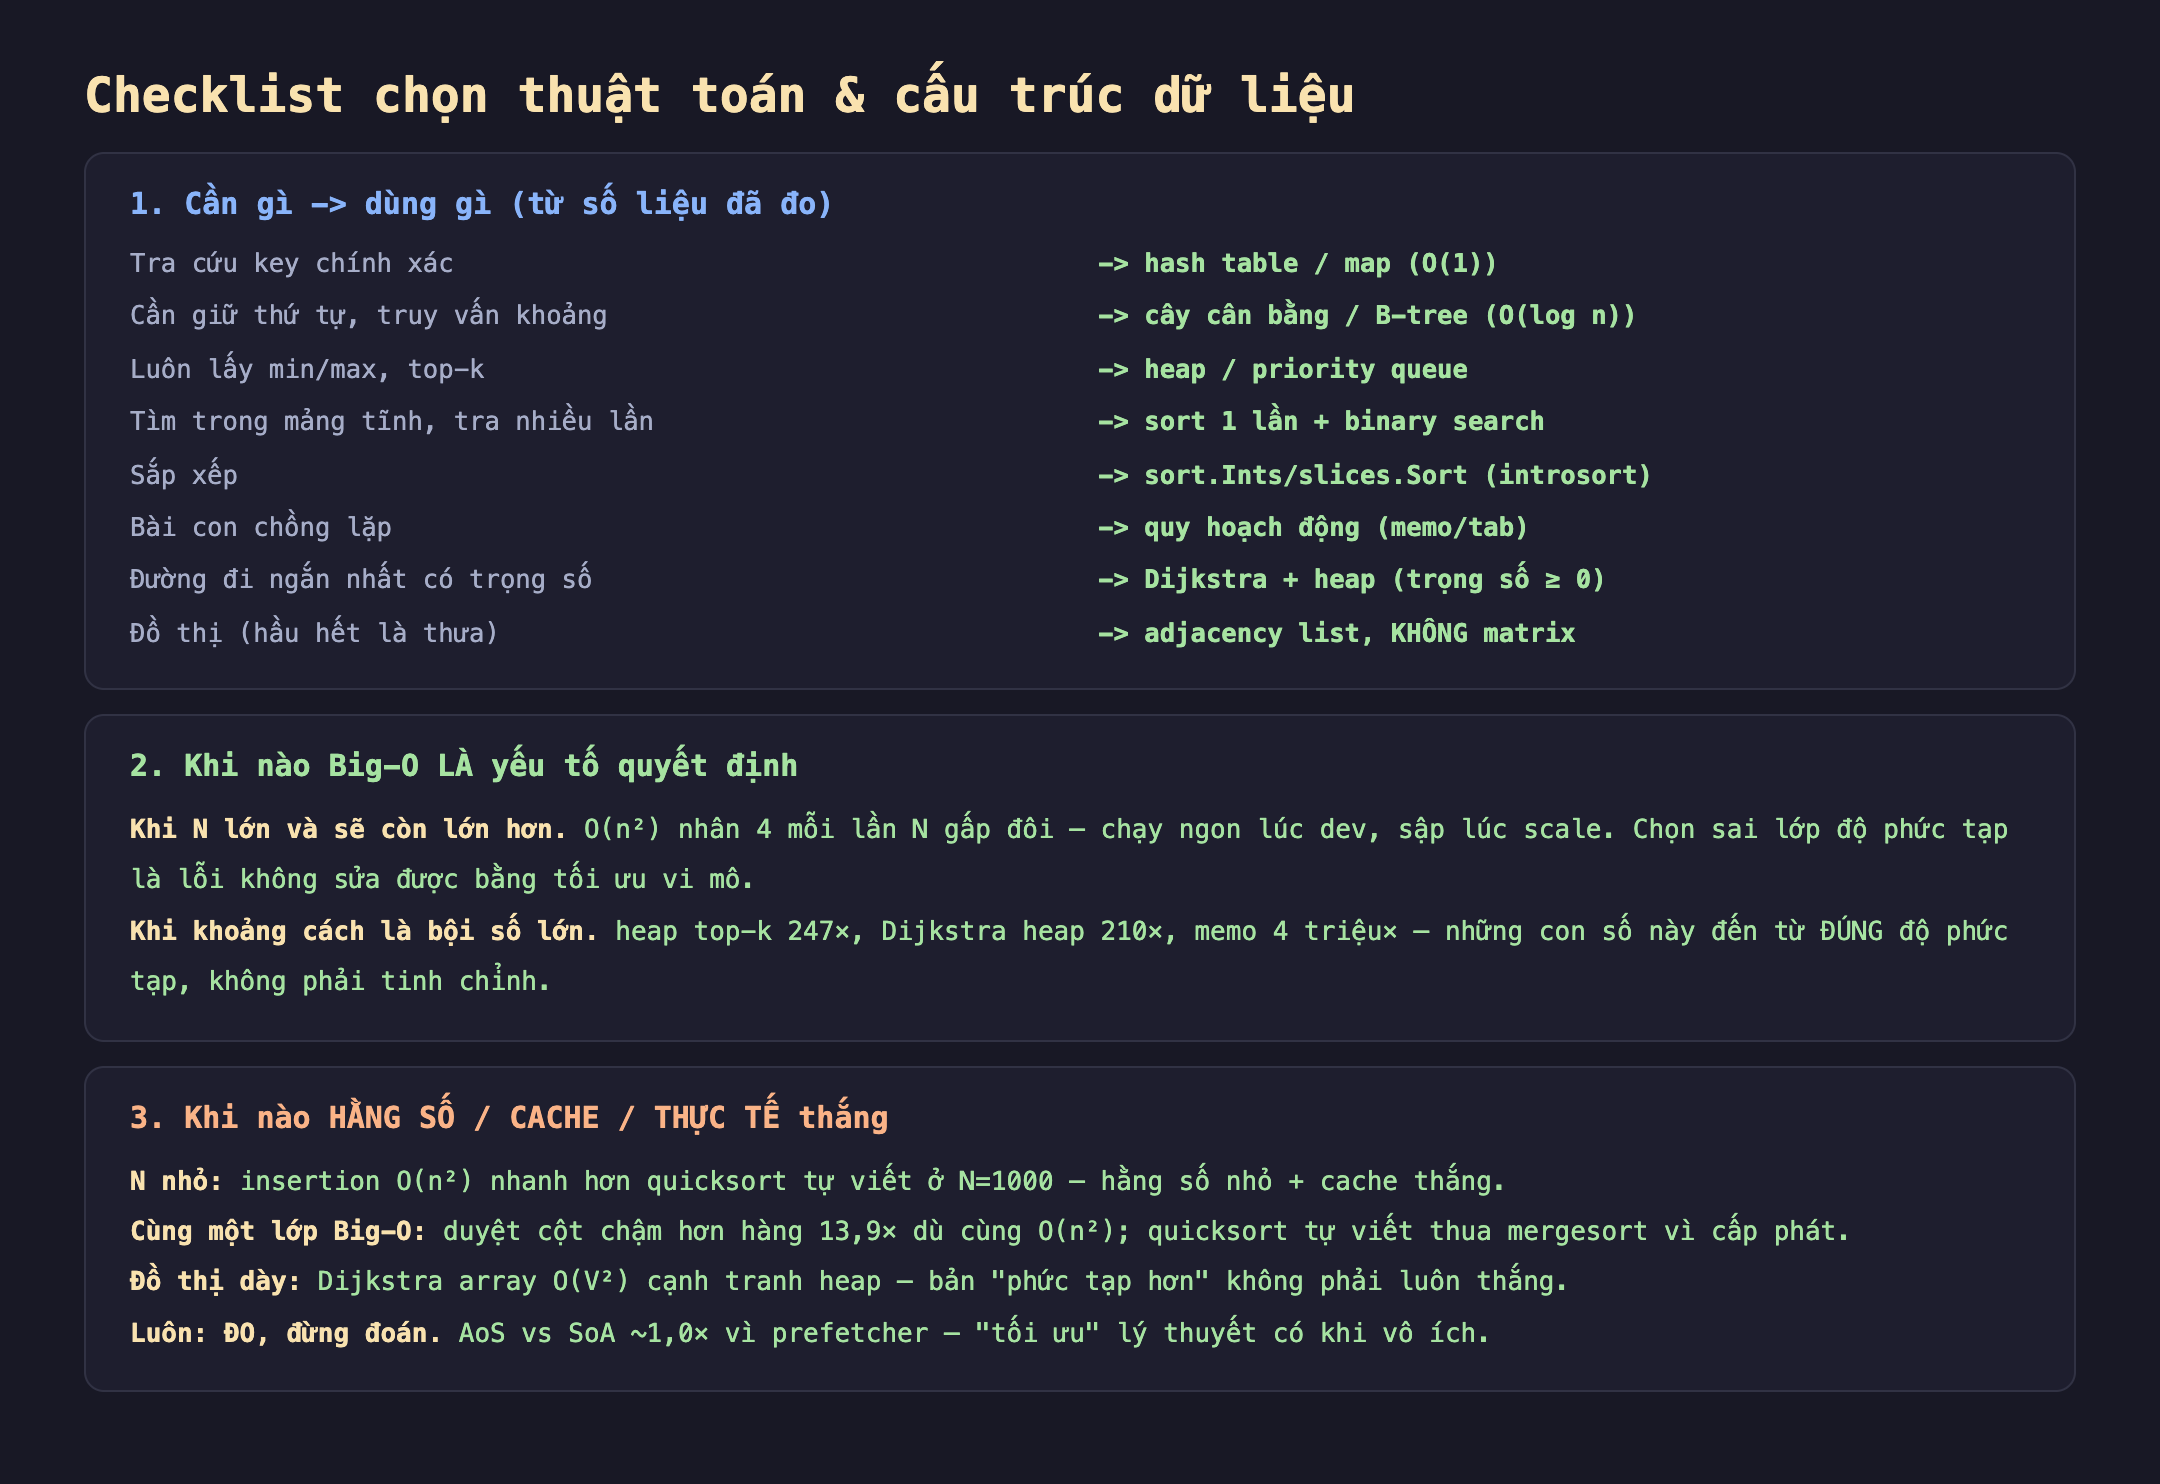
Hình 2: Khung quyết định ba phần — ánh xạ nhu cầu sang cấu trúc, dấu hiệu Big-O là yếu tố sống còn, và dấu hiệu hằng số/cache/thực tế mới là thứ quyết định.
Ba câu hỏi lọc nhanh: (1) tôi cần tra cứu, giữ thứ tự, hay luôn lấy cực trị? (2) dữ liệu tĩnh hay thay đổi liên tục? (3) N hiện tại và N tương lai lớn cỡ nào? Trả lời xong ba câu này, lựa chọn cấu trúc gần như tự hiện ra.
Khi nào Big-O là yếu tố sống còn
Big-O quyết định khi hai điều kiện gặp nhau: N lớn, và sẽ còn lớn hơn. Đây là lúc chênh lệch độ phức tạp áp đảo mọi thứ khác:
- Heap top-k nhanh hơn full sort 247 lần ở N=8 triệu (bài 6) — không phải nhờ tinh chỉnh, mà nhờ O(n log k) thay vì O(n log n).
- Dijkstra với heap nhanh hơn bản mảng 210 lần ở V=50.000 (bài 10) — O((V+E) log V) thay vì O(V²).
- Memoization nhanh hơn đệ quy ngây thơ 4 triệu lần cho fib(45) (bài 7) — O(n) thay vì O(φⁿ).
Dấu hiệu nhận ra: khi một hàm "chạy ngon lúc dev nhưng chậm dần một cách bí ẩn khi dữ liệu lớn", gần như luôn là lỗi độ phức tạp — một O(n²) nấp trong vòng lặp lồng, một đệ quy không memo. Không tối ưu vi mô nào cứu được; phải đổi thuật toán. Bài 1 cho công cụ chẩn đoán: phép thử nhân đôi N — cho N gấp đôi, xem thời gian nhân mấy lần (×2 là O(n), ×4 là O(n²)).
Khi nào thực tế thắng Big-O
Nhưng Big-O không phải lúc nào cũng là câu trả lời — và đây là phần loạt bài này nhấn mạnh nhất, vì nó hay bị bỏ qua:
- N nhỏ: hằng số thắng. Insertion sort O(n²) nhanh hơn quicksort tự viết ở N=1.000 (bài 3) vì hằng số nhỏ và thân thiện cache. Mọi thư viện sort đều chuyển sang insertion cho mảng con nhỏ.
- Cùng một lớp Big-O: cache và cài đặt quyết định. Duyệt mảng theo cột chậm hơn theo hàng 13,9 lần dù cùng O(n²) (bài 11); quicksort tự viết thua mergesort vì cấp phát bộ nhớ (bài 3). Big-O bỏ qua hằng số; bạn thì không được.
- "Phức tạp hơn" không phải luôn thắng. Trên đồ thị dày, Dijkstra bản mảng O(V²) cạnh tranh ngang bản heap O((V+E) log V) (bài 10) — thêm thừa số log có khi là gánh nặng.
- Luôn đo, đừng đoán. AoS vs SoA cho ~1,0× (bài 11) vì prefetcher của CPU đã xử lý stride cố định — một "tối ưu" sách giáo khoa hóa ra vô ích trên phần cứng thật.
Và những đánh đổi không nằm trong Big-O
Vài quyết định quan trọng nhất của loạt bài hoàn toàn không phải về tốc độ:
- Đúng vs nhanh: greedy nhanh hơn DP 9-93 lần nhưng cho kết quả sai với hệ mệnh giá lệch (bài 8). Nhanh mà sai thì vô dụng.
- Trung bình vs đảm bảo: hash table O(1) trung bình nhưng sụp về O(n) khi va chạm nhiều (chậm 11.874×, bài 4); BST O(log n) suy biến thành O(n) khi chèn dữ liệu đã sắp (chậm 300×, bài 5). Luôn hỏi "trường hợp xấu nhất là gì, và nó có xảy ra với dữ liệu của tôi không?".
- Thời gian vs bộ nhớ: ma trận kề cho tra cạnh O(1) nhưng tốn O(V²) bộ nhớ — 391 MB cho đồ thị 20.000 đỉnh (bài 9); tabulation tiết kiệm bộ nhớ hơn memoization dù cùng O(n) thời gian (bài 7).
- Khả năng vs chi phí: cây cho truy vấn theo thứ tự mà hash không làm được (bài 5); dùng cây là trả O(log n) để đổi lấy khả năng đó.
Ba ý mang về
- Chọn đúng Big-O trước — đó là thứ không sửa được sau. Khi N lớn và còn lớn hơn, chênh lệch độ phức tạp áp đảo mọi thứ: heap top-k 247×, Dijkstra 210×, memo 4 triệu×. Dùng phép thử nhân đôi N để chẩn đoán, và nhận ra "chậm dần bí ẩn khi scale" gần như luôn là lỗi độ phức tạp.
- Trong cùng một lớp Big-O, thực tế mới quyết định. Hằng số, cache locality và cài đặt tạo khác biệt tới 14× (duyệt cột vs hàng) mà Big-O không thấy; ở N nhỏ, O(n²) có thể thắng O(n log n). Và "phức tạp hơn" không phải luôn nhanh hơn — đo trên phần cứng thật, đừng đoán.
- Nhiều quyết định quan trọng không nằm trong Big-O. Đúng vs nhanh (greedy có thể sai), trung bình vs xấu nhất (hash/BST suy biến), thời gian vs bộ nhớ, khả năng vs chi phí. Một kỹ sư giỏi hỏi đủ bốn câu đó, không chỉ "cái nào nhanh hơn trên giấy".
Nguồn
- CLRS — Introduction to Algorithms: https://mitpress.mit.edu/9780262046305/introduction-to-algorithms/
- Go docs — sort, container/heap, package time: https://pkg.go.dev/sort
- Ulrich Drepper — What Every Programmer Should Know About Memory: https://people.freebsd.org/~lstewart/articles/cpumemory.pdf
