Mười phần trước đo từng cơ chế một. Phần này đặt chúng cạnh nhau dưới tải: 10.000 kết nối, 100 vòng fan-out 1 KB, và thay vì nhìn p50, nhìn p99.9 và max, nơi 1.000 mẫu tệ nhất trong một triệu sống. Ba thủ phạm quen thuộc của đuôi độ trễ realtime là client chậm, garbage collector, và thiếu CPU. Với mỗi thủ phạm, bài đo trạng thái "trước" đúng như code thường được viết, rồi đo lại sau từng cách sửa, để biết cách nào thật sự đưa đuôi về và cách nào chỉ dời nó đi chỗ khác. Có một kết quả đi ngược trực giác: chỉnh GC bằng GOGC làm p99 tốt hơn và p99.9 tệ hơn cùng lúc.
p50 nói dối, p99.9 nói thật
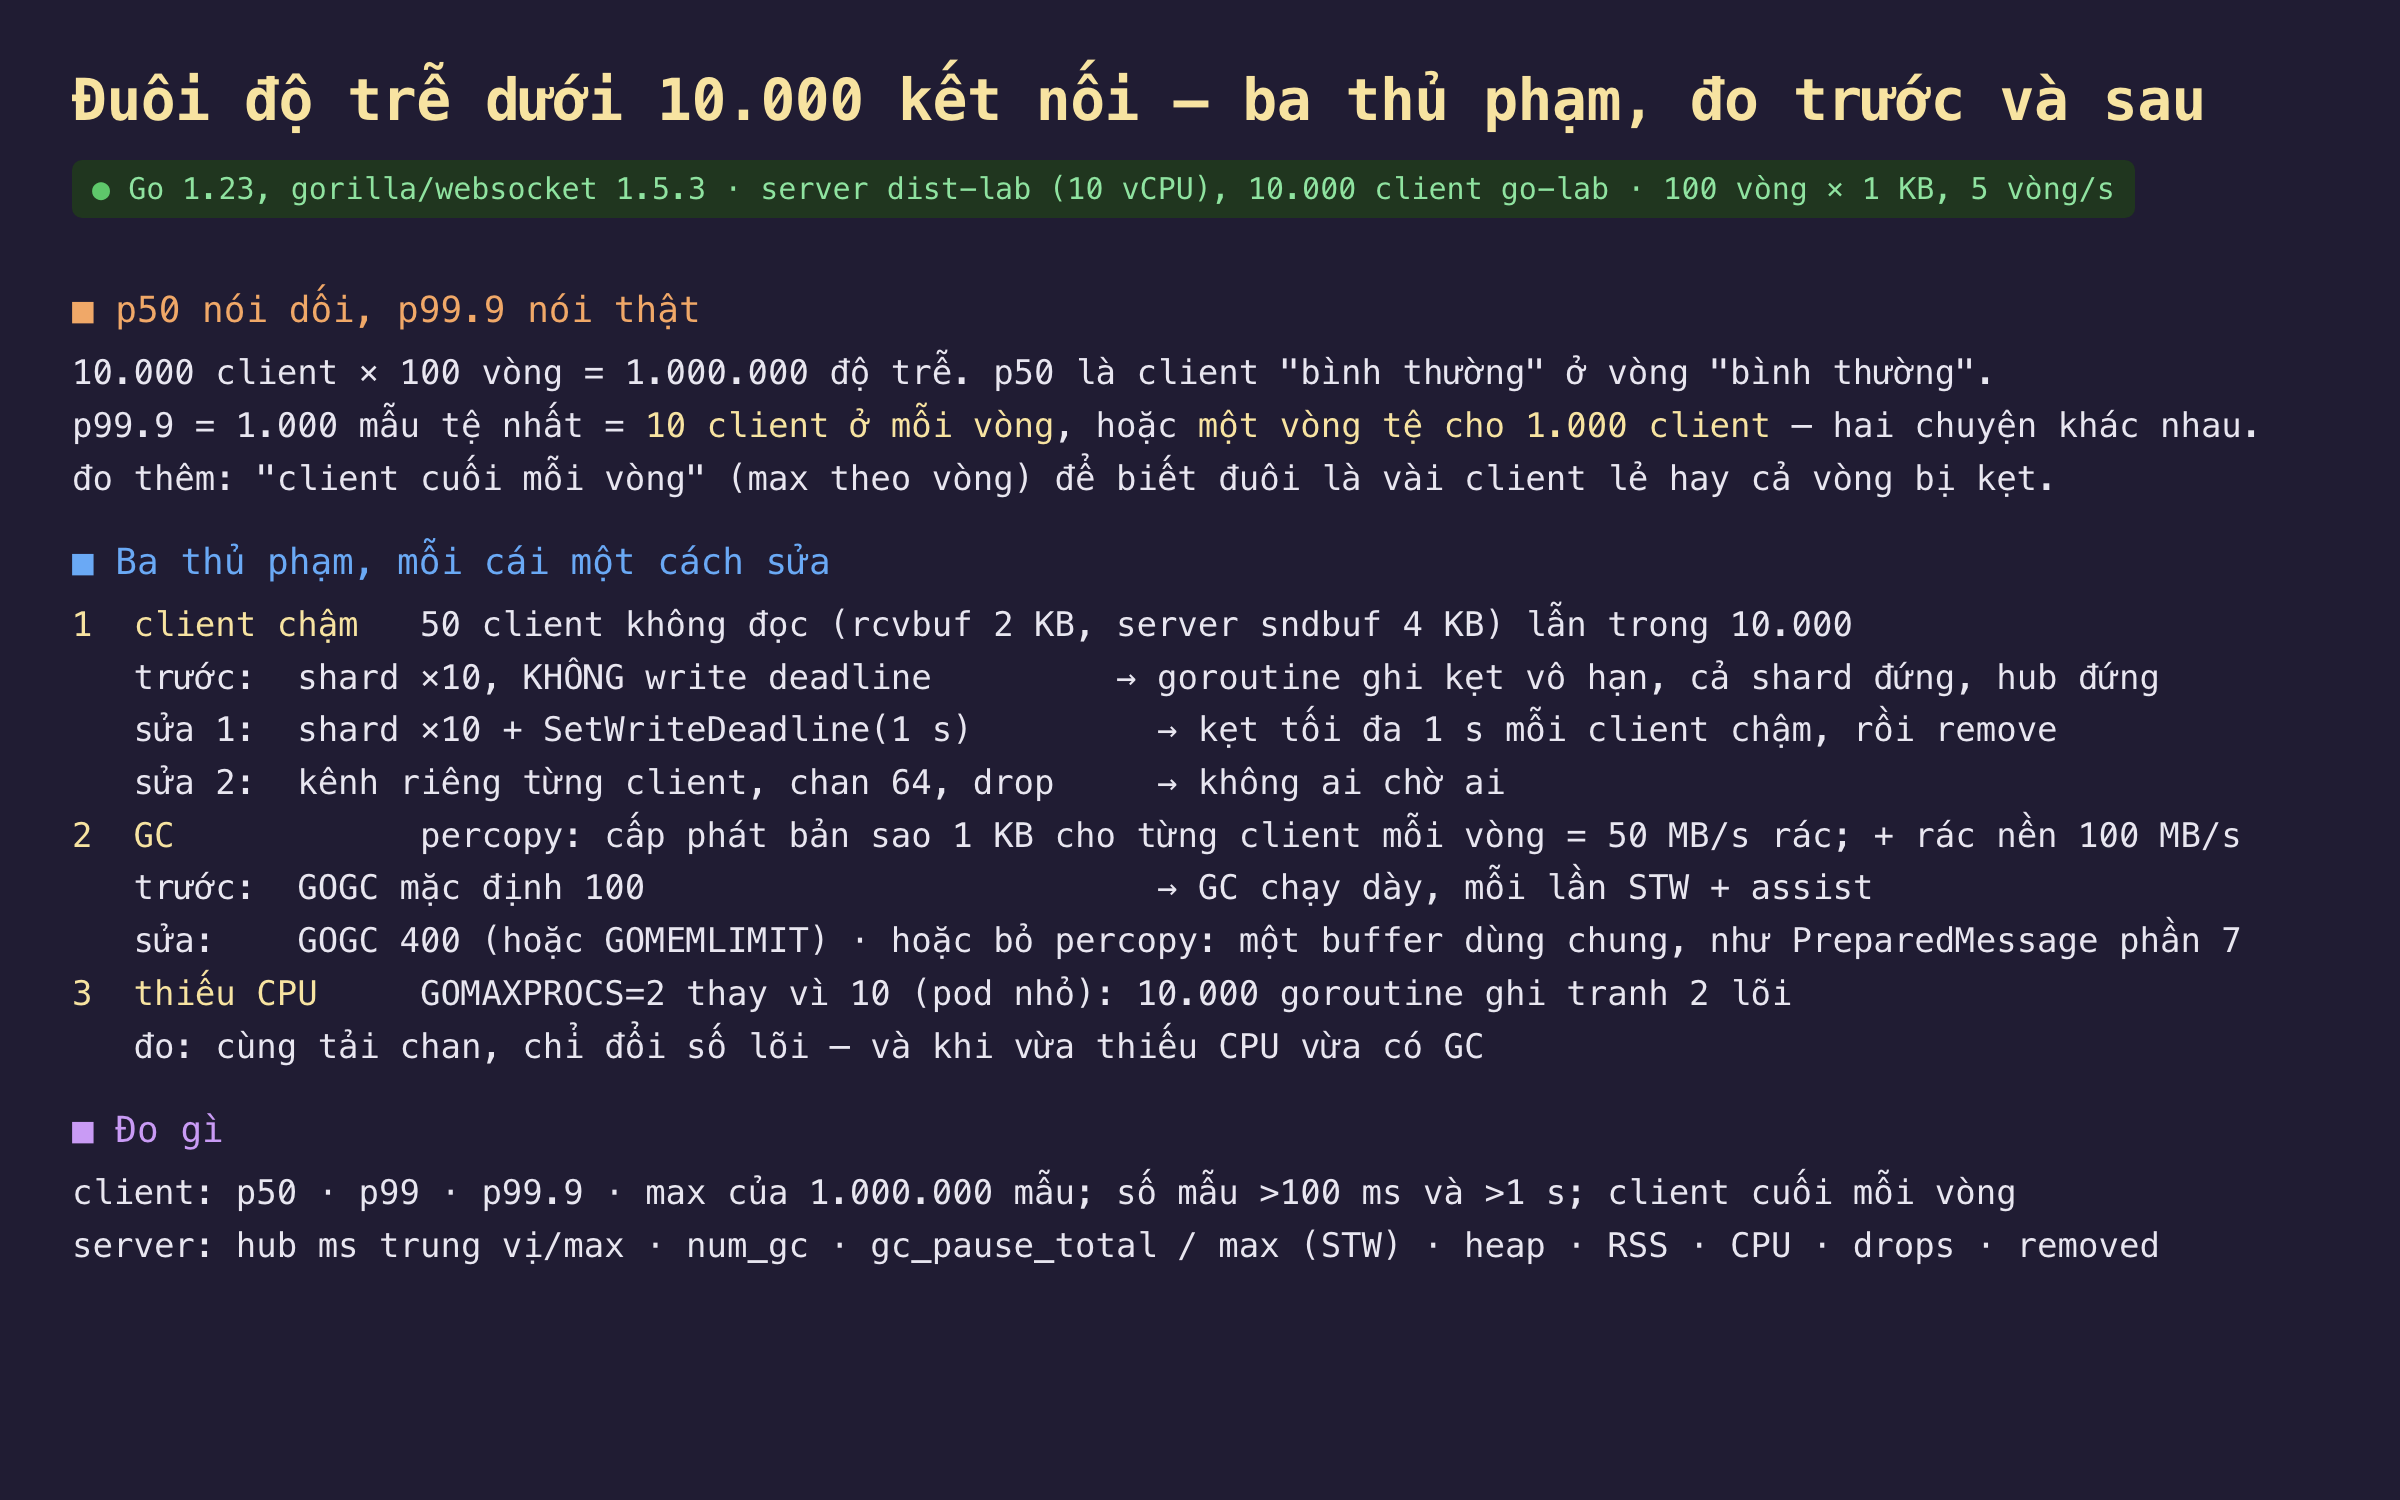
Hình 1: Vì sao cần p99.9 và client cuối mỗi vòng, ba thủ phạm của đuôi độ trễ, và cách sửa cho từng cái.
10.000 client nhân 100 vòng là 1.000.000 độ trễ. p50 là một client bình thường ở một vòng bình thường và hầu như không đổi trong cả bài. p99.9 là 1.000 mẫu tệ nhất, và chúng có thể là hai thứ rất khác nhau: 10 client lẻ ở mỗi vòng, hoặc một vòng tệ cho 1.000 client. Để phân biệt, bài đo thêm "client cuối mỗi vòng", tức độ trễ lớn nhất trong từng vòng, và đếm số mẫu vượt 100 ms và 1 giây. Server đo riêng thời gian hub phát xong, số lần GC, tổng và max thời gian dừng thế giới, heap, RSS, CPU.
Ba thủ phạm, mỗi cái với trạng thái trước và cách sửa. Client chậm: 50 client trong 10.000 không bao giờ đọc, bộ đệm nhận 2 KB phía client và bộ đệm gửi 4 KB phía server như phần 7; trước là fan-out chia 10 shard không có write deadline, cách nhiều code production đang chạy; sửa 1 là thêm SetWriteDeadline 1 giây; sửa 2 là kênh riêng cho từng client với drop khi đầy. GC: "percopy" cấp phát một bản sao 1 KB cho từng client mỗi vòng, tức 10 MB rác mỗi vòng hay 50 MB/s, mô phỏng việc encode riêng cho từng client; cộng rác nền 100 MB/s từ phần còn lại của ứng dụng; trước là GOGC mặc định 100; sửa 1 là GOGC 400; sửa 2 là bỏ cấp phát trong đường nóng, dùng một buffer chung. Thiếu CPU: GOMAXPROCS=2 thay vì 10, như một pod nhỏ, cùng tải.
Đo thật: 59 ms, 20 giây, 5 giây, 148 ms, 251 ms
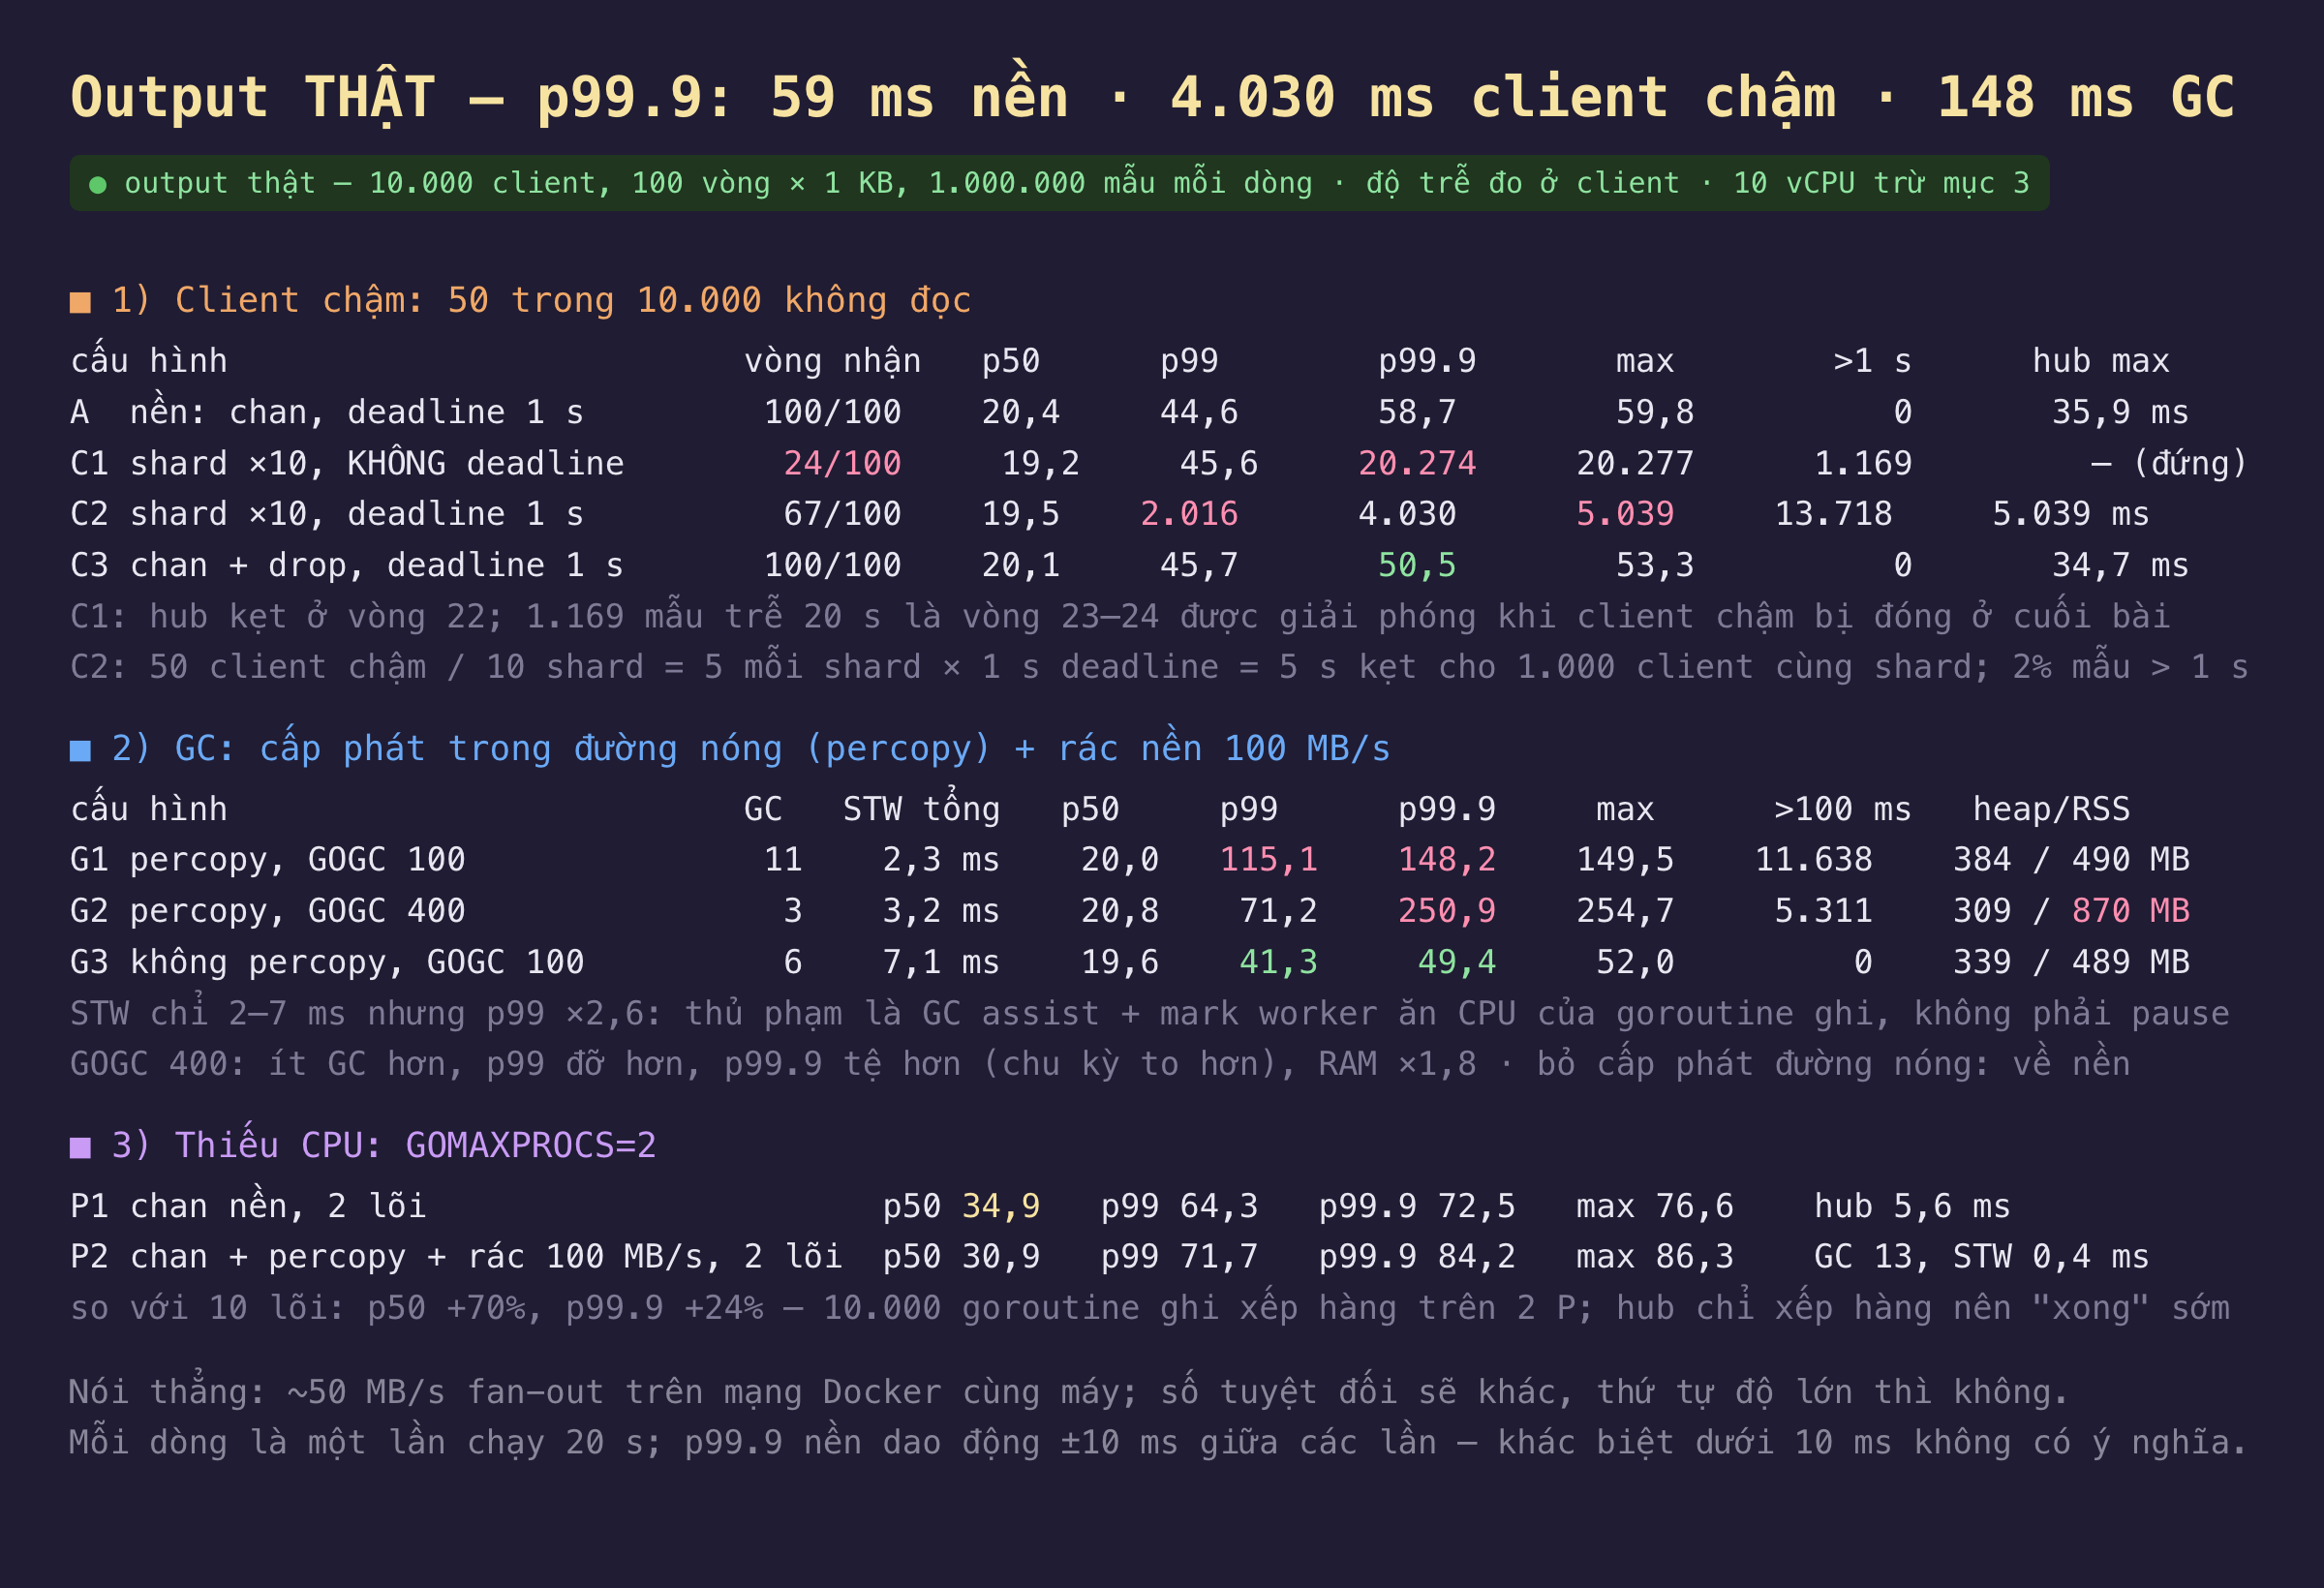
Hình 2: Đuôi độ trễ trước và sau từng cách sửa cho client chậm, GC và thiếu CPU; mỗi dòng là một triệu mẫu.
| kịch bản | p50 | p99 | p99.9 | max | mẫu > 1 s |
|---|---|---|---|---|---|
| A nền: chan, deadline 1 s | 20,4 | 44,6 | 58,7 | 59,8 | 0 |
| C1 50 client chậm, shard, không deadline | 19,2 | 45,6 | 20.274 | 20.277 | 1.169, hub đứng ở vòng 22 |
| C2 50 client chậm, shard, deadline 1 s | 19,5 | 2.016 | 4.030 | 5.039 | 13.718 |
| C3 50 client chậm, chan + drop | 20,1 | 45,7 | 50,5 | 53,3 | 0 |
| G1 percopy + rác 100 MB/s, GOGC 100 | 20,0 | 115,1 | 148,2 | 149,5 | 0 |
| G2 percopy + rác, GOGC 400 | 20,8 | 71,2 | 250,9 | 254,7 | 0 |
| G3 không percopy, rác 100 MB/s | 19,6 | 41,3 | 49,4 | 52,0 | 0 |
| P1 GOMAXPROCS=2 | 34,9 | 64,3 | 72,5 | 76,6 | 0 |
| P2 GOMAXPROCS=2 + percopy + rác | 30,9 | 71,7 | 84,2 | 86,3 | 0 |
Nền: p99.9 là 59 ms, và p50 gần như không nhúc nhích suốt bài. Kênh riêng từng client, write deadline 1 giây, không client chậm, không rác: p50 20,4 ms, p99 44,6, p99.9 58,7, max 59,8, không mẫu nào quá 100 ms. Đây là mốc. Trong tám kịch bản còn lại, p50 nằm trong 19 đến 21 ms ở mọi cấu hình 10 lõi; nếu dashboard chỉ vẽ p50, mọi sự cố dưới đây đều vô hình.
Client chậm không deadline: hub đứng ở vòng 22, và 1.169 mẫu trễ 20 giây. 50 client không đọc trong shard fan-out không có SetWriteDeadline: sau 22 vòng, cả 10 shard đều kẹt vì mỗi shard có 5 client chậm, hub không bao giờ hoàn thành vòng 23, và 9.950 client khoẻ ngừng nhận. Con số 20.274 ms ở p99.9 là đoạn kết của câu chuyện: khi bài đo đóng các client chậm ở giây cuối, các goroutine ghi được giải phóng, shard chạy tiếp, và vòng 23 và 24 tới 1.169 client sau 20 giây chờ. Trên production không có ai đóng hộ; hub đứng cho tới khi client chậm tự biến mất, tức có thể là mãi mãi. Không lỗi, không log, CPU 4 giây thay vì 17.
Thêm deadline 1 giây: hub không chết nữa nhưng p99 thành 2 giây và max 5 giây. Cùng shard với SetWriteDeadline 1 giây: 67 vòng hoàn thành trong 20 giây thay vì 100, hub max 5.039 ms, 13.718 mẫu, tức 2%, trễ hơn 1 giây. Số học: 50 client chậm chia 10 shard là 5 mỗi shard, mỗi cái kẹt đủ 1 giây deadline trước khi bị gỡ, tuần tự trong cùng goroutine, thành 5 giây cho toàn bộ 1.000 client của shard đó. Deadline là lưới an toàn, không phải cách sửa: nó đổi "đứng mãi" lấy "đứng 1 giây nhân số client chậm chung goroutine".
Kênh riêng từng client: 50 client chậm, p99.9 50 ms, không ai biết. Mỗi client một goroutine ghi và channel 64, đầy thì drop: 100 vòng đủ, p99 45,7, p99.9 50,5, max 53,3, không mẫu nào quá 100 ms, 50 client chậm bị gỡ lặng lẽ. Kết quả này là của phần 7 được xác nhận ở quy mô 50 client chậm thay vì 1: phạm vi thiệt hại bằng đúng số client chung goroutine ghi với kẻ chậm, và ở đây con số đó là 0.
GC: dừng thế giới 2,3 ms nhưng p99 tăng 2,6 lần, vì thủ phạm không phải pause. Cấp phát bản sao 1 KB cho từng client mỗi vòng cộng rác nền 100 MB/s, GOGC 100: 11 lần GC trong 20 giây, tổng thời gian dừng thế giới 2,3 ms, max 2,23 ms, những con số mà bất kỳ ai nhìn vào cũng kết luận GC vô hại. Nhưng p99 từ 44,6 lên 115,1 ms, p99.9 148, và 11.638 mẫu quá 100 ms. Khoản tăng đó không đến từ pause mà từ GC assist và mark worker: khi heap tăng nhanh, goroutine nào cấp phát phải tự trả nợ đánh dấu, và 25% CPU bị mark worker chiếm; 10.000 goroutine ghi mất CPU đúng lúc cần nó. Chỉ số pause của Go đo đúng thứ nó đo, và thứ đó không phải cái làm đuôi của bạn dài ra.
GOGC 400 làm p99 tốt hơn và p99.9 tệ hơn cùng lúc, với RSS gấp 1,8. Cùng tải, GOGC 400: 3 lần GC thay vì 11, p99 từ 115 xuống 71 ms, nhưng p99.9 từ 148 lên 251 ms, max 255, và RSS từ 490 lên 870 MB. Ít chu kỳ hơn nhưng mỗi chu kỳ đánh dấu một heap lớn hơn, nên đợt assist dài hơn, và những client trúng đợt đó trả giá nặng hơn. Chỉnh GOGC dời đuôi từ p99 sang p99.9; nếu SLO của bạn là p99 thì trông như thắng, nếu là p99.9 thì thua, và cả hai cách nhìn đều đúng cho cùng một hệ thống.
Bỏ cấp phát trong đường nóng: về bằng nền, kể cả khi rác nền vẫn 100 MB/s. Cùng rác nền 100 MB/s, GOGC 100, nhưng hub dùng một buffer chung thay vì copy cho từng client: 6 lần GC, pause tổng 7,1 ms, cao hơn G1, mà p99 41,3, p99.9 49,4, max 52, bằng nền. Rác sinh ra ở goroutine nền thì goroutine nền trả nợ assist; rác sinh ra trong đường fan-out thì 10.000 goroutine ghi trả. Vị trí cấp phát quan trọng hơn tổng lượng cấp phát, và đây chính là lý do PreparedMessage của phần 7 có nghĩa dù không bớt mấy mili giây ở p50.
Hai lõi thay vì mười: p50 tăng 70%, p99.9 tăng 24%. GOMAXPROCS=2 với tải nền: p50 34,9 ms, p99 64,3, p99.9 72,5. Hub báo xong nhanh hơn, 5,6 ms thay vì 12,9, vì nó chỉ xếp vào channel; việc thật là 10.000 goroutine ghi xếp hàng trên 2 P. Thêm percopy và rác vào 2 lõi: p99.9 84 ms, tệ hơn 12 ms, ít hơn nhiều so với khoản 90 ms ở 10 lõi, vì khi CPU đã là nút thắt thì GC chỉ là một phần của hàng đợi chung. Pod nhỏ không làm đuôi nổ, nó nâng cả phân phối lên đều.
Đánh đổi cần cân nhắc
Đo p99.9 cộng "client cuối mỗi vòng", hoặc đừng tin con số đuôi. Cùng p99.9 là 1.000 mẫu xấu có thể là 10 client mỗi vòng (vài kết nối tệ, chấp nhận được) hoặc 1 vòng cho 1.000 client (một sự cố, không chấp nhận được). Ở C2, "client cuối mỗi vòng" trung vị là 31,6 ms nhưng xấu nhất 5.039: đuôi tập trung vào vài vòng. Ở G1, trung vị 30,2 và xấu nhất 149,5: đuôi rải đều hơn. Hai hình dạng cần hai cách sửa khác nhau.
Deadline là bắt buộc nhưng không phải là cách sửa; cô lập mới là. Không deadline thì một client chậm có thể dừng tất cả, mãi mãi. Có deadline thì thiệt hại là deadline nhân số client chậm chung goroutine. Cách duy nhất đưa con số đó về 0 là không để ai chung goroutine với ai, trả bằng 5 KB mỗi kết nối như phần 6 đã đo.
Với GC, hỏi "cấp phát ở đâu" trước "GOGC bao nhiêu". GOGC và GOMEMLIMIT chỉnh tần suất chu kỳ, không chỉnh ai trả tiền cho nó. Một buffer chung, sync.Pool, PreparedMessage, encode một lần: tất cả đều là cách đưa cấp phát ra khỏi đường 10.000 goroutine cùng đi. Phạm vi đo: 20 giây mỗi lần chạy, mạng Docker cùng máy, p99.9 nền dao động khoảng 10 ms giữa các lần, nên khác biệt dưới 10 ms không có ý nghĩa; không đo TLS và không đo nén.
Ba ý mang về
- p50 không đổi trong cả chín kịch bản; mọi sự cố sống ở p99.9: 59 ms nền, 20 giây khi hub kẹt, 5 giây với deadline, 148 ms với GC. Đo p99.9 và client cuối mỗi vòng, hoặc bạn không thấy gì.
- Client chậm: deadline cứu hub, cô lập cứu đuôi: không deadline thì hub đứng ở vòng 22; deadline 1 giây thì 2% mẫu quá 1 giây; kênh riêng từng client thì 50 client chậm không để lại dấu vết.
- GC làm đau bằng assist, không bằng pause, và GOGC chỉ dời đuôi: 2,3 ms dừng thế giới đi kèm p99 115 ms; GOGC 400 đổi p99 71 lấy p99.9 251 và RSS gấp 1,8; bỏ cấp phát trong đường fan-out đưa mọi thứ về nền dù rác nền còn nguyên.
Nguồn
- Go — A Guide to the Go Garbage Collector: GC assist, mark worker,
GOGC,GOMEMLIMIT: https://go.dev/doc/gc-guide - Go
runtime—MemStats.PauseNs,NumGC,GOMAXPROCS: https://pkg.go.dev/runtime#MemStats - Go
runtime/debug—SetGCPercent,SetMemoryLimit: https://pkg.go.dev/runtime/debug#SetGCPercent - Gil Tene — How NOT to Measure Latency (coordinated omission, vì sao nhìn p99.9): https://www.youtube.com/watch?v=lJ8ydIuPFeU
- gorilla/websocket —
Conn.SetWriteDeadline,PreparedMessage: https://pkg.go.dev/github.com/gorilla/websocket#Conn.SetWriteDeadline
Phần sau gom mười một phần thành một khung chọn: khi nào polling đủ, khi nào SSE, khi nào WebSocket, và một checklist vận hành với từng con số đã đo để đối chiếu.
