Phần 6 dựng 10.000 kết nối và để chúng ngồi yên. Phần này gửi cho chúng một thứ: cùng một thông điệp tới tất cả, việc mà mọi hệ thống realtime đều làm, từ bảng giá tới thông báo tới phòng chat lớn. Cách viết hiển nhiên là một vòng for qua danh sách client. Câu hỏi là client đứng cuối danh sách nhận sau bao lâu, con số đó đổi thế nào khi chia việc ra nhiều goroutine, khi dựng khung một lần bằng PreparedMessage, khi mỗi client có goroutine ghi riêng, và chuyện gì xảy ra với 9.999 client còn lại khi có một client không đọc lẫn vào. Mọi độ trễ trong bài đo ở phía client, bằng timestamp server nhúng trong payload, không phải thời gian hub chạy xong.
Năm cách phát và một client chậm
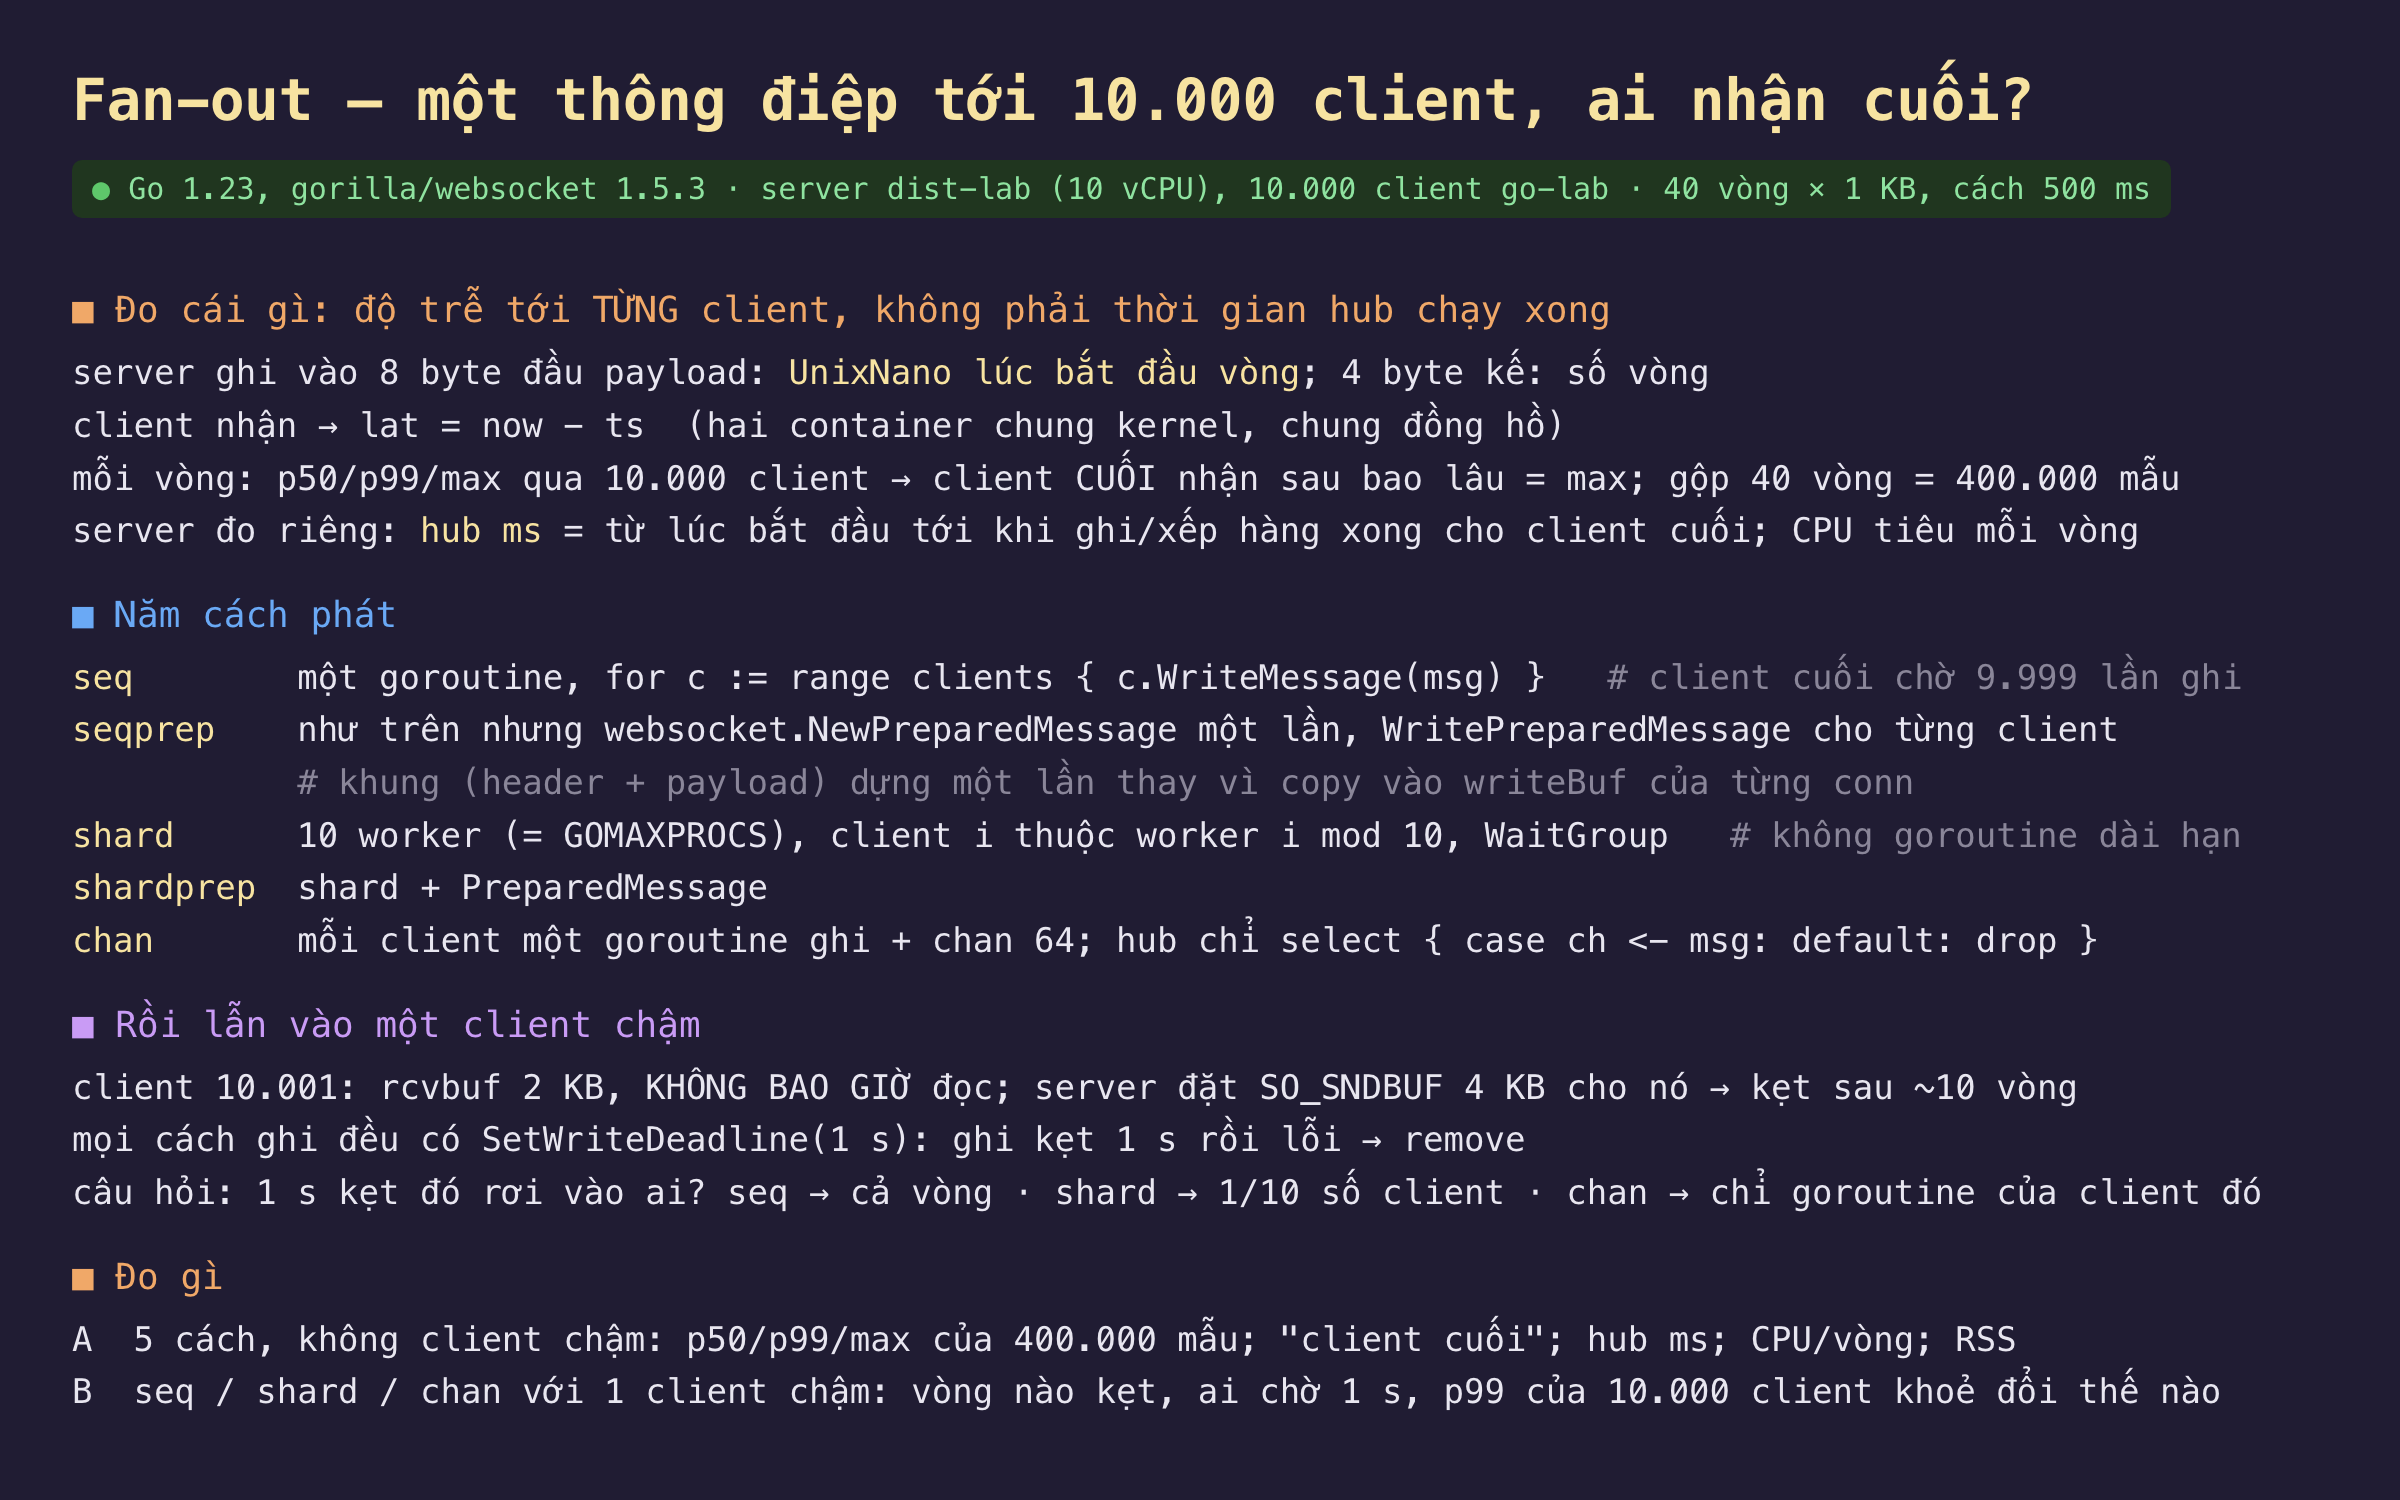
Hình 1: Độ trễ đo ở client bằng timestamp trong payload, năm cách phát, và cách dựng một client chậm sao cho nó thật sự kẹt.
Độ trễ đúng nghĩa là lúc client nhận trừ lúc hub bắt đầu vòng phát. Server ghi UnixNano vào 8 byte đầu payload và số vòng vào 4 byte kế; client, chạy trong container khác nhưng chung kernel và chung đồng hồ, tính hiệu khi nhận. Mỗi vòng cho 10.000 mẫu; 40 vòng cho 400.000 mẫu mỗi cách; giá trị lớn nhất mỗi vòng là client cuối. Server đo thêm hub ms, thời gian từ lúc bắt đầu tới khi ghi hoặc xếp hàng xong cho client cuối, và CPU tiêu mỗi vòng.
Năm cách phát. seq: một goroutine, vòng for gọi WriteMessage cho từng client; client cuối chờ 9.999 lần ghi trước nó. seqprep: như trên nhưng dựng khung một lần bằng NewPreparedMessage rồi WritePreparedMessage cho từng client, bỏ bước copy payload vào bộ đệm ghi của mỗi kết nối. shard: 10 worker goroutine bằng GOMAXPROCS, client thứ i thuộc worker i mod 10, WaitGroup chờ xong. shardprep: shard cộng PreparedMessage. chan: mỗi client một goroutine ghi và channel 64 chỗ, hub chỉ select với default bỏ qua, chính là chiến lược drop của phần 5.
Client chậm là client thứ 10.001: đặt bộ đệm nhận 2 KB, gửi chữ "slow", rồi không bao giờ đọc. Hai bài học khi dựng nó nằm ở phần đo. Mọi cách ghi đều đặt SetWriteDeadline 1 giây, nên khi kẹt, lời gọi ghi chờ đúng 1 giây rồi lỗi và kết nối bị gỡ. Câu hỏi của phần B là một giây đó rơi vào ai.
Đo thật: client cuối, PreparedMessage, và một giây kẹt rơi vào ai
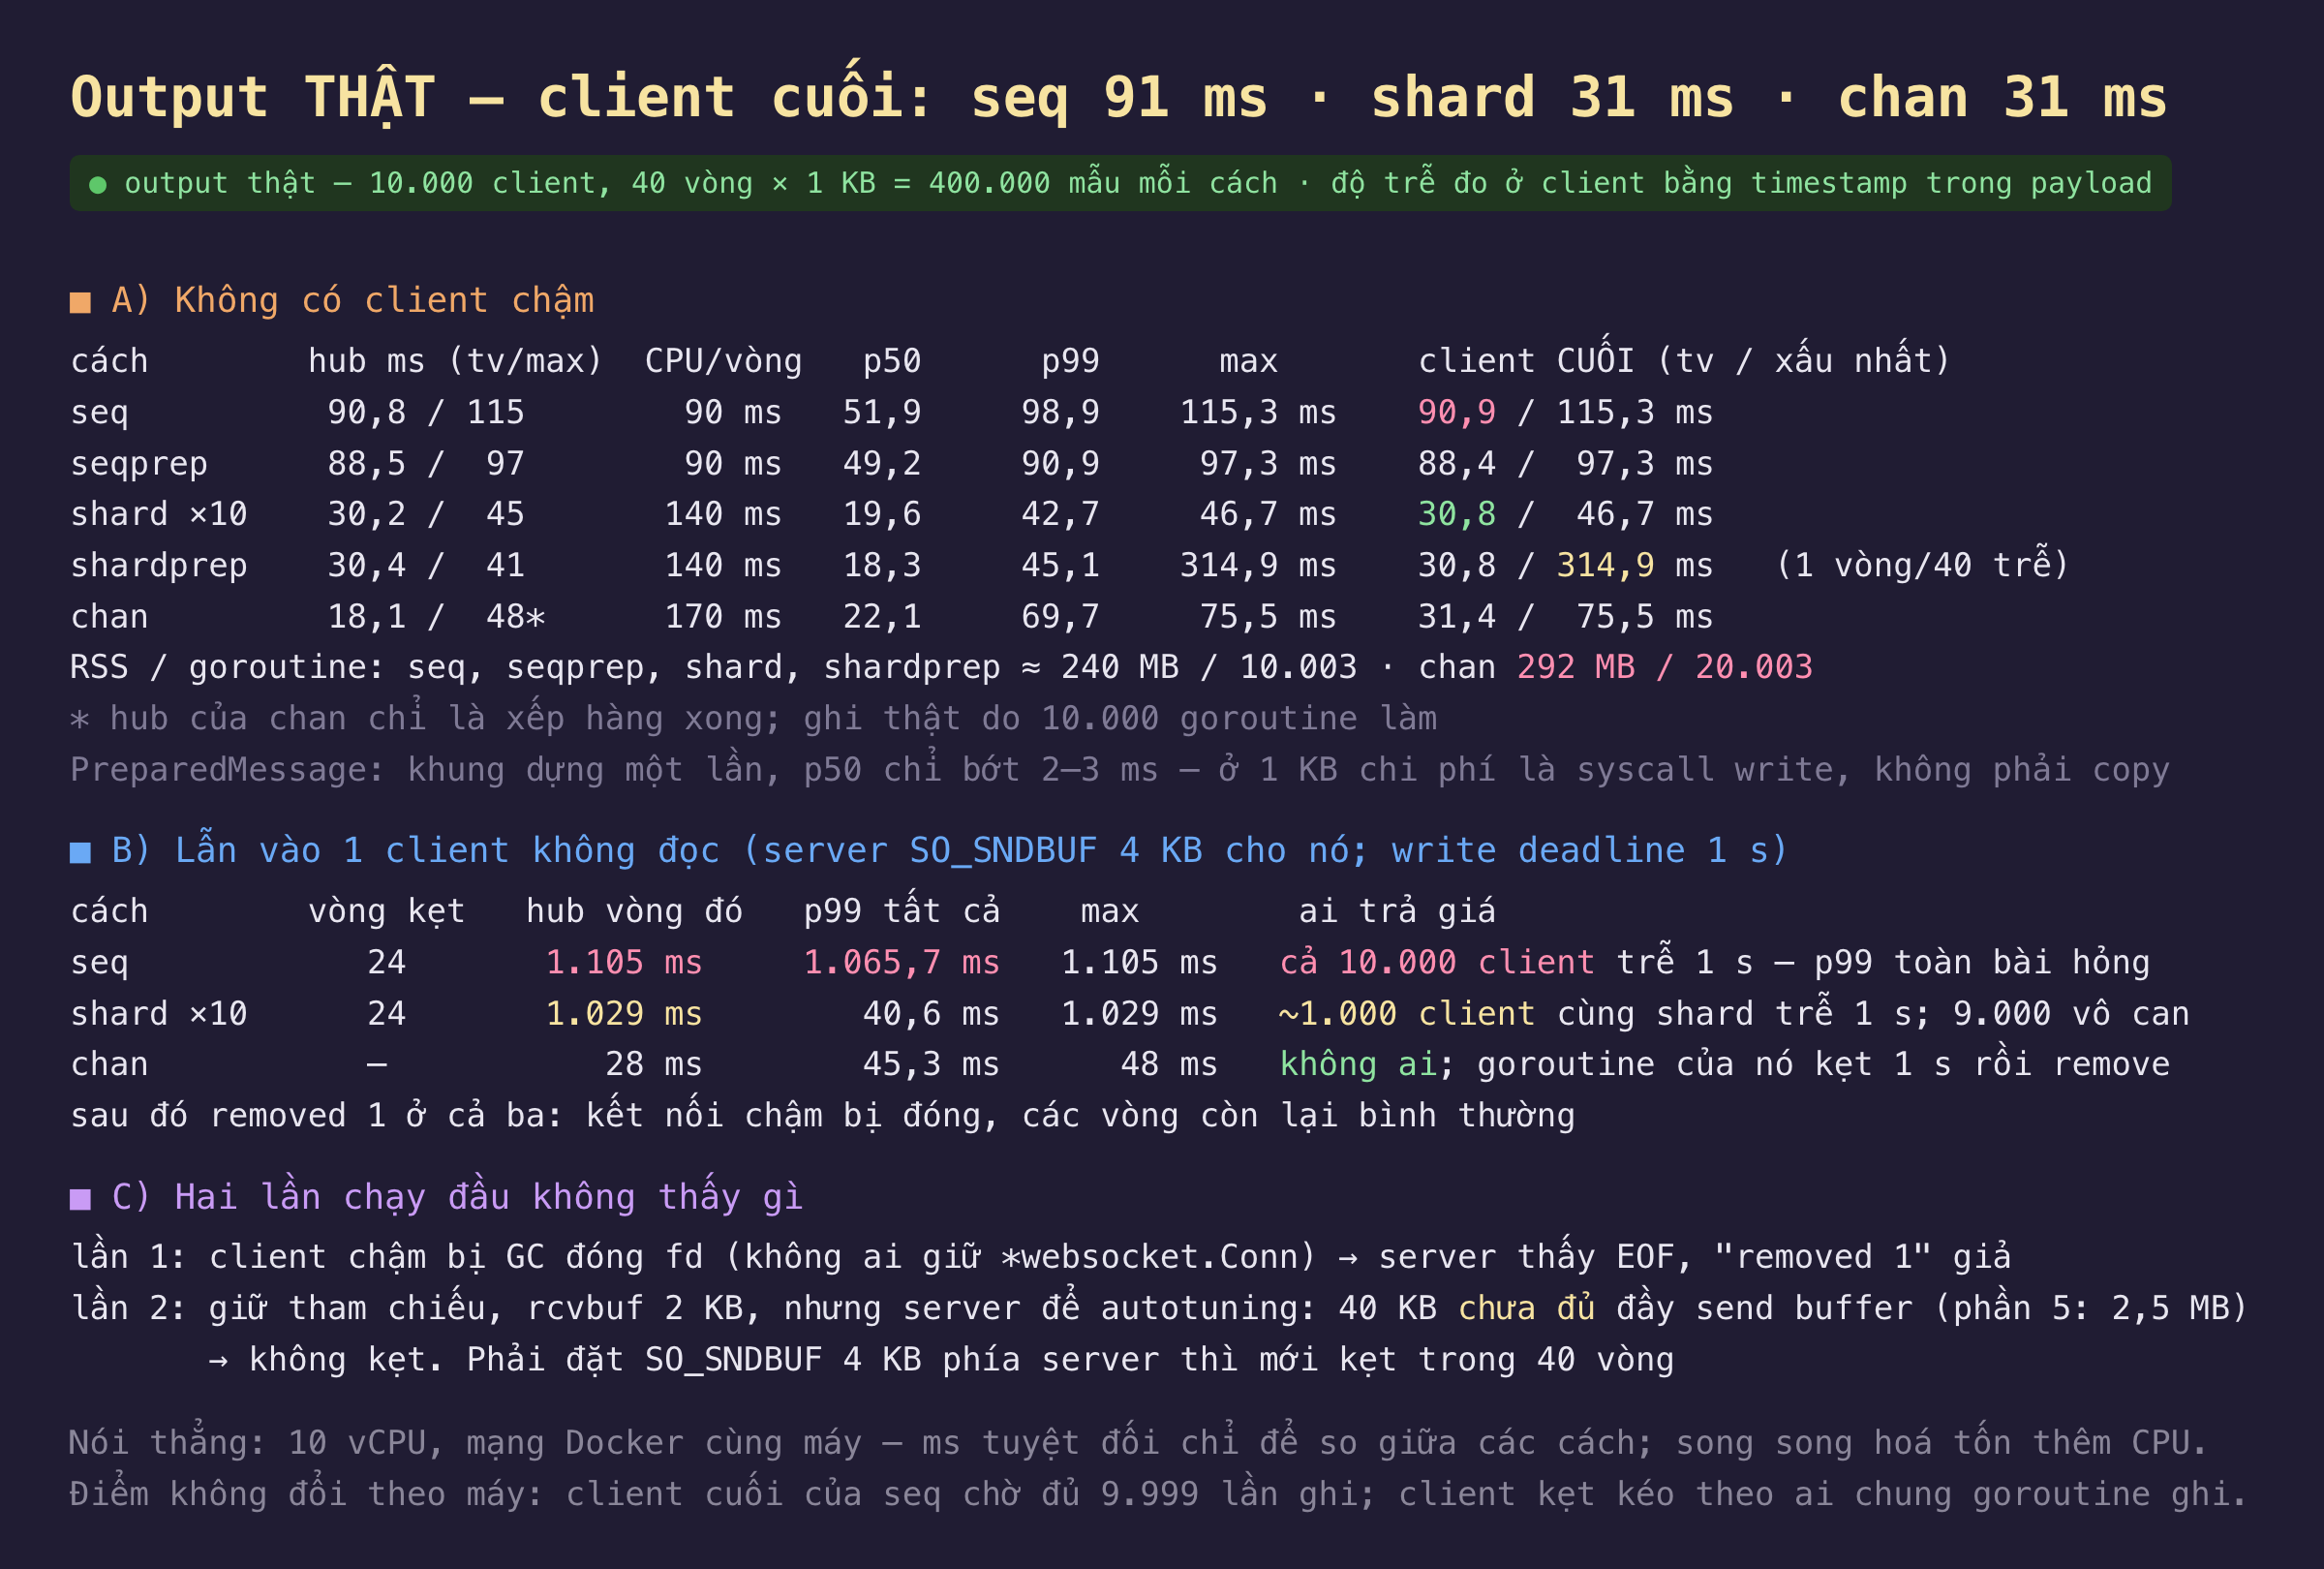
Hình 2: Độ trễ 400.000 mẫu mỗi cách, client cuối theo từng cách, và một giây kẹt của client chậm rơi vào 10.000, 1.000 hay 0 client.
| cách | client cuối (trung vị) | p99 | CPU/vòng | RSS, goroutine |
|---|---|---|---|---|
| seq | 90,9 ms | 98,9 ms | 90 ms | 240 MB, 10.003 |
| seqprep | 88,4 ms | 90,9 ms | 90 ms | 240 MB, 10.003 |
| shard ×10 | 30,8 ms | 42,7 ms | 140 ms | 239 MB, 10.003 |
| shardprep | 30,8 ms | 45,1 ms (1 vòng 315 ms) | 140 ms | 239 MB, 10.003 |
| chan | 31,4 ms | 69,7 ms | 170 ms | 292 MB, 20.003 |
| với 1 client không đọc | vòng kẹt | p99 toàn bài | ai trễ 1 s | |
| seq | 1.105 ms | 1.065,7 ms | cả 10.000 | |
| shard ×10 | 1.029 ms | 40,6 ms | ~1.000 | |
| chan | không | 45,3 ms | không ai |
Ghi tuần tự: client cuối chờ 91 ms, đúng bằng 9.999 lần ghi trước nó. Hub ghi xong cho 10.000 client sau 90,8 ms trung vị, tức khoảng 9 µs mỗi lần WriteMessage 1 KB trên 10 vCPU. Phía client, p50 là 51,9 ms (client ở giữa danh sách), p99 98,9 ms, và client cuối trung vị 90,9 ms, trùng khít hub. Độ trễ của bạn là hàm của vị trí trong danh sách, và thứ tự duyệt map trong Go là ngẫu nhiên nên mỗi vòng một client khác chịu phần cuối. Với 100.000 client, con số này là gần một giây cho người cuối, trước khi mạng kịp làm gì.
Chia 10 worker: 31 ms, gần đúng chia cho số lõi, nhưng CPU mỗi vòng tăng từ 90 lên 140 ms. shard với 10 goroutine bằng GOMAXPROCS: hub 30,2 ms, client cuối 30,8 ms, p99 42,7 ms. Không phải chia đúng 10 vì 10.000 lần write() tranh nhau lõi với 10.000 goroutine đọc đang chờ và với kernel đang chuyển 10 MB qua mạng ảo. CPU mỗi vòng cao hơn 55% so với tuần tự: song song hoá trả bằng chuyển ngữ cảnh và cache. Đổi 50 ms CPU lấy 60 ms độ trễ cho người cuối là đổi có lãi với realtime; với một job nền thì không.
PreparedMessage chỉ bớt 2 đến 3 ms, vì ở 1 KB chi phí là syscall, không phải copy. seqprep so với seq: client cuối 88,4 thay vì 90,9 ms, p99 90,9 thay vì 98,9; shardprep so với shard không khác trong sai số, và còn dính một vòng 315 ms trong 40 vòng, nhiều khả năng là một lần GC hoặc lịch của hệ điều hành. PreparedMessage dựng khung một lần và tiết kiệm một copy 1 KB cho mỗi client, nhưng mỗi client vẫn cần một write() riêng, và syscall đó mới là 9 µs. PreparedMessage có nghĩa khi bật permessage-deflate (nén một lần thay vì 10.000 lần) hoặc payload lớn; với 1 KB không nén, nó là tối ưu đúng chỗ sai.
Kênh riêng cho mỗi client: cùng 31 ms, thêm 10.000 goroutine và 52 MB, và p99 xấu hơn. chan: hub "xong" sau 18 ms vì chỉ xếp hàng, nhưng client cuối vẫn 31,4 ms vì 10.000 goroutine ghi tranh nhau 10 lõi; p99 69,7 ms, tệ hơn shard, vì lịch 10.000 goroutine kém đều hơn 10 worker duyệt tuần tự. RSS 292 MB so với 240, goroutine 20.003 so với 10.003. Đó là giá của sự cô lập, và phần B cho thấy nó mua được gì.
Một client không đọc: tuần tự làm cả 10.000 client trễ 1,1 giây; shard làm 1.000; kênh riêng không ai. Ở vòng 24, send buffer của client chậm đầy. seq: WriteMessage cho nó chặn đủ 1 giây deadline, hub của vòng đó 1.105 ms, và vì mọi client xếp sau nó trong vòng lặp đều chờ, p99 toàn bài nhảy từ 99 lên 1.066 ms, tức hơn 1% tổng số mẫu, cả một vòng, trễ hơn một giây. shard: chỉ worker chứa client đó kẹt 1.029 ms, khoảng 1.000 client cùng shard trễ, 9.000 còn lại không biết gì, p99 toàn bài 40,6 ms. chan: goroutine ghi của riêng nó kẹt rồi lỗi rồi bị gỡ, hub chưa bao giờ quá 28 ms, p99 45,3 ms, không client nào khác thấy gì. Sau đó cả ba đều ghi removed 1 và các vòng còn lại trở lại bình thường. Phạm vi thiệt hại tỉ lệ đúng với số client chung một goroutine ghi với kẻ chậm: 10.000, 1.000, hay 1.
Hai lần chạy đầu không thấy gì, và lý do đáng giá hơn kết quả. Lần đầu, client chậm bị gỡ ngay mà không kẹt: không ai giữ tham chiếu tới *websocket.Conn của nó, GC chạy finalizer của net.Conn và đóng fd, server thấy EOF. Lần hai, giữ tham chiếu rồi, 40 vòng × 1 KB = 40 KB vẫn không đủ làm send buffer đầy, vì autotuning của kernel nới bộ đệm như phần 5 đã đo tới 2,5 MB; không kẹt, không ai bị gì. Phải đặt SO_SNDBUF 4 KB phía server cho riêng kết nối đó, tắt autotuning, kẹt mới xảy ra trong 40 vòng. Trên production, chuyện này không cần ai giúp: một client bị nền hoá 10 phút ở 1 KB/giây là 600 KB, và ở tốc độ của bảng giá thì vài giây.
Đánh đổi cần cân nhắc
Shard là điểm cân bằng tốt nhất trong bài, với điều kiện có deadline. Độ trễ bằng chan, bộ nhớ bằng seq, không goroutine dài hạn, thiệt hại khi có client chậm giới hạn trong một shard và chỉ kéo dài một deadline. Hạ deadline xuống 100 ms thu hẹp thiệt hại thêm 10 lần nhưng đóng nhầm client chỉ hơi chậm; chọn theo p99 của mạng thật. Nếu hệ thống đã có goroutine ghi riêng cho mỗi client vì lý do khác (xếp hàng theo thứ tự, gộp, nén), chan là lựa chọn tự nhiên và trả 5 KB mỗi client cho sự cô lập hoàn toàn.
Không có cách nào thoát khỏi 10.000 lần write(). Mọi cách ở đây đều gọi write() 10.000 lần mỗi vòng; khác nhau chỉ ở bao nhiêu goroutine và ai chờ ai. Giảm số syscall là việc của tầng khác: gộp nhiều thông điệp vào một khung khi tần suất cao (10 thông điệp 100 B thành một khung 1 KB là bớt 90% syscall), hoặc chia client ra nhiều tiến trình và nhiều máy, chủ đề của phần 9 với Redis pub/sub.
Phạm vi đo. 10 vCPU, mạng Docker cùng máy, payload 1 KB, 2 vòng mỗi giây. Độ trễ tuyệt đối sẽ khác trên máy bạn; tỉ lệ giữa các cách và cơ chế thiệt hại thì không. Chưa đo: permessage-deflate (nơi PreparedMessage thật sự có lãi), TLS (mỗi write() thêm mã hoá), và fan-out tới các nhóm con thay vì tất cả.
Ba ý mang về
- Với ghi tuần tự, độ trễ của một client là vị trí của nó trong danh sách: client cuối trong 10.000 chờ 91 ms, bằng đúng 9.999 lần write trước nó. Chia theo số lõi đưa con số về 31 ms với giá 50 ms CPU mỗi vòng.
- PreparedMessage không phải thuốc cho fan-out thông điệp nhỏ: bớt 2 đến 3 ms trong 91, vì chi phí là syscall chứ không phải copy. Nó có lãi khi nén hoặc payload lớn.
- Một client kẹt kéo theo đúng những ai chung goroutine ghi với nó: 10.000 với vòng lặp tuần tự, 1.000 với 10 shard, 0 với kênh riêng. Luôn đặt write deadline, và chọn mức cô lập theo số client bạn chấp nhận cho trễ cùng lúc.
Nguồn
- gorilla/websocket —
PreparedMessage,Conn.WritePreparedMessage: https://pkg.go.dev/github.com/gorilla/websocket#PreparedMessage - gorilla/websocket — ví dụ
chat: hub,broadcast,send chan []byte: https://github.com/gorilla/websocket/tree/main/examples/chat - Go —
runtime.GOMAXPROCSvà lịch goroutine: https://pkg.go.dev/runtime#GOMAXPROCS - Linux
socket(7)—SO_SNDBUF,SO_RCVBUFvà việc tắt autotuning khi đặt tay: https://man7.org/linux/man-pages/man7/socket.7.html - Go
net— finalizer đóng fd khinet.Connbị thu gom: https://pkg.go.dev/net#Conn
Phần sau đổi góc nhìn sang client: kết nối rớt rồi nối lại, thông điệp nào đã mất, thông điệp nào tới hai lần, và số thứ tự cộng xác nhận giúp được bao nhiêu khi đo với netem cắt mạng thật.
