Cache thường được coi là lá chắn êm ái đứng trước database: request tới, trúng cache, DB nhàn nhã. Nhưng có một khoảnh khắc lá chắn đó tự biến thành khẩu súng chĩa vào chân mình — khi một key nóng (được rất nhiều request cùng hỏi) hết hạn. Ngay giây phút đó, mọi request đang bay đều miss cùng lúc, và mỗi cái đều "tự giác" đi tính lại giá trị bằng cách gọi xuống nguồn. Cache đang đỡ 100% tải bỗng buông tay, và toàn bộ tải dồn xuống DB trong một nhịp. Đây là cache stampede (còn gọi là thundering herd, dog-piling): nghịch lý là hệ thống sập không phải lúc cache hỏng, mà lúc cache vừa hết hạn trong khi lưu lượng vẫn cao. Bài này (phần 8 loạt Hệ thống chịu tải) đo thật hiện tượng đó trong Go và chữa nó bằng singleflight.
Cơ chế: vì sao một key hết hạn lại nguy hiểm
Hãy hình dung một key được 1000 request/giây cùng đọc — ví dụ cấu hình hệ thống, hay bảng xếp hạng trang chủ. Khi nó còn trong cache, DB gần như không thấy tải gì. Nhưng cache có TTL, và tới lúc TTL hết:
- Request đầu tiên miss → bắt đầu tính lại (giả sử query DB mất 50ms).
- Trong 50ms đó, 999 request khác cũng tới, cũng miss (giá trị chưa kịp được ghi lại), và mỗi cái cũng khởi động một query DB y hệt.
- DB nhận 1000 query giống hệt nhau trong một chớp mắt — trong khi đúng ra chỉ cần một.
Điểm mấu chốt: các request này không sai. Từng cái đều làm đúng logic "miss thì đi lấy nguồn". Vấn đề nằm ở chỗ không ai biết có đứa khác đang lấy cùng thứ đó. Cần một cơ chế để chúng nhận ra nhau và gộp lại.
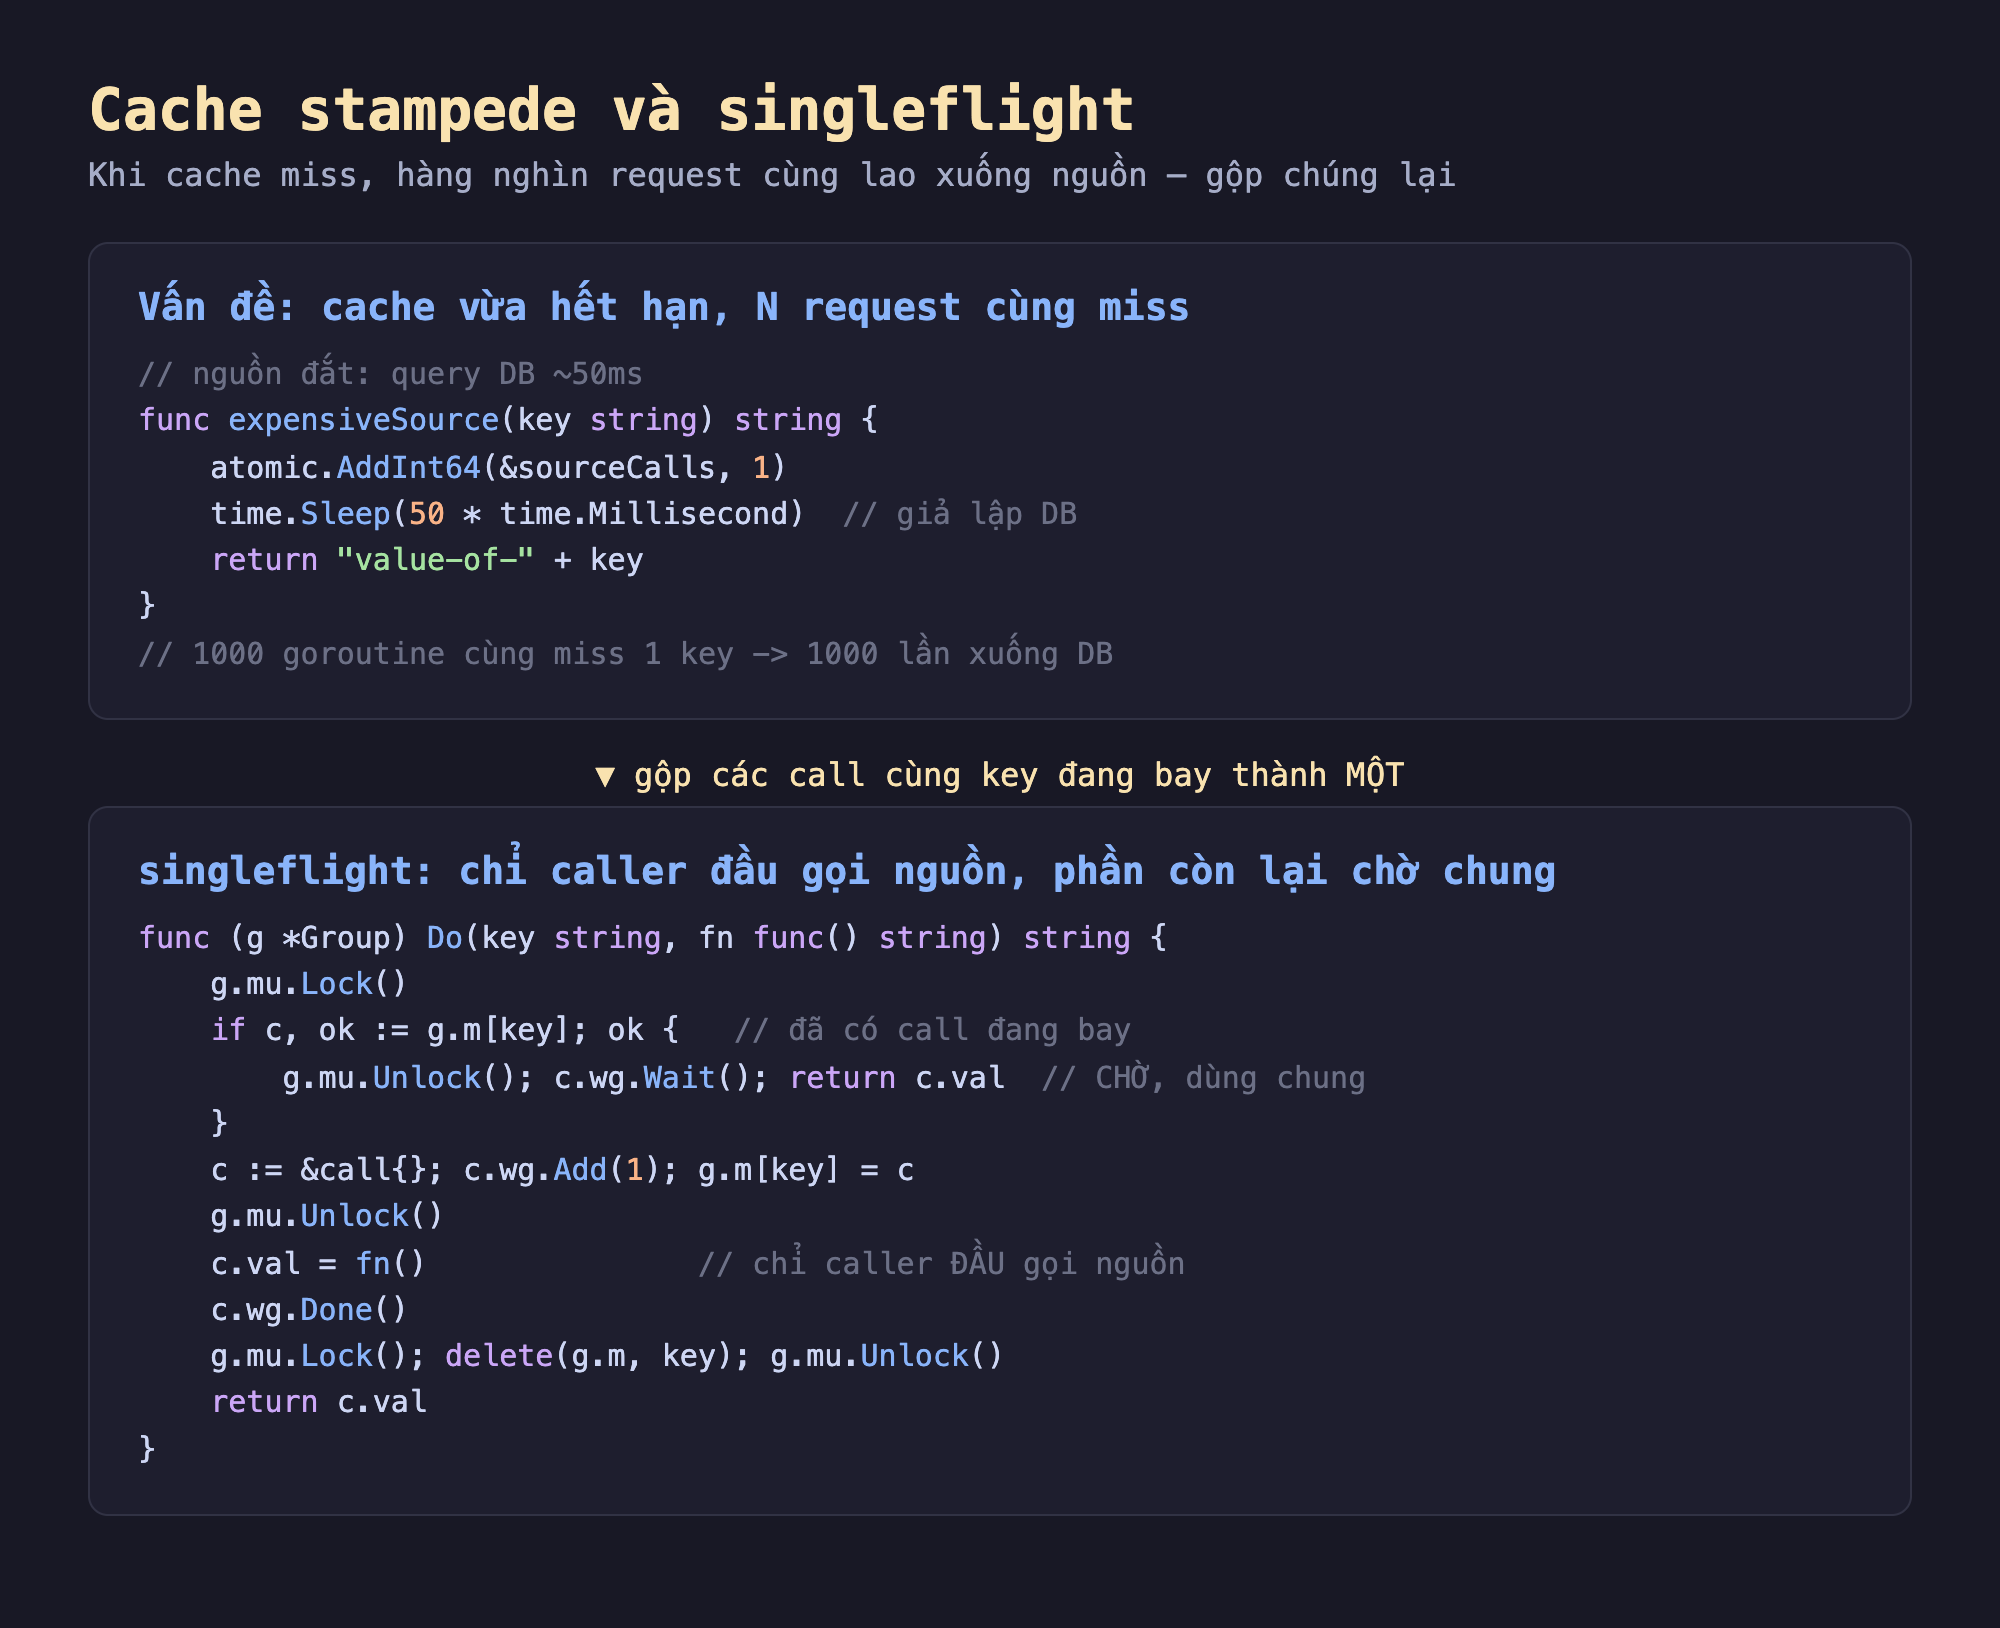
Hình 1: Nguồn đắt (expensiveSource) giả lập query DB 50ms và đếm số lần bị gọi thật; singleflight.Do kiểm tra map các call đang bay — nếu key đã có người lấy thì chờ và dùng chung, nếu chưa thì chỉ caller đầu tiên gọi nguồn.
singleflight: gộp các lời gọi trùng thành một
Ý tưởng của singleflight rất gọn: giữ một map[key]*call cho các lời gọi đang bay. Khi một goroutine muốn lấy key, nó khoá map lại một nhịp:
- Nếu key chưa có ai đang lấy → tạo một
callmới, đánh dấu vào map, và chỉ nó gọi nguồn. - Nếu key đã có người đang lấy → không gọi nguồn nữa, chỉ
wg.Wait()chờ kết quả rồi dùng chung.
sync.WaitGroup đóng vai trò tín hiệu "kết quả đã sẵn sàng". Đây chính là golang.org/x/sync/singleflight của Go, nhưng cơ chế đủ đơn giản để tự cài trong ~15 dòng — mình tự cài để không phụ thuộc phiên bản toolchain:
type call struct {
	wg  sync.WaitGroup
	val string
}
type Group struct {
	mu sync.Mutex
	m  map[string]*call
}

func (g *Group) Do(key string, fn func() string) string {
	g.mu.Lock()
	if g.m == nil {
		g.m = map[string]*call{}
	}
	if c, ok := g.m[key]; ok { // đã có call đang bay -> chờ, dùng chung
		g.mu.Unlock()
		c.wg.Wait()
		return c.val
	}
	c := &call{}
	c.wg.Add(1)
	g.m[key] = c
	g.mu.Unlock()

	c.val = fn() // CHỈ caller đầu tiên gọi nguồn
	c.wg.Done()

	g.mu.Lock()
	delete(g.m, key)
	g.mu.Unlock()
	return c.val
}
Cái tinh tế nằm ở việc delete(g.m, key) xảy ra sau khi fn() xong: trong suốt lúc nguồn đang được tính, key vẫn nằm trong map để mọi request mới đến kịp gộp vào. Khi tính xong và xoá key, các request sau đó nữa sẽ lại tạo call mới — đúng ý, vì lúc đó giá trị đã được ghi vào cache rồi.
Đo thật trong go-lab
Mình chạy trong container go-lab (golang 1.23): tạo 1000 goroutine cùng hỏi một key "hot" vừa miss, đếm số lần nguồn thật sự bị gọi — trước và sau khi thêm singleflight. Sau đó đo hit rate của một LRU cache với mẫu truy cập lệch.
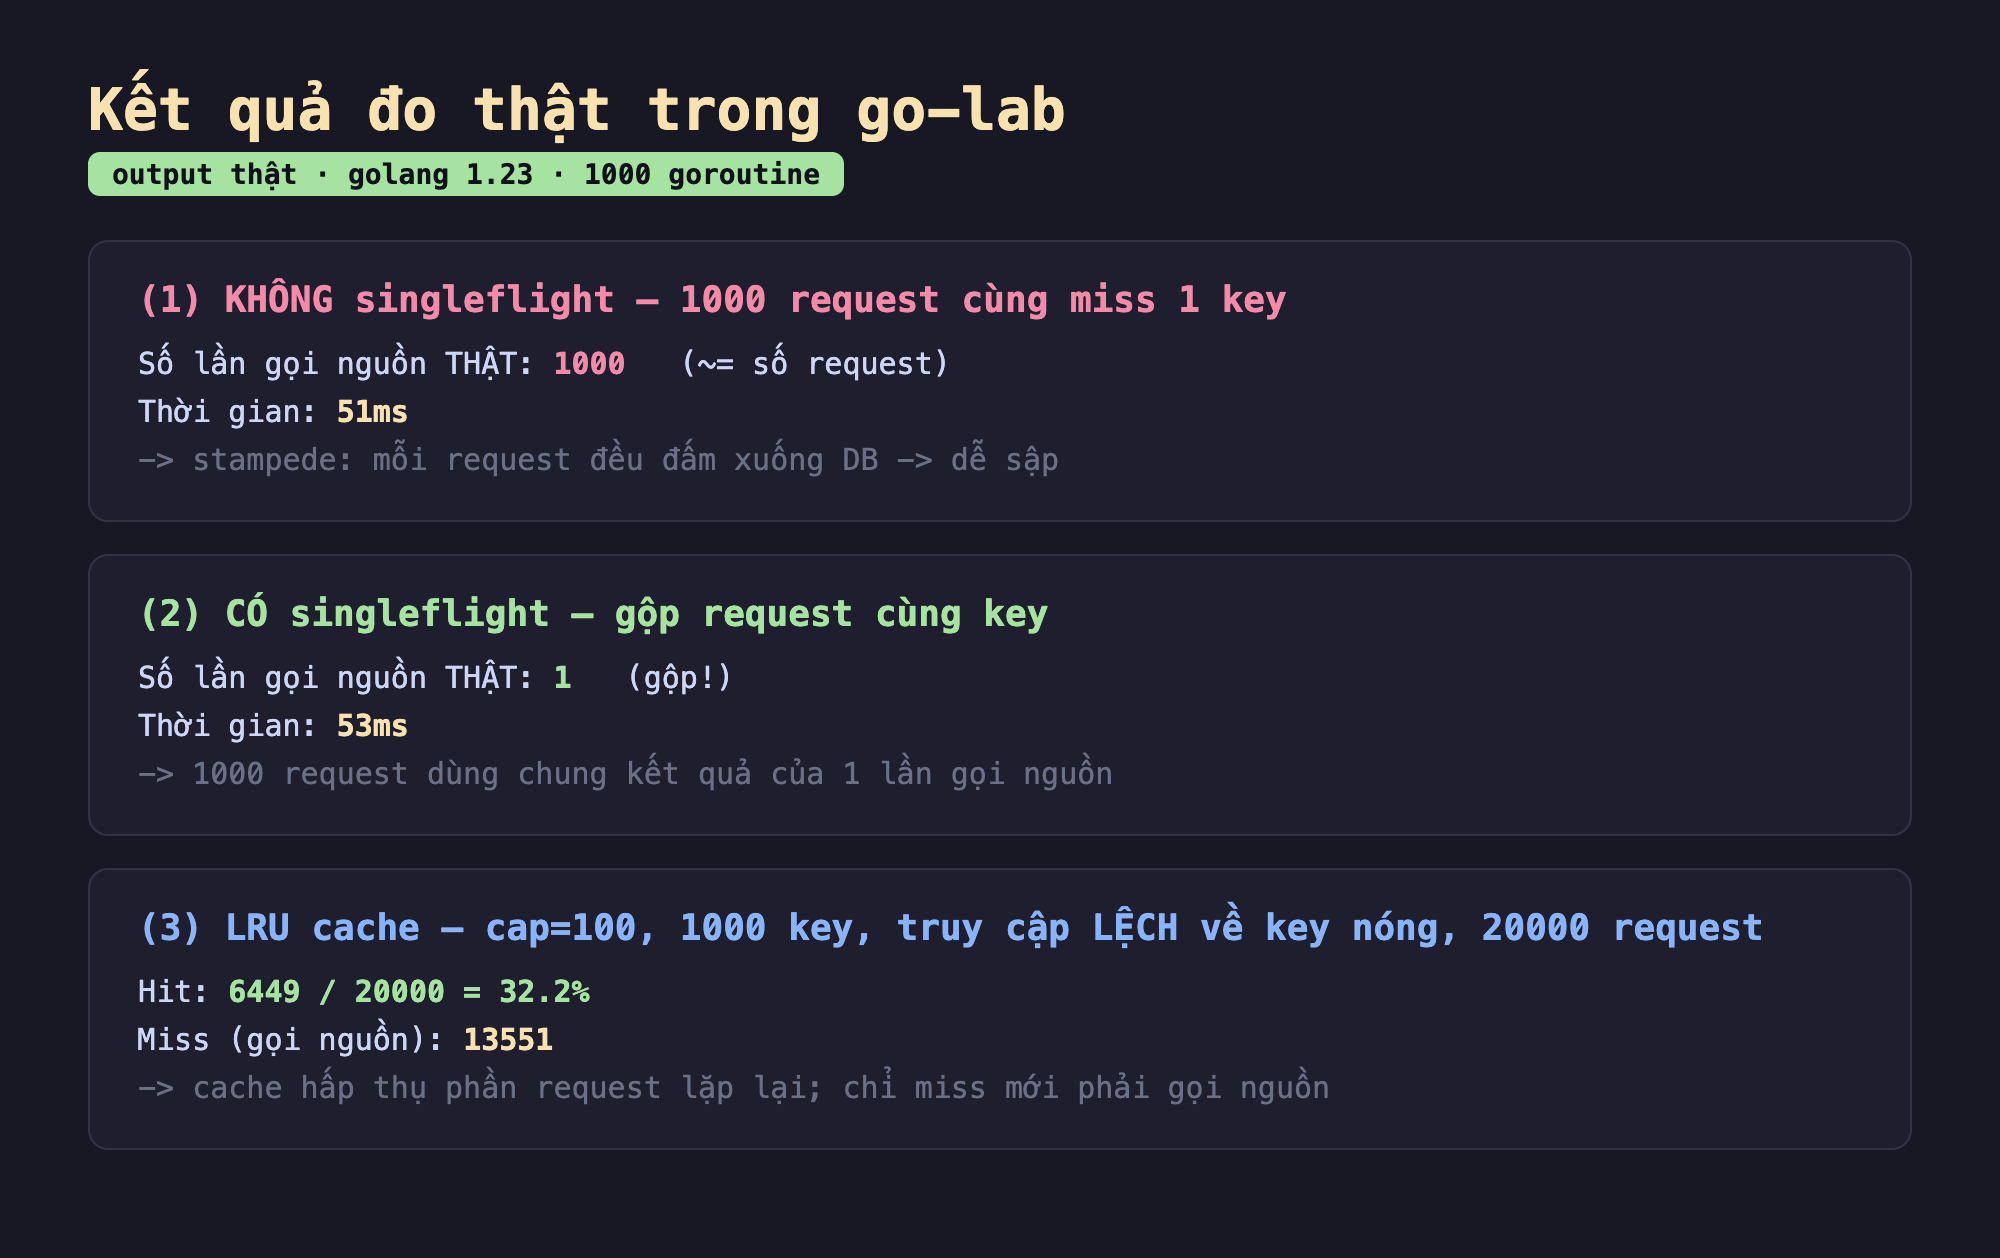
Hình 2: Kết quả thật — không singleflight: 1000 lần gọi nguồn (đúng bằng số request); có singleflight: chỉ 1 lần; LRU với truy cập lệch: hit rate 32.2% (6449/20000).
Ba con số đáng nói:
- Không singleflight: 1000 lần gọi nguồn. Đúng như dự đoán — mỗi request tự đi lấy. Trên DB thật, đây là 1000 query đồng thời cho một giá trị duy nhất; đủ để đẩy connection pool tới hạn và làm mọi request khác chờ theo.
- Có singleflight: 1 lần gọi nguồn. 999 request còn lại chờ và dùng chung kết quả. Tải xuống nguồn giảm 1000 lần trong tình huống này.
- Thời gian gần như không đổi (51ms so với 53ms). Đây là điểm cần nói thẳng: singleflight không làm request nhanh hơn — cả hai đều mất ~50ms vì đằng nào cũng phải chờ một query DB hoàn tất. Cái nó cứu là tải xuống nguồn, không phải độ trễ. Thực ra bản singleflight còn chậm hơn một nhịp cực nhỏ (2ms) do chi phí khoá map và chờ WaitGroup.
Về hit rate LRU: mình cố tình đo với mẫu truy cập lệch về key nóng (phân phối kiểu Zipf, idx = 1000 * rand^3), vì đó mới giống tải thật. Kết quả 32.2% nghe khiêm tốn, và nó khiêm tốn thật: cache chỉ giữ 100 trong 1000 key, còn đuôi dài các key ít gặp liên tục đẩy nhau ra. Mình có thử cả mẫu quét tuần tự (round-robin qua 120 key với cache 100) và nhận 0% hit — đó là ca xấu nhất kinh điển của LRU: khi vòng lặp dài hơn cache, mỗi key vừa bị đẩy ra đúng lúc sắp cần lại. Con số hit rate của cache phụ thuộc hoàn toàn vào hình dạng truy cập, không phải vào việc "có cache hay không".
Vì sao cả hai kỹ thuật đều cần
Đừng nhầm singleflight với cache — chúng giải hai vấn đề khác nhau và thường đi cùng nhau:
- Cache (LRU/TTL) giảm số lần chạm nguồn qua thời gian: cùng một key hỏi 100 lần trong 1 phút mà TTL còn thì chỉ 1 lần xuống nguồn.
- singleflight giảm số lần chạm nguồn trong một khoảnh khắc: cùng một key hỏi 1000 lần cùng lúc khi đang miss thì chỉ 1 lần xuống nguồn.
Cache mà thiếu singleflight sẽ dính stampede đúng lúc TTL hết. singleflight mà thiếu cache thì mỗi đợt vẫn phải gọi nguồn một lần cho mỗi lần key nguội. Ghép lại: cache đỡ tải thường trực, singleflight đỡ tải đúng lúc chuyển giao — chính là khoảnh khắc nguy hiểm nhất.
Đánh đổi cần cân nhắc
singleflight biến 1000 lỗi thành 1000 lần chờ chung — con dao hai lưỡi. Nếu lần gọi nguồn duy nhất đó chậm (DB đang nghẽn), thì cả 1000 request đều chờ theo nó thay vì mỗi request tự timeout độc lập. Một query treo 5 giây giờ giữ chân toàn bộ 1000 goroutine. Vì vậy fn() bên trong singleflight phải có timeout/context (như bài timeout & context), để một nguồn chậm không kéo cả đàn xuống theo. singleflight gộp thành công rất tốt, nhưng cũng gộp thất bại — một lỗi được chia đều cho tất cả.
TTL cứng gây "vách hết hạn" đồng loạt. Nếu nhiều key được nạp cùng lúc với cùng TTL (ví dụ warmup lúc khởi động), chúng sẽ hết hạn cùng lúc — stampede trên nhiều key một lượt. Hai cách chữa quen thuộc: jitter TTL (mỗi key cộng thêm một khoảng ngẫu nhiên, ví dụ TTL ± 10%, để chúng hết hạn rải ra), và stale-while-revalidate (khi key hết hạn vẫn trả giá trị cũ ngay lập tức rồi làm mới ở nền — request không phải chờ, nguồn được cập nhật không gấp gáp). Cả hai làm mượt đường tải thay vì để nó dựng đứng.
Hit rate là thuộc tính của tải, không phải của code. Như con số 32.2% (và 0% ở ca quét tuần tự) cho thấy, không có "hit rate tốt" chung chung. Trước khi tăng cache size để "cải thiện hit rate", hãy đo hình dạng truy cập thật: nếu tải là quét tuần tự tập dữ liệu lớn hơn cache, thêm RAM cho cache gần như vô ích — LRU sẽ vẫn thrash. Ngược lại nếu tải lệch mạnh về ít key nóng, một cache nhỏ cũng đủ đỡ phần lớn tải.
Ba ý mang về
- Cache stampede xảy ra lúc cache vừa hết hạn, không phải lúc cache hỏng: đo thật, 1000 goroutine cùng miss một key nóng gọi nguồn 1000 lần — toàn bộ tải dồn xuống DB trong một nhịp, đủ để quật sập nguồn ngay cả khi hệ thống "đang chạy tốt".
- singleflight gộp các lời gọi trùng đang bay về một: đo thật, con số gọi nguồn từ 1000 rớt về 1, 999 request còn lại dùng chung kết quả; nhưng nó cứu tải nguồn chứ không cứu độ trễ (51ms so với 53ms), và bắt buộc
fn()phải có timeout kẻo một nguồn chậm giữ chân cả đàn. - Cache và singleflight bù cho nhau, và hit rate phụ thuộc hình dạng truy cập: cache đỡ tải qua thời gian, singleflight đỡ tải trong khoảnh khắc chuyển giao; LRU đạt 32.2% với truy cập lệch nhưng 0% khi quét tuần tự — nên dùng jitter TTL và stale-while-revalidate để làm mượt vách hết hạn.
Nguồn
- Go — golang.org/x/sync/singleflight: https://pkg.go.dev/golang.org/x/sync/singleflight
- Wikipedia — Cache stampede: https://en.wikipedia.org/wiki/Cache_stampede
- MDN — stale-while-revalidate (Cache-Control): https://developer.mozilla.org/en-US/docs/Web/HTTP/Headers/Cache-Control#stale-while-revalidate
Phần sau ta bàn về idempotency: khi retry (như phần 3) gửi lại một request đã thành công, làm sao để "trừ tiền hai lần" không xảy ra — khoá idempotency, cửa sổ dedup, và đo thật.
