Go làm goroutine rẻ đến mức sinh ra một thói quen nguy hiểm: "cứ go func() cho mỗi task". Với vài chục task thì không sao, nhưng với hàng triệu task, bạn tạo hàng triệu goroutine — tốn RAM (mỗi goroutine vài KB stack), đè scheduler, và tệ hơn: hàng triệu goroutine cùng gọi database sẽ đè sập database. Worker pool giới hạn số việc chạy đồng thời ở một con số N cố định, tái dùng goroutine thay vì tạo mới. Bài này (phần 7 loạt Hệ thống chịu tải) chạy thật để thấy sự bùng nổ goroutine và tìm số worker tối ưu.
Cơ chế: N worker cố định đọc chung một channel
Thay vì một goroutine mỗi task, ta tạo đúng N goroutine (worker), tất cả đọc từ một channel công việc chung:
jobs := make(chan Task, cap)
for w := 0; w < N; w++ {           // tạo ĐÚNG N goroutine
    go func() { for t := range jobs { handle(t) } }()  // tái dùng
}
for _, t := range tasks { jobs <- t }  // đẩy việc vào
close(jobs)
Dù có 1 triệu task, số goroutine luôn là N. Song song bị giới hạn ở N — vừa kiểm soát tài nguyên của chính mình, vừa bảo vệ downstream (chỉ N kết nối database cùng lúc, chẳng hạn).
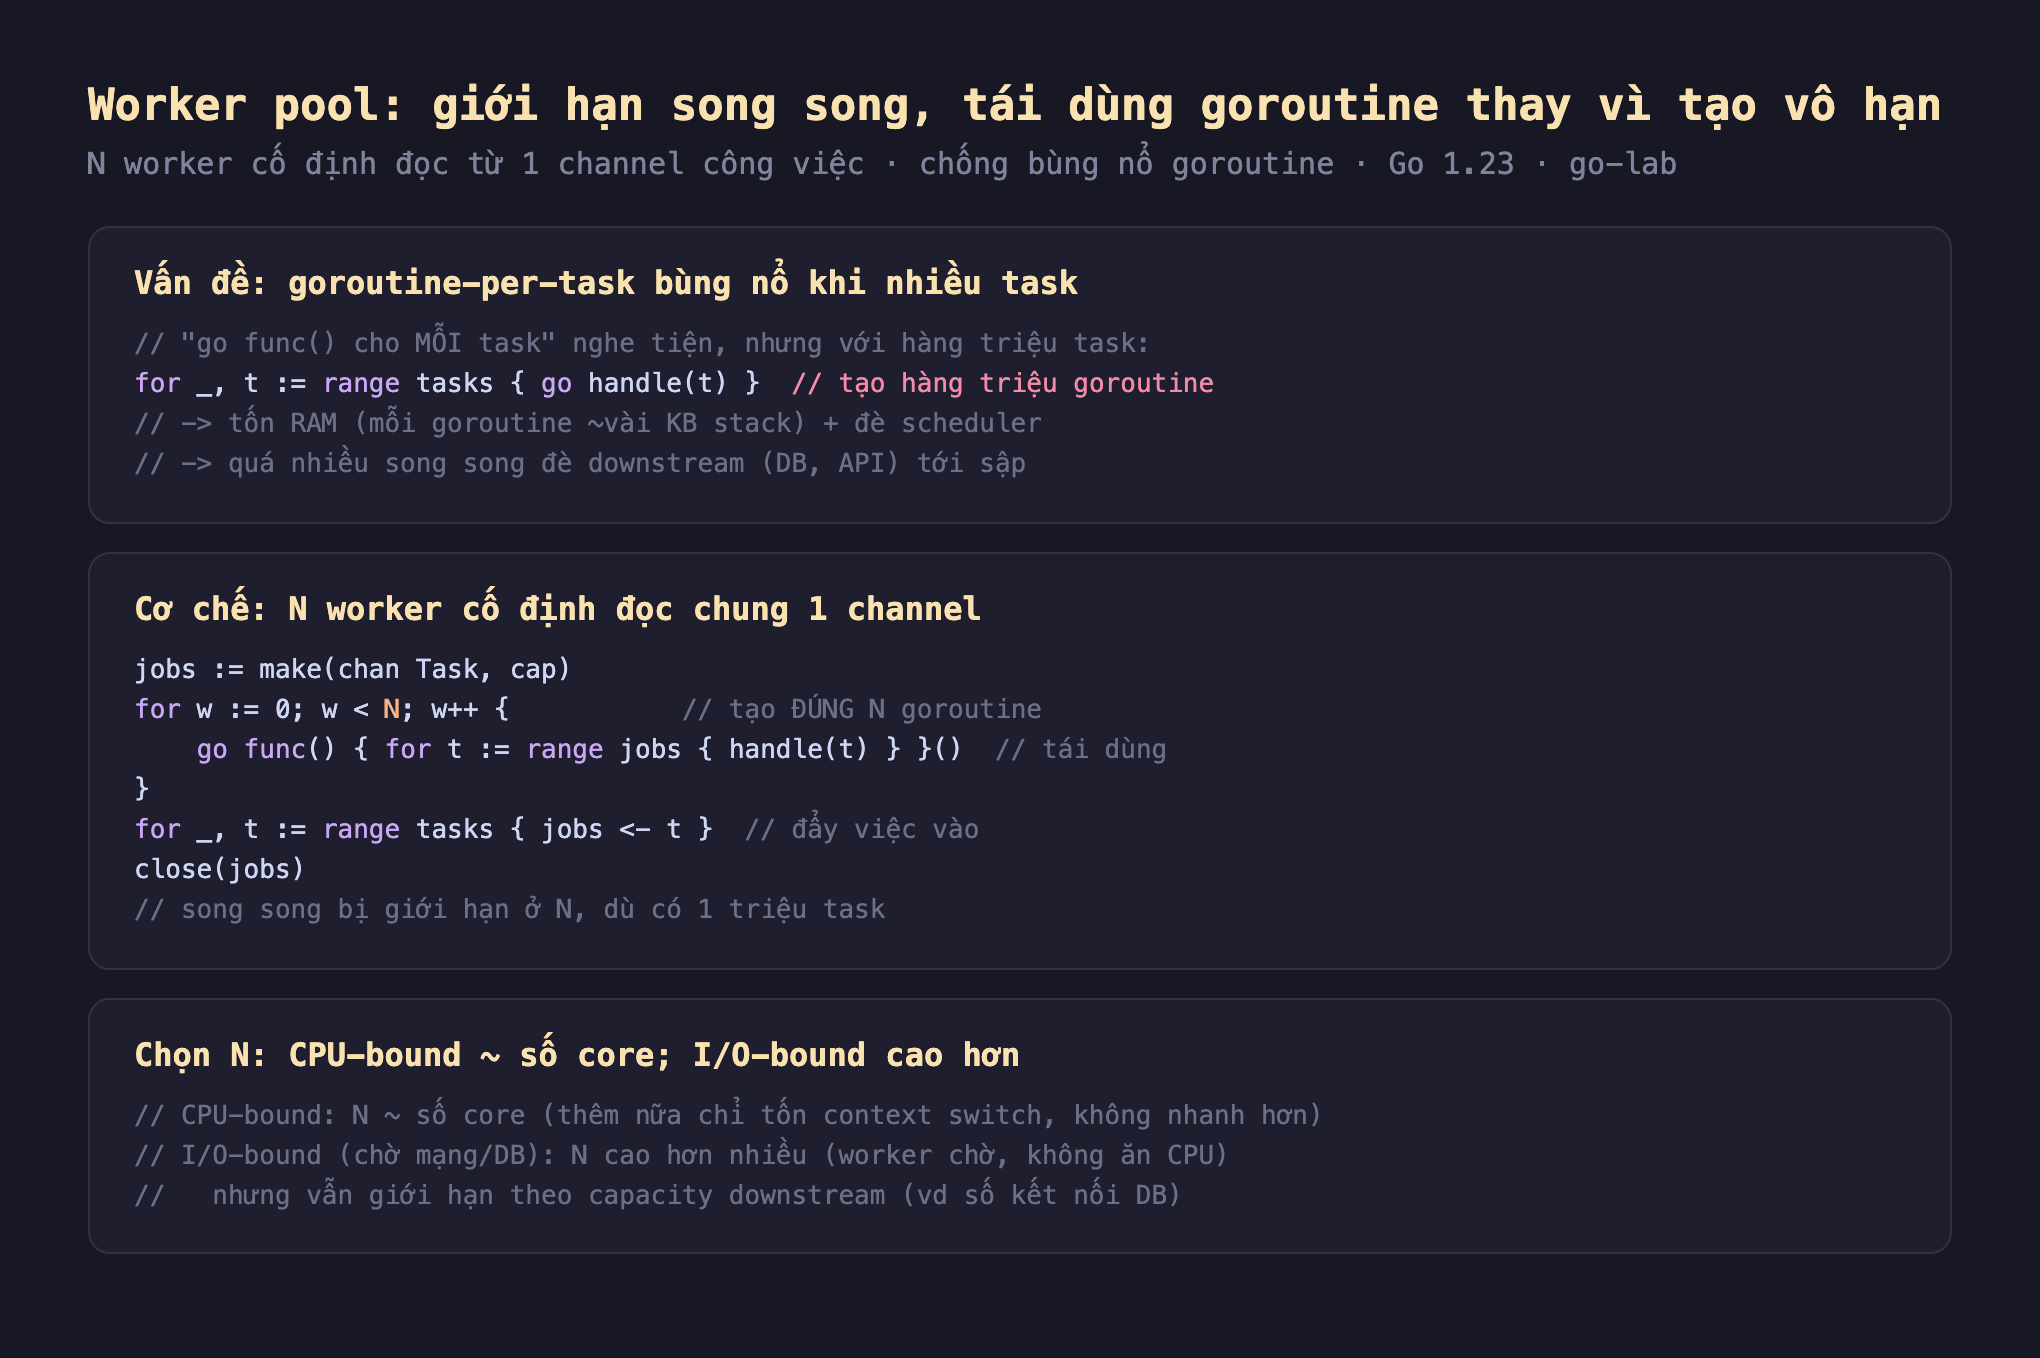
Hình 1: Worker pool tạo đúng N goroutine đọc chung channel jobs — song song giới hạn ở N dù bao nhiêu task; chọn N theo loại việc (CPU-bound ~ số core, I/O-bound cao hơn nhưng giới hạn theo downstream).
Đo thật: bão hòa quanh số core, và 11 vs 200.001 goroutine
Mình đo throughput theo số worker (CPU-bound, 10 core) và so số goroutine đỉnh:
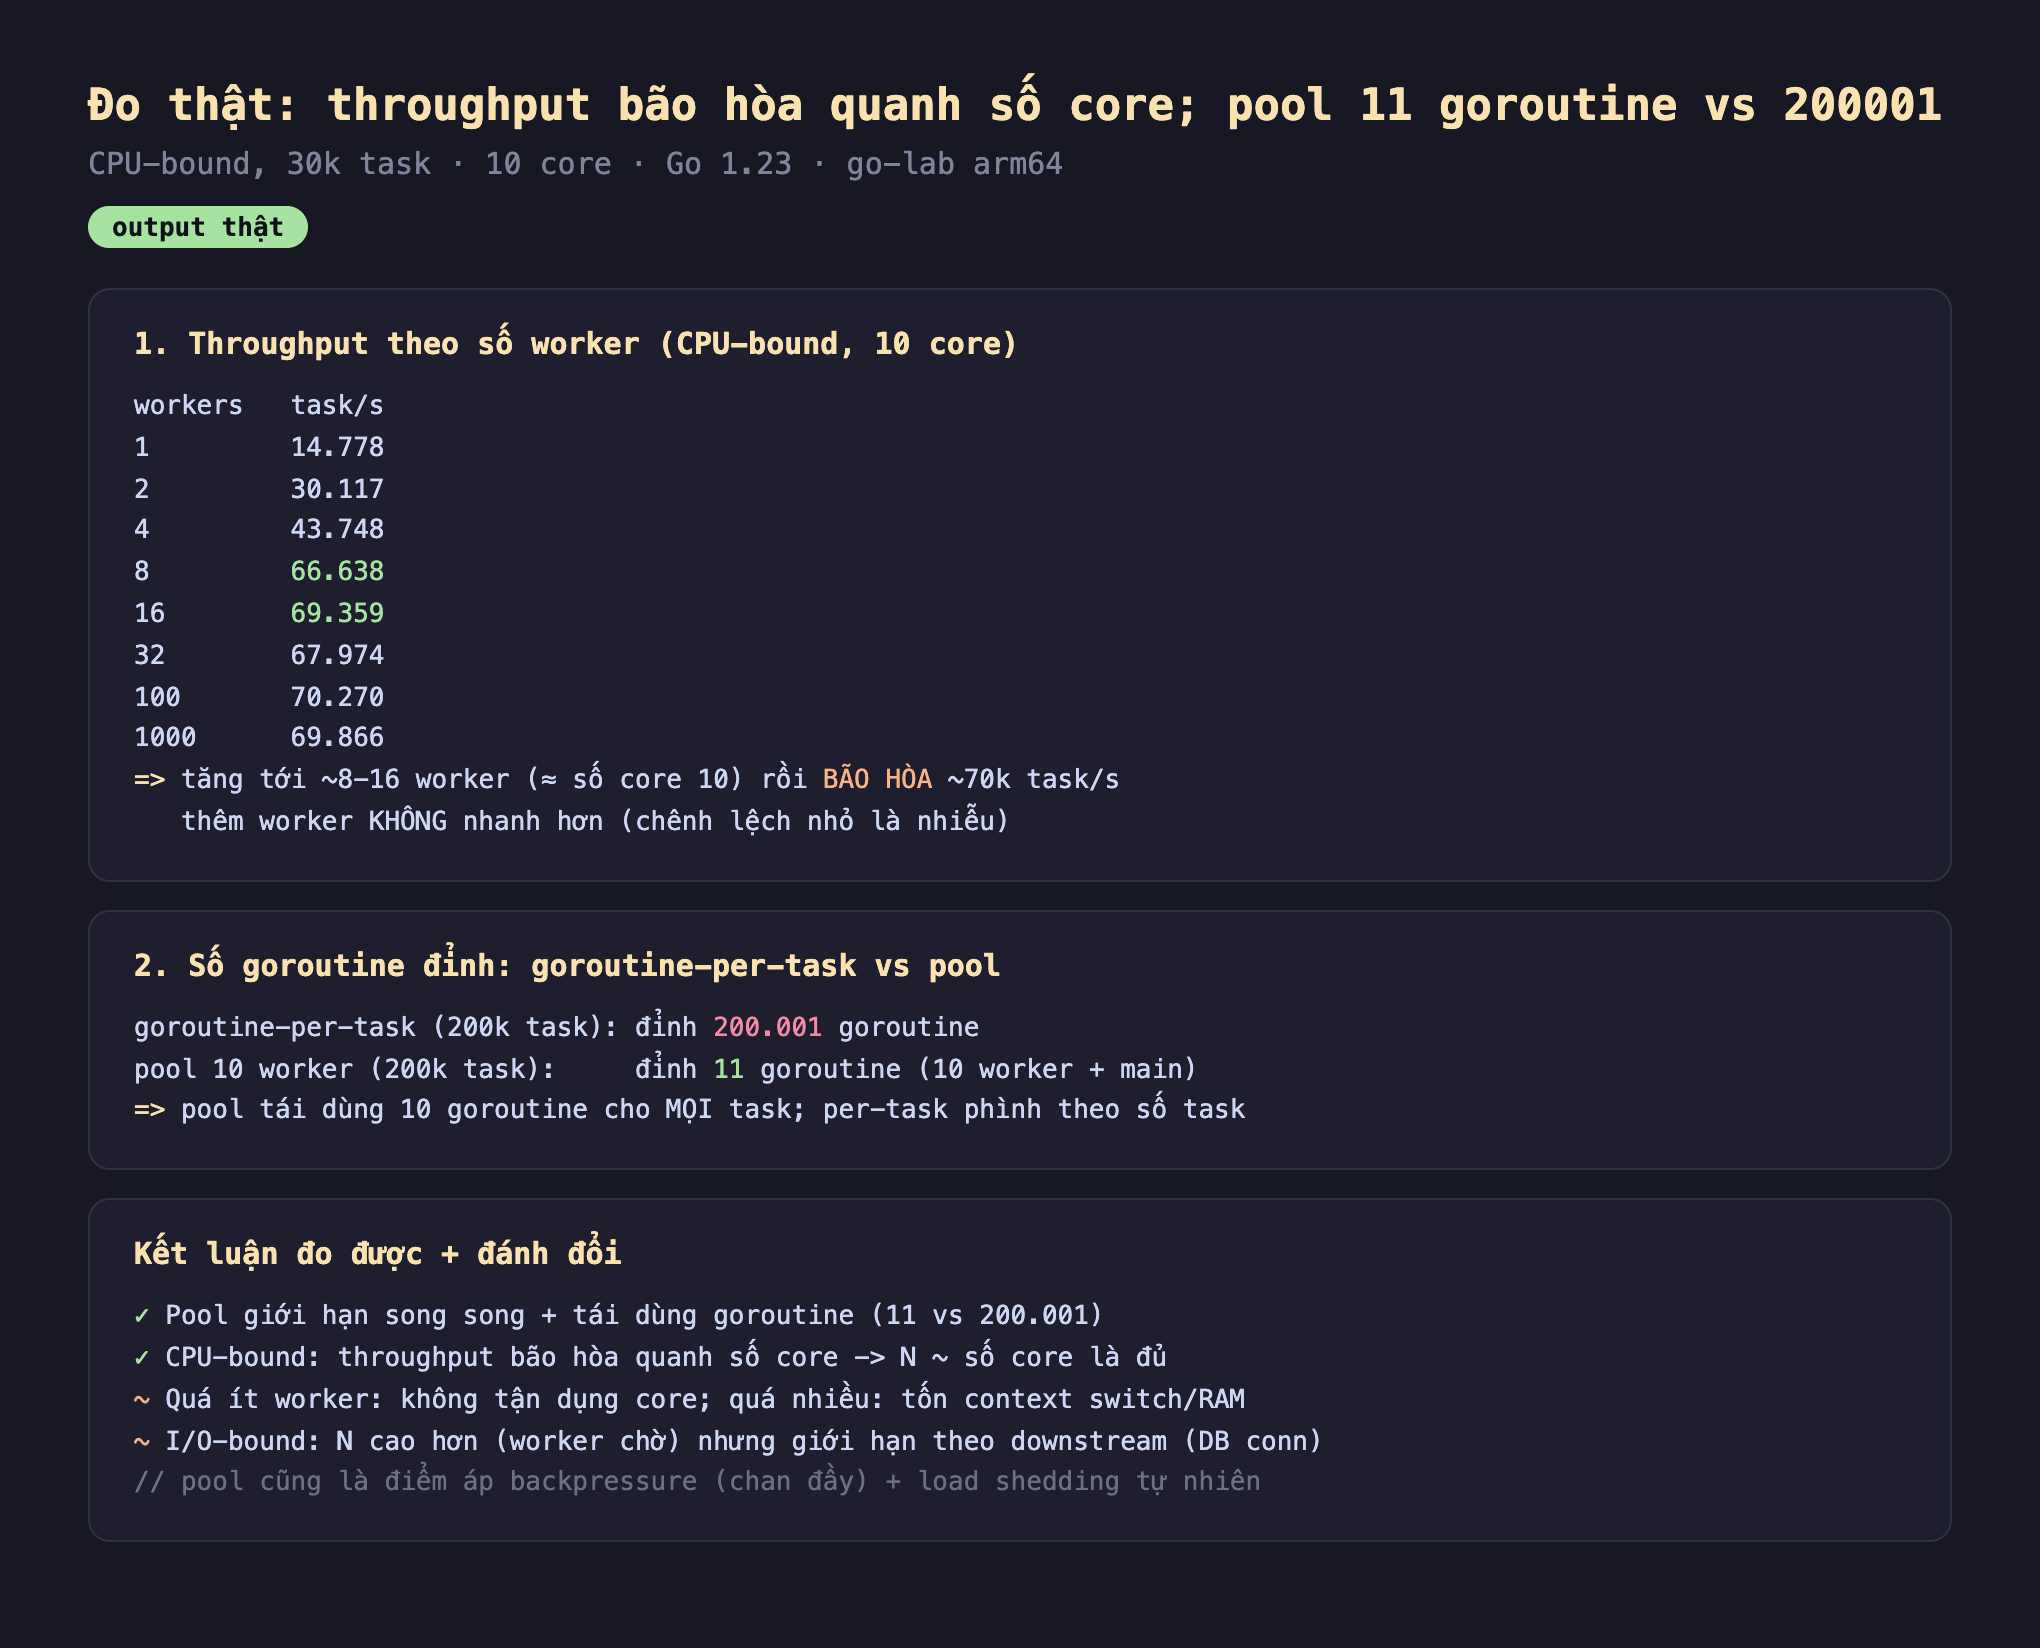
Hình 2: Chạy thật — throughput CPU-bound: 1 worker 14.778 task/s tăng dần tới ~70k ở 8-16 worker (≈ 10 core) rồi bão hòa; số goroutine: per-task 200.001 vs pool 10 worker chỉ 11.
Đọc kết quả đo được:
- Throughput tăng tới số core rồi bão hòa: 1 worker 14.778 task/s, 2 → 30k, 4 → 43k, 8 → 66k, 16 → 69k. Tới đây đạt trần ~70k task/s và dừng — 32, 100, 1000 worker đều quanh 70k (chênh lệch nhỏ là nhiễu đo). Với công việc CPU-bound, throughput bị chặn bởi số core (10): khi đã dùng hết core, thêm worker chỉ tạo thêm context switch chứ không có core nào rảnh để chạy.
- Goroutine: 11 vs 200.001: goroutine-per-task với 200.000 task tạo đỉnh 200.001 goroutine cùng tồn tại; worker pool 10 giữ đỉnh chỉ 11 (10 worker + main). Đây là khác biệt sống còn về tài nguyên: 200.000 goroutine × vài KB stack = hàng trăm MB RAM chỉ cho stack, chưa kể áp lực scheduler — trong khi pool giữ mức không đổi bất kể số task.
- Pool = kiểm soát, không phải giới hạn tốc độ: điều đẹp là pool không làm chậm khi N đủ lớn (throughput ở 16 worker ≈ 1000 worker), nó chỉ chặn phần thừa vô ích. Bạn được throughput tối đa mà không trả giá bùng nổ goroutine.
Đánh đổi cần cân nhắc
CPU-bound: N ≈ số core; I/O-bound: N cao hơn nhiều. Đây là quyết định quan trọng nhất. Với việc CPU-bound (tính toán), như đo được, N vượt số core là vô ích — throughput bão hòa. Với việc I/O-bound (chờ mạng, database, đĩa), worker phần lớn thời gian chờ chứ không ăn CPU, nên N có thể cao hơn số core nhiều lần để lấp thời gian chờ. Nhưng đừng đặt N vô hạn: giới hạn theo capacity downstream — nếu database chỉ chịu 50 kết nối, pool không nên có 500 worker cùng gọi nó.
Pool cũng là điểm áp backpressure và load shedding tự nhiên. Channel jobs có buffer chính là bounded queue (bài 5): khi đầy, người đẩy việc bị chặn (backpressure) hoặc có thể từ chối (load shedding, bài 6). Vậy worker pool không chỉ giới hạn song song mà còn là nơi tự nhiên để áp các mẫu kia — ba mẫu này thường đi cùng nhau trong một pipeline xử lý.
Đo để tìm N, đừng đoán. Con số "số core" là điểm khởi đầu tốt cho CPU-bound, nhưng workload thật thường hỗn hợp (vừa tính vừa chờ I/O). Cách đúng là đo throughput theo N như bài này trên workload thật của bạn, tìm điểm bão hòa. Đặt N ngay trước điểm đó — đủ để tận dụng, không thừa để lãng phí. Và nhớ GOMAXPROCS (mặc định = số core) là trần song song thực sự trên CPU, khác với số worker.
Ba ý mang về
- Worker pool chống bùng nổ goroutine: đo thật 200.000 task với goroutine-per-task tạo 200.001 goroutine, còn pool 10 worker chỉ 11 — pool tái dùng số goroutine cố định bất kể số task, tránh cạn RAM và đè scheduler.
- CPU-bound: throughput bão hòa quanh số core: đo thật throughput tăng tới ~70k task/s ở 8-16 worker (≈ 10 core) rồi dừng — thêm worker chỉ tốn context switch; N ≈ số core là đủ cho CPU-bound.
- Chọn N theo loại việc và downstream, đo đừng đoán: I/O-bound cần N cao hơn (worker chờ) nhưng giới hạn theo capacity downstream (số kết nối DB); pool cũng là điểm áp backpressure/load shedding; đo throughput theo N trên workload thật để tìm điểm bão hòa.
Nguồn
- Go blog — Go Concurrency Patterns: Pipelines and cancellation: https://go.dev/blog/pipelines
- Go docs — runtime.GOMAXPROCS: https://pkg.go.dev/runtime#GOMAXPROCS
- Go — golang.org/x/sync/errgroup (pool có giới hạn + lỗi): https://pkg.go.dev/golang.org/x/sync/errgroup
Phần sau ta sang caching và cache stampede — cache tăng tốc bằng cách nhớ kết quả, nhưng khi một key nóng hết hạn, hàng nghìn request cùng miss và cùng dội xuống database (stampede); đo thật singleflight gộp chúng thành một lần tính.
