Backpressure (bài 5) chặn nguồn khi hàng đợi đầy — hợp với producer nội bộ chờ được. Nhưng với request từ client, bắt họ chờ 5 giây rồi vẫn timeout thì tệ hơn từ chối thẳng. Load shedding là lựa chọn đó: khi tải vượt khả năng, từ chối bớt request ngay (trả 503) để những request được nhận vẫn được phục vụ nhanh. Nghe có vẻ tàn nhẫn — bỏ một phần khách — nhưng phương án còn lại (nhận hết) khiến tất cả cùng chậm và có khi sập cả hệ. Bài này (phần 6 loạt Hệ thống chịu tải) chạy thật để thấy con số.
Cơ chế: giới hạn in-flight, đầy thì từ chối ngay
Ý tưởng: giới hạn số request đang xử lý đồng thời (in-flight). Vượt ngưỡng → trả 503 ngay, không xếp hàng. Trong Go, dùng một semaphore (channel có buffer) với thao tác thử lấy không chờ:
sem := make(chan struct{}, 10)  // capacity: 10 request đồng thời
select {
case sem <- struct{}{}:   // còn slot -> xử lý
    time.Sleep(work); <-sem
default:                   // ĐẦY -> trả 503 NGAY, KHÔNG xếp hàng
    shed++                // từ chối sớm để không tích hàng đợi
}
Khác biệt cốt lõi với backpressure: backpressure chặn (nguồn chờ), load shedding từ chối (không chờ). Với client, "nhận 503 sau 1ms" tốt hơn nhiều "chờ 5 giây rồi timeout".
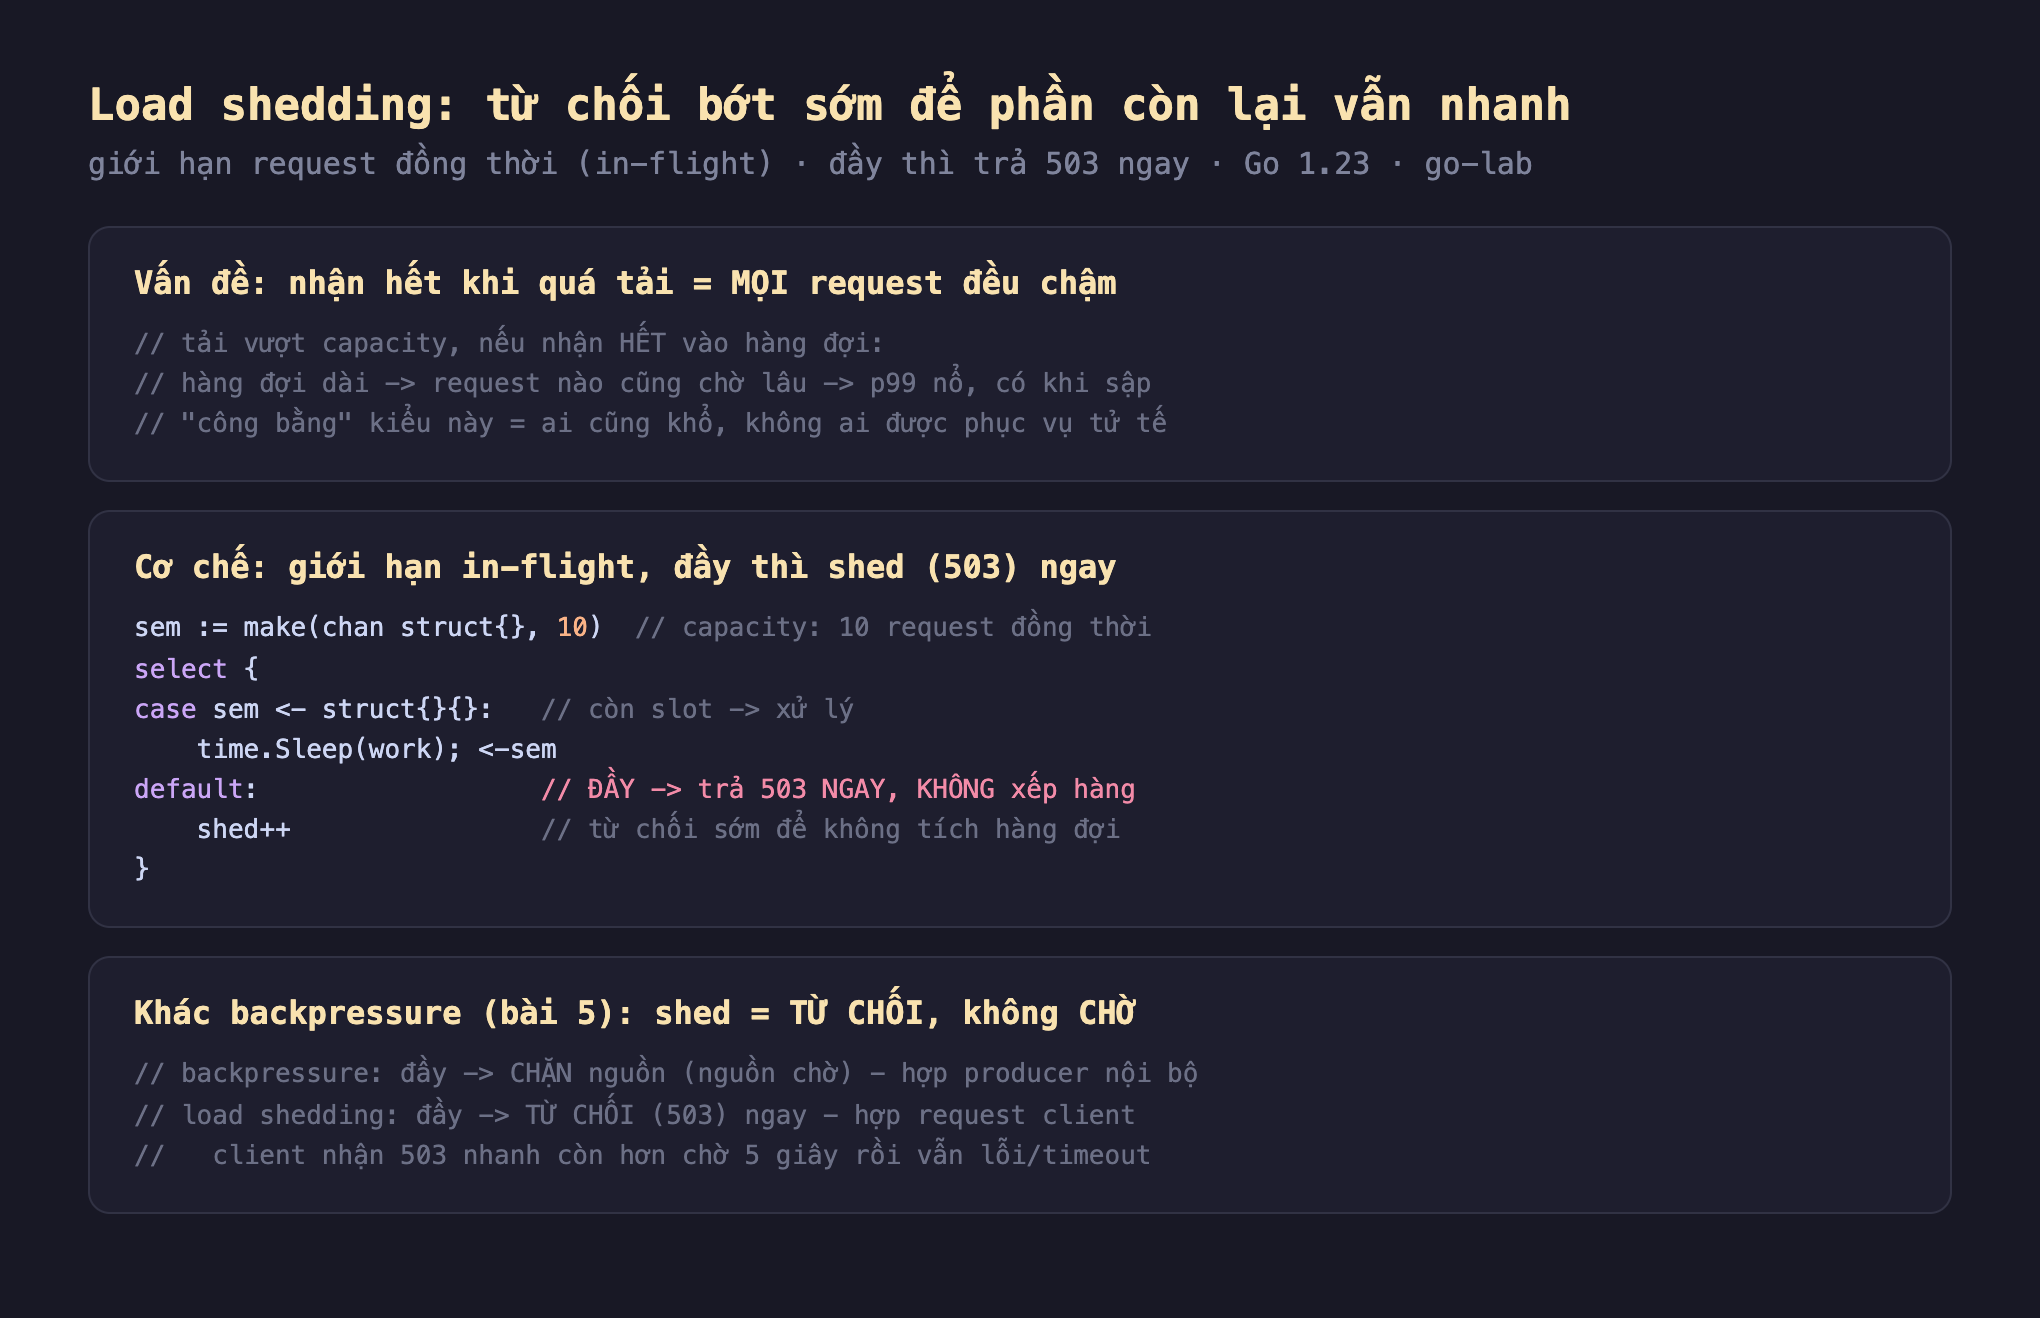
Hình 1: Load shedding giới hạn số request in-flight bằng semaphore; đầy thì trả 503 ngay không xếp hàng — khác backpressure (chặn/chờ), shed là từ chối, hợp với request client.
Đo thật: p99 4,8s vs 21ms
Mình giả lập server capacity 10 slot, mỗi request 20ms, bắn tải 2000 request (vượt xa capacity):
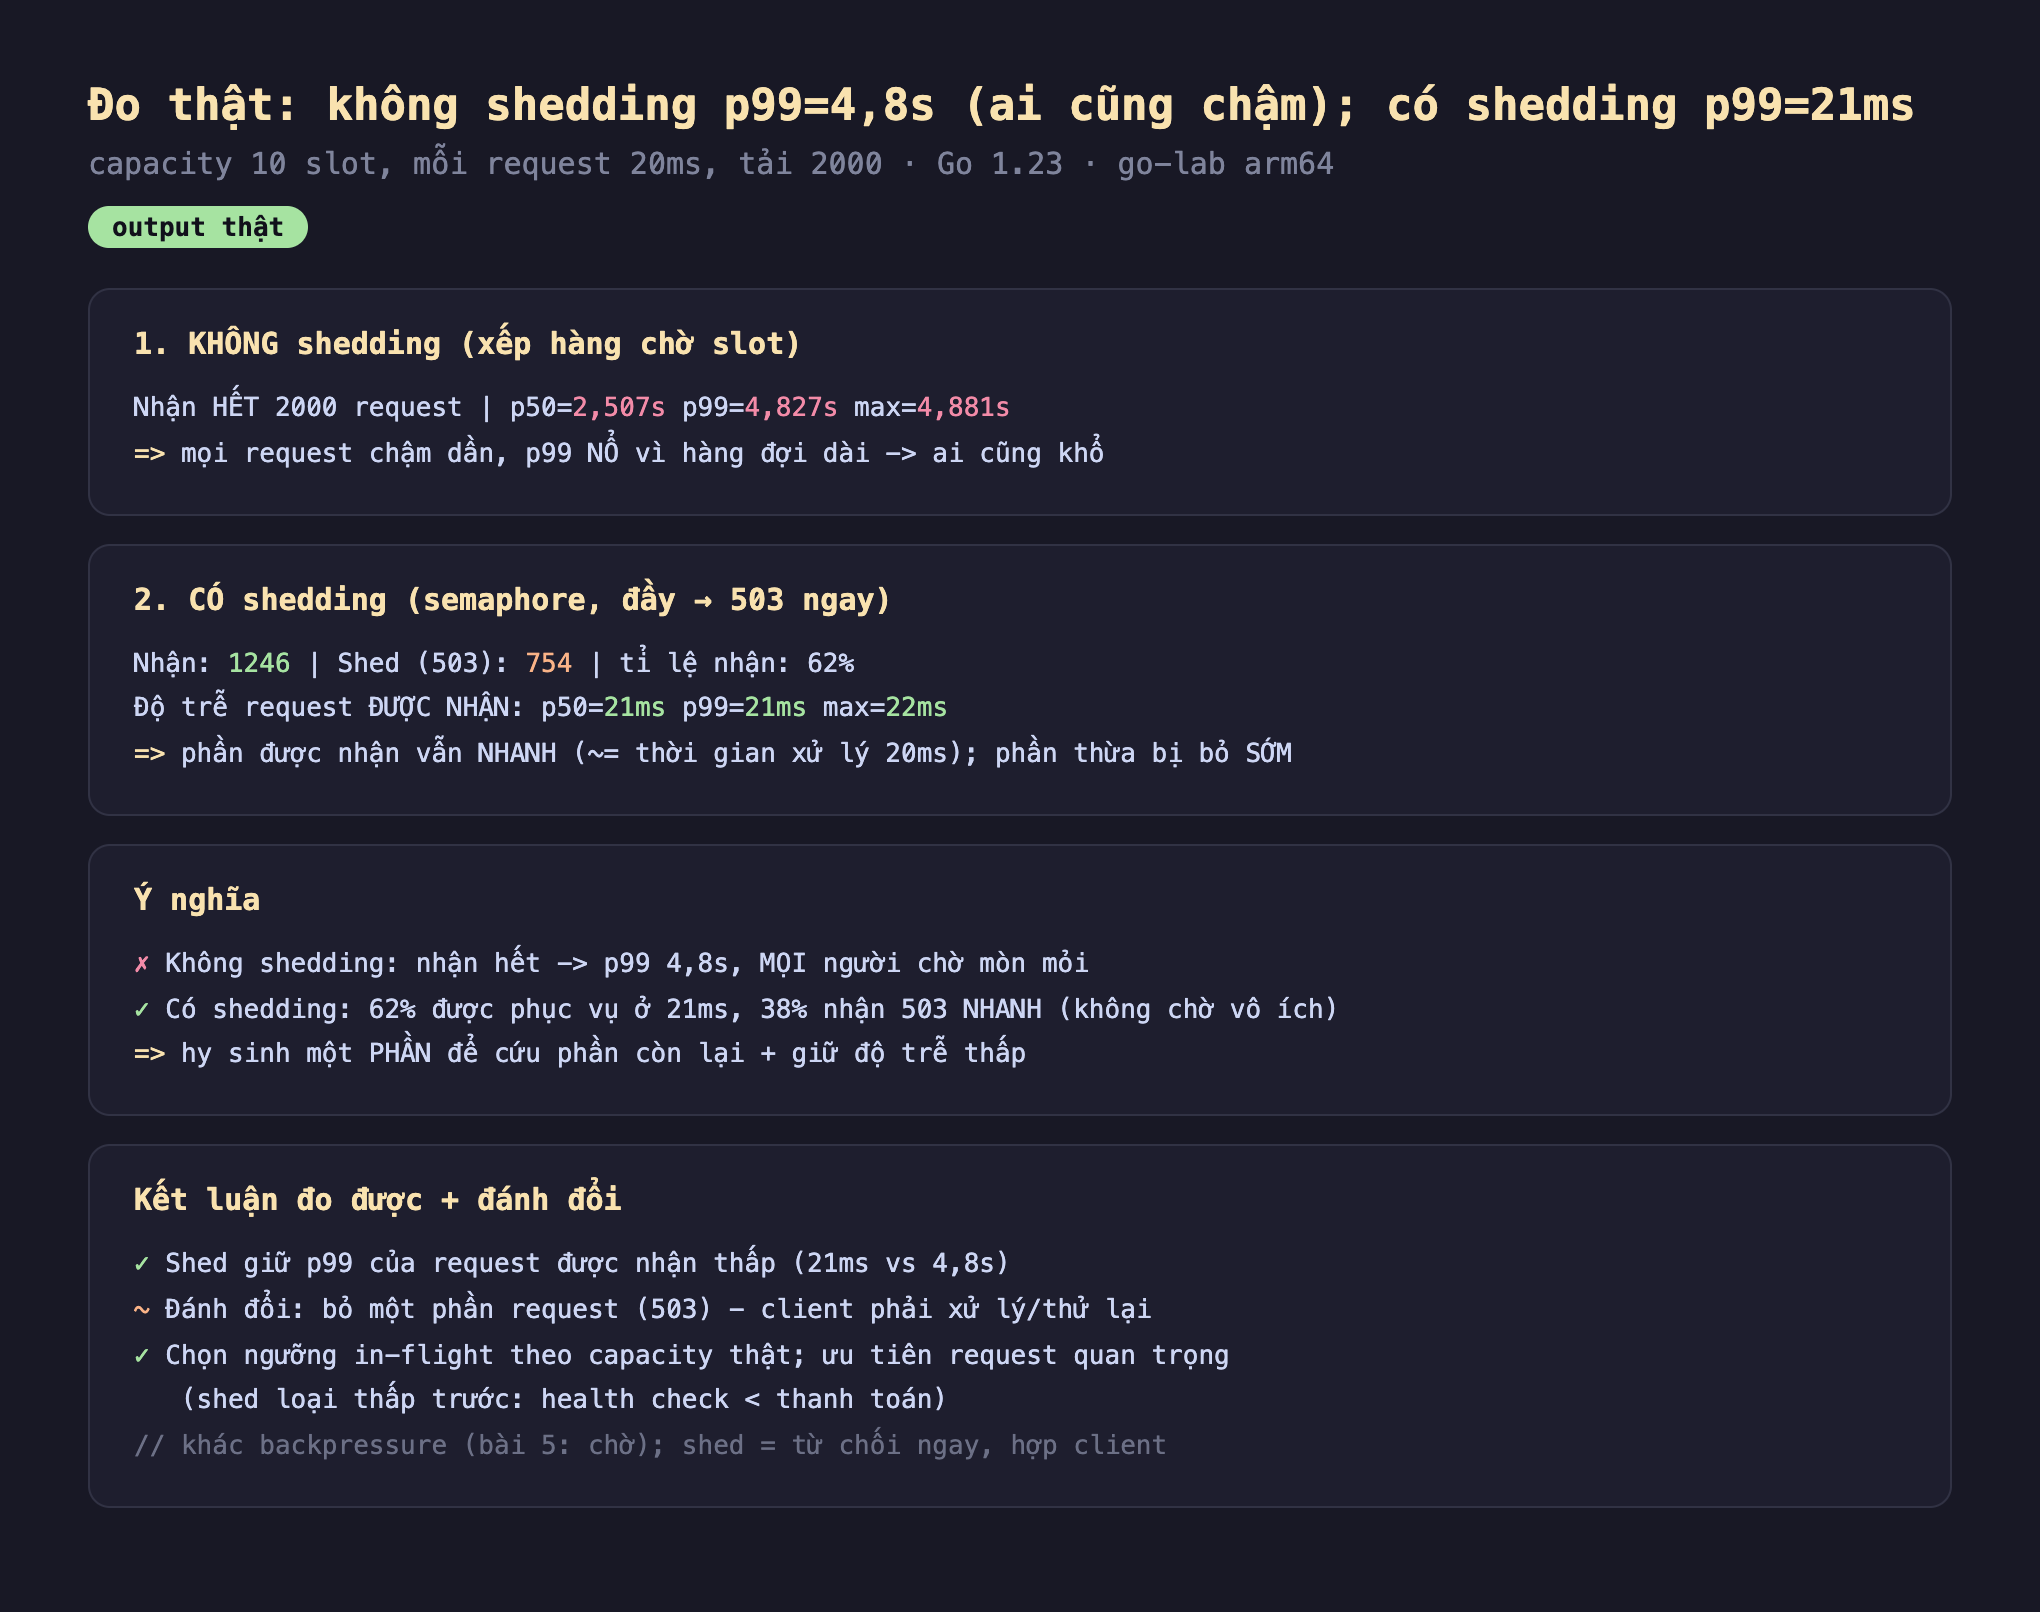
Hình 2: Chạy thật — không shedding: 2000 request nhận hết, p50=2,5s, p99=4,8s (ai cũng chậm); có shedding: nhận 1246 (62%), shed 754, độ trễ request được nhận p50=p99=21ms (~thời gian xử lý).
Đọc kết quả đo được:
- Không shedding: p99 nổ tung, ai cũng khổ: nhận hết 2000 request, tất cả xếp hàng chờ 10 slot. Kết quả: p50=2,5 giây, p99=4,8 giây. Không request nào bị từ chối, nhưng mọi request đều chậm khủng khiếp — thứ tự phục vụ "công bằng" này thực ra khiến ai cũng nhận trải nghiệm tệ, và với client thật thì hầu hết đã timeout từ lâu.
- Có shedding: 62% nhanh, 38% bị từ chối ngay: giới hạn in-flight 10, nhận 1246 request (62%), shed 754 (38%) với 503. Điều quan trọng: độ trễ của request được nhận là p50=p99=21ms — gần bằng đúng thời gian xử lý (20ms), không có chờ đợi thừa. Hệ phục vụ tốt phần nó có thể phục vụ.
- Bản chất: hy sinh một phần để cứu phần còn lại: đây là đánh đổi trung tâm của load shedding. Thay vì để quá tải làm hỏng trải nghiệm của tất cả (và có khi sập), ta chấp nhận từ chối một phần sớm và rõ ràng để phần còn lại được phục vụ đúng chất lượng. 62% khách hài lòng + 38% nhận lỗi nhanh (có thể thử lại) tốt hơn 100% khách chờ mòn mỏi.
Đánh đổi cần cân nhắc
Shed thông minh: ưu tiên request quan trọng, bỏ loại thấp trước. Không phải mọi request đáng giá như nhau. Khi phải bỏ, nên bỏ theo thứ tự ưu tiên: health check nội bộ, prefetch, analytics có thể bỏ trước; thanh toán, đăng nhập giữ lại. Cài đặt: phân loại request và dùng ngưỡng khác nhau (hoặc hàng riêng) cho từng loại — khi tải cao, loại thấp bị shed ở ngưỡng thấp hơn. Shed mù (bỏ ngẫu nhiên) tốt hơn không shed, nhưng shed theo ưu tiên tốt hơn nhiều.
Chọn ngưỡng in-flight theo capacity thật, không theo phỏng đoán. Ngưỡng quá cao → shed quá muộn, độ trễ đã nổ trước khi shed kích hoạt. Quá thấp → shed oan khi hệ còn chịu được. Cách đúng: đo số request đồng thời tối đa mà hệ giữ được độ trễ chấp nhận (như các bài đo throughput), đặt ngưỡng quanh đó. Nâng cao hơn: adaptive load shedding — tự điều chỉnh ngưỡng theo độ trễ đo được thời gian thực (khi p99 tăng thì shed mạnh hơn).
Load shedding và backpressure bổ sung nhau, không thay thế. Chúng là hai cách xử lý "đầy": backpressure chặn/chờ (hợp luồng nội bộ, producer chịu được chậm), load shedding từ chối (hợp request client cần phản hồi nhanh). Một hệ tốt dùng cả hai ở các tầng khác nhau: shed ở biên (từ chối client thừa sớm), backpressure ở trong (điều tiết pipeline nội bộ). Và cả hai đều cần đo — không có con số thì không biết ngưỡng đúng.
Ba ý mang về
- Nhận hết khi quá tải khiến mọi request chậm: đo thật 2000 request không shedding có p50=2,5s, p99=4,8s — "công bằng" kiểu xếp hàng khiến ai cũng khổ và client thật đã timeout.
- Load shedding giữ p99 thấp cho phần được nhận: đo thật có shedding phục vụ 62% ở p99=21ms (gần bằng thời gian xử lý), 38% nhận 503 ngay — hy sinh một phần để cứu phần còn lại + giữ độ trễ.
- Shed theo ưu tiên, ngưỡng theo capacity thật, kết hợp backpressure: bỏ loại thấp trước (health check < thanh toán); đặt ngưỡng in-flight quanh capacity đo được (adaptive càng tốt); shed ở biên + backpressure ở trong.
Nguồn
- Google SRE Book — Handling Overload (load shedding, graceful degradation): https://sre.google/sre-book/handling-overload/
- Netflix — Performance Under Load (adaptive concurrency limits): https://netflixtechblog.medium.com/performance-under-load-3e6fa9a60581
- Go docs — golang.org/x/sync/semaphore: https://pkg.go.dev/golang.org/x/sync/semaphore
Phần sau ta gặp cách kiểm soát song song ở phía xử lý: worker pool — giới hạn số goroutine làm việc đồng thời để không tạo vô hạn goroutine; đo thật throughput theo số worker và tìm điểm bão hòa.
