Loạt bài này mở màn bằng Bloom filter (phần 1): một cấu trúc tuyệt vời để hỏi "phần tử này có thể đã thấy chưa?" với bộ nhớ tí hon. Nhưng Bloom có hai nhược điểm khó chịu. Thứ nhất: không xóa được — muốn xóa một phần tử phải tắt các bit của nó, nhưng những bit đó dùng chung với phần tử khác, tắt đi là làm hỏng cả chúng (Counting Bloom ở phần 3 xóa được nhưng tốn gấp 4 lần bộ nhớ). Thứ hai: ở cùng mức bộ nhớ, khi ta cần tỉ lệ dương tính giả (FPP) thật thấp, Bloom không phải lựa chọn tối ưu.
Cuckoo filter (Fan và cộng sự, 2014) giải cả hai. Nó xóa được phần tử, tra cứu chỉ chạm đúng 2 bucket, và ở vùng FPP thấp thường tiết kiệm hơn Bloom. Bài này (phần 11 loạt Cấu trúc dữ liệu xác suất) tự cài một Cuckoo filter bằng Python và chạy thật để đo load factor, FPP, và chứng minh thao tác xóa.
Cơ chế: fingerprint và hai bucket khả dĩ
Ý tưởng cốt lõi: thay vì bật bit như Bloom, Cuckoo filter lưu một fingerprint — vài bit băm của phần tử (ví dụ 12 bit) — vào một bucket (ô chứa được vài fingerprint). Mỗi phần tử có hai bucket khả dĩ, tính theo cuckoo hashing bán phần:
fp = hash(x) & mask           # fingerprint: vài bit "vân tay" của x
i1 = hash(x) % nb             # bucket thứ nhất
i2 = i1 ^ (hash(fp) % nb)     # bucket thay thế
Điểm tinh tế: i2 = i1 XOR hash(fp). Phép XOR là đối xứng, nên từ i2 ta tính lại được i1 = i2 XOR hash(fp) chỉ cần biết fingerprint — không cần lưu khóa gốc x. Đây là mấu chốt để tra cứu và di chuyển fingerprint mà không giữ dữ liệu gốc.
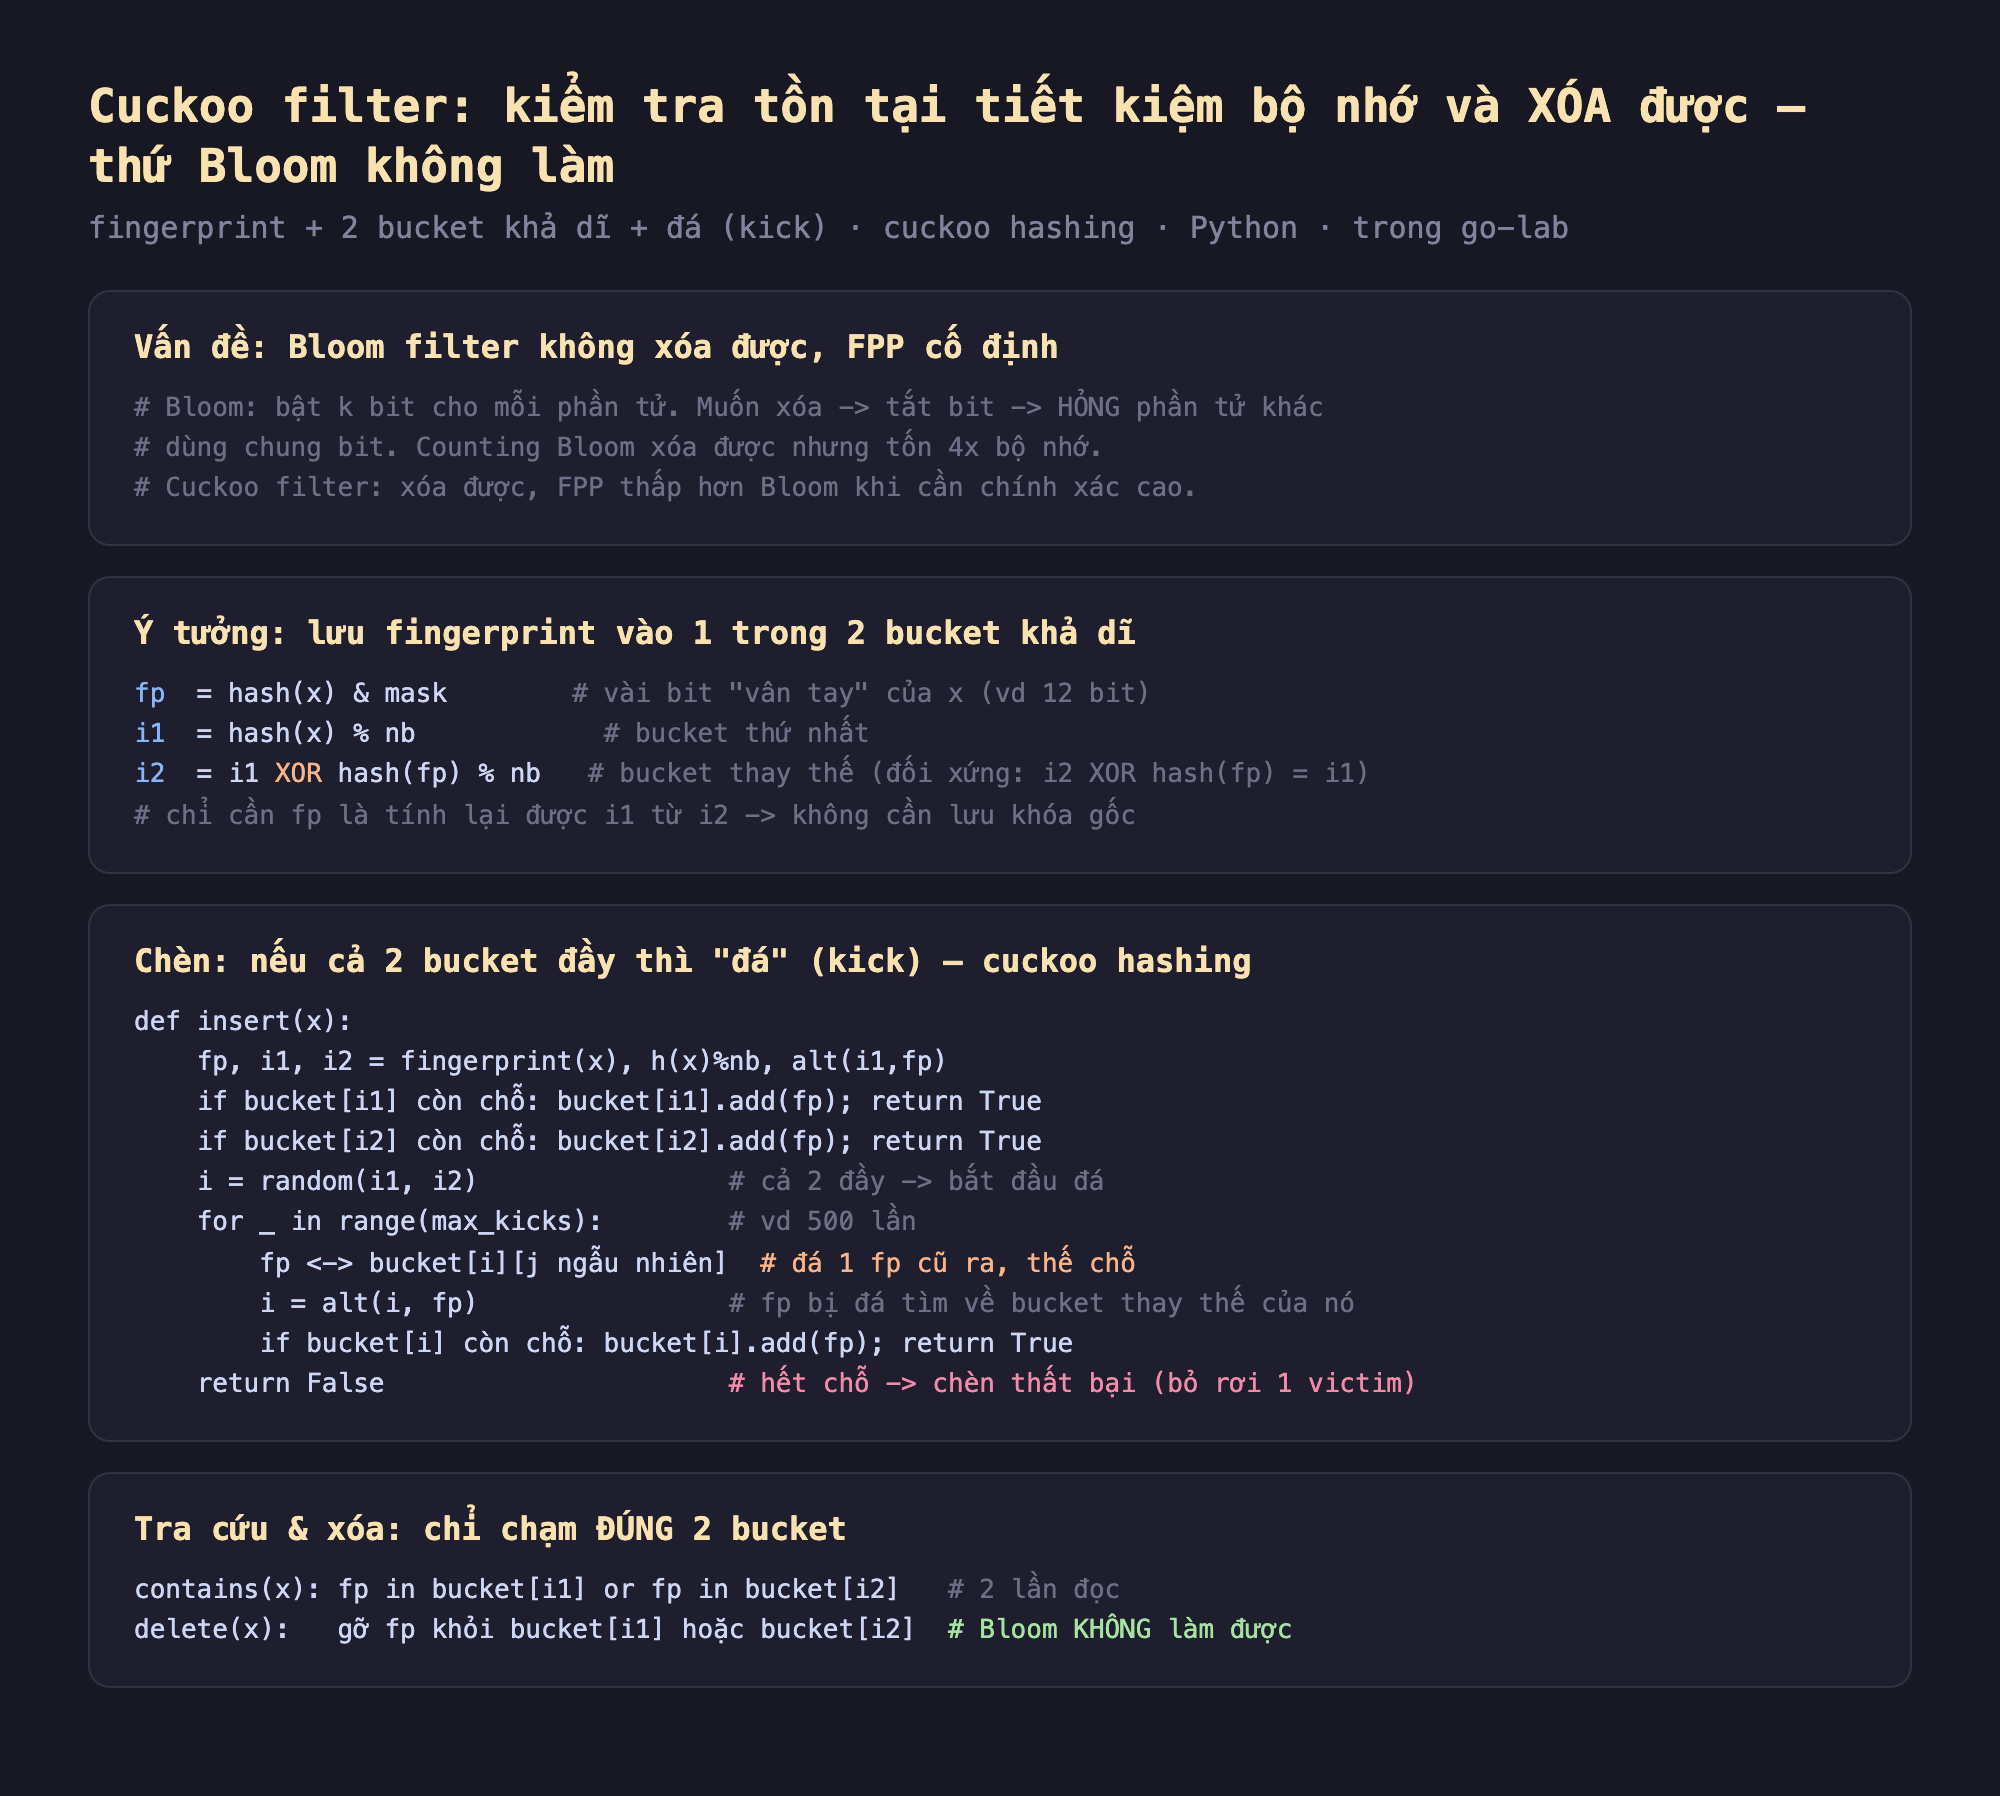
Hình 1: Cuckoo filter lưu fingerprint vào một trong hai bucket i1, i2 = i1 XOR hash(fp); khi cả hai đầy thì "đá" (kick) một fingerprint hiện có sang bucket thay thế của nó, lặp lại tối đa ~500 lần; tra cứu và xóa chỉ chạm đúng 2 bucket.
Chèn: khi cả hai bucket đầy thì "đá"
Nếu một trong hai bucket còn chỗ, chèn thẳng. Nhưng nếu cả hai đầy, ta không bỏ cuộc mà đá (kick): chọn ngẫu nhiên một bucket, lấy một fingerprint hiện có ra và đặt fingerprint mới vào chỗ đó; fingerprint bị đá ra phải tìm về bucket thay thế của chính nó — nếu chỗ đó cũng đầy, nó lại đá tiếp một fingerprint khác. Quá trình này (đúng như tập tính chim cu cu đẩy trứng khác ra khỏi tổ) lặp tới một số lần tối đa:
def insert(self, x):
    fp, i1 = self._fp(x), self._i1(x)
    i2 = self._i2(i1, fp)
    if len(self.buckets[i1]) < self.bs: self.buckets[i1].append(fp); return True
    if len(self.buckets[i2]) < self.bs: self.buckets[i2].append(fp); return True
    i = random.choice([i1, i2])               # cả 2 đầy -> bắt đầu đá
    for _ in range(self.max_kicks):           # ví dụ 500 lần
        j = random.randrange(len(self.buckets[i]))
        fp, self.buckets[i][j] = self.buckets[i][j], fp   # hoán đổi: đá fp cũ ra
        i = self._i2(i, fp)                   # fp bị đá về bucket thay thế của nó
        if len(self.buckets[i]) < self.bs: self.buckets[i].append(fp); return True
    return False                              # hết chỗ sau max_kicks -> thất bại
Tra cứu và xóa đều chỉ đọc đúng hai bucket: contains kiểm fingerprint có trong buckets[i1] hoặc buckets[i2]; delete gỡ nó ra khỏi bucket chứa nó.
Đo thật: 249.036 phần tử, load 95%, FPP 0,18%
Mình cài Cuckoo filter (bucket 4 ô, fingerprint 12 bit, 65.536 bucket) và nạp tới 95% sức chứa, rồi đo:
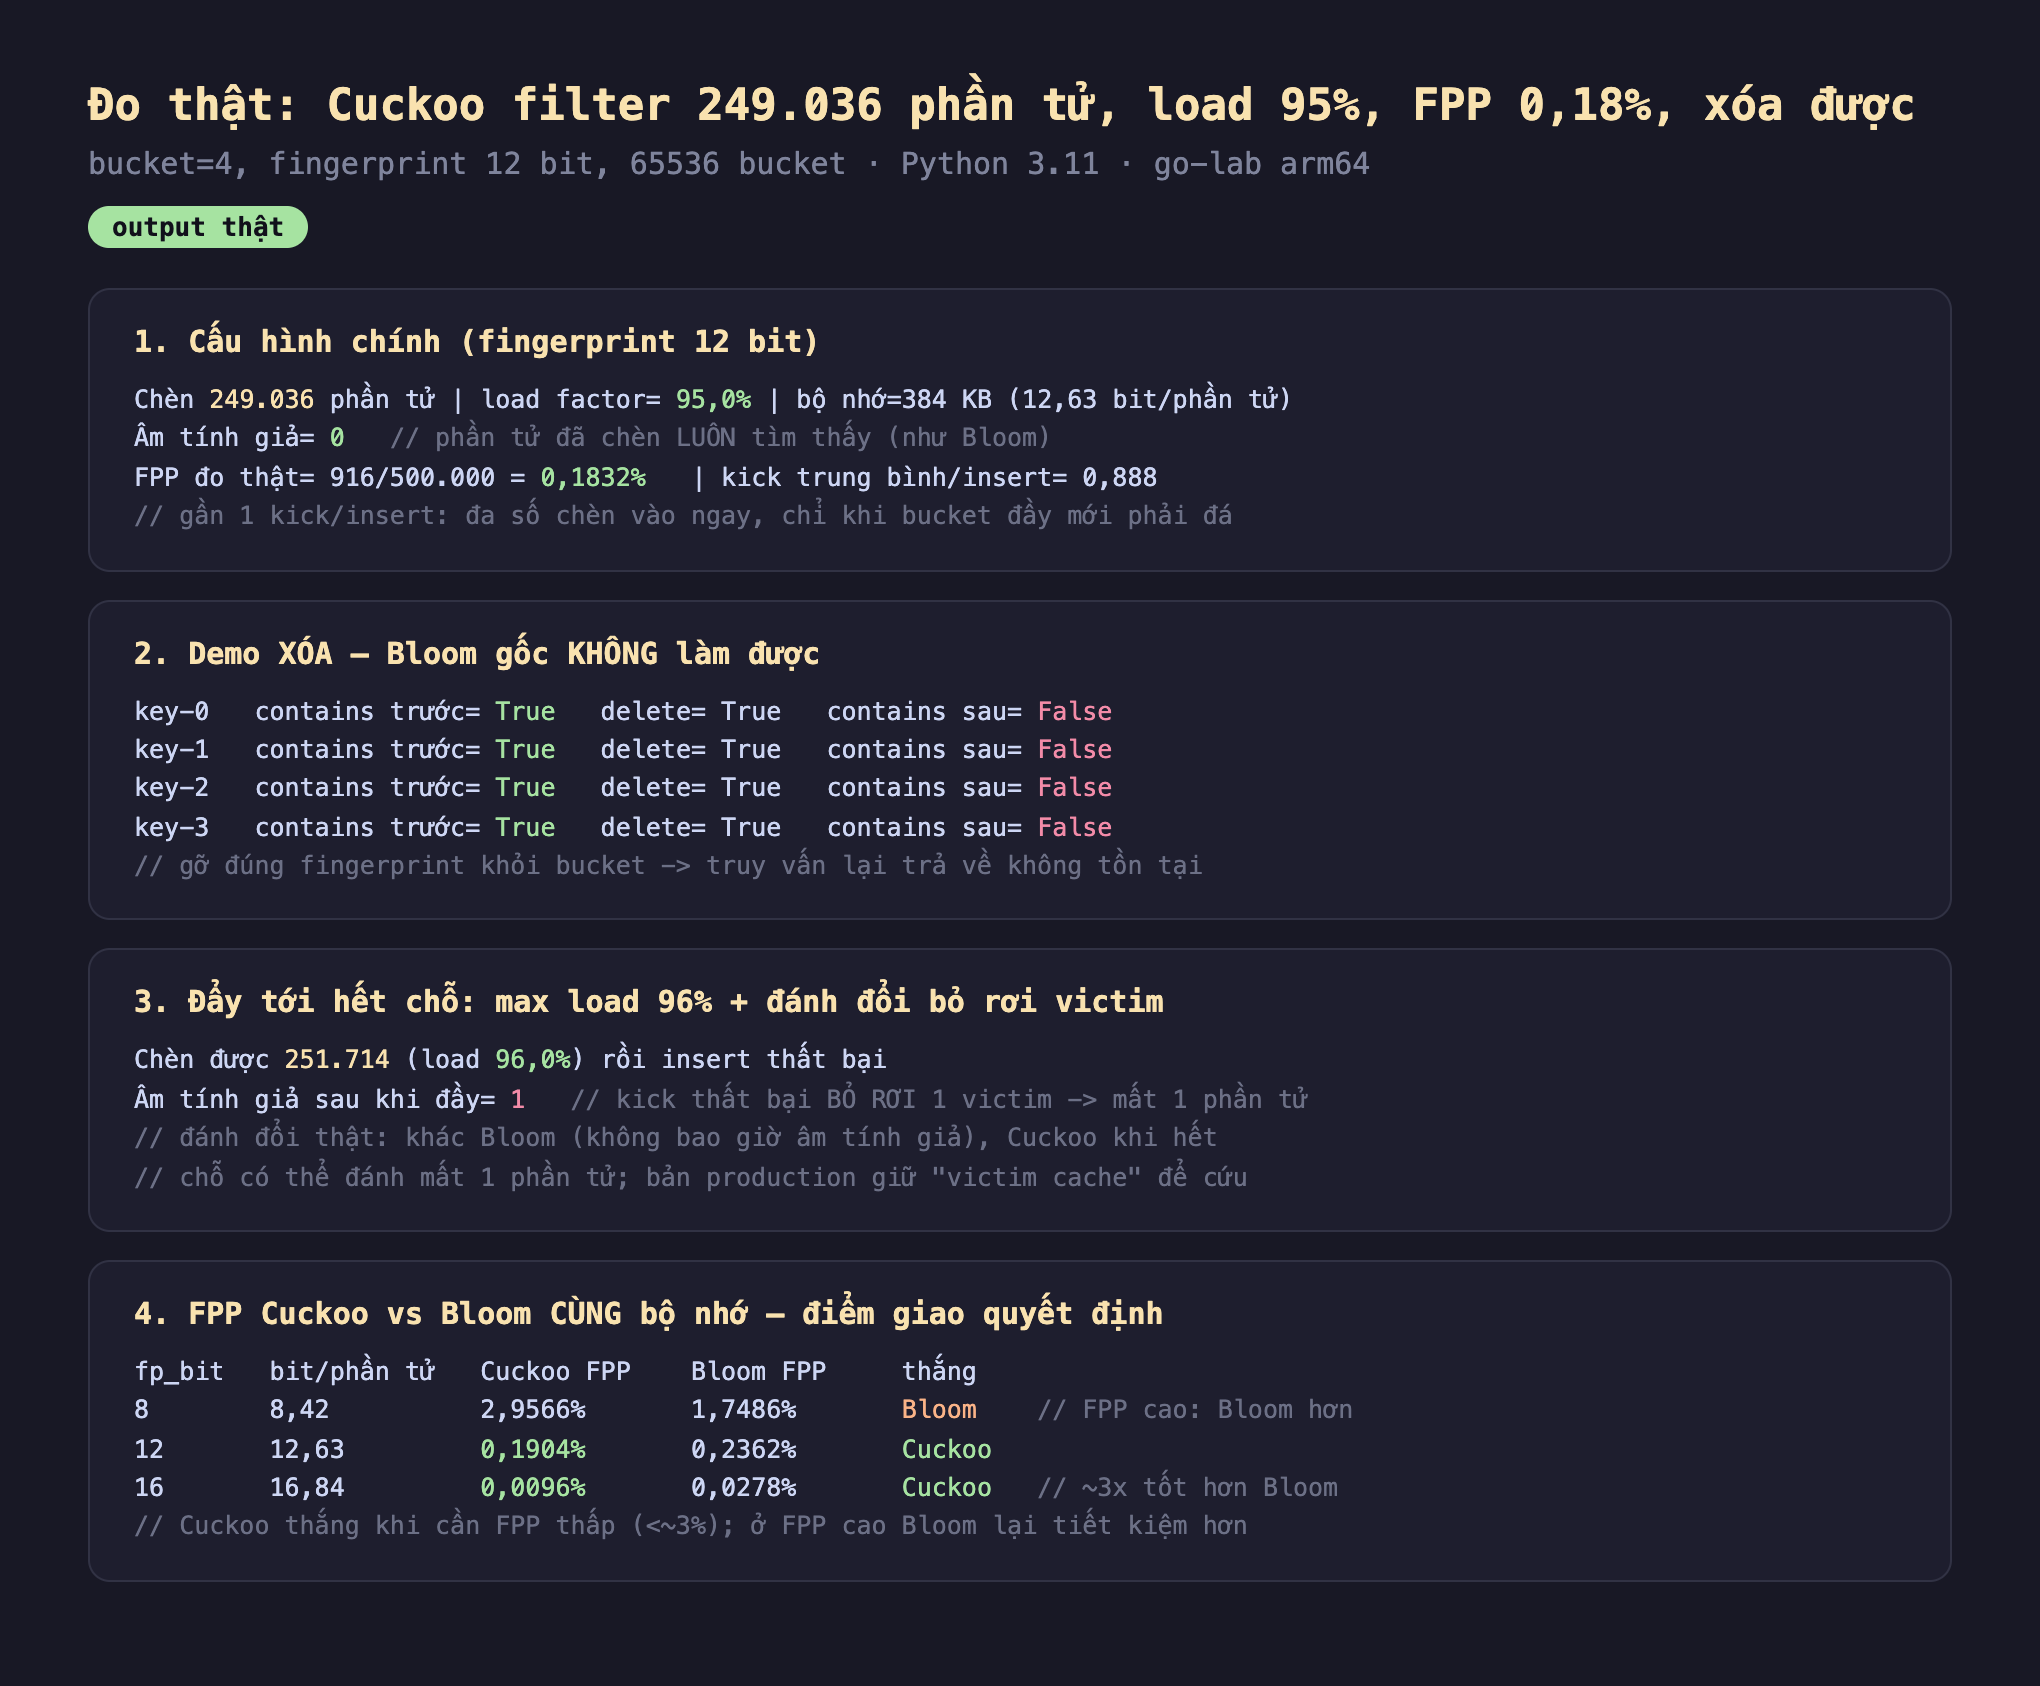
Hình 2: Chạy thật — Cuckoo filter fingerprint 12 bit chèn 249.036 phần tử ở load 95% (384 KB, 12,63 bit/phần tử), 0 âm tính giả, FPP đo thật 0,1832%, trung bình 0,888 kick/insert; demo xóa 4/4 thành công; đẩy tới hết chỗ đạt max load 96% và để lộ đánh đổi bỏ rơi victim; bảng FPP Cuckoo vs Bloom cùng bộ nhớ theo số bit fingerprint.
Đọc kết quả thật:
- Load factor cao, bộ nhớ gọn: nhét được 249.036 phần tử ở 95% sức chứa, dùng 384 KB (12,63 bit/phần tử). Cuckoo hashing với bucket 4 ô cho phép nạp rất đặc trước khi hết chỗ — hiệu suất không gian tốt.
- Không âm tính giả (ở load an toàn): cả 249.036 phần tử đã chèn đều
contains = True— 0 âm tính giả, đúng cam kết giống Bloom: đã chèn thì luôn tìm thấy. - FPP đo thật 0,1832%: truy vấn 500.000 phần tử không thuộc tập, chỉ 916 cái bị báo nhầm là có. Sát lý thuyết
2·b/2^f = 2·4/4096 ≈ 0,195%. - Gần 1 kick/insert: trung bình 0,888 lần đá mỗi lần chèn — đa số phần tử vào thẳng bucket còn chỗ, chỉ khi đầy mới phải đá dây chuyền. Chèn nhanh khi load chưa quá cao.
- Xóa hoạt động: xóa 4 phần tử,
containstrước = True, sau = False. Đây chính là thứ Bloom gốc không làm được.
Điểm giao với Bloom: Cuckoo không phải lúc nào cũng thắng
Câu hỏi quan trọng: Cuckoo có thật tốt hơn Bloom ở cùng bộ nhớ không? Mình đo FPP của cả hai với cùng số bit, thay đổi kích thước fingerprint:
- fingerprint 8 bit (8,42 bit/phần tử): Cuckoo FPP 2,96% vs Bloom 1,75% — Bloom thắng.
- fingerprint 12 bit (12,63 bit/phần tử): Cuckoo 0,19% vs Bloom 0,24% — Cuckoo thắng.
- fingerprint 16 bit (16,84 bit/phần tử): Cuckoo 0,0096% vs Bloom 0,028% — Cuckoo thắng, tốt hơn ~3 lần.
Đây là kết luận trung thực và quan trọng: Cuckoo filter thắng Bloom khi ta cần FPP thấp (dưới ~3%) — càng cần chính xác cao, khoảng cách càng rộng. Nhưng ở vùng FPP cao (fingerprint ngắn), Bloom lại tiết kiệm bộ nhớ hơn. Điều này khớp đúng phân tích trong bài báo gốc của Fan (2014): điểm giao nằm quanh FPP 3%. Đừng chọn Cuckoo chỉ vì nó "mới hơn"; chọn theo FPP mục tiêu.
Đánh đổi cần cân nhắc
Chèn có thể thất bại và làm mất một phần tử. Khi đẩy tới hết chỗ (đo thật: max load 96%), một dây chuyền kick chạy hết 500 lần mà không tìm được chỗ sẽ trả về thất bại — và fingerprint đang "cầm trên tay" (victim) bị bỏ rơi. Đo thật cho thấy sau khi filter đầy, xuất hiện 1 âm tính giả vì đúng cơ chế này. Khác hẳn Bloom (không bao giờ âm tính giả). Bản cài production giữ một "victim cache" nhỏ để cứu phần tử này, và ta nên coi 95% là ngưỡng an toàn, không nạp tới sát trần.
Fingerprint trùng giới hạn số lần chèn cùng một phần tử. Vì mỗi bucket chỉ chứa b bản sao của một fingerprint và có 2 bucket, ta không thể chèn cùng một khóa (hay các khóa trùng fingerprint trong cùng cặp bucket) quá 2b lần. Với ứng dụng cho phép trùng nhiều, cần bucket lớn hơn hoặc fingerprint dài hơn — hoặc dùng cấu trúc khác.
Xóa chỉ an toàn nếu phần tử chắc chắn đã được chèn. delete gỡ một fingerprint khớp khỏi bucket. Nếu ta xóa một phần tử chưa từng chèn nhưng fingerprint của nó tình cờ trùng với phần tử khác, ta sẽ xóa nhầm phần tử kia — gây âm tính giả cho nó. Chỉ gọi delete cho phần tử mà ứng dụng bảo đảm đã có trong filter.
Ba ý mang về
- Cuckoo filter xóa được và tra cứu chỉ chạm 2 bucket: đo thật chèn 249.036 phần tử ở load 95%, 0 âm tính giả, FPP 0,18%, và xóa 4/4 thành công (
containssau xóa = False) — giải đúng nhược điểm không-xóa-được của Bloom gốc mà không tốn 4× như Counting Bloom. - Cuckoo thắng Bloom ở vùng FPP thấp, thua ở FPP cao: đo thật cùng bộ nhớ, fingerprint 8 bit Bloom thắng (1,75% vs 2,96%) nhưng 12–16 bit Cuckoo thắng (16 bit: 0,0096% vs 0,028%, tốt hơn ~3 lần) — chọn theo FPP mục tiêu, điểm giao quanh 3%.
- Đánh đổi thật: chèn có thể thất bại và mất victim: đo thật đẩy tới max load 96% thì kick thất bại bỏ rơi 1 phần tử (xuất hiện 1 âm tính giả), khác Bloom vốn không bao giờ âm tính giả — nên giữ load ở mức an toàn và dùng victim cache trong production.
Nguồn
- Bin Fan, Dave Andersen, Michael Kaminsky, Michael Mitzenmacher — Cuckoo Filter: Practically Better Than Bloom (CoNEXT 2014): https://www.cs.cmu.edu/~dga/papers/cuckoo-conext2014.pdf
- Kho tham khảo — efficient/cuckoofilter (C++): https://github.com/efficient/cuckoofilter
- Bản Go — seiflotfy/cuckoofilter: https://github.com/seiflotfy/cuckoofilter
Phần sau là bài tổng kết loạt: điểm lại toàn bộ 12 cấu trúc dữ liệu xác suất đã học (Bloom, Counting Bloom, HyperLogLog, Count-Min, MinHash, reservoir, t-digest, Cuckoo...) và một cây quyết định thực dụng — với câu hỏi nào thì chọn sketch nào, và khi nào không nên dùng ước lượng.
