Suốt 11 phần trước, ta đã đi qua một họ cấu trúc dữ liệu có chung một triết lý: đổi một chút sai số để lấy bộ nhớ nhỏ hơn nhiều lần (thường là hằng số, không tăng theo dữ liệu). Chúng được gọi chung là sketch hay cấu trúc dữ liệu xác suất. Bài cuối này (phần 12) không giới thiệu cấu trúc mới — nó trả lời câu hỏi thực dụng nhất: khi đứng trước một bài toán, chọn cái nào? Và để không chỉ nói suông, mình chạy thật cả năm cấu trúc chính trên cùng một luồng dữ liệu rồi đặt lên bàn cân bộ nhớ và sai số.
Điểm lại: mỗi cấu trúc trả lời một câu hỏi
Chìa khóa để chọn đúng là nhận ra mỗi sketch sinh ra để trả lời một loại câu hỏi cụ thể:
- "Phần tử X đã từng xuất hiện chưa?" (tồn tại/thành viên) → Bloom filter (phần 1–2). Cần xóa phần tử → Counting Bloom (phần 3, tốn 4× bộ nhớ) hoặc Cuckoo filter (phần 11, xóa được và FPP thấp hơn ở cùng bộ nhớ).
- "Có bao nhiêu phần tử PHÂN BIỆT?" (đếm cardinality) → HyperLogLog và bản cải tiến HLL++ (phần 4–5): đếm hàng triệu key phân biệt bằng vài KB.
- "Phần tử X xuất hiện BAO NHIÊU lần?" (tần suất) → Count-Min Sketch (phần 6); cần top-K key nóng → Count-Min ghép heap (phần 7).
- "Hai tập GIỐNG nhau bao nhiêu?" (độ tương tự Jaccard) → MinHash (phần 8).
- "Lấy MẪU đại diện của luồng?" (sampling) → Reservoir sampling (phần 9): k mẫu đều, một lượt, không cần biết trước độ dài.
- "PERCENTILE p50/p99/p999 là bao nhiêu?" (phân vị) → t-digest (phần 10): ước lượng percentile mà không sort cả mảng.
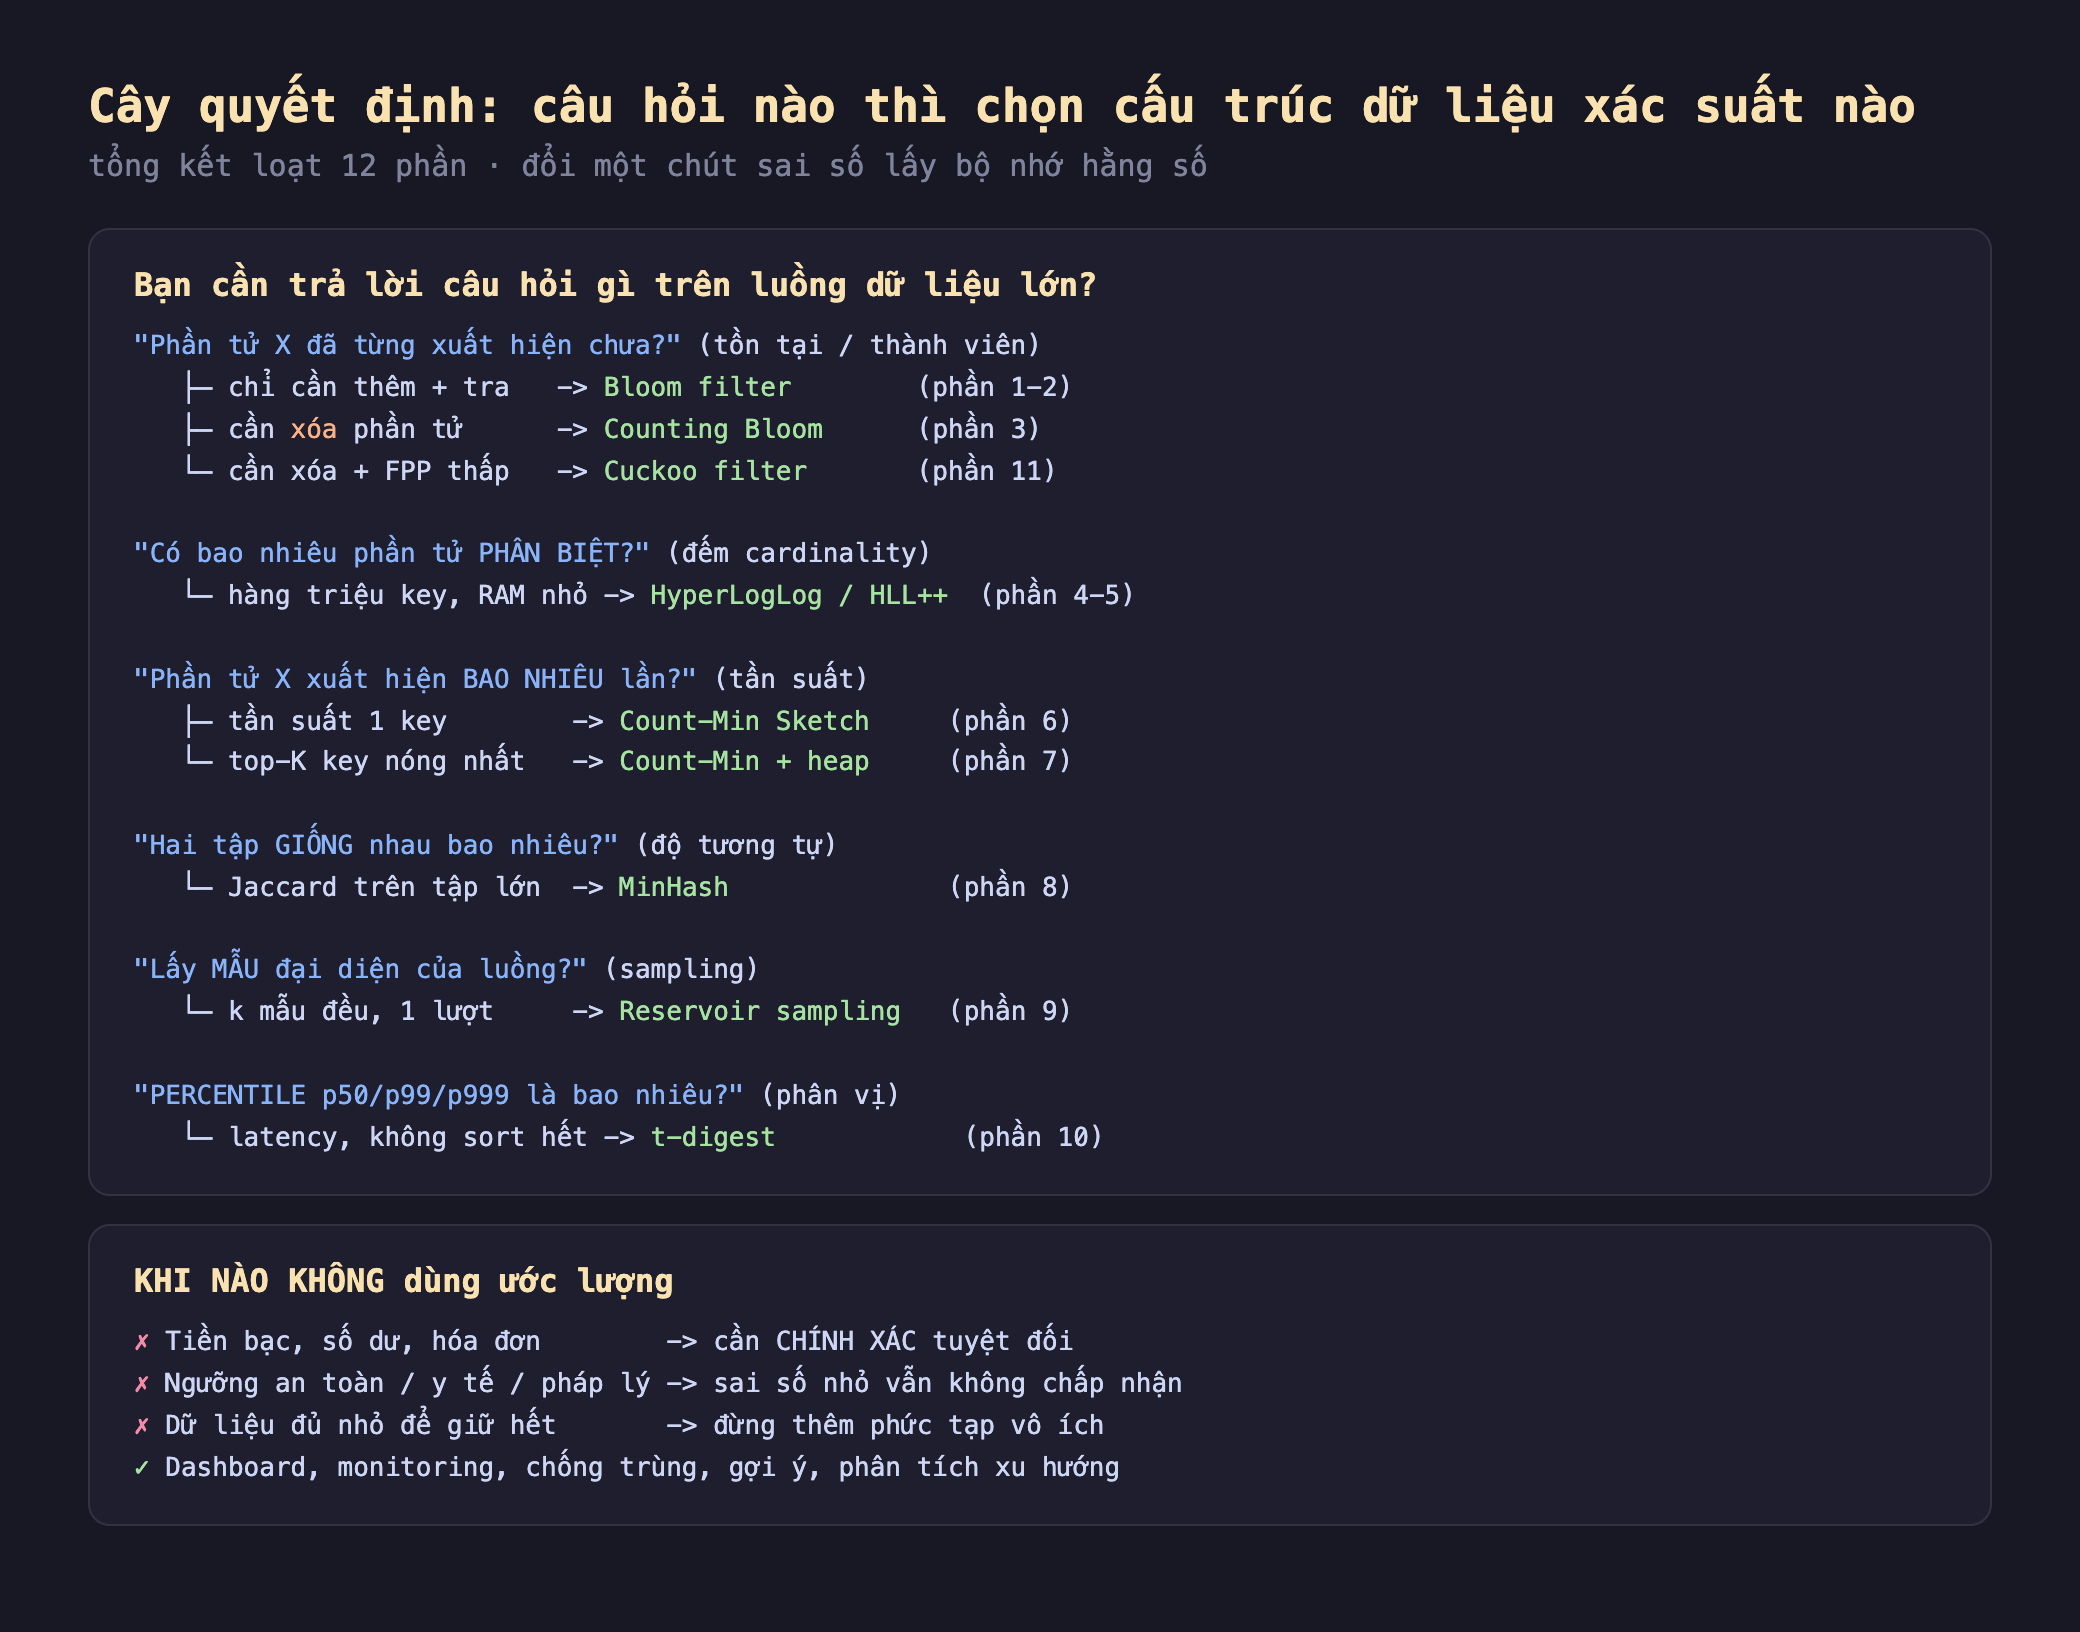
Hình 1: Cây quyết định — bắt đầu từ câu hỏi bạn cần trả lời (tồn tại, đếm phân biệt, tần suất, tương tự, lấy mẫu, phân vị) rồi chọn sketch tương ứng; cùng danh sách các tình huống KHÔNG nên dùng ước lượng.
Đo thật: cùng một luồng, năm sketch, một bảng cân
Để so công bằng, mình tạo một luồng 2 triệu sự kiện (universe 200.000 key, tần suất lệch kiểu Zipf, mỗi sự kiện kèm một giá trị latency lognormal), rồi cho cùng luồng đó chạy qua năm sketch — mỗi sketch trả lời câu hỏi của nó — và so với cách "giữ hết + tính chính xác" (một set, một Counter, một list latency đầy đủ):
hll = HLL(14); cm = CountMin(16384,4); res = Reservoir(1000)
td  = TDigest(300.0); bloom = Bloom(UNIVERSE*10, 7)
exact_set=set(); exact_freq=Counter(); exact_lat=[]     # giữ hết

for _ in range(N):                # N = 2_000_000
    key = ('k%d' % kid).encode(); lat = random.lognormvariate(3.0,0.9)
    hll.add(key); cm.add(key); bloom.add(key); res.add(lat); td.add(lat)
    exact_set.add(kid); exact_freq[kid]+=1; exact_lat.append(lat)
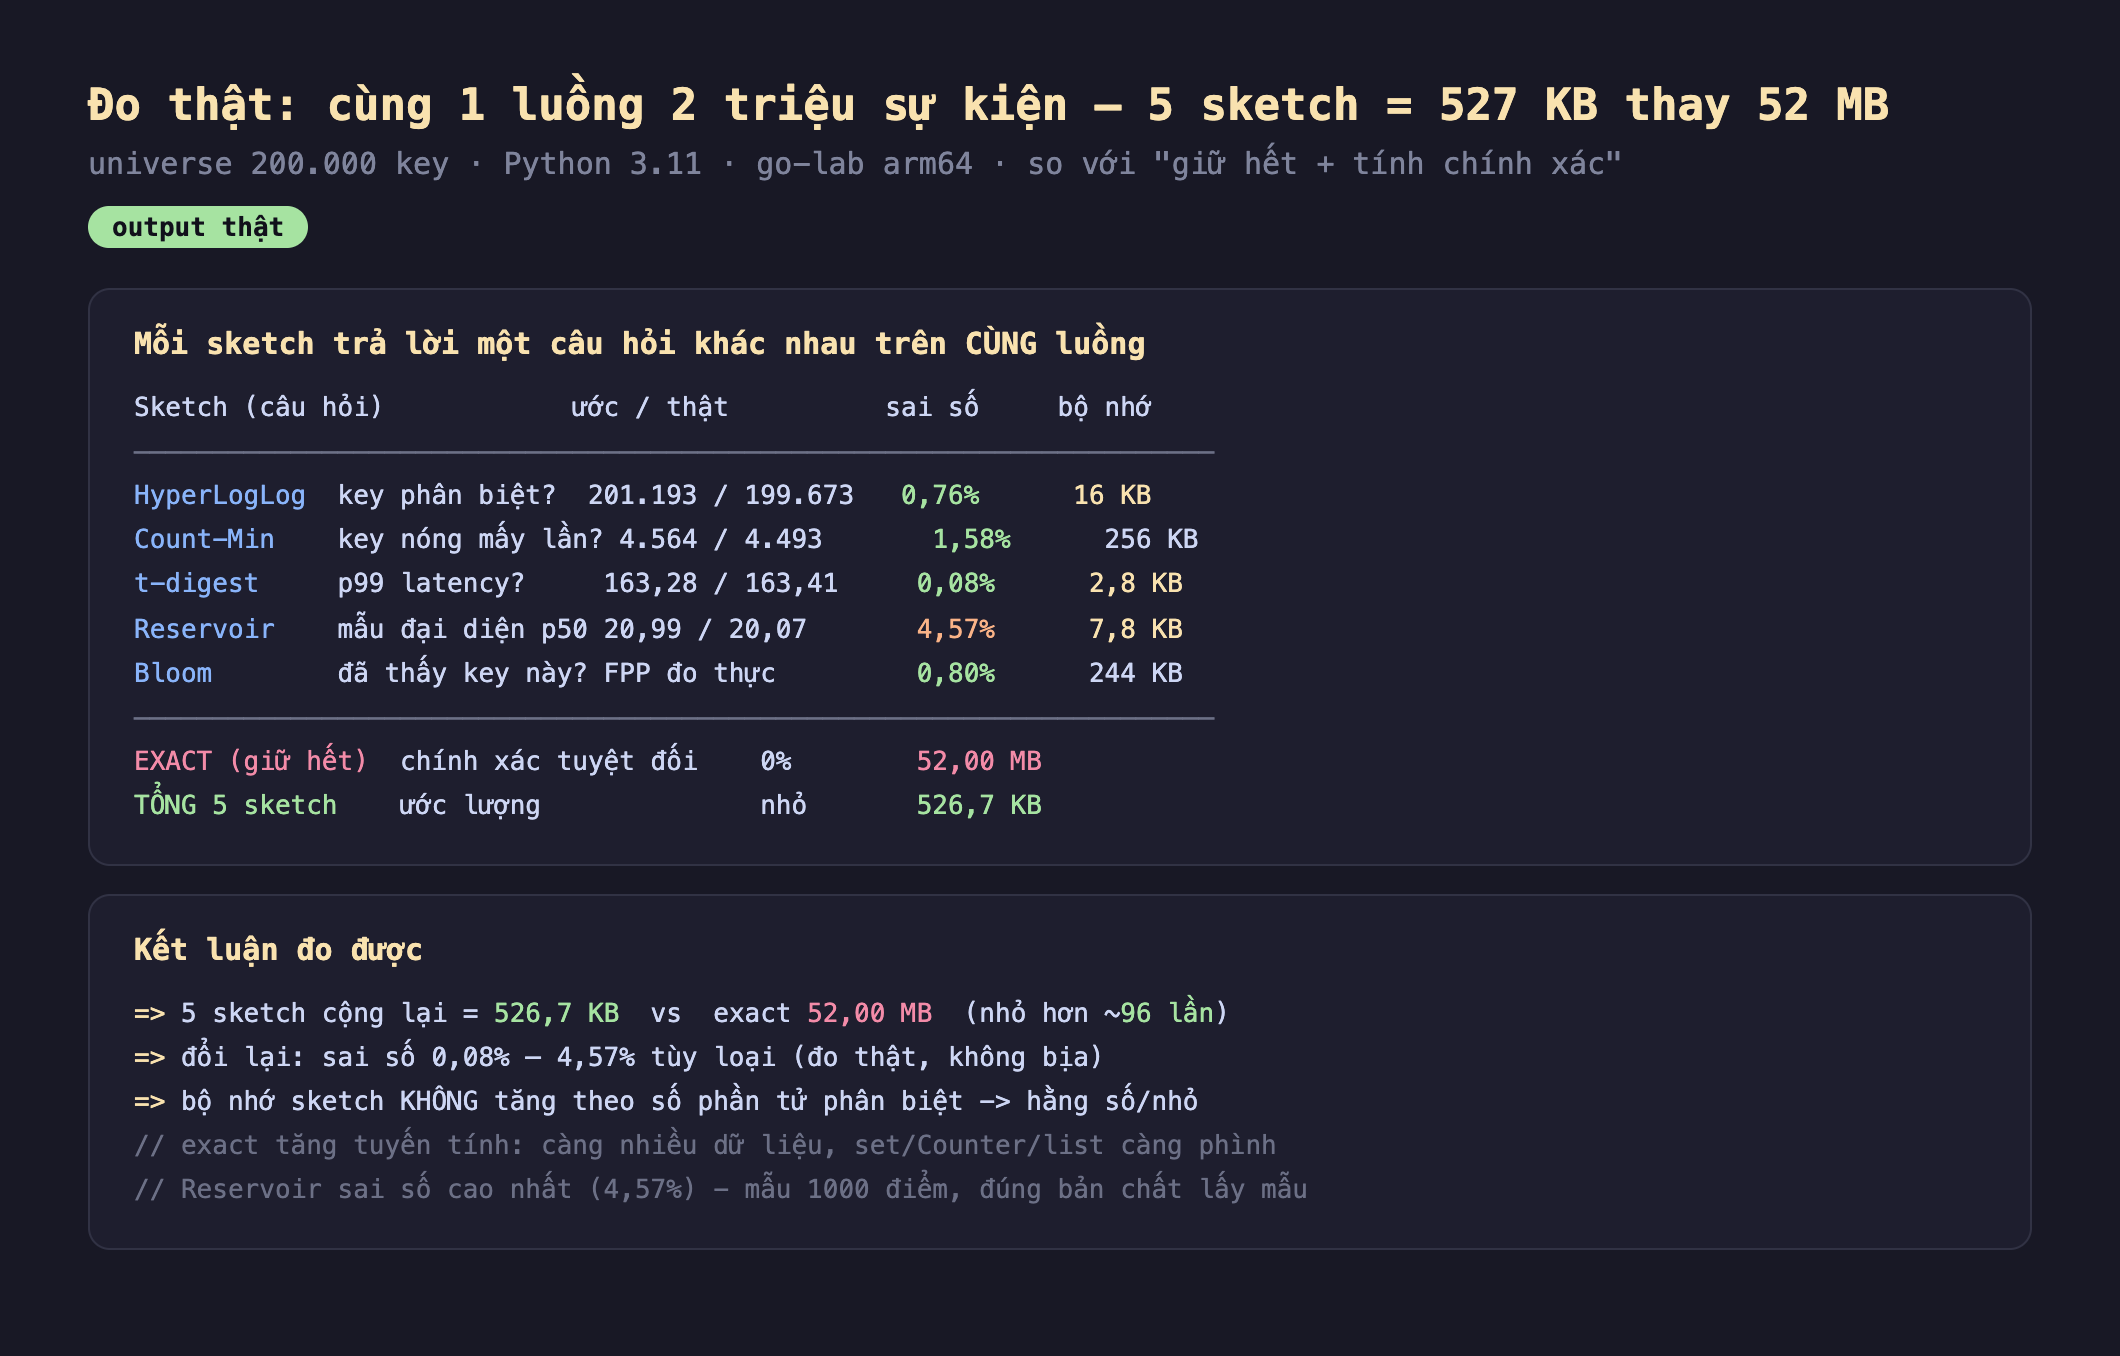
Hình 2: Chạy thật — trên cùng luồng 2 triệu sự kiện: HyperLogLog đếm phân biệt sai 0,76% (16 KB), Count-Min đếm tần suất key nóng sai 1,58% (256 KB), t-digest p99 sai 0,08% (2,8 KB), Reservoir ước p50 sai 4,57% (7,8 KB), Bloom FPP 0,80% (244 KB); tổng 5 sketch 526,7 KB so với exact 52,00 MB — nhỏ hơn ~96 lần.
Đọc kết quả đo được:
- HyperLogLog: ước 201.193 key phân biệt so với thật 199.673 — sai 0,76%, chỉ tốn 16 KB (16.384 register 1 byte). Đây là ví dụ kinh điển: đếm cardinality của luồng khổng lồ bằng bộ nhớ cố định vài KB.
- Count-Min Sketch: ước key nóng nhất xuất hiện 4.564 lần so với thật 4.493 — sai 1,58%, tốn 256 KB. Count-Min luôn ước lượng thừa (do va chạm hash cộng dồn); mở rộng bảng thì sai số giảm.
- t-digest: ước p99 latency 163,28 so với thật 163,41 — sai chỉ 0,08%, và rẻ nhất bảng: 2,8 KB (171 centroid). Percentile gần như hoàn hảo với bộ nhớ tí hon.
- Reservoir sampling: ước p50 từ mẫu 1.000 điểm là 20,99 so với thật 20,07 — sai 4,57%, tốn 7,8 KB. Đây là sai số cao nhất bảng, đúng bản chất lấy mẫu: mẫu nhỏ thì ước lượng nhiễu hơn; muốn chính xác hơn thì lấy mẫu lớn hơn.
- Bloom filter: FPP đo thực 0,80% (query 200.000 key vắng mặt), tốn 244 KB cho 200.000 key ở ~10 bit/key.
Con số tổng kết: năm sketch cộng lại 526,7 KB, trong khi giữ hết để tính chính xác tốn 52,00 MB — nhỏ hơn ~96 lần. Và khác biệt then chốt: bộ nhớ của set/Counter/list tăng tuyến tính theo dữ liệu (càng nhiều key phân biệt càng phình), còn bộ nhớ sketch gần như hằng số. Ở quy mô hàng tỉ sự kiện, khoảng cách này là ranh giới giữa "chạy được trên một máy" và "không thể".
Khi nào KHÔNG nên dùng ước lượng
Đây là phần quan trọng nhất của một bài tổng kết trung thực. Sketch không phải luôn đúng chỗ:
- Tiền bạc, số dư, hóa đơn: cần chính xác tuyệt đối. Không ai chấp nhận số dư tài khoản "sai 0,8%".
- Ngưỡng an toàn, y tế, pháp lý: sai số nhỏ vẫn không chấp nhận được khi hậu quả lớn.
- Dữ liệu đủ nhỏ để giữ hết: nếu chỉ có vài nghìn phần tử, một
sethayCountervừa chính xác vừa đơn giản — thêm sketch chỉ tổ phức tạp và dễ sai.
Ngược lại, sketch tỏa sáng ở: dashboard và monitoring (đếm unique visitor, p99 latency), chống trùng quy mô lớn, hệ gợi ý, phân tích xu hướng — những nơi "gần đúng, ngay lập tức, rẻ" giá trị hơn "chính xác từng chữ số nhưng chậm và tốn".
Đánh đổi cần cân nhắc
Sai số có hai kiểu bảo đảm rất khác nhau. Một số sketch có cận sai số lý thuyết chặt: Bloom/Cuckoo (FPP tính được từ tham số), HyperLogLog (sai số chuẩn ≈ 1,04/√m), Count-Min (ước lượng thừa ≤ ε·N với xác suất cho trước). Số khác chỉ có sai số thực nghiệm tốt nhưng không kèm cận chặt dễ dùng — như t-digest. Khi chọn, hãy biết mình đang cầm loại bảo đảm nào.
Hướng sai lệch cũng khác nhau. Count-Min chỉ ước lượng thừa (không bao giờ thiếu). Bloom/Cuckoo có dương tính giả nhưng (ở trạng thái bình thường) không âm tính giả. HyperLogLog và t-digest sai về cả hai phía. Hiểu hướng lệch giúp bạn dùng đúng: ví dụ Count-Min hợp cho "chặn trên số lần xuất hiện", không hợp cho "đếm chính xác".
Đừng ghép nhầm câu hỏi với sketch. Lỗi hay gặp nhất không phải cài sai, mà là dùng sai công cụ cho câu hỏi: lấy Bloom đi đếm số lần (nó chỉ biết có/không), hay lấy Count-Min đi đếm phân biệt (nó đếm tần suất, không đếm cardinality). Cây quyết định ở Hình 1 chính là để tránh lỗi đó.
Ba ý mang về
- Mỗi sketch trả lời một câu hỏi — chọn theo câu hỏi, không theo độ "mới": tồn tại → Bloom/Cuckoo, đếm phân biệt → HyperLogLog, tần suất → Count-Min, tương tự → MinHash, lấy mẫu → reservoir, percentile → t-digest.
- Đổi một chút sai số lấy bộ nhớ nhỏ hơn nhiều lần — đo thật: cùng luồng 2 triệu sự kiện, 5 sketch cộng lại 526,7 KB thay cho 52,00 MB (nhỏ hơn ~96 lần), với sai số đo được 0,08%–4,57%; và bộ nhớ sketch gần như hằng số trong khi cách giữ hết tăng tuyến tính.
- Biết khi nào KHÔNG dùng: tiền bạc, an toàn, hay dữ liệu đủ nhỏ thì cần chính xác tuyệt đối; sketch dành cho monitoring, chống trùng, phân tích xu hướng — nơi "gần đúng, rẻ, ngay" đáng giá hơn "chính xác nhưng đắt".
Nguồn
- Andrii Gakhov — Probabilistic Data Structures and Algorithms for Big Data: https://www.gakhov.com/books/pdsa.html
- Redis — Probabilistic data types (Bloom, Cuckoo, Count-Min, t-digest, HLL trong thực tế): https://redis.io/docs/latest/develop/data-types/probabilistic/
- Apache DataSketches — thư viện sketch chuẩn công nghiệp: https://datasketches.apache.org/
Loạt Cấu trúc dữ liệu xác suất khép lại ở đây sau 12 phần: từ Bloom filter (phần 1) tới bài tổng kết này. Xuyên suốt, mỗi phần đều chạy demo thật trong container và báo số đo trung thực — kể cả khi kết quả khiêm tốn hay phản trực giác (HyperLogLog dùng trung bình điều hòa vì trung bình cộng lệch ~150%, bzip2 có lúc nén tốt hơn xz, Cuckoo thua Bloom ở FPP cao, histogram ô đều sai 630% khi gặp outlier). Hy vọng bạn rời loạt bài với thứ quan trọng hơn cả danh sách cấu trúc: thói quen hỏi "câu hỏi của mình là gì, và mình chấp nhận sai số bao nhiêu để đổi lấy bộ nhớ" trước khi chọn công cụ.
