Ở loạt Debug phần 11, để biết p99 độ trễ của một service, ta sort cả mảng độ trễ rồi lấy phần tử ở vị trí 99%. Cách đó cho số chính xác tuyệt đối — nhưng phải giữ mọi điểm trong RAM (2 triệu float64 là 16 MB), sort tốn O(n log n), và tệ nhất: không gộp được số liệu từ nhiều máy. Một hệ monitoring như Prometheus không thể giữ mọi điểm của mọi service mãi mãi.
t-digest giải đúng bài toán này: ước lượng quantile (p50, p90, p99, p999...) của một luồng lớn bằng một cấu trúc nhỏ, không cần biết trước khoảng giá trị, và gộp được. Điểm tinh tế nhất: nó cố ý nén thô ở giữa phân phối (nơi ta ít quan tâm) và giữ nhiều centroid nhỏ ở hai đuôi, nơi p99/p999 nằm — đúng chỗ ta cần chính xác. Bài này (phần 10 loạt Cấu trúc dữ liệu xác suất) tự cài một t-digest rút gọn bằng Python và chạy thật trong container để đo sai số và bộ nhớ.
Cơ chế: centroid và hàm scale
Ý tưởng gốc: thay vì giữ từng điểm, ta gom các điểm gần nhau thành một centroid — một cặp [mean, count] (trọng tâm và số điểm nó đại diện). Digest là một danh sách centroid, luôn sắp theo mean.
Câu hỏi then chốt: một centroid được phép "to" đến đâu? Nếu cho mọi centroid to như nhau, hai đuôi sẽ bị nén thô y như giữa và p999 sẽ sai bét. t-digest dùng một hàm scale k(q) ánh xạ quantile q ∈ [0,1] sang một thang khác, rồi ra luật: một centroid chỉ được gộp thêm điểm khi khoảng của nó trên thang k không vượt quá 1 đơn vị.
import math
def k(q, delta):
    # delta = compression: càng lớn càng nhiều centroid, càng chính xác
    return (delta / (2*math.pi)) * math.asin(2*q - 1)
Mấu chốt nằm ở asin: đạo hàm của nó dốc đứng khi q → 0 và q → 1. Nghĩa là gần hai đuôi, chỉ cần thêm rất ít điểm là đã "vượt 1 đơn vị scale" và phải chốt centroid — nên đuôi có nhiều centroid nhỏ (sắc nét). Ở giữa (q ≈ 0.5), asin phẳng, một centroid ôm được rất nhiều điểm (thô, nhưng ta không cần p50 chính xác từng chữ số).
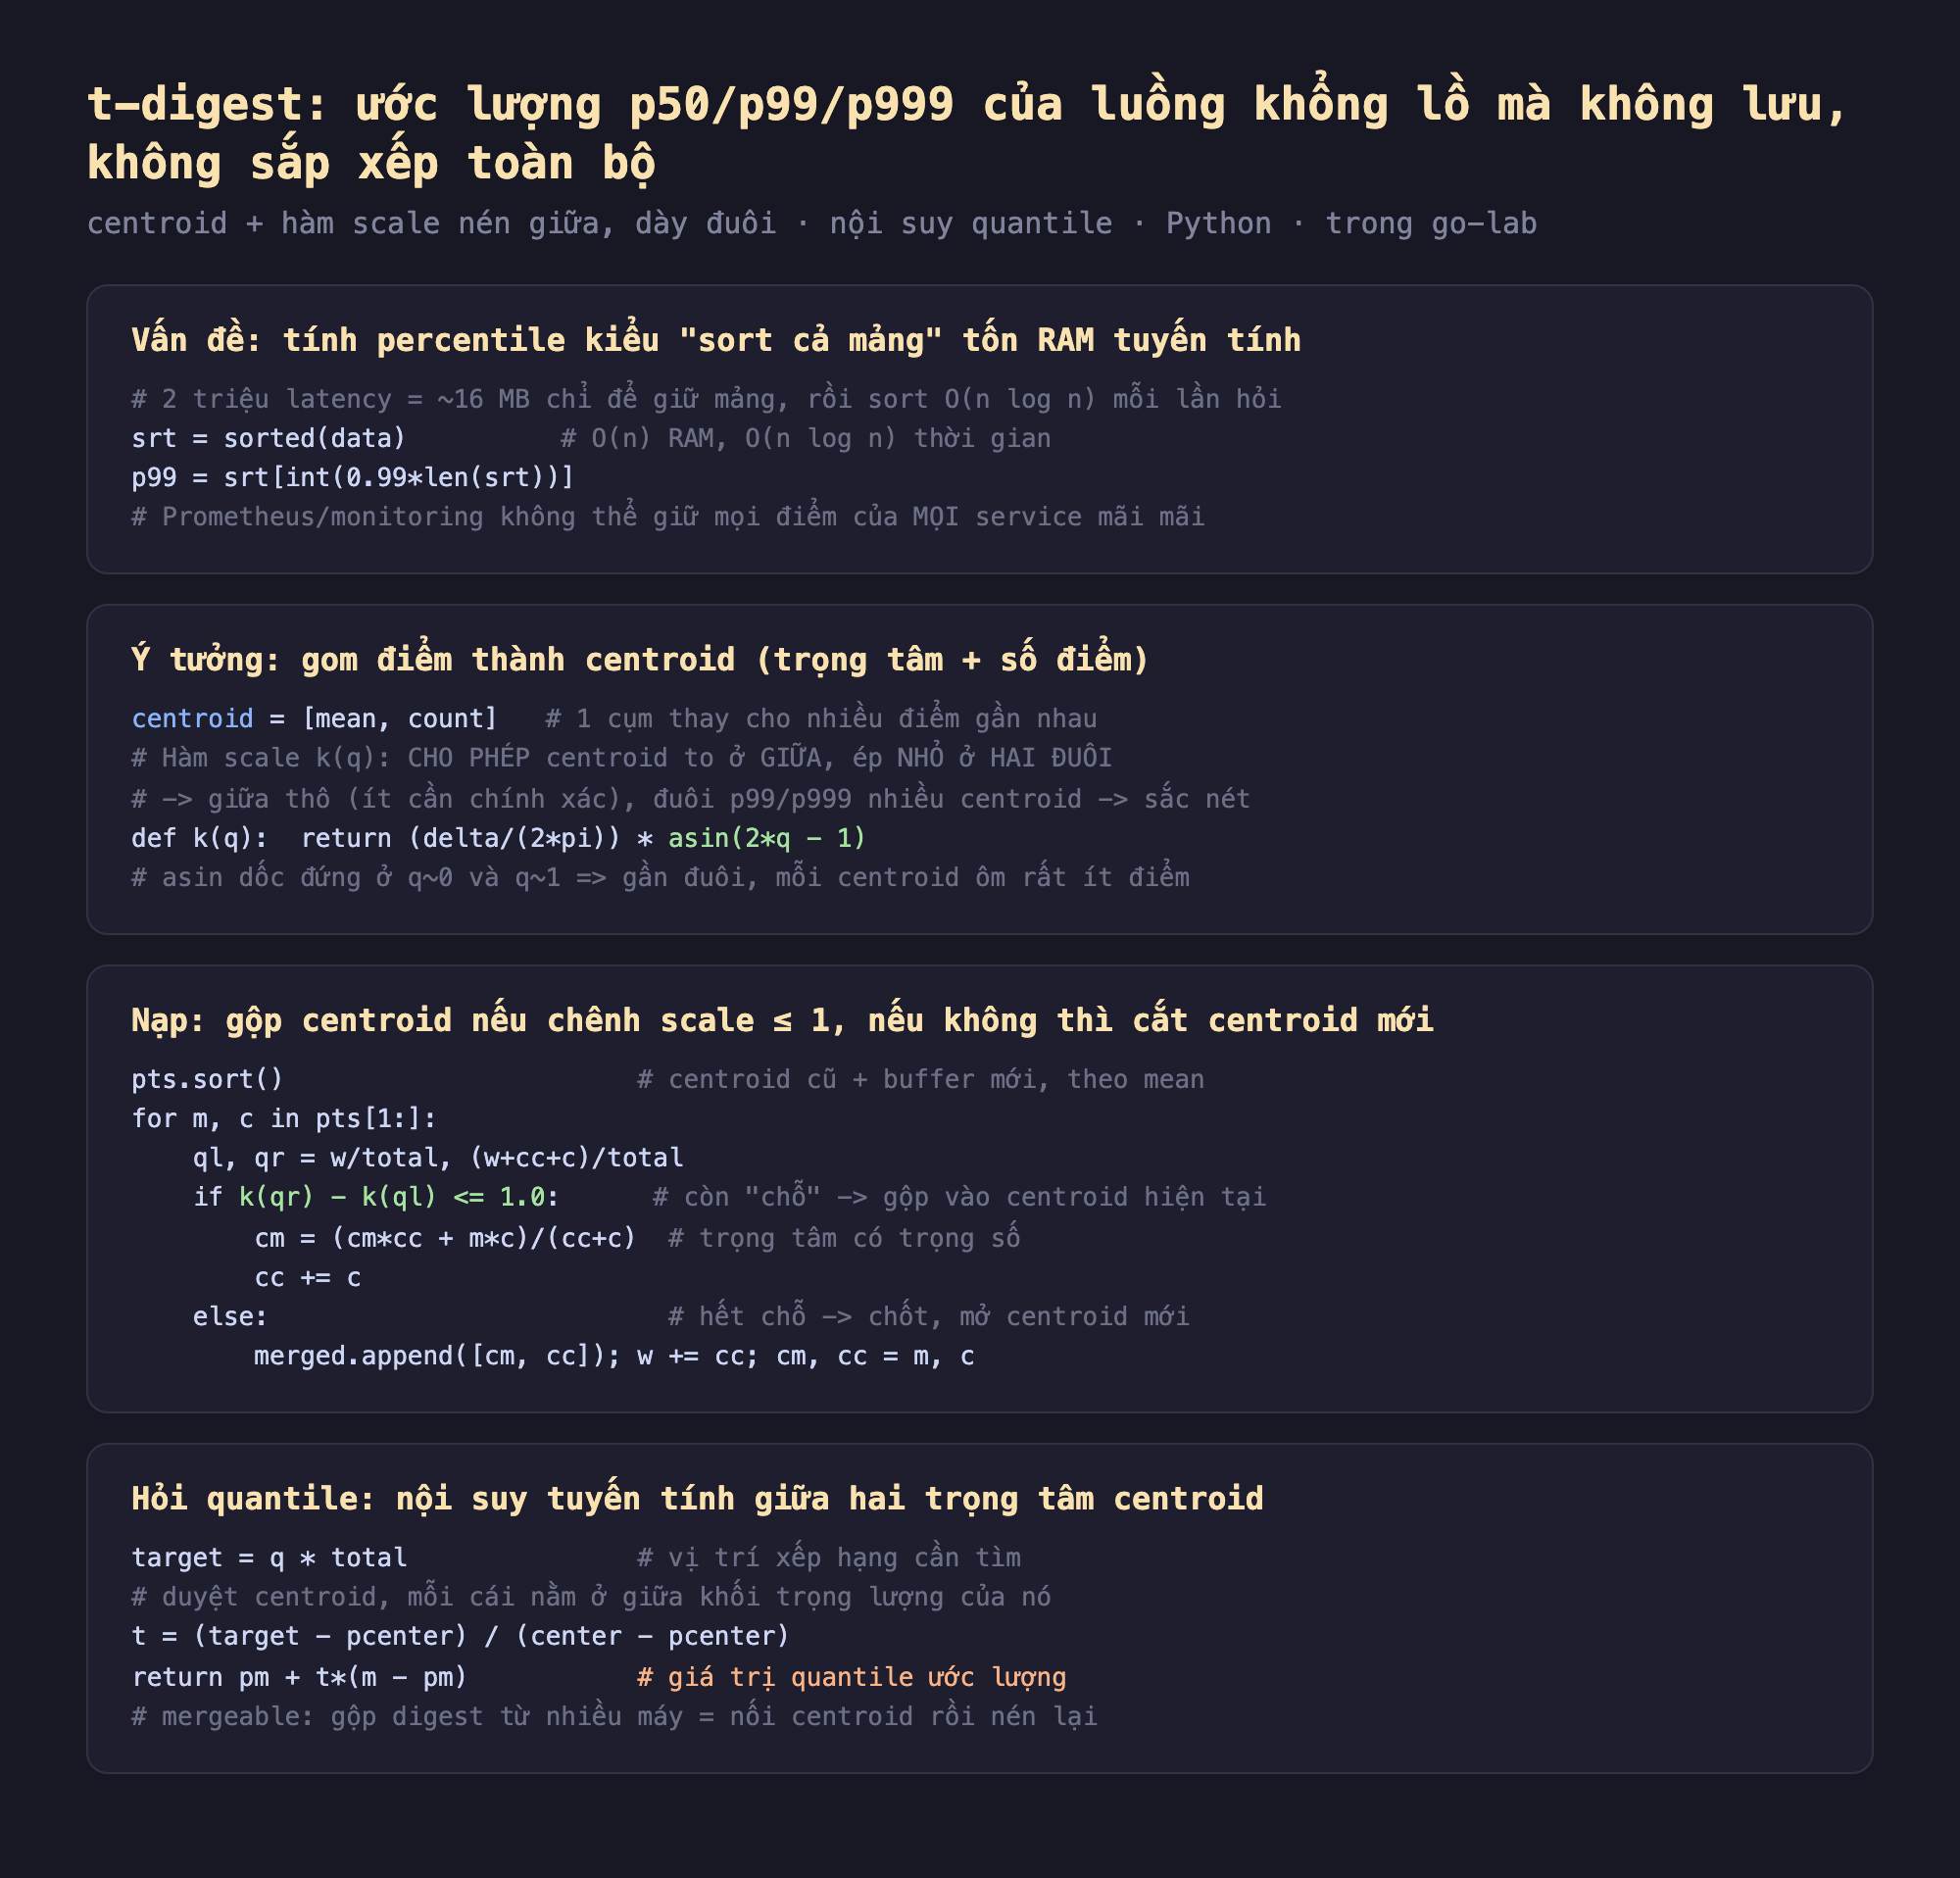
Hình 1: t-digest gom điểm thành centroid [mean, count]; hàm scale k(q)=δ/(2π)·asin(2q−1) cho centroid to ở giữa và nhỏ ở hai đuôi; nạp bằng cách gộp khi chênh scale ≤ 1, hỏi quantile bằng nội suy giữa các trọng tâm.
Nạp dữ liệu và hỏi quantile
Để tránh sort lại mỗi điểm, ta đệm điểm vào một buffer; khi đầy thì gộp buffer với các centroid cũ, sort một lần, rồi quét tuần tự áp luật scale:
def _flush(self):
    pts = [[m, c] for m, c in self.centroids] + [[x, 1] for x in self.buffer]
    self.buffer = []
    pts.sort(key=lambda p: p[0])
    total = sum(c for _, c in pts); self.n = total
    merged = []; w = 0.0; cm, cc = pts[0]
    for m, c in pts[1:]:
        ql, qr = w/total, (w + cc + c)/total
        if k(qr, self.delta) - k(ql, self.delta) <= 1.0:   # còn chỗ -> gộp
            cm = (cm*cc + m*c) / (cc + c); cc += c          # trọng tâm có trọng số
        else:                                               # hết chỗ -> chốt
            merged.append([cm, cc]); w += cc; cm, cc = m, c
    merged.append([cm, cc]); self.centroids = merged
Hỏi quantile q: nhân q với tổng số điểm để ra vị trí xếp hạng cần tìm, rồi duyệt các centroid (mỗi centroid coi như nằm ở giữa khối trọng lượng của nó) và nội suy tuyến tính giữa hai trọng tâm liền kề.
Đo thật: 2 triệu latency, 171 centroid thay 16 MB
Mình sinh 2 triệu độ trễ mô phỏng theo phân phối lognormal (đa số nhanh, đuôi dài chậm) kèm spike hiếm, rồi so percentile thật (sort cả mảng) với t-digest delta=300:
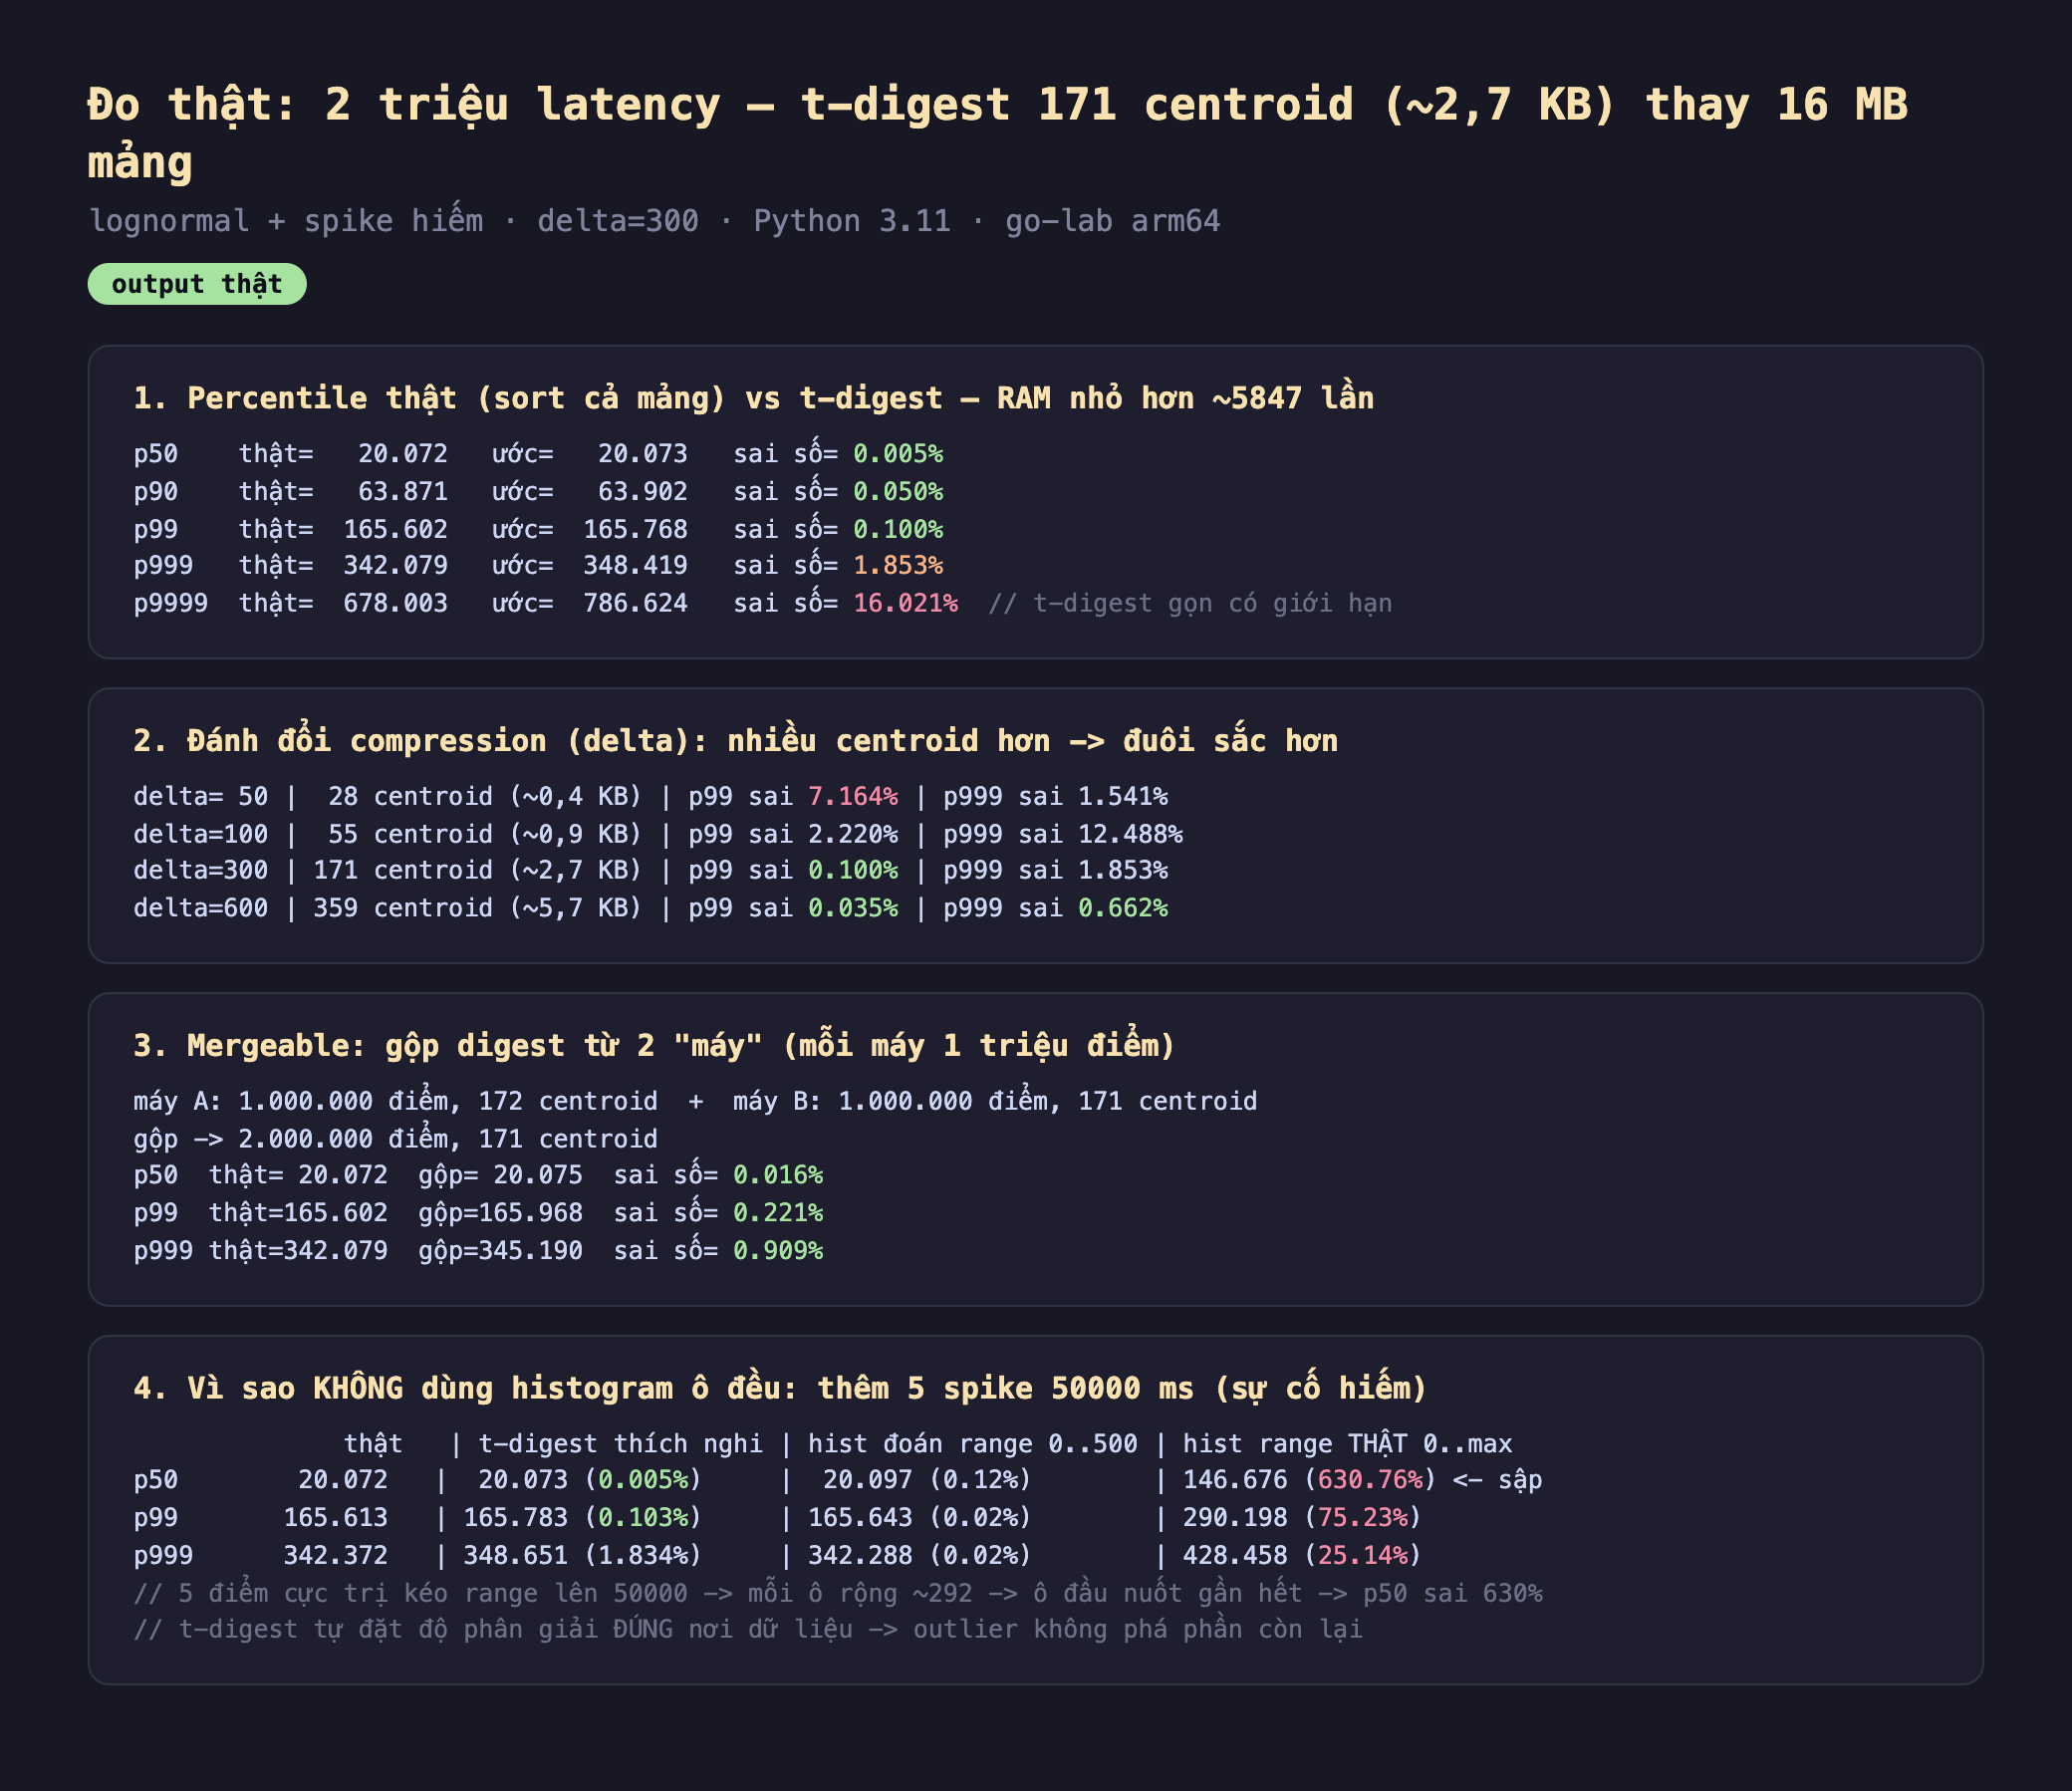
Hình 2: Chạy thật — t-digest delta=300 cho 171 centroid (~2,7 KB) thay mảng 16 MB (nhỏ hơn ~5847 lần): p50 sai 0,005%, p99 sai 0,100%; p999 1,853% và p9999 16,021% (đuôi cực trị là giới hạn của bản rút gọn). Tăng delta=600 → p999 còn 0,662%. Gộp digest từ 2 "máy" vẫn cho p99 sai 0,221%.
Đọc kết quả thật:
- Giữa gần như hoàn hảo, bộ nhớ tí hon: p50 sai 0,005%, p90 0,050%, p99 0,100% — trong khi digest chỉ nặng ~2,7 KB so với 16 MB của mảng đầy đủ. Đây đúng là thứ monitoring cần: một con số p99 gần đúng với chi phí bộ nhớ không đổi.
- Đuôi cực trị là giới hạn thật của bản rút gọn: p999 sai 1,853% và p9999 sai tới 16,021%. Mình báo thẳng: bản t-digest tối giản này ở đuôi xa (p9999 = 200 điểm trên cùng của 2 triệu) chưa giữ đủ centroid singleton như bản gốc của Ted Dunning. Muốn sắc hơn thì tăng
delta. - Đánh đổi compression rõ ràng:
deltatừ 50 → 600 đưa số centroid từ 28 → 359 và p99 từ 7,164% xuống 0,035%, p999 từ (12,488% ở delta=100) xuống 0,662%. Đây là núm xoay trực tiếp giữa bộ nhớ và độ chính xác đuôi. - Mergeable — bán hàng đắt giá nhất: chia 2 triệu điểm cho 2 "máy", mỗi máy dựng digest riêng, rồi gộp (nối centroid, nén lại) cho p99 sai chỉ 0,221%, p999 sai 0,909%. Nhờ vậy mỗi node báo digest của mình, hệ trung tâm cộng lại ra p99 toàn cục — điều mà "sort cả mảng" không làm được.
Vì sao không chỉ dùng histogram ô đều?
Câu hỏi hợp lý: sao không chia trục giá trị thành N ô đều rồi đếm? Mình đã thử — và đây là chỗ t-digest tỏ rõ giá trị. Khi thêm 5 spike 50000 ms (sự cố hiếm như GC pause, timeout) vào luồng:
- t-digest thích nghi: p50 vẫn sai 0,005%, p99 sai 0,103% — nó tự đặt độ phân giải đúng nơi dữ liệu dày, mấy điểm cực trị chỉ tạo thêm vài centroid ở rìa, không ảnh hưởng phần còn lại.
- Histogram ô đều với range THẬT (0..50000): sập — p50 sai tới 630,76%! Vì 5 điểm cực trị kéo khoảng lên 50000, chia cho 171 ô thì mỗi ô rộng ~292 ms, và ô đầu tiên (0–292) nuốt gần như toàn bộ dữ liệu. Toàn bộ độ phân giải ở vùng 0–300 ms (nơi p50–p999 thật nằm) biến mất.
Histogram ô đều có thể chính xác — nhưng chỉ khi bạn đoán trúng khoảng giá trị trước, và một vài outlier là đủ phá nát nó. t-digest không cần biết trước khoảng, và bền với outlier. Đó là lý do nó (cùng họ hàng HDR Histogram) được dùng trong Prometheus, Elasticsearch, và các hệ đo độ trễ thật.
Đánh đổi cần cân nhắc
Đuôi rất xa cần delta lớn hoặc bản cài đầy đủ. Như số đo cho thấy, p9999 của bản rút gọn này sai 16% ở delta=300. Bản t-digest gốc xử lý đuôi tốt hơn nhờ giữ centroid singleton (count=1) ở hai cực và quy tắc nội suy tinh hơn. Nếu bạn cần p9999/p99999 sắc, hãy dùng thư viện đã kiểm chứng (tdunning/t-digest, caio/go-tdigest) và đặt compression cao — đừng tự cài cho production chỉ vì nó ngắn.
Ước lượng, không phải chính xác — và sai số không có cận cứng dễ chịu. t-digest cho sai số thực nghiệm rất tốt ở giữa nhưng không kèm bảo đảm lý thuyết chặt như Count-Min hay HyperLogLog. Với hoá đơn tiền bạc hay ngưỡng an toàn tính mạng, đừng dùng quantile ước lượng; với dashboard độ trễ, nó là lựa chọn đúng.
Chọn đúng sketch cho đúng việc. Cần quantile/percentile → t-digest (hoặc HDR Histogram nếu khoảng giá trị biết trước và cố định). Cần đếm phần tử phân biệt → HyperLogLog. Cần tần suất → Count-Min. Cần kiểm tra tồn tại → Bloom/Cuckoo. Dùng nhầm sketch là đo sai câu hỏi.
Ba ý mang về
- t-digest đo percentile của luồng lớn với bộ nhớ không đổi: đo thật 2 triệu latency → 171 centroid (~2,7 KB) thay mảng 16 MB (~5847 lần nhỏ hơn), p50 sai 0,005% và p99 sai 0,100% — đủ tốt cho monitoring mà không cần giữ và sort mọi điểm.
- Hàm scale nén giữa, dày đuôi — và
deltalà núm xoay: đo thật tăngdelta50→600 đưa p99 từ 7,164% xuống 0,035%; đuôi cực trị (p9999) là giới hạn của bản rút gọn, cần bản đầy đủ nếu muốn sắc. - Mergeable và bền với outlier là thứ histogram ô đều không có: gộp digest 2 máy cho p99 sai 0,221%; và khi thêm spike cực trị, histogram range-thật sai 630% ở p50 trong khi t-digest vẫn 0,005% nhờ tự đặt độ phân giải đúng nơi dữ liệu.
Nguồn
- Ted Dunning, Otmar Ertl — Computing Extremely Accurate Quantiles Using t-Digests: https://arxiv.org/abs/1902.04023
- Kho gốc — tdunning/t-digest: https://github.com/tdunning/t-digest
- Bản Go — caio/go-tdigest: https://github.com/caio/go-tdigest
Phần sau ta gặp Cuckoo filter — một đối thủ của Bloom filter (loạt bài này mở màn bằng nó): vừa kiểm tra tồn tại với ít bộ nhớ, vừa xóa được phần tử (thứ Bloom gốc không làm được), và thường có tỉ lệ dương tính giả thấp hơn ở cùng mức bộ nhớ.
