Đây là một thuật toán nhỏ mà thanh lịch đến mức ai lần đầu hiểu cũng phải mỉm cười. Bài toán nghe có vẻ không thể: bạn đang đọc một luồng dữ liệu — một log đang chảy, một tệp lớn hơn RAM, một dòng sự kiện vô tận — và muốn lấy một mẫu ngẫu nhiên đều gồm k phần tử. Vấn đề: bạn không biết trước độ dài của luồng, và không thể giữ hết để chọn sau. Cách ngây thơ — đếm N rồi chọn ngẫu nhiên — cần biết N trước và duyệt hai lần. Cách giữ-hết-rồi-chọn tốn RAM theo N. Reservoir sampling (Algorithm R) giải cả hai: một lượt duyệt duy nhất, bộ nhớ O(k), không cần biết N, và mẫu ngẫu nhiên đều tuyệt đối. Bài này (phần 9 loạt Xác suất) tự cài và đo thật tính đều đó.
Algorithm R: giữ reservoir, thay thế với xác suất giảm dần
Ý tưởng: giữ một "hồ chứa" (reservoir) k phần tử. Khi một phần tử mới đến, quyết định ngẫu nhiên có nên đưa nó vào hồ (đẩy một phần tử cũ ra) hay không — với xác suất vừa đủ để mọi phần tử cuối cùng có cơ hội bằng nhau.
- k phần tử đầu: nhận hết vào reservoir.
- Phần tử thứ i (i ≥ k): chọn số ngẫu nhiên
jtrong[0, i]. Nếuj < k, thayreservoir[j] = phần tử i; nếu không, bỏ qua phần tử i.
for i, x in enumerate(stream):
    if i < k:
        res.append(x)               # k phần tử đầu: nhận hết
    else:
        j = random.randint(0, i)    # ngẫu nhiên trong [0, i]
        if j < k: res[j] = x        # thay thế với xác suất k/(i+1)
Vì sao đều? Phần tử thứ i được đưa vào reservoir với xác suất k/(i+1) lúc nó đến. Và mỗi phần tử sau đó có xác suất không đẩy nó ra. Nhân tất cả các xác suất này lại (chứng minh bằng quy nạp), mỗi phần tử — bất kể vị trí — có xác suất đúng k/N được giữ lại đến cuối. Không thiên vị đầu hay cuối luồng. Đây là điểm tinh tế: phần tử đầu tiên và phần tử cuối cùng có cùng cơ hội.
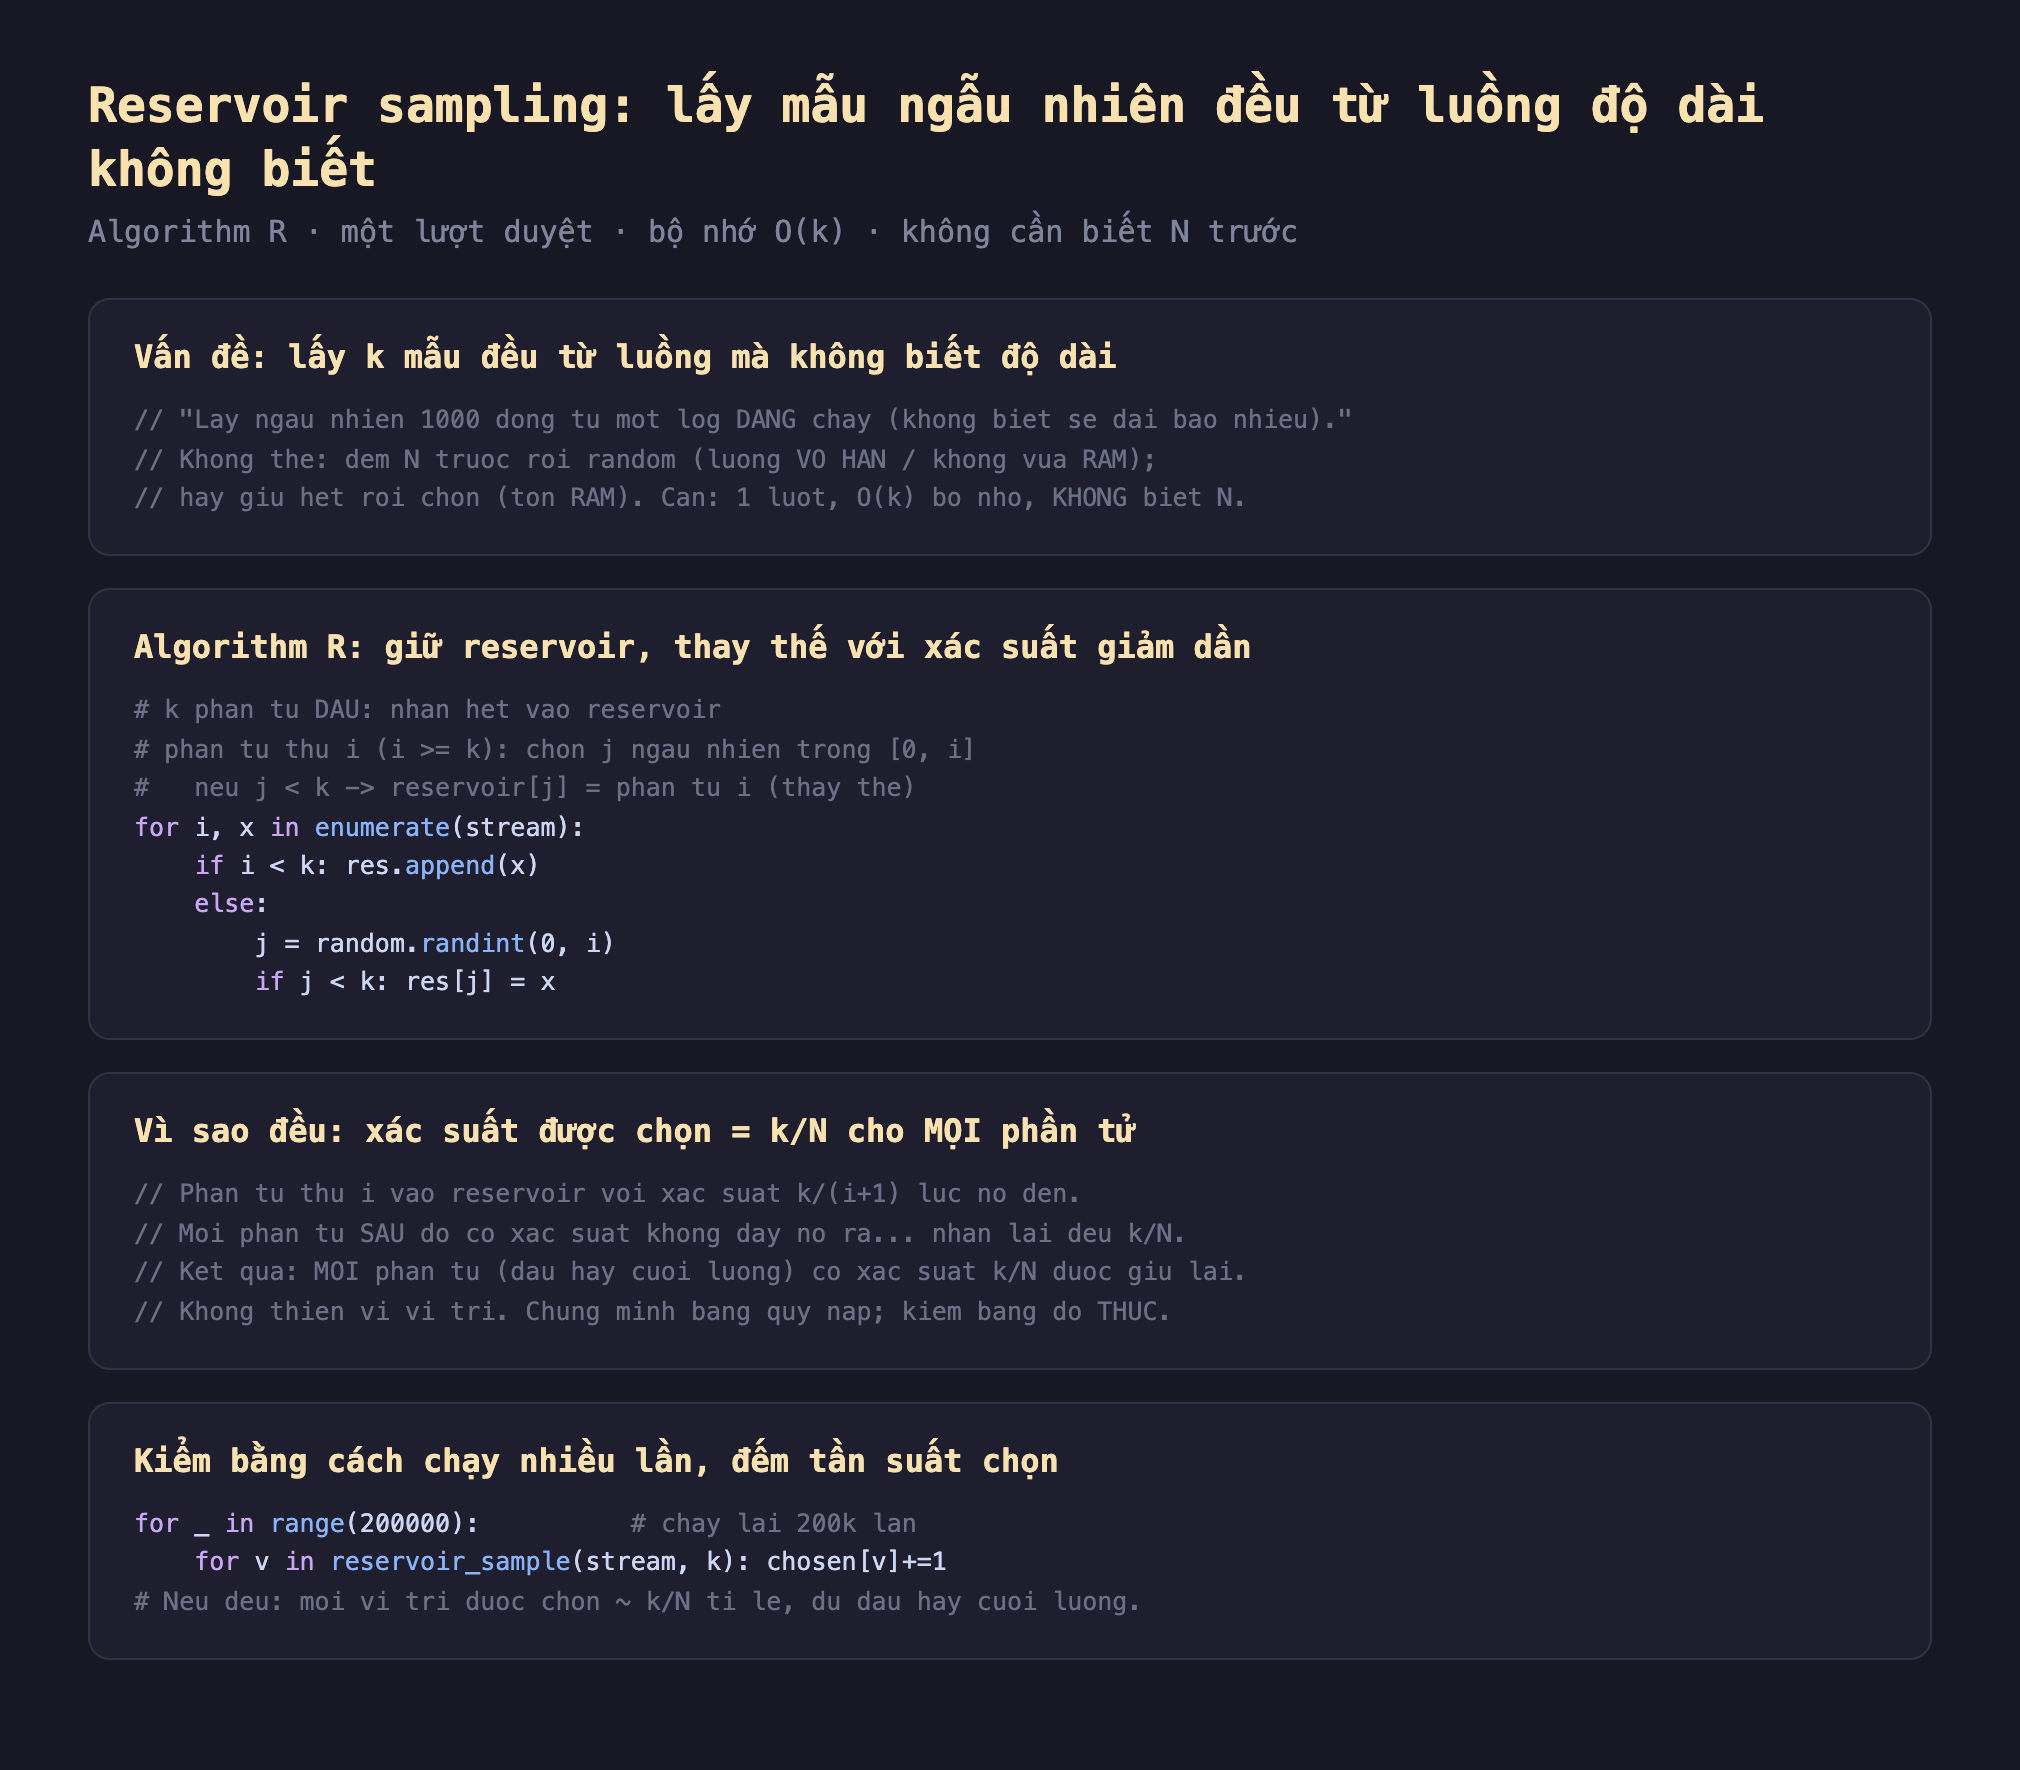
Hình 1: Algorithm R giữ reservoir k phần tử — k phần tử đầu nhận hết, phần tử thứ i (i≥k) chọn j ngẫu nhiên trong [0,i] và thay reservoir[j] nếu j<k; mỗi phần tử có xác suất đúng k/N được giữ lại bất kể vị trí, chứng minh bằng quy nạp và kiểm bằng đo thực.
Đo thật: mọi vị trí được chọn đều tăm tắp
Để chứng minh tính đều, mình chạy reservoir sampling (N=50, k=5) 200.000 lần và đếm mỗi vị trí trong luồng được chọn vào mẫu bao nhiêu lần:
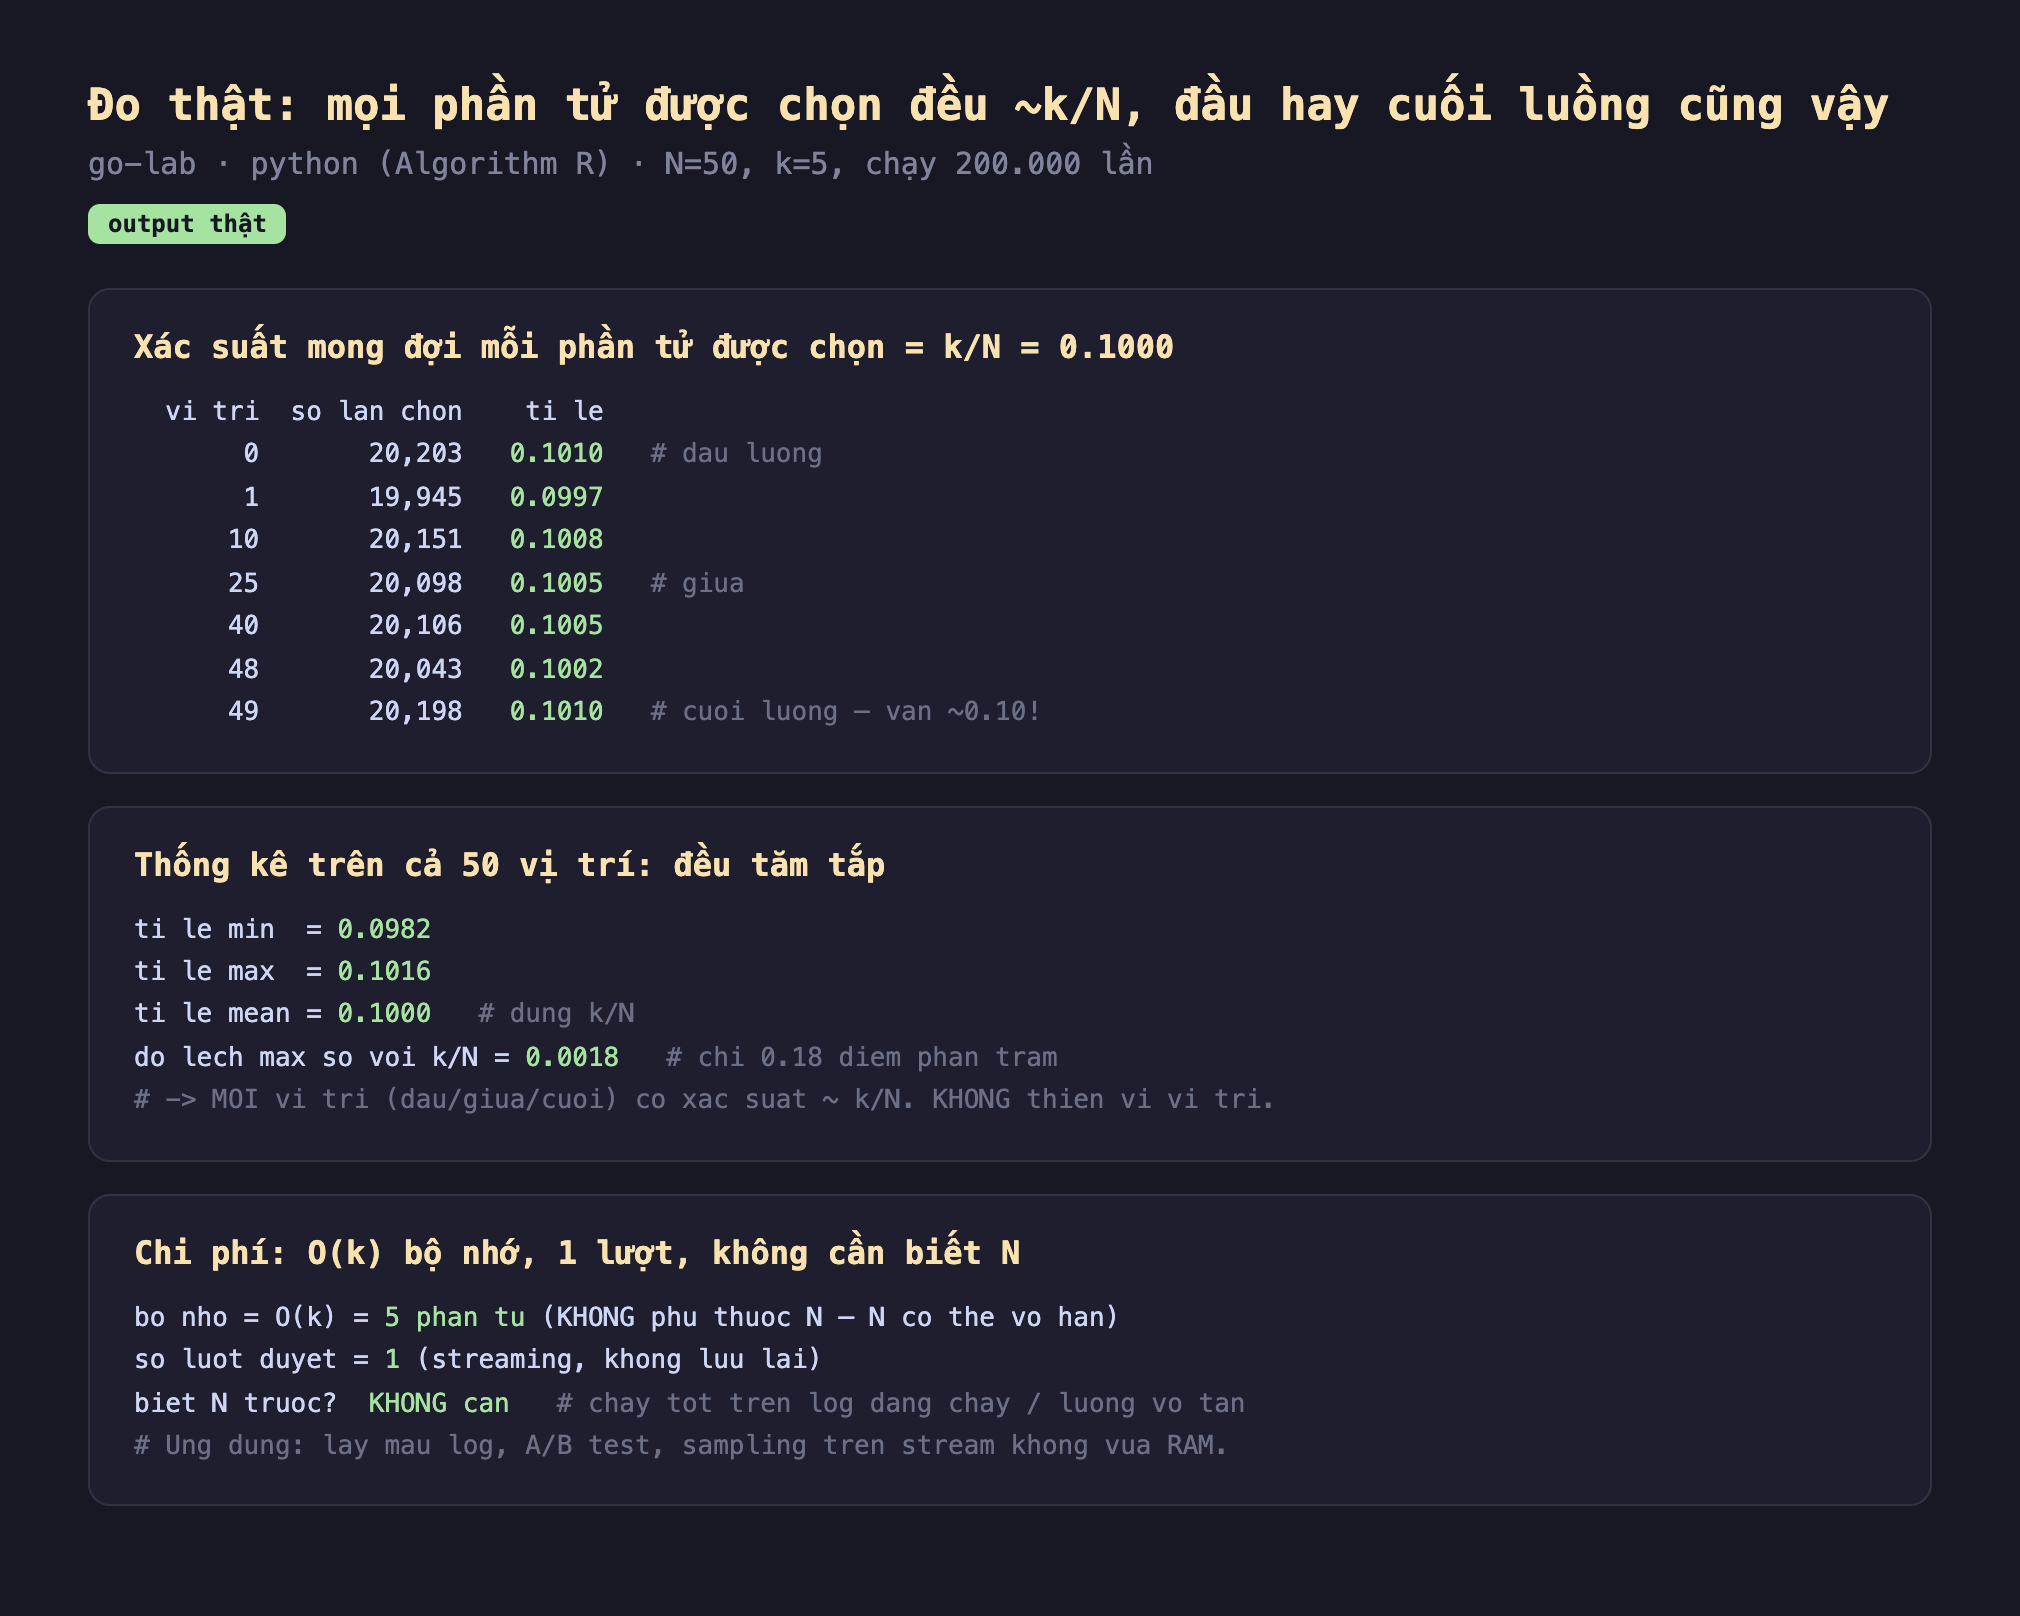
Hình 2: Chạy thật — N=50, k=5, 200.000 lần: xác suất mong đợi k/N=0.1000; vị trí 0 (đầu) chọn 0.1010, vị trí 49 (cuối) chọn 0.1010, các vị trí giữa ~0.100; trên cả 50 vị trí min 0.0982, max 0.1016, mean 0.1000, lệch tối đa so với k/N chỉ 0.0018.
- Đầu và cuối luồng: cùng xác suất: đây là điều đáng kinh ngạc nhất. Vị trí 0 (phần tử đầu tiên của luồng) được chọn với tỉ lệ 0.1010, và vị trí 49 (phần tử cuối cùng) là 0.1010 — y hệt. Dù phần tử đầu phải "sống sót" qua 45 lần có thể bị thay thế, còn phần tử cuối vừa vào đã xong, cả hai có cùng xác suất k/N. Đây chính là tính chất mà Algorithm R đảm bảo.
- Đều tăm tắp trên mọi vị trí: trên cả 50 vị trí, tỉ lệ được chọn dao động từ 0.0982 tới 0.1016, trung bình đúng 0.1000 = k/N, và lệch tối đa so với k/N chỉ 0.0018 (0.18 điểm phần trăm) — chỉ là nhiễu thống kê của 200.000 lần chạy. Không có vị trí nào bị thiên vị. Nếu thuật toán sai (ví dụ luôn giữ k phần tử đầu), vị trí 0-4 sẽ có tỉ lệ ~1.0 còn phần còn lại ~0 — nhưng ta thấy đều hoàn toàn.
- Chi phí tối thiểu: bộ nhớ O(k) = 5 phần tử, không phụ thuộc N (N có thể vô hạn). Một lượt duyệt duy nhất (streaming, không lưu lại). Và không cần biết N trước — thuật toán chạy tốt trên một log đang chảy mà bạn không biết sẽ dài bao nhiêu. Đây là bộ ba tính chất khiến reservoir sampling vô giá cho xử lý luồng.
Đánh đổi cần cân nhắc
Algorithm R gọi random mỗi phần tử — chậm cho luồng khổng lồ, có bản tối ưu. Cài cơ bản gọi random.randint cho mỗi phần tử sau k đầu, tốn O(N) lần gọi random. Với N cực lớn, phần lớn phần tử bị bỏ qua (không vào reservoir), nên gọi random cho chúng là lãng phí. Algorithm L (Li, 1994) tối ưu bằng cách tính trước "bỏ qua bao nhiêu phần tử tiếp theo" bằng một phép random duy nhất — giảm số lần gọi random xuống O(k·log(N/k)). Với luồng hàng tỉ phần tử, dùng Algorithm L; với luồng vừa, Algorithm R đủ đơn giản và tốt.
Lấy mẫu đều không phải lúc nào cũng là thứ bạn muốn — cân nhắc weighted/time-decay. Reservoir sampling cho mỗi phần tử cùng trọng số. Nhưng nhiều ứng dụng muốn thiên về gần đây (dữ liệu mới quan trọng hơn) hoặc có trọng số (phần tử quan trọng hơn dễ được chọn). Có các biến thể: weighted reservoir sampling (A-Res của Efraimidis-Spirakis, dùng key = random^(1/weight)) cho lấy mẫu có trọng số; exponential decay reservoir cho thiên về gần đây. Chọn biến thể theo ngữ nghĩa bạn cần — đừng mặc định "đều" nếu dữ liệu có cấu trúc thời gian.
Một phần tử trong mẫu có thể trùng nếu luồng có phần tử trùng — đây là sampling without replacement theo vị trí. Reservoir sampling chọn k vị trí khác nhau trong luồng (không lấy lại). Nhưng nếu luồng chứa các giá trị trùng nhau (cùng một giá trị ở nhiều vị trí), mẫu có thể chứa giá trị trùng — đó là hành vi đúng (mẫu đại diện cho phân phối giá trị). Nếu bạn cần k giá trị phân biệt, đó là bài toán khác (distinct sampling), cần cách tiếp cận khác (ví dụ kết hợp với một set, hoặc min-hash).
Ba ý mang về
- Reservoir sampling lấy k mẫu đều từ luồng độ dài không biết: đo thật Algorithm R (giữ reservoir, phần tử thứ i thay thế với xác suất k/(i+1)) cho mỗi vị trí xác suất được chọn đúng k/N — một lượt duyệt, O(k) bộ nhớ, không cần biết N trước.
- Đều tuyệt đối, không thiên vị vị trí: đo thật 200.000 lần chạy, phần tử đầu (0.1010) và phần tử cuối luồng (0.1010) có cùng xác suất k/N=0.10, lệch tối đa chỉ 0.0018 trên cả 50 vị trí — tính chất mấu chốt của Algorithm R.
- Biết biến thể phù hợp: Algorithm L giảm số lần gọi random cho luồng khổng lồ; weighted/time-decay reservoir khi cần thiên về gần đây hoặc có trọng số; và nhớ nó lấy mẫu theo vị trí (mẫu có thể chứa giá trị trùng nếu luồng có trùng).
Nguồn
- Vitter — Random Sampling with a Reservoir (Algorithm R & L, 1985): https://www.cs.umd.edu/~samir/498/vitter.pdf
- Efraimidis & Spirakis — Weighted Random Sampling (A-Res, 2006): https://utopia.duth.gr/~pefraimi/research/data/2007EncOfAlg.pdf
- Wikipedia — Reservoir sampling: https://en.wikipedia.org/wiki/Reservoir_sampling
Phần sau ta quay lại bài toán quen từ loạt Debug: ước lượng percentile (p50, p99) — nhưng ở quy mô luồng. t-digest ước lượng các phân vị chính xác cả ở đuôi bằng bộ nhớ nhỏ, mà không cần lưu và sắp xếp toàn bộ dữ liệu.
