Bốn cấu trúc trước trả lời "có trong tập không", "bao nhiêu khác nhau", "bao nhiêu lần". Giờ đến câu hỏi thứ năm: "hai tập giống nhau bao nhiêu?". Hai tài liệu có trùng lặp không? Hai người dùng có sở thích giống nhau không? Thước đo chuẩn là Jaccard similarity = |giao| / |hợp| — tỉ lệ phần tử chung. Nhưng tính chính xác đòi hỏi giao hai tập, và khi bạn có hàng triệu tập cần so từng cặp, chi phí bùng nổ. MinHash giải quyết bằng một ý tưởng đẹp đến kinh ngạc: rút gọn mỗi tập thành một chữ ký nhỏ (vài trăm số), và so hai chữ ký cho ra ước lượng Jaccard — mà không cần chạm vào tập gốc. Bài này (phần 8 loạt Xác suất) tự cài MinHash và đo thật độ chính xác của phép màu đó.
Trực giác thần kỳ: min-hash trùng = Jaccard
Đây là một trong những kết quả đẹp nhất của cấu trúc dữ liệu xác suất. Lấy một hàm băm ngẫu nhiên, băm mọi phần tử trong hai tập A và B. Xét phần tử có hash nhỏ nhất trong toàn bộ A ∪ B. Phần tử đó ngẫu nhiên đều trong hợp, nên:
- Nó cũng là min-hash của cả A lẫn B (tức
minhash(A) == minhash(B)) khi và chỉ khi nó thuộc giaoA ∩ B. - Xác suất điều đó xảy ra =
|A ∩ B| / |A ∪ B|= đúng bằng Jaccard similarity!
P[ minhash(A) == minhash(B) ] = Jaccard(A, B)
Vậy nếu dùng k hàm băm độc lập, mỗi hàm cho một cặp min-hash, thì tỉ lệ số hàm mà min-hash trùng nhau là một ước lượng không thiên lệch cho Jaccard. Chữ ký của một tập là k giá trị min-hash đó; so hai tập = đếm vị trí trùng trong hai chữ ký, chia k.
sig[i] = min( hash_i(x) for x in S )        # với k hàm băm khác nhau
J_ước_lượng = (số vị trí sig_A[i] == sig_B[i]) / k
# sai số ~ 1/√k
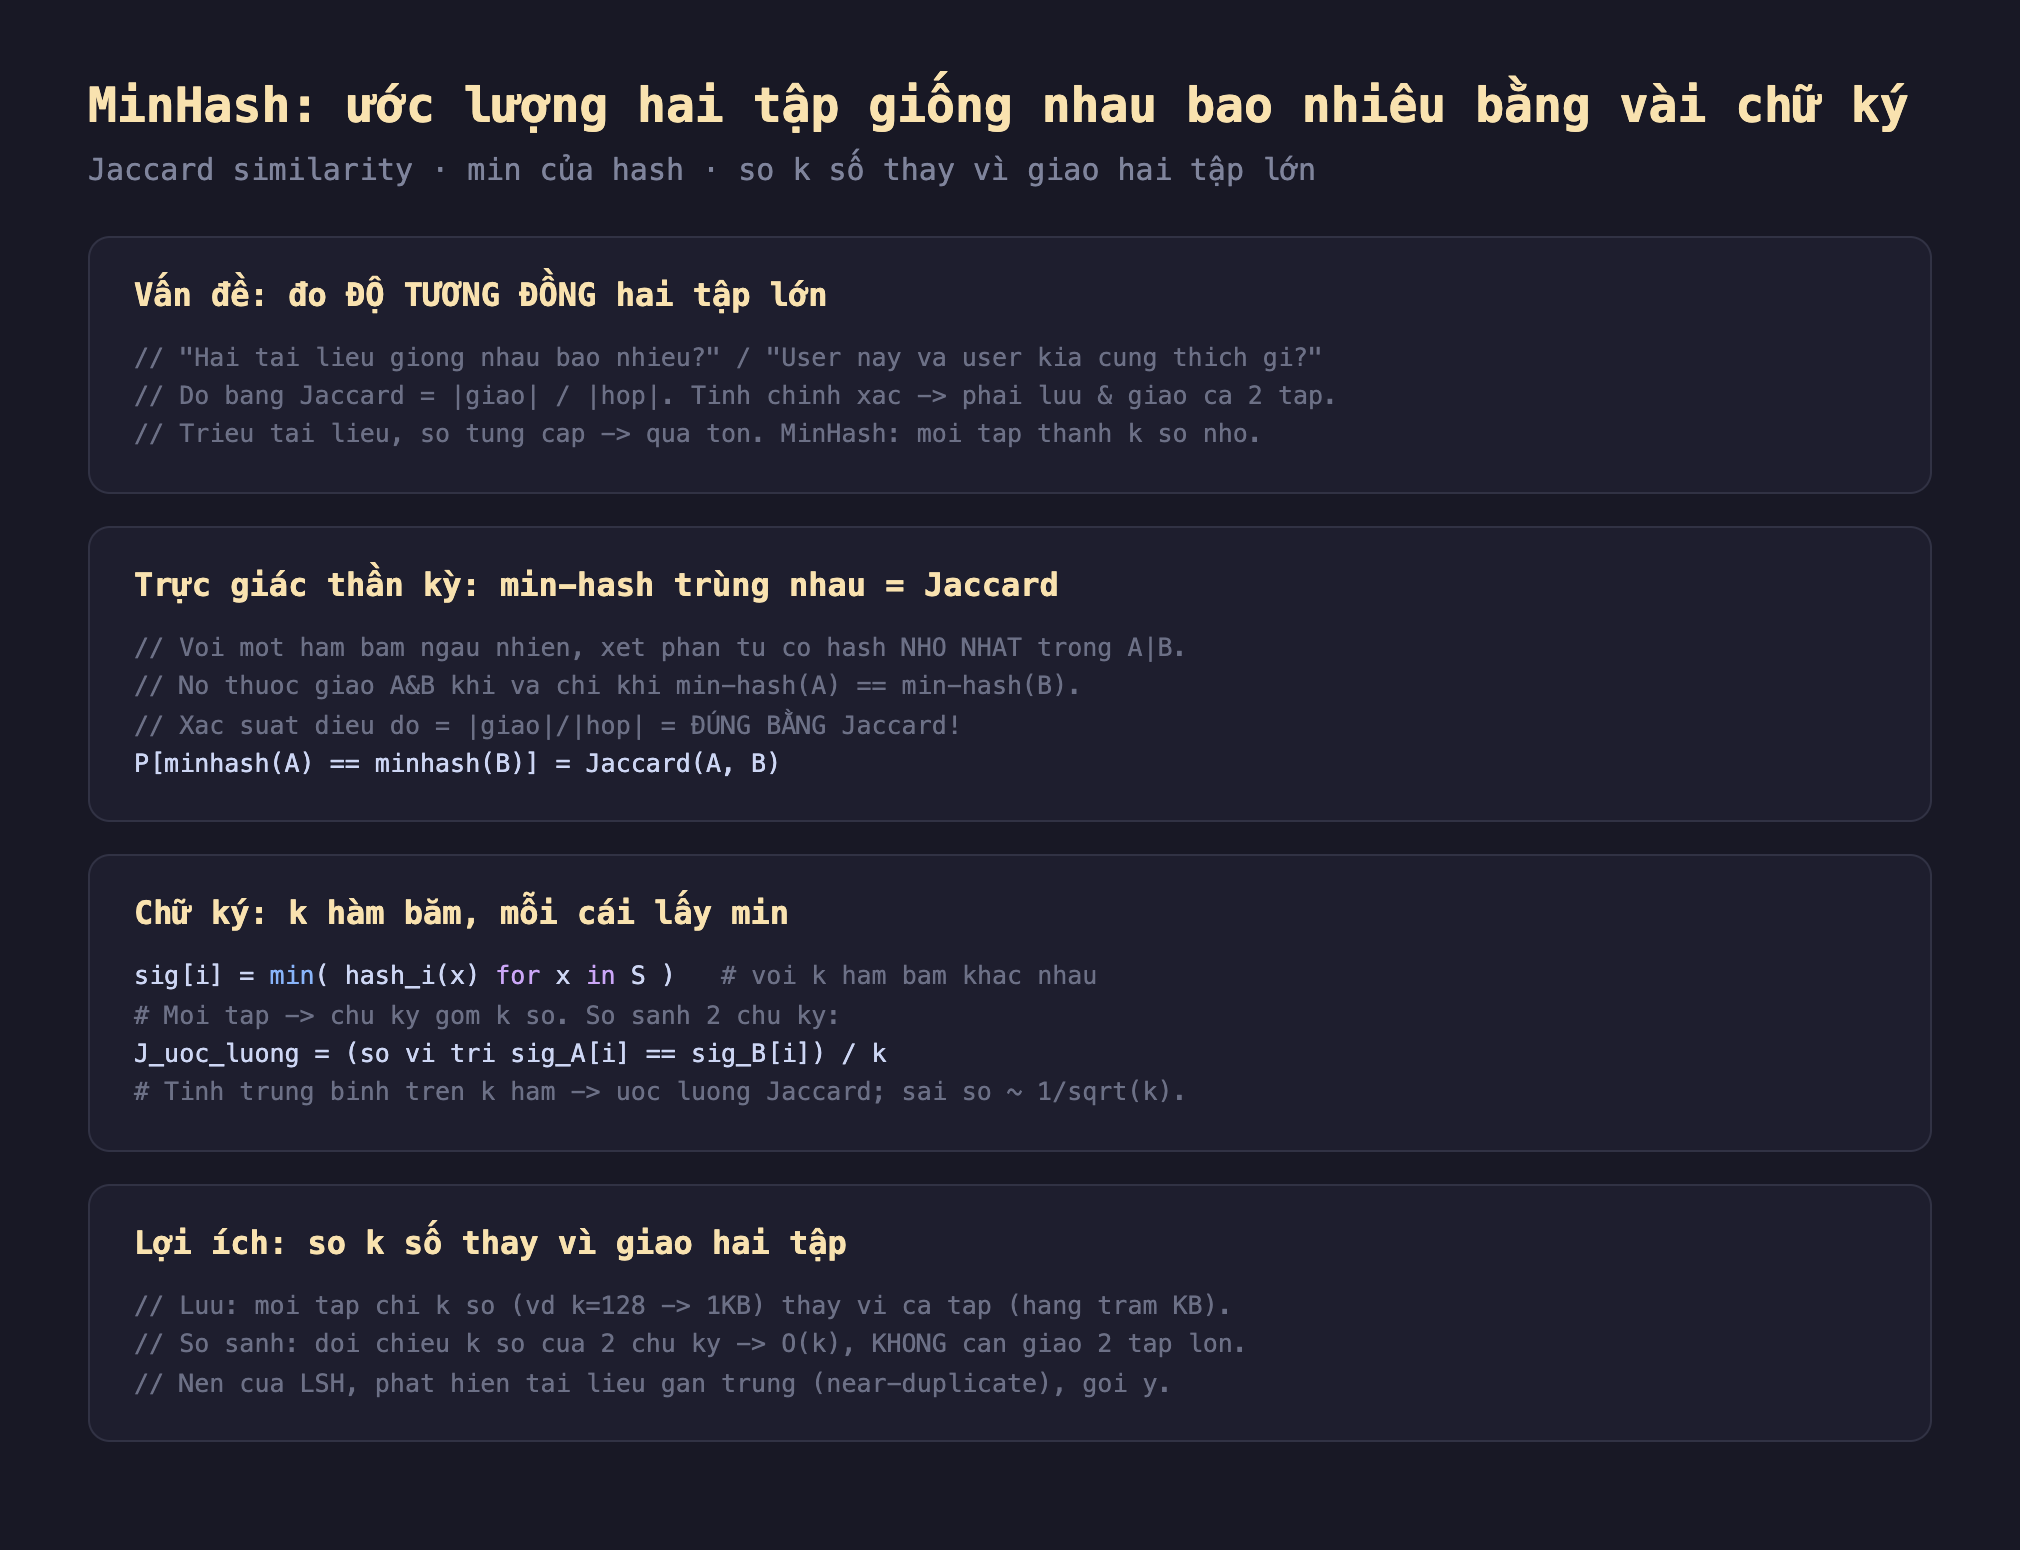
Hình 1: MinHash dựa trên sự thật P[minhash(A)==minhash(B)] = Jaccard(A,B); chữ ký của một tập là k giá trị min-hash (mỗi hàm băm lấy min trên tập), ước lượng Jaccard = tỉ lệ vị trí chữ ký trùng nhau, sai số ~1/√k; lợi ích là so k số thay vì giao hai tập lớn.
Đo thật: bám sát Jaccard, sai số giảm theo 1/√k
Mình tạo các cặp tập ~5000 phần tử với độ chồng lấn biết trước (90%, 50%, 10%, 0%), tính Jaccard thật (giao/hợp) và so với MinHash ước lượng ở k=128 và k=256:
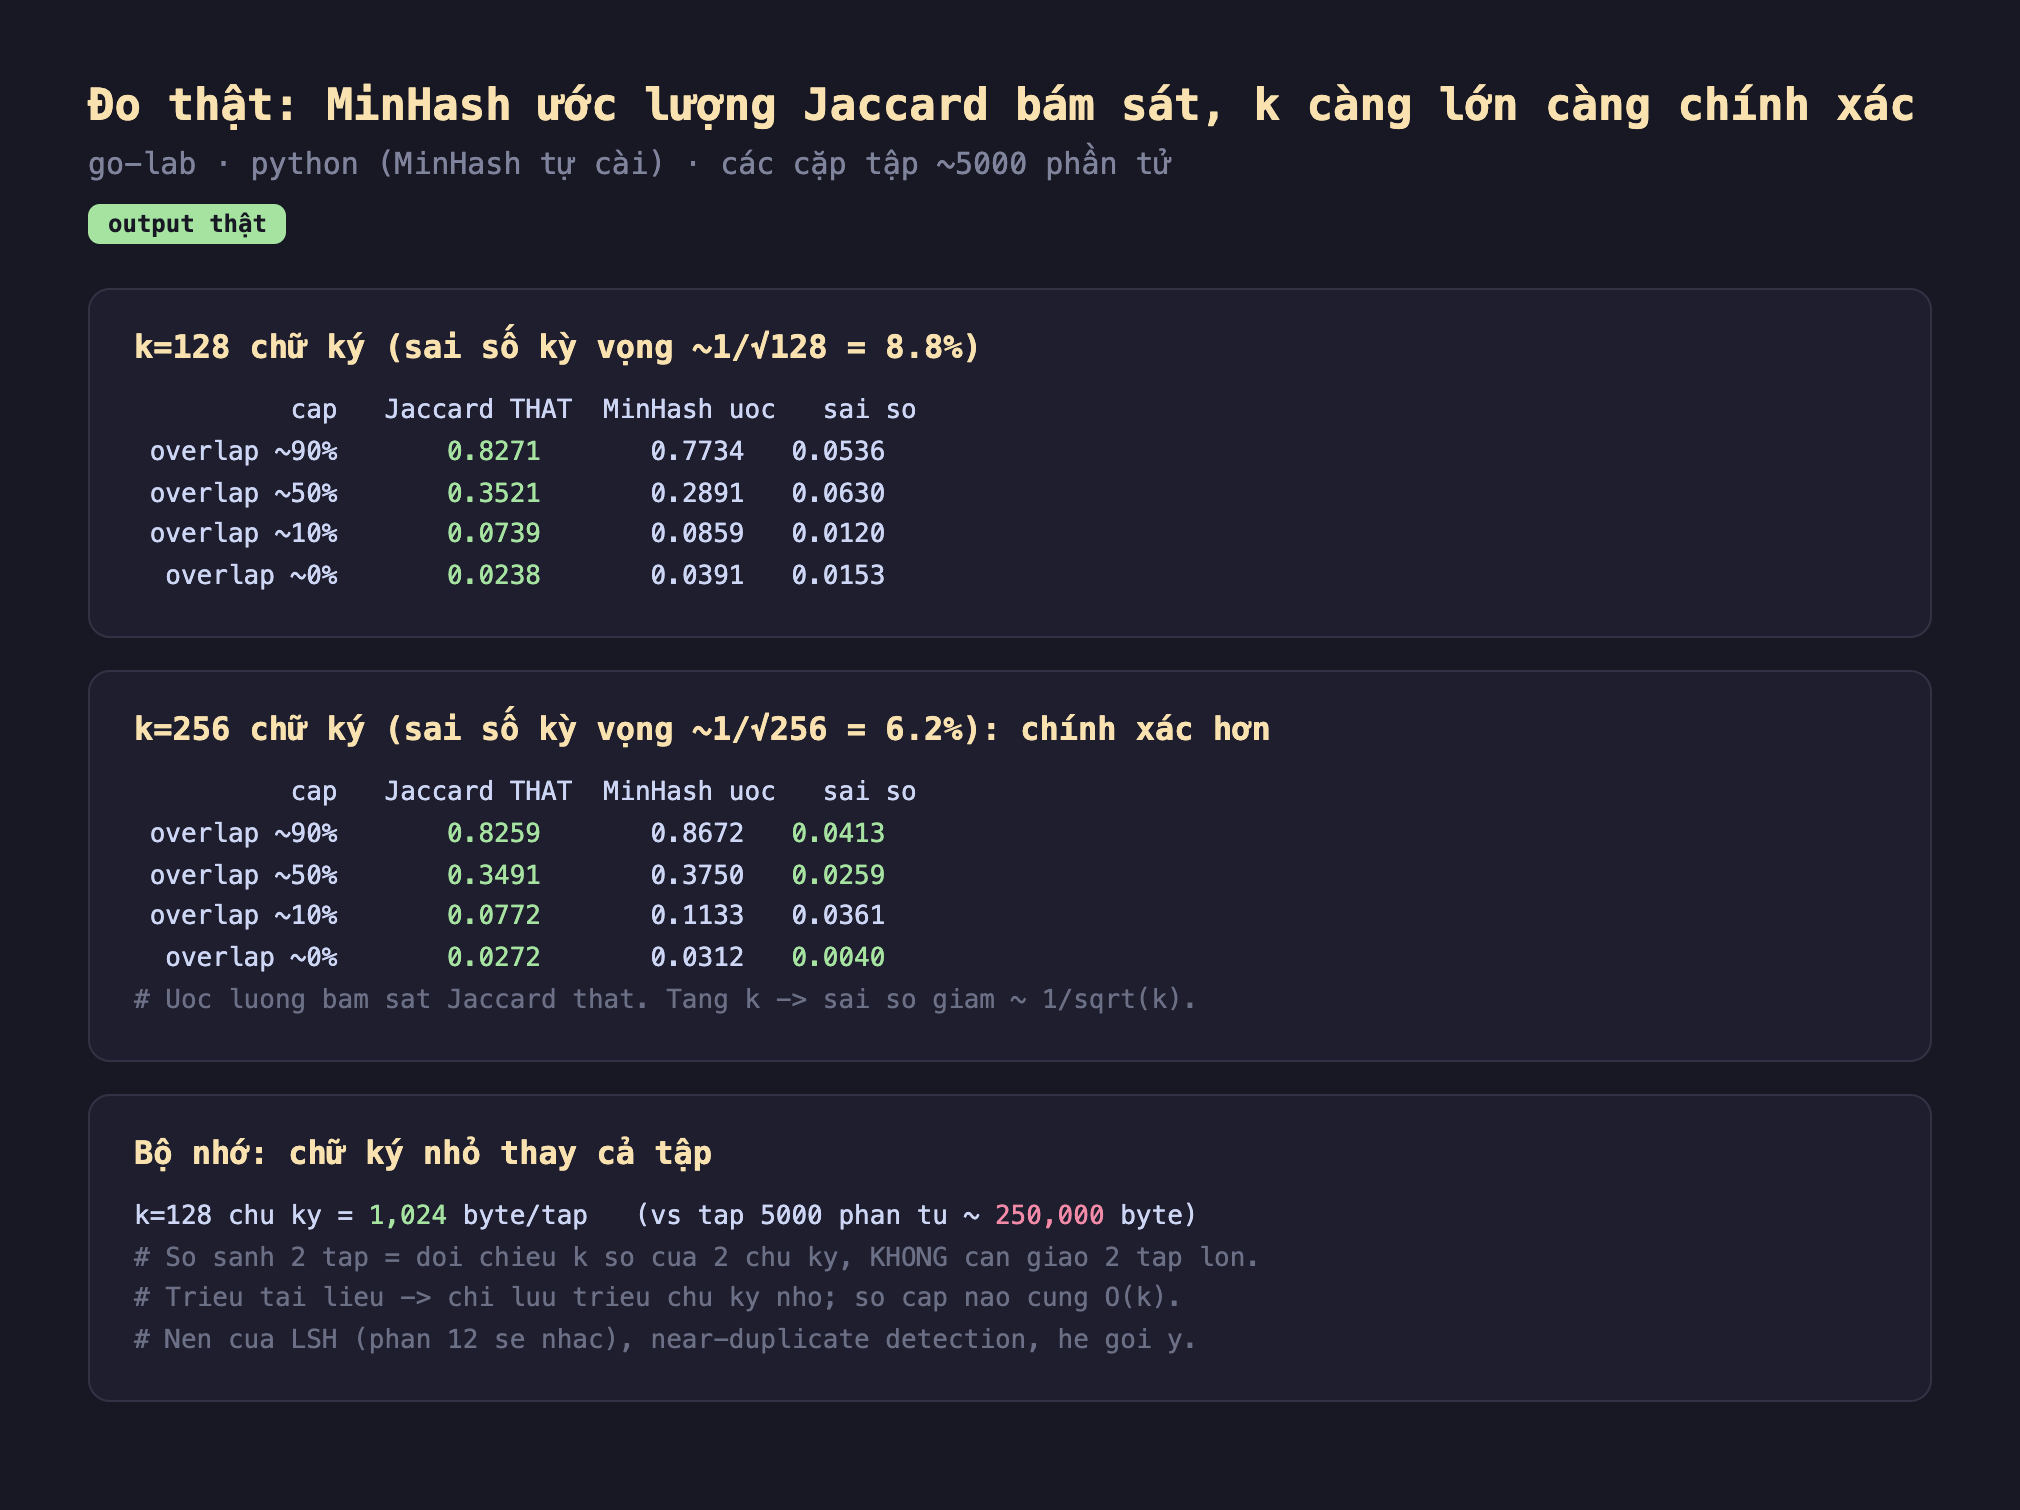
Hình 2: Chạy thật — k=128 (sai số kỳ vọng ~8.8%): Jaccard thật 0.8271/0.3521/0.0739/0.0238 vs MinHash 0.7734/0.2891/0.0859/0.0391; k=256 (~6.2%) chính xác hơn (sai số 0.0413/0.0259/0.0361/0.0040); mỗi tập chỉ 1.024 byte (k=128) vs cả tập ~250.000 byte.
- Ước lượng bám sát Jaccard thật: ở mọi mức chồng lấn, MinHash cho con số gần đúng — tập trùng nhiều (Jaccard ~0.83) được ước lượng ~0.77-0.87, tập gần rời nhau (Jaccard ~0.02) được ~0.03-0.04. Quan trọng là thứ tự đúng: tập giống nhau nhiều luôn được ước lượng cao hơn tập giống ít — đủ để phân loại "gần trùng" vs "khác nhau".
- Sai số giảm theo 1/√k: đây là quan hệ then chốt. k=128 cho sai số kỳ vọng ~1/√128 = 8.8%, và đo thực tế các sai số (0.05, 0.06, 0.01, 0.015) nằm quanh mức đó. Tăng lên k=256 (kỳ vọng 6.2%), sai số đo giảm rõ (0.041, 0.026, 0.036, 0.004). Muốn chính xác gấp đôi, cần k gấp bốn lần (vì 1/√k) — đây là đánh đổi độ chính xác ↔ kích thước chữ ký.
- Bộ nhớ: chữ ký nhỏ thay cả tập: mỗi tập chỉ cần lưu k số — k=128 là 1.024 byte, trong khi tập 5000 phần tử ngốn ~250KB. Nhỏ hơn ~250 lần. Và điểm mấu chốt: so hai tập giờ là đối chiếu k số của hai chữ ký (O(k)), không cần giao hai tập lớn. Với một triệu tài liệu, bạn lưu một triệu chữ ký nhỏ và so bất kỳ cặp nào trong O(k).
Đánh đổi cần cân nhắc
Một hash thật + k seed (như demo) đơn giản nhưng chậm — dùng k hash tính nhanh. Cài ở trên băm mỗi phần tử bằng SHA-1 k lần (một lần cho mỗi seed), tốn O(|S|·k) băm — đắt cho tập lớn. Các cài đặt thực dùng mẹo: một hash nhanh (MurmurHash) rồi sinh k giá trị bằng a_i·h + b_i (universal hashing), hoặc one-permutation MinHash chỉ băm một lần rồi chia thành k bucket. Với dữ liệu lớn, chọn cách tính chữ ký nhanh — kết quả tương đương nhưng nhanh hơn nhiều.
MinHash đo Jaccard trên tập, nên bạn phải biến dữ liệu thành tập đúng cách. Với văn bản, thường dùng shingling: cắt tài liệu thành các đoạn k-ký-tự hoặc k-từ liên tiếp (w-shingle), tập các shingle là "tập" đưa vào MinHash. Chọn kích thước shingle quan trọng: shingle ngắn làm mọi tài liệu trông giống nhau (nhiều shingle chung ngẫu nhiên), shingle dài làm chỉ bản sao gần y hệt mới giống. MinHash chỉ tốt như cách bạn định nghĩa "tập" — sai bước shingling là sai kết quả.
So triệu cặp vẫn tốn — MinHash cần LSH để thực sự mở rộng. MinHash làm một phép so rẻ (O(k)), nhưng nếu bạn có một triệu tài liệu và muốn tìm mọi cặp gần trùng, đó vẫn là 10^12 phép so — không khả thi. Giải pháp là LSH (Locality-Sensitive Hashing): băm các chữ ký MinHash thành các "xô", để các tập giống nhau rơi vào cùng xô, và chỉ so trong xô. LSH + MinHash là cặp bài trùng cho phát hiện near-duplicate ở quy mô web (Google dùng cho khử trùng lặp trang). MinHash một mình là viên gạch; LSH là thứ biến nó thành hệ thống.
Ba ý mang về
- MinHash ước lượng Jaccard bằng chữ ký nhỏ: dựa trên sự thật đẹp
P[minhash(A)==minhash(B)] = Jaccard(A,B); đo thật ước lượng bám sát Jaccard thật ở mọi mức chồng lấn (90% → 0%), với mỗi tập chỉ 1KB (k=128) thay vì 250KB cả tập. - Sai số giảm theo 1/√k: đo thật k=128 cho sai số ~kỳ vọng 8.8%, k=256 giảm còn ~6.2% — muốn chính xác gấp đôi cần k gấp bốn; và so hai tập là đối chiếu k số (O(k)), không cần giao hai tập lớn.
- MinHash là viên gạch, cần shingling đúng và LSH để mở rộng: biến dữ liệu thành tập đúng cách (shingling cho văn bản); dùng k-hash tính nhanh thay vì băm k lần; và ghép với LSH để tìm near-duplicate trong triệu tài liệu mà không so mọi cặp.
Nguồn
- Broder — On the resemblance and containment of documents (MinHash, 1997): https://www.cs.princeton.edu/courses/archive/spring13/cos598C/broder97resemblance.pdf
- Leskovec, Rajaraman, Ullman — Mining of Massive Datasets (ch.3: MinHash & LSH): http://www.mmds.org/
- Wikipedia — MinHash: https://en.wikipedia.org/wiki/MinHash
Phần sau ta chuyển sang một kỹ thuật khác của xử lý luồng: reservoir sampling — lấy một mẫu ngẫu nhiên đều k phần tử từ một luồng mà không biết trước độ dài, chỉ với một lượt duyệt và bộ nhớ O(k).
