Phần 6 kết thúc với một hạn chế của Count-Min Sketch: nó đếm được tần suất khi bạn hỏi về một phần tử cụ thể, nhưng không tự biết phần tử nào nóng nhất. Mà trong thực tế, câu hỏi thường gặp lại chính là "phần tử nào nóng nhất?" — top 10 từ khóa tìm nhiều nhất, top IP gọi API nhiều nhất (dấu hiệu DDoS), sản phẩm trending. Đây gọi là bài toán heavy hitters (top-k). Lưu cả Counter đầy đủ thì tốn RAM theo số phần tử khác nhau. Giải pháp thanh lịch: ghép CMS (đếm tần suất bằng bộ nhớ cố định) với một min-heap nhỏ (theo dõi K ứng viên nóng nhất). Bài này (phần 7 loạt Xác suất) tự cài và đo thật độ chính xác của top-k tìm được.
Cơ chế: CMS đếm, min-heap giữ ứng viên
Ý tưởng kết hợp: CMS trả lời "tần suất ước lượng của x", và một min-heap kích thước K giữ K phần tử có tần suất cao nhất thấy được cho tới giờ. Với mỗi phần tử đến trong luồng:
- Cập nhật CMS (tăng d ô như phần 6).
- Hỏi CMS tần suất ước lượng của phần tử đó.
- So với phần tử nhỏ nhất trong heap (
heap[0]): nếu lớn hơn, đẩy ứng viên yếu nhất ra và thêm phần tử này vào.
Min-heap cho phép luôn biết "ứng viên yếu nhất hiện tại" trong O(1) và thay nó trong O(log K). Bộ nhớ = CMS (cố định) + K phần tử (nhỏ) — không phụ thuộc số phần tử khác nhau trong luồng.
cms.add(tok); est = cms.count(tok)
if tok in heap: cập_nhật_est_trong_heap
elif len(heap) < K: heapq.heappush(heap, (est, tok))
elif est > heap[0][0]:                 # lớn hơn phần tử nhỏ nhất
    heapq.heapreplace(heap, (est, tok))  # đẩy ứng viên yếu nhất ra
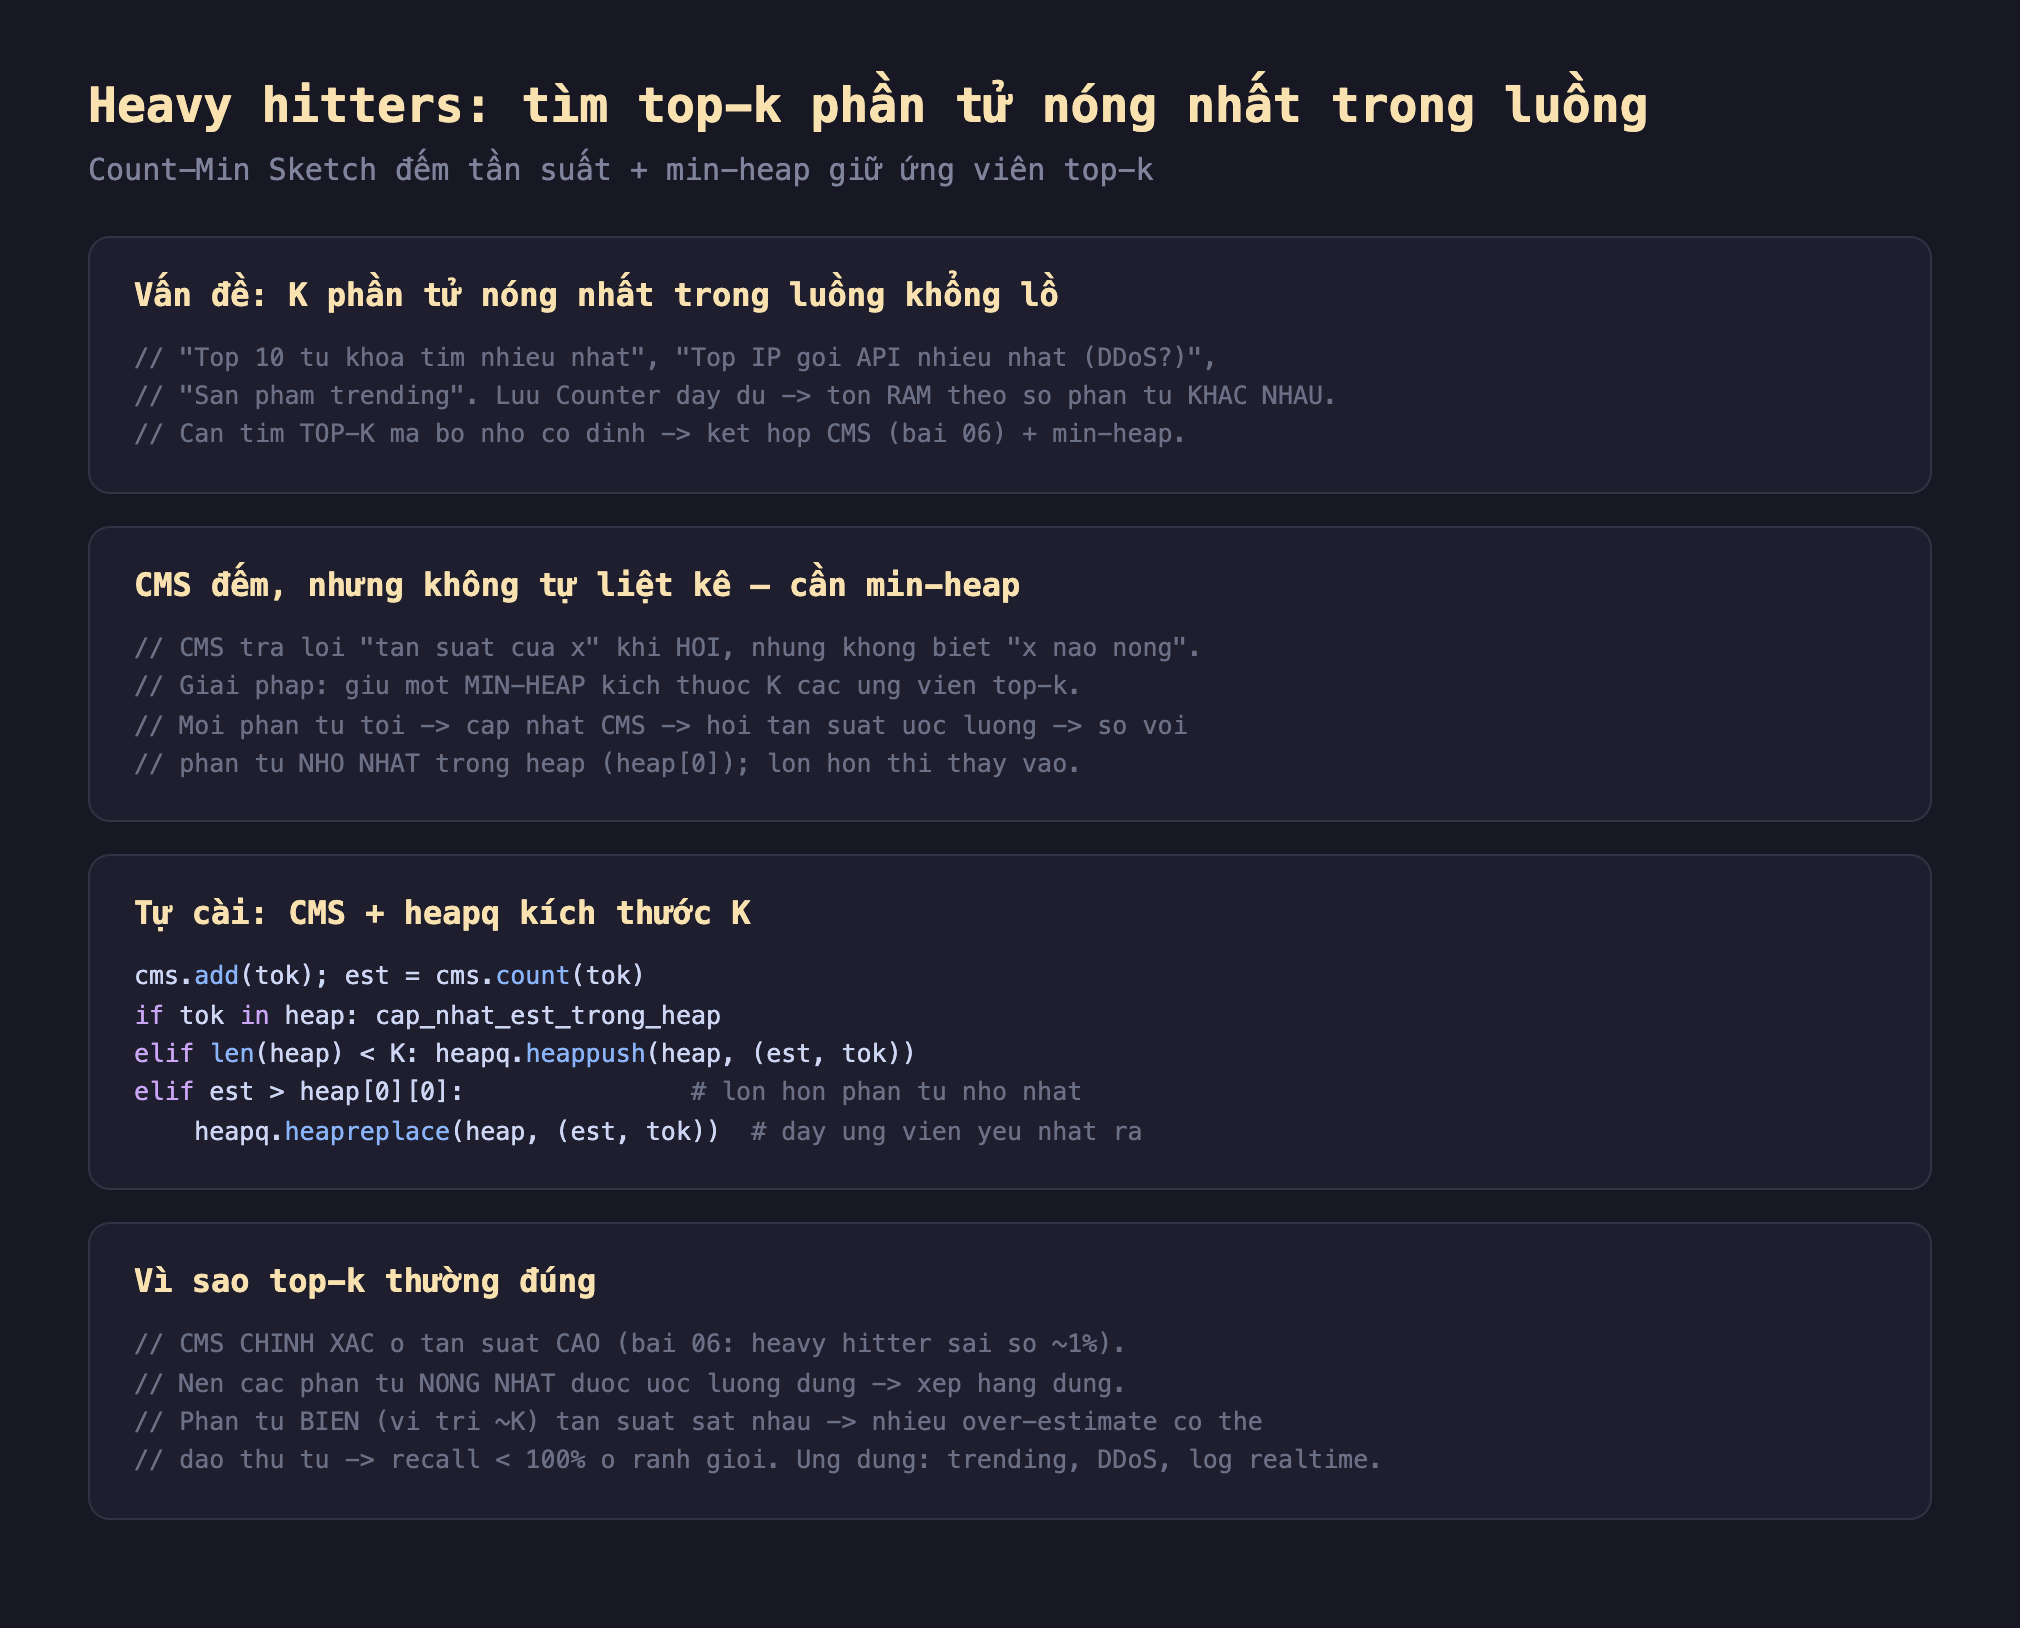
Hình 1: Heavy hitters = CMS (đếm tần suất bằng bộ nhớ cố định) + min-heap kích thước K (giữ ứng viên nóng nhất); mỗi phần tử đến cập nhật CMS, hỏi tần suất, so với phần tử nhỏ nhất trong heap và thay nếu lớn hơn; top-k thường đúng vì CMS chính xác ở tần suất cao.
Đo thật: recall 90%, chỉ lệch ở ranh giới
Mình tạo luồng 300.000 sự kiện với phân phối lệch (15.000 phần tử khác nhau), tìm top-10 bằng CMS+heap, và so với top-10 thật (tính từ Counter đầy đủ để kiểm chứng):
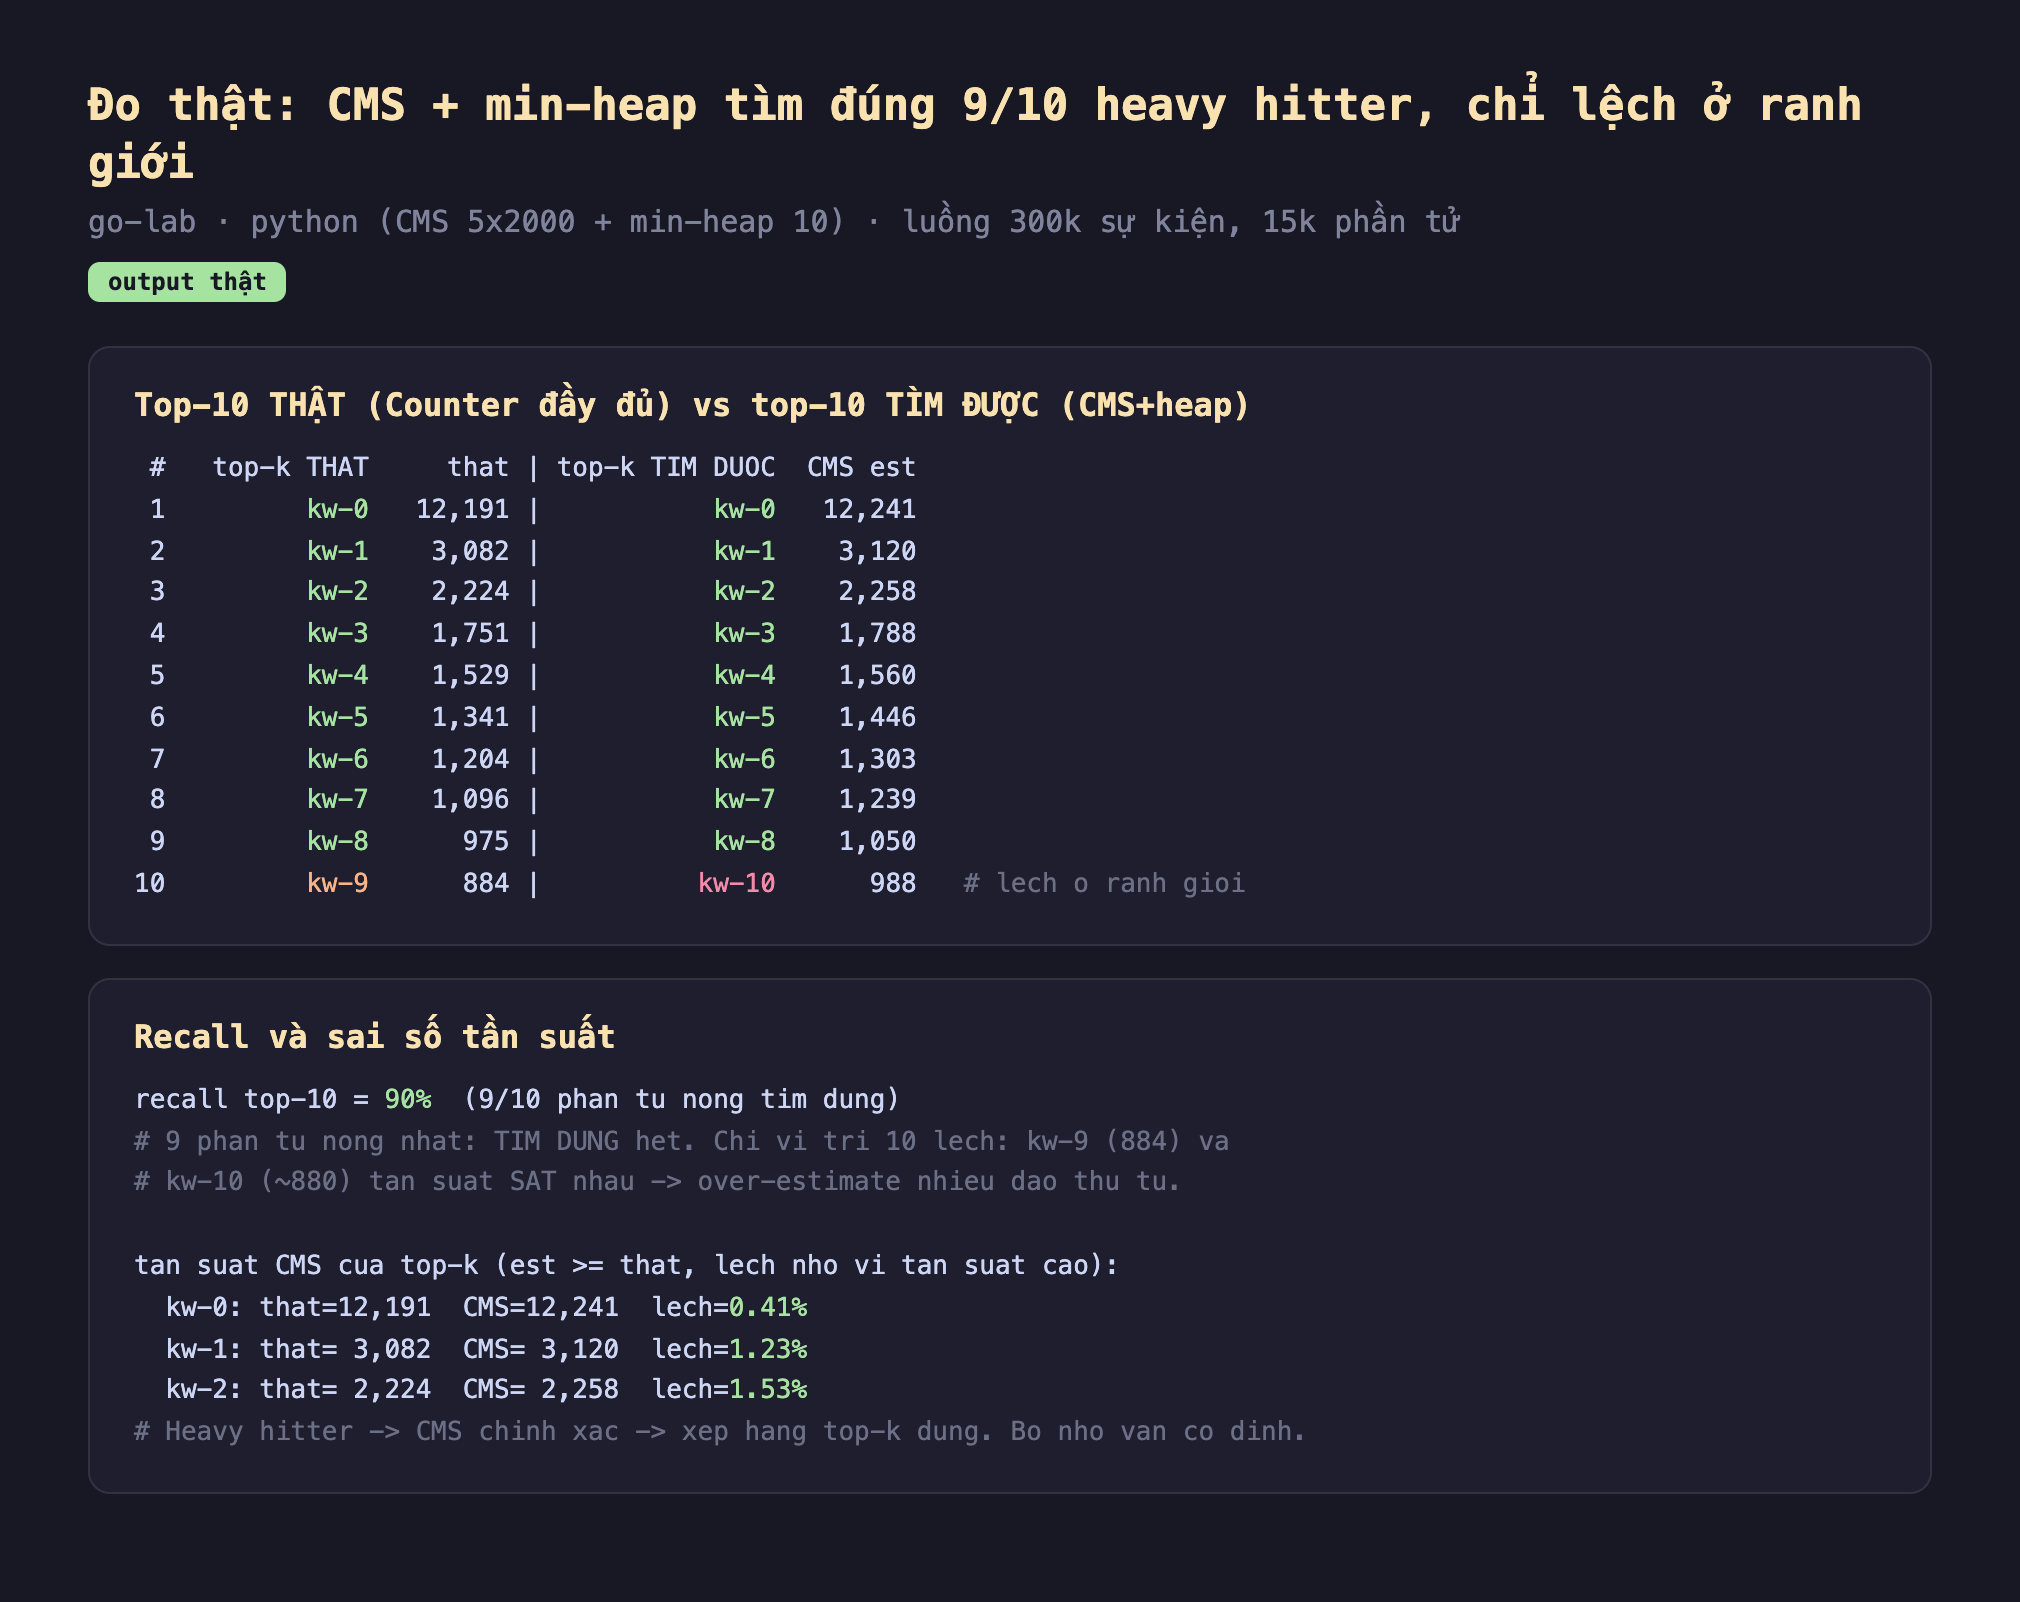
Hình 2: Chạy thật — top-10 thật (kw-0..kw-9) vs top-10 tìm được: chín vị trí đầu (kw-0..kw-8) khớp hoàn toàn, chỉ vị trí 10 lệch (tìm kw-10 thay vì kw-9, hai phần tử có tần suất sát nhau ~880); recall 90%; CMS over-estimate nhỏ cho heavy hitter (kw-0 lệch 0.41%, kw-1 1.23%, kw-2 1.53%).
- Chín heavy hitter nóng nhất: tìm đúng hết: các vị trí 1-9 (kw-0 đến kw-8) khớp chính xác giữa top-k tìm được và top-k thật, đúng thứ tự. Đây là điều CMS+heap làm tốt: những phần tử thực sự nóng được nhận diện và xếp hạng đúng.
- Vì sao đúng: CMS chính xác ở tần suất cao: nhớ phần 6 — CMS over-estimate tương đối nhỏ với phần tử tần suất cao. Ở đây kw-0 (thật 12.191) được ước lượng 12.241 (lệch chỉ 0.41%), kw-1 lệch 1.23%, kw-2 lệch 1.53%. Vì các heavy hitter được đếm gần đúng, thứ tự của chúng được giữ đúng. Đây chính là lý do CMS hợp với bài toán heavy hitters (và không hợp đếm phần tử hiếm).
- Chỉ lệch ở ranh giới (recall 90%): vị trí thứ 10 tìm được kw-10 thay vì kw-9. Lý do trung thực: hai phần tử này có tần suất rất sát nhau (884 vs ~880), và lượng over-estimate của CMS (vốn nhiễu vài chục) đủ để đảo thứ tự của hai phần tử gần bằng nhau ở ranh giới top-k. Đây là hạn chế cố hữu: top-k xấp xỉ luôn có thể sai ở đường biên nơi tần suất các phần tử gần nhau — nhưng các phần tử rõ ràng nóng thì luôn đúng.
Đánh đổi cần cân nhắc
Recall cao ở đỉnh, kém ở biên — tăng K nội bộ để chắc chắn. Vì lỗi tập trung ở ranh giới top-k, một mẹo thực tế là theo dõi nhiều hơn K ứng viên (ví dụ giữ heap kích thước 2K hoặc 3K) rồi lấy top-K cuối cùng. Điều này giảm khả năng một phần tử thực sự thuộc top-K bị đẩy ra sớm do nhiễu. Đổi lại một chút bộ nhớ heap (vẫn nhỏ so với CMS) để tăng recall ở biên. Nếu bạn cần chính xác tuyệt đối ở biên thì heavy hitters xấp xỉ không phải công cụ đúng.
CMS over-estimate làm tần suất báo cao hơn thật — nhớ khi hiển thị. Con số tần suất mà bạn lấy ra cho top-k là ước lượng vượt (kw-0 báo 12.241 thay vì 12.191). Với hiển thị "xu hướng" thì không sao, nhưng nếu bạn dùng con số này cho tính toán tiếp (ví dụ tính tỉ lệ phần trăm), nhớ rằng nó hơi cao. Muốn con số chính xác hơn cho riêng top-k (ít phần tử), có thể duy trì một Counter thật chỉ cho các ứng viên trong heap — bộ nhớ vẫn nhỏ vì heap nhỏ.
Có các thuật toán heavy-hitter chuyên dụng tốt hơn cho một số ca. CMS+heap là cách phổ biến và đơn giản, nhưng có những thuật toán chuyên cho heavy hitters với đảm bảo tốt hơn: Space-Saving (Metwally et al.) đảm bảo tìm đủ mọi phần tử vượt ngưỡng tần suất với bộ nhớ nhỏ hơn, và Misra-Gries là thuật toán cổ điển đơn giản. Nếu heavy hitters là nhu cầu chính (không chỉ đếm tần suất chung), cân nhắc Space-Saving — nó thường chính xác hơn CMS+heap cho cùng bộ nhớ.
Ba ý mang về
- Heavy hitters = CMS + min-heap: đo thật trên luồng 300.000 sự kiện, CMS (bộ nhớ cố định) đếm tần suất và min-heap kích thước K giữ ứng viên nóng nhất — mỗi phần tử đến, cập nhật CMS, so với phần tử nhỏ nhất trong heap và thay nếu lớn hơn.
- Top-k đúng vì CMS chính xác ở tần suất cao: đo thật 9/10 heavy hitter tìm đúng (recall 90%), các vị trí 1-9 khớp hoàn toàn với over-estimate nhỏ (0.41-1.53%); lỗi chỉ ở ranh giới nơi tần suất các phần tử sát nhau (kw-9 vs kw-10).
- Biết giới hạn và cách cải thiện: lỗi tập trung ở biên top-k (tăng heap lên 2K-3K để tăng recall); tần suất báo là over-estimate (duy trì Counter thật cho riêng ứng viên nếu cần chính xác); và cân nhắc Space-Saving/Misra-Gries khi heavy hitters là nhu cầu chính.
Nguồn
- Cormode & Muthukrishnan — Count-Min Sketch and its Applications (heavy hitters): http://dimacs.rutgers.edu/~graham/pubs/papers/cm-full.pdf
- Metwally, Agrawal, El Abbadi — Efficient Computation of Frequent and Top-k Elements in Data Streams (Space-Saving, 2005): https://www.cse.ust.hk/~raywong/comp5331/References/EfficientComputationOfFrequentAndTop-kElementsInDataStreams.pdf
- Wikipedia — Misra–Gries summary: https://en.wikipedia.org/wiki/Misra%E2%80%93Gries_summary
Phần sau ta chuyển sang bài toán độ tương đồng: MinHash ước lượng hai tập giống nhau bao nhiêu (Jaccard similarity) bằng vài chữ ký nhỏ thay vì so từng phần tử — nền của phát hiện trùng lặp và gợi ý ở quy mô lớn.
