Ba cấu trúc, ba câu hỏi khác nhau. Bloom filter (phần 1-3): "x có trong tập không?". HyperLogLog (phần 4-5): "có bao nhiêu phần tử khác nhau?". Giờ đến câu hỏi thứ ba, cũng tốn RAM không kém: "phần tử này xuất hiện bao nhiêu lần?" — đếm tần suất. Có bao nhiêu lần từ khóa này được tìm, IP này gọi API, sản phẩm này được xem? Cách hiển nhiên là một dict{phần_tử: đếm}, nhưng nó tốn RAM tỉ lệ số phần tử khác nhau — một triệu từ khóa duy nhất ngốn hàng trăm MB. Count-Min Sketch (CMS) đếm tần suất mọi phần tử bằng một ma trận nhỏ cố định, đổi lại một sai số một chiều thú vị. Bài này (phần 6 loạt Xác suất) tự cài CMS và đo thật điểm mạnh lẫn điểm yếu của nó.
Cơ chế: ma trận d × w và phép lấy MIN
CMS là một ma trận d hàng × w cột các bộ đếm, mỗi hàng có một hàm băm độc lập:
- Thêm x: với mỗi hàng i, tăng ô
CMS[i][hash_i(x)]lên 1. - Đếm x: lấy MIN của d ô đó —
min(CMS[i][hash_i(x)])qua mọi hàng.
Tại sao lấy MIN? Vì va chạm chỉ làm bộ đếm tăng, không bao giờ giảm. Khi một phần tử khác băm trùng ô của x (ở một hàng nào đó), nó cộng thêm vào ô đó, làm ô cao hơn giá trị thật của x. Nhưng ít có khả năng x bị mọi d hàng đều va chạm; hàng nào ít va chạm nhất cho giá trị gần thật nhất. Lấy MIN chính là chọn hàng "may mắn" đó. Hệ quả quan trọng: CMS luôn ước lượng vượt (over-estimate), không bao giờ thiếu — giá trị thật ≤ mọi ô, nên thật ≤ MIN.
def add(self, x):
    for i in range(self.d): self.t[i][self._h(x,i)] += 1
def count(self, x):
    return min(self.t[i][self._h(x,i)] for i in range(self.d))  # MIN: gần thật nhất
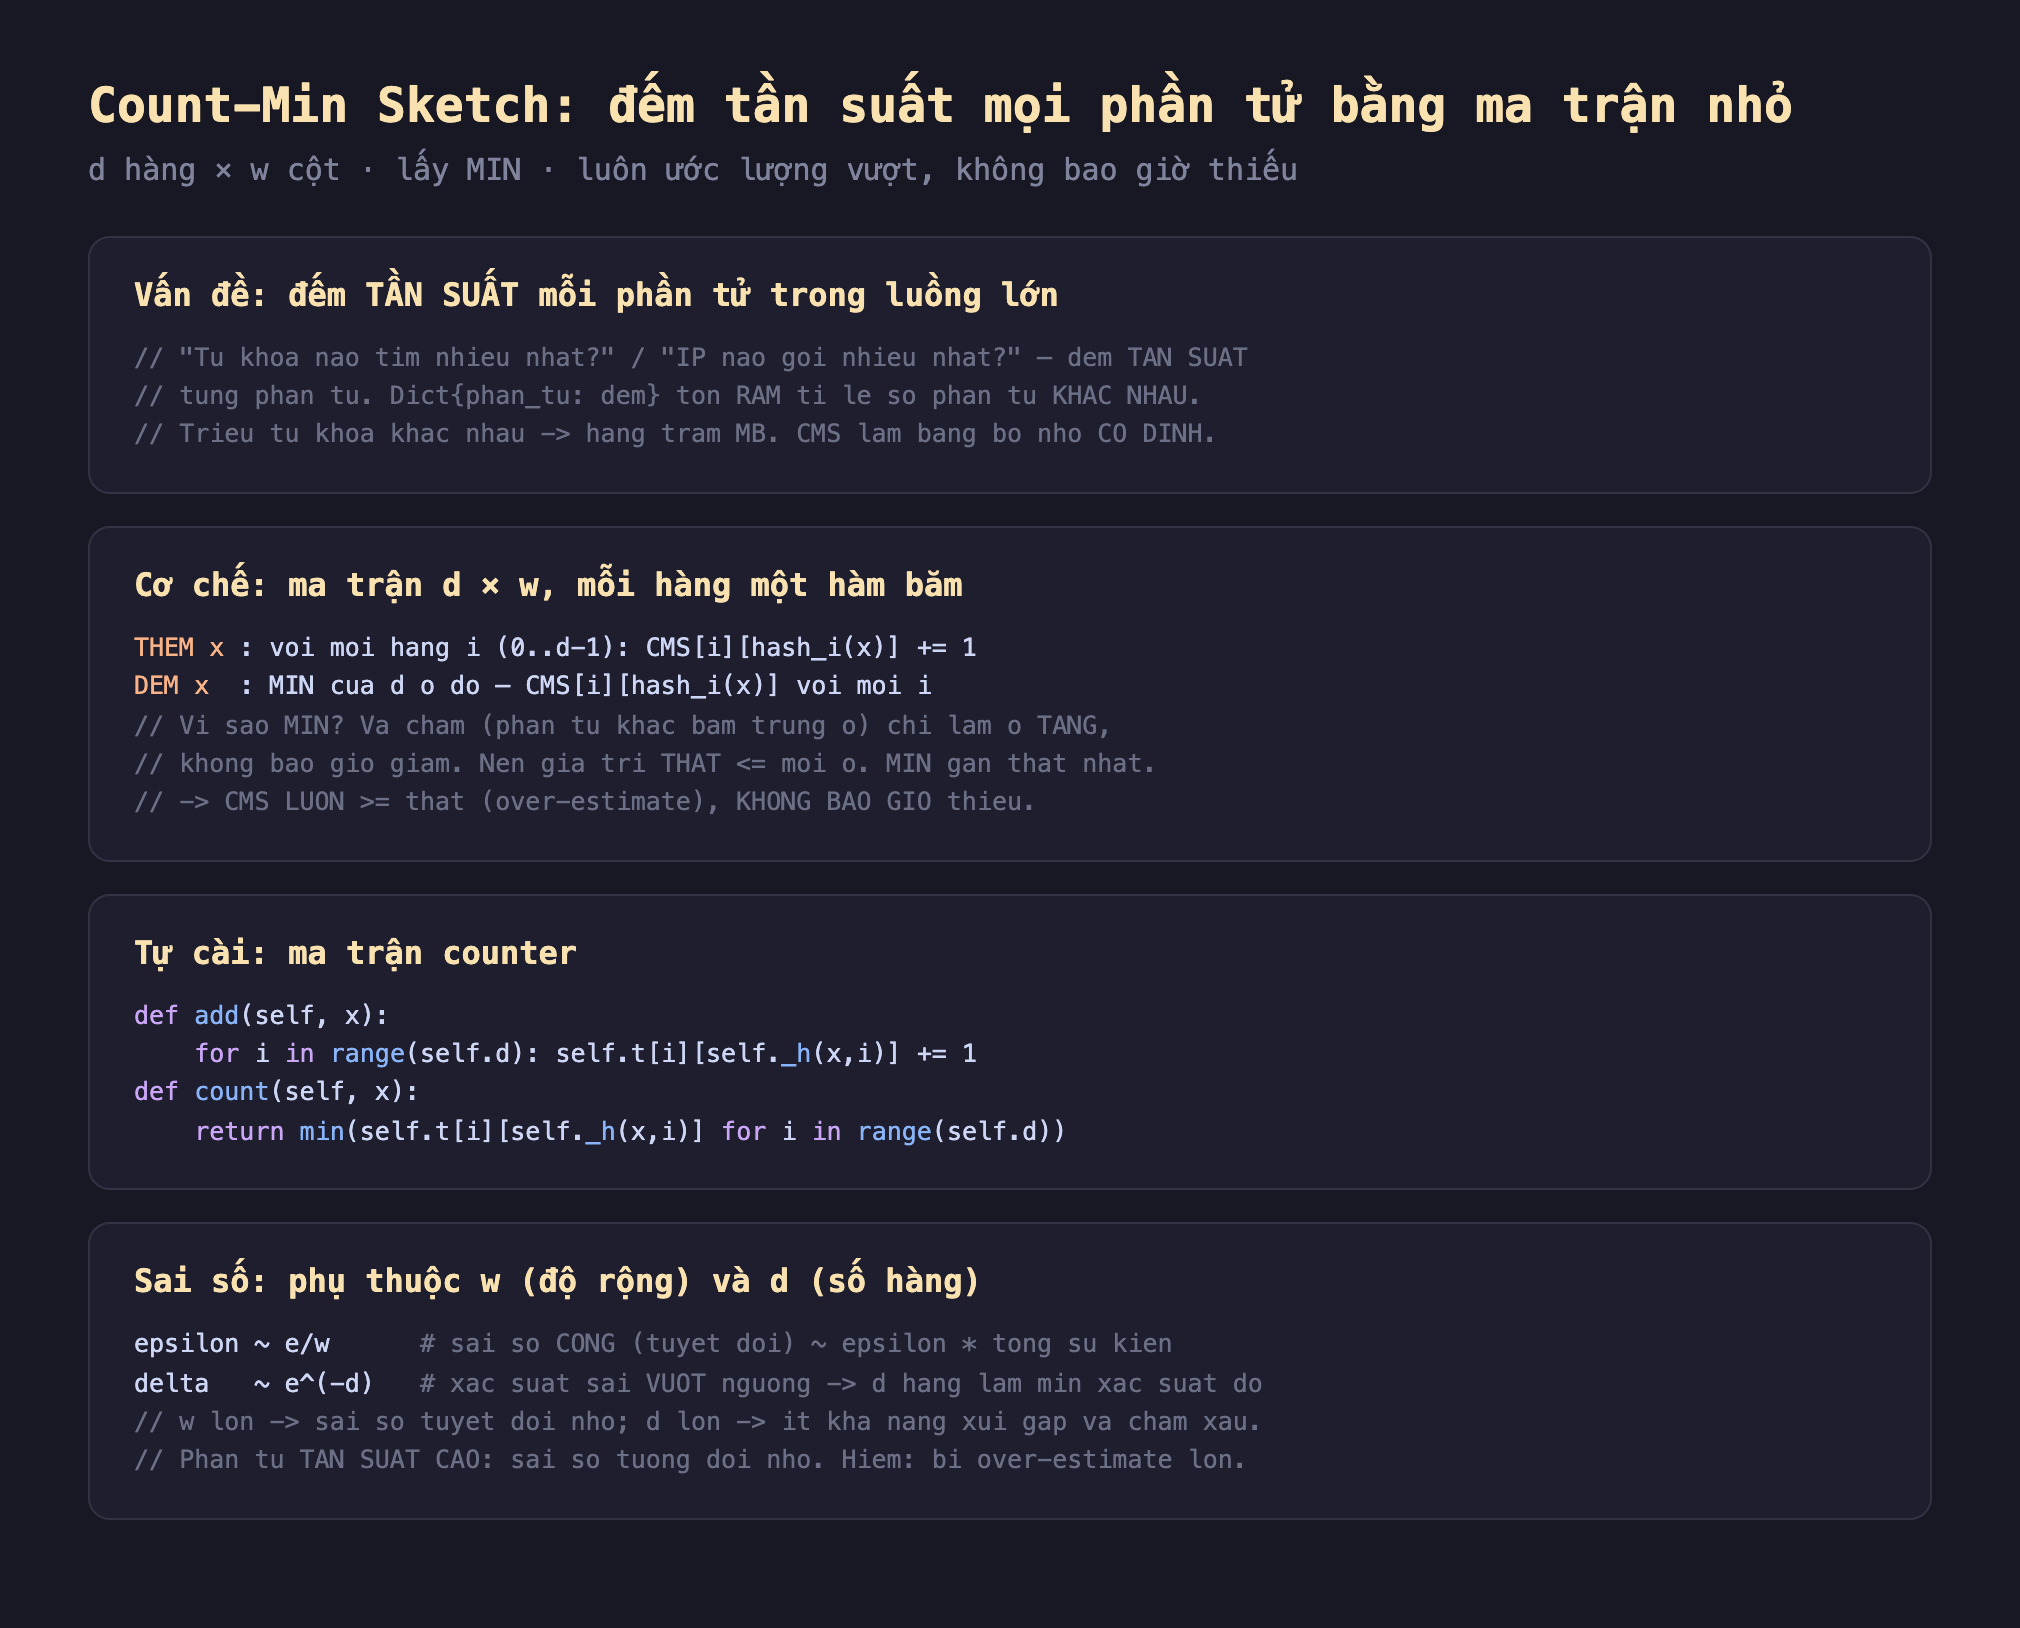
Hình 1: Count-Min Sketch là ma trận d hàng × w cột, mỗi hàng một hàm băm; thêm x tăng d ô, đếm x lấy MIN của d ô (va chạm chỉ làm tăng nên MIN gần thật nhất); CMS luôn ≥ thật (over-estimate); sai số ~ε=e/w (tuyệt đối), δ=e^(-d) (xác suất vượt ngưỡng).
Đo thật: hoàn hảo với heavy hitters, tệ với đuôi dài
Mình tạo một luồng 2 triệu sự kiện với phân phối lệch (kiểu Zipf: vài phần tử tần suất rất cao, rất nhiều phần tử tần suất thấp — giống dữ liệu thật), đếm bằng CMS (d=5 × w=2000) và so với tần suất thật:
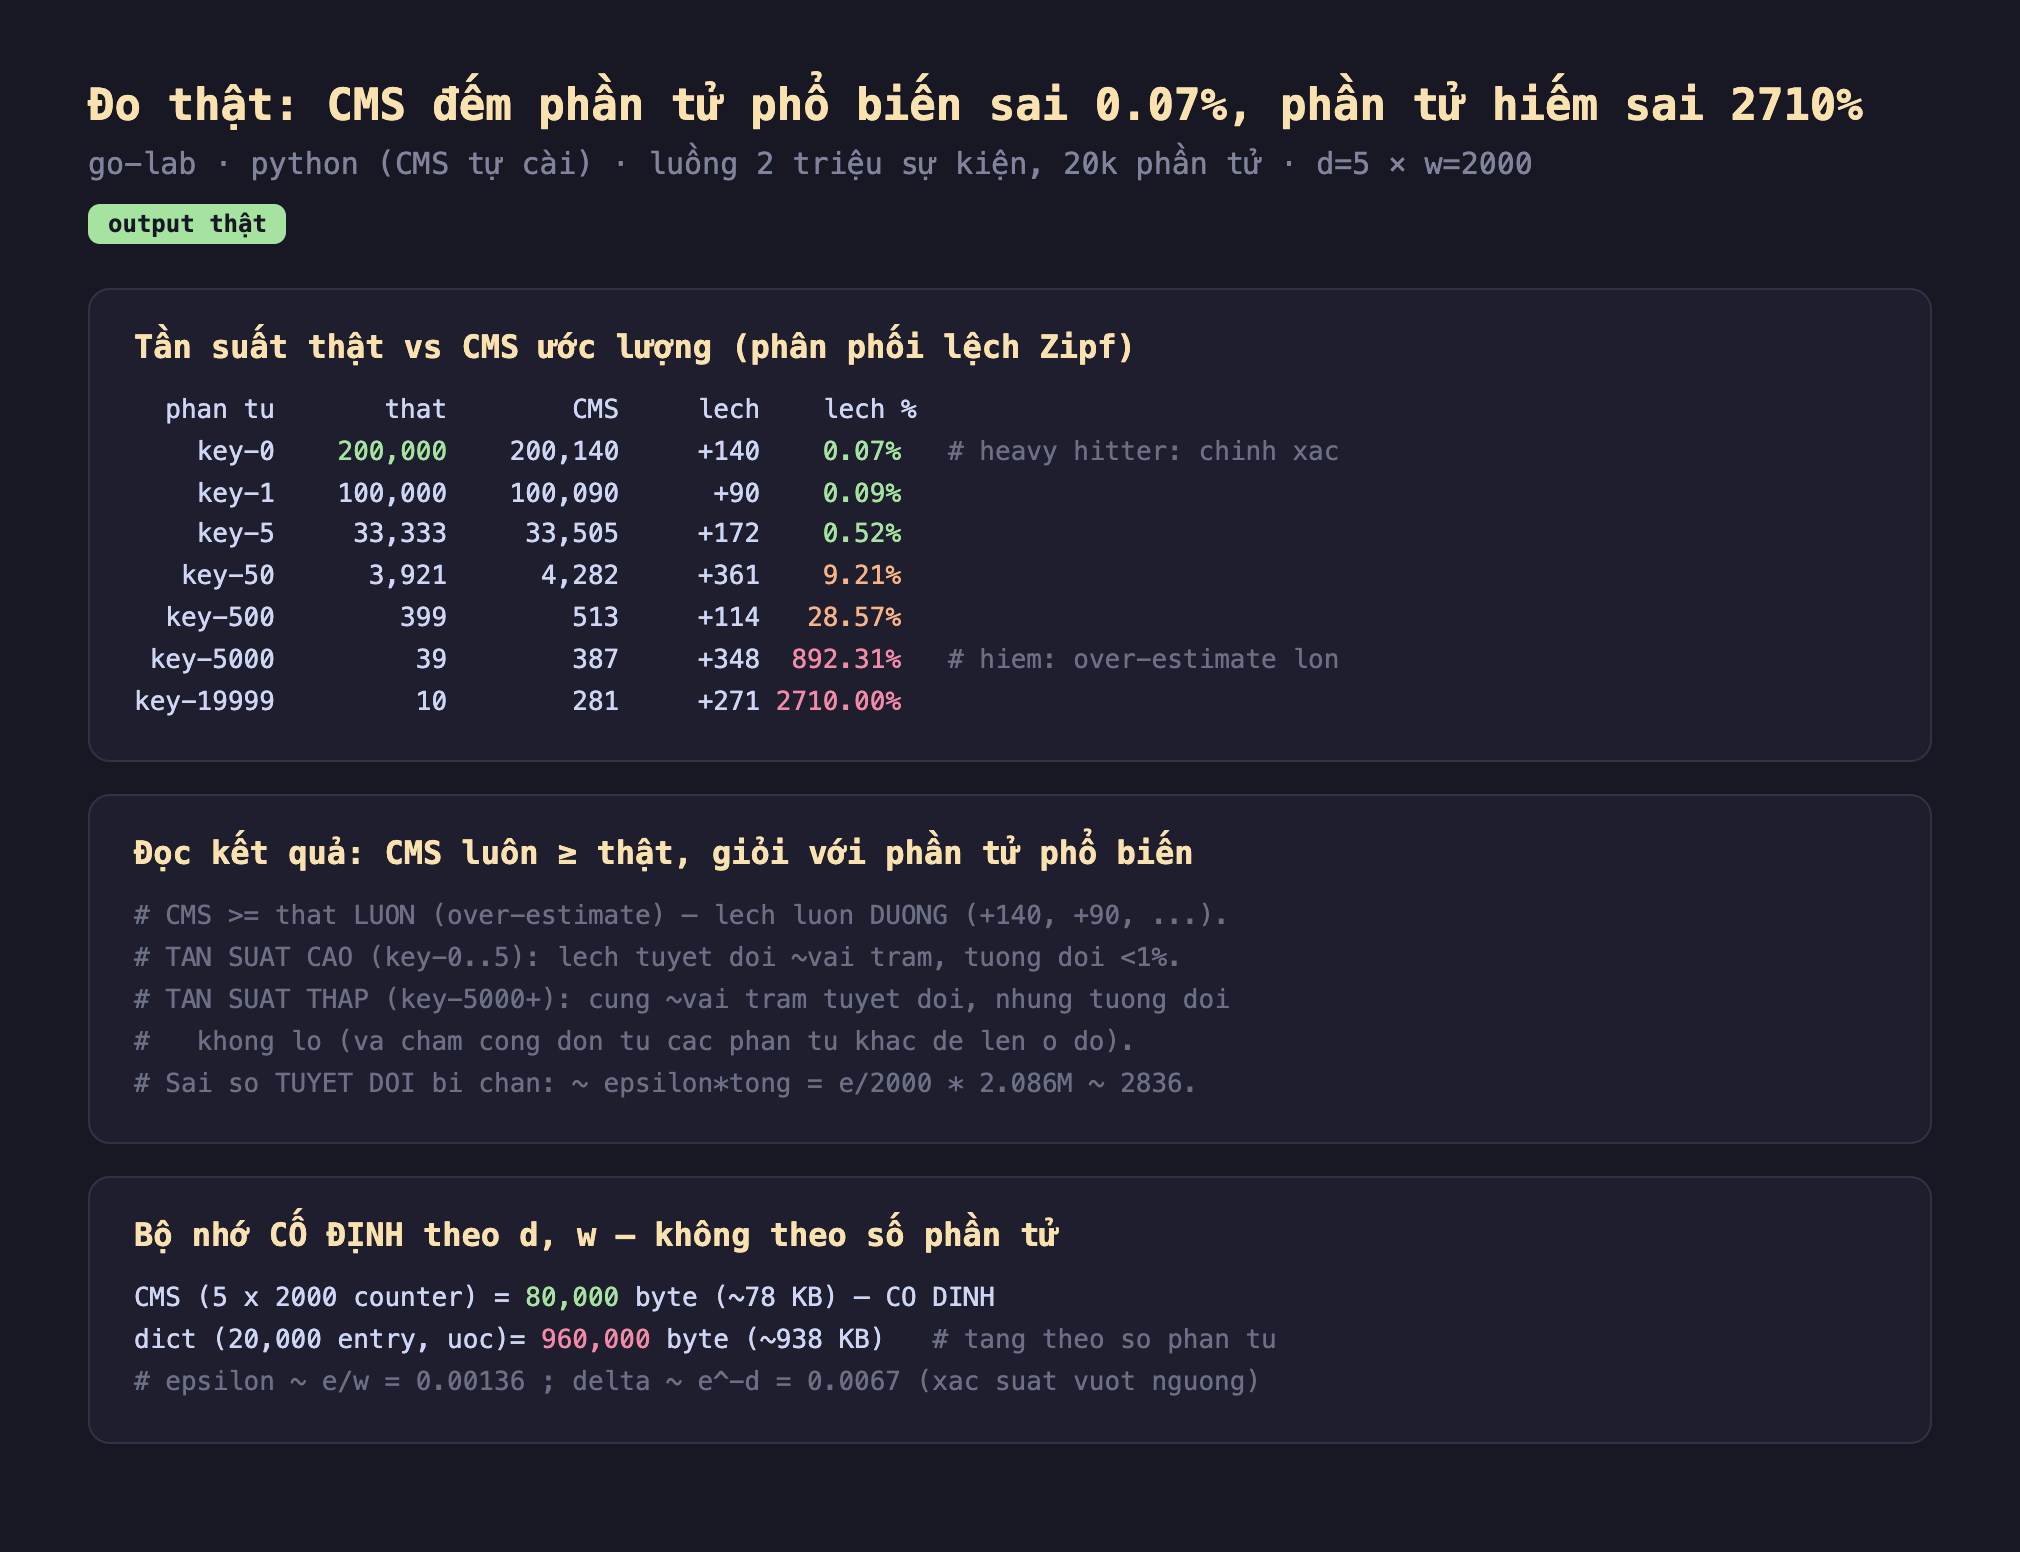
Hình 2: Chạy thật — 2 triệu sự kiện, 20k phần tử, CMS d=5×w=2000: key-0 (thật 200.000) CMS 200.140 lệch +140 (0.07%), key-50 (3921) lệch +361 (9.21%), key-5000 (39) lệch +348 (892%), key-19999 (10) lệch +271 (2710%); CMS luôn ≥ thật; bộ nhớ CMS 78KB (cố định) vs dict 938KB.
- CMS luôn ≥ thật — over-estimate một chiều: mọi phần tử đều lệch dương (+140, +90, +172...). Không bao giờ thiếu. Đây là sai số một chiều giống Bloom, và nó có ích: bạn biết con số thật không lớn hơn CMS trả về.
- Hoàn hảo với heavy hitters: phần tử tần suất cao (key-0 đến key-5) có sai số tương đối cực nhỏ — 0.07%, 0.09%, 0.52%. Vì tần suất thật của chúng lớn (hàng chục nghìn tới 200 nghìn), còn lượng over-estimate do va chạm chỉ vài trăm — không đáng kể so với con số lớn. Đây là lý do CMS là công cụ đếm phần tử nóng (phần 7).
- Tệ với đuôi dài (phần tử hiếm): phần tử tần suất thấp (key-5000 thật 39, key-19999 thật 10) bị over-estimate khổng lồ về tương đối — 892%, 2710%. Lý do: lượng over-estimate (va chạm cộng dồn từ tất cả phần tử khác đè lên ô đó) là cùng cỡ (~vài trăm) cho mọi phần tử, nhưng với phần tử thật chỉ 10-39 thì vài trăm đó là khổng lồ về tỉ lệ. CMS không dùng được để đếm chính xác phần tử hiếm.
- Sai số tuyệt đối bị chặn: điểm đẹp lý thuyết — lượng over-estimate bị chặn bởi
ε·Nvớiε ≈ e/wvà N là tổng sự kiện. Ở đâye/2000 × 2.086 triệu ≈ 2836, và mọi lượng lệch đo được (140, 90, 361, 271...) đều dưới ngưỡng này. Bạn tính trước được sai số tuyệt đối tối đa. - Bộ nhớ cố định: CMS 5×2000 = 78KB bất kể số phần tử khác nhau, trong khi dict 20 nghìn entry ngốn ~938KB (và tăng nếu nhiều phần tử hơn). Nếu luồng có 20 triệu phần tử khác nhau, CMS vẫn 78KB còn dict thành hàng GB.
Đánh đổi cần cân nhắc
Chỉnh w và d cho đúng mục tiêu: w kiểm sai số, d kiểm rủi ro. Sai số tuyệt đối ε ≈ e/w — muốn nhỏ hơn thì tăng w (nhiều cột hơn). Xác suất một phần tử bị lệch vượt ngưỡng là δ ≈ e^(-d) — muốn chắc chắn hơn thì tăng d (nhiều hàng hơn), nhưng d chỉ cần nhỏ (5-10) vì e^(-d) giảm rất nhanh. Bộ nhớ = d·w bộ đếm. Cho trước ε và δ mong muốn, tính w = ⌈e/ε⌉, d = ⌈ln(1/δ)⌉. Đây là cách thiết kế CMS chính xác.
CMS đếm được, nhưng không cho biết phần tử nào. Giống Bloom và HLL, CMS chỉ trả lời khi bạn hỏi về một phần tử cụ thể — nó không tự liệt kê các phần tử, không nói "phần tử nào nóng nhất". Để tìm heavy hitters (top-k), phải kết hợp CMS với một cấu trúc phụ (min-heap) theo dõi ứng viên — chủ đề của phần 7. CMS là bộ đếm, không phải bộ xếp hạng.
Trừ (giảm bộ đếm) làm hỏng tính chất — dùng biến thể khác nếu cần. CMS cơ bản chỉ cộng. Nếu bạn trừ (ví dụ đếm trong cửa sổ trượt, phần tử hết hạn), phép MIN không còn đảm bảo over-estimate — có thể sinh under-estimate. Cần đếm có trừ thì dùng Count-Sketch (dùng hash dấu ±1, ước lượng không thiên lệch nhưng hai chiều) hoặc CMS với conservative update. Chọn biến thể theo việc bạn có cần trừ không.
Ba ý mang về
- CMS đếm tần suất bằng ma trận cố định, lấy MIN: đo thật đếm 2 triệu sự kiện bằng 78KB (vs dict 938KB, và cố định bất kể số phần tử) — thêm tăng d ô, đếm lấy MIN của d ô; va chạm chỉ làm tăng nên CMS luôn ≥ thật (over-estimate một chiều).
- Hoàn hảo với phần tử nóng, tệ với đuôi dài: đo thật phần tử phổ biến (key-0) sai chỉ 0.07% nhưng phần tử hiếm (key-19999) bị over-estimate 2710% — vì lượng lệch tuyệt đối (~vài trăm) cùng cỡ cho mọi phần tử, khổng lồ về tỉ lệ với phần tử thật nhỏ; sai số tuyệt đối bị chặn ~ε·N.
- Thiết kế bằng ε và δ, biết giới hạn: tăng w giảm sai số (ε≈e/w), tăng d giảm rủi ro vượt ngưỡng (δ≈e^(-d)); CMS chỉ đếm khi hỏi một phần tử (cần min-heap để tìm top-k — phần 7); và trừ bộ đếm phá tính over-estimate (dùng Count-Sketch nếu cần trừ).
Nguồn
- Cormode & Muthukrishnan — An Improved Data Stream Summary: The Count-Min Sketch and its Applications (2005): http://dimacs.rutgers.edu/~graham/pubs/papers/cm-full.pdf
- Wikipedia — Count-Min sketch: https://en.wikipedia.org/wiki/Count%E2%80%93min_sketch
- Redis — Count-Min Sketch (CMS.)*: https://redis.io/docs/latest/develop/data-types/probabilistic/count-min-sketch/
Phần sau ta dùng CMS để giải một bài toán thực tế: tìm top-k phần tử nóng nhất trong luồng (heavy hitters) — kết hợp Count-Min Sketch với một min-heap, và đo thật độ chính xác của top-k tìm được.
