Phần 4 giới thiệu ý tưởng đẹp của HyperLogLog: rank lớn nhất báo hiệu cardinality, chia register để giảm phương sai. Nhưng giữa một ý tưởng đẹp và một thuật toán chạy được là một khoảng cách đầy chi tiết kỹ thuật — và chính những chi tiết đó phân biệt HLL của sách giáo khoa với HLL trong Redis hay BigQuery. Bài này (phần 5 loạt Xác suất) đào vào ba hiệu chỉnh quan trọng nhất, và đo thật để thấy vì sao thiếu chúng thì thuật toán sai thảm hại: tại sao phải dùng trung bình điều hòa, hằng số alpha làm gì, và cách xử lý thiên lệch ở cardinality nhỏ và lớn.
Vì sao trung bình điều hòa, không phải trung bình thường
Mỗi register giữ một rank, và 2^rank là "ước lượng thô" cho số phần tử mà register đó thấy. Để gộp m register, câu hỏi là: lấy trung bình kiểu gì? Trực giác đầu tiên là trung bình cộng (arithmetic mean). Nhưng đây là bẫy: register có rank cao (băm ra chuỗi nhiều số 0 dẫn đầu — hiếm) có 2^rank lớn gấp bội, và nó là một ngoại lai kéo lệch trung bình cộng lên cao. Một register may mắn thấy rank 20 (2^20 ≈ 1 triệu) sẽ áp đảo hàng nghìn register khác.
Trung bình điều hòa (harmonic mean) giải quyết điều này: nó bị chi phối bởi các giá trị nhỏ, nên giảm mạnh ảnh hưởng của ngoại lai lớn → phương sai thấp hơn, ước lượng ổn định hơn. Công thức HLL chính là harmonic mean cải trang:
E = alpha · m² / Σ 2^(-reg[i]) # = alpha · m · harmonic_mean(2^reg)
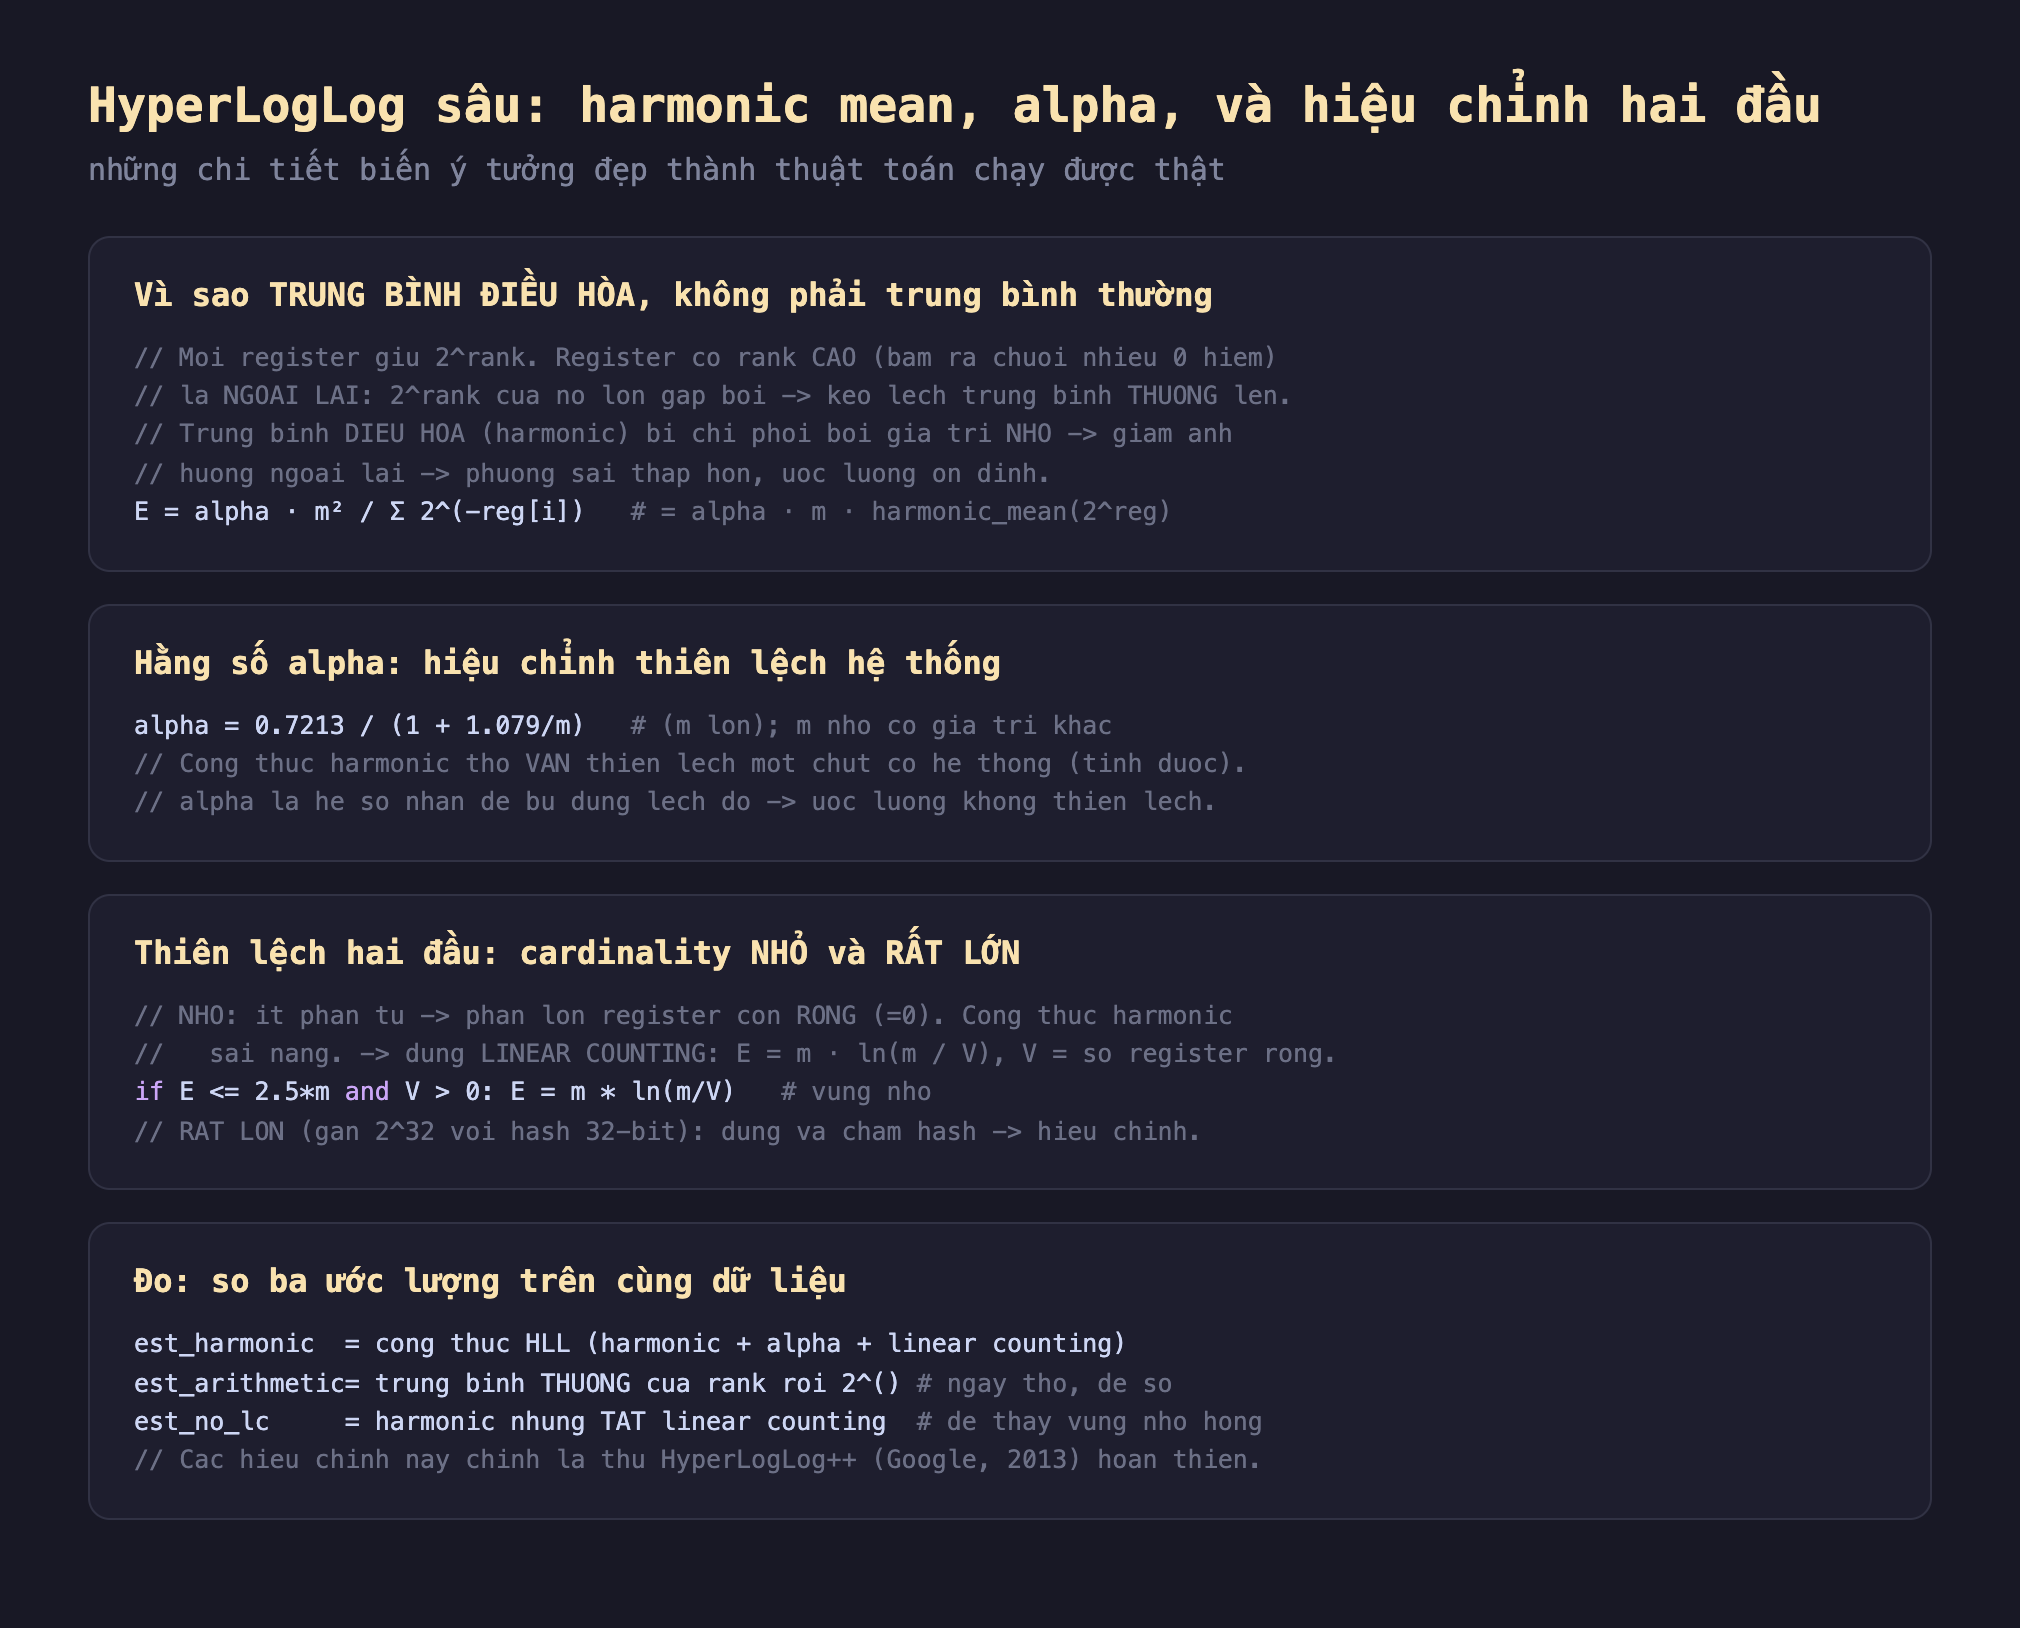
Hình 1: Ba hiệu chỉnh của HLL — trung bình điều hòa thay trung bình thường (giảm ảnh hưởng register rank cao ngoại lai); hằng số alpha = 0.7213/(1+1.079/m) bù thiên lệch hệ thống; và linear counting E = m·ln(m/V) cho cardinality nhỏ (V = số register rỗng) — chính là những gì HyperLogLog++ hoàn thiện.
Đo thật: thiếu hiệu chỉnh thì sai thảm hại
Mình tự cài HLL (m=2^12) và so các cách ước lượng trên cùng dữ liệu:
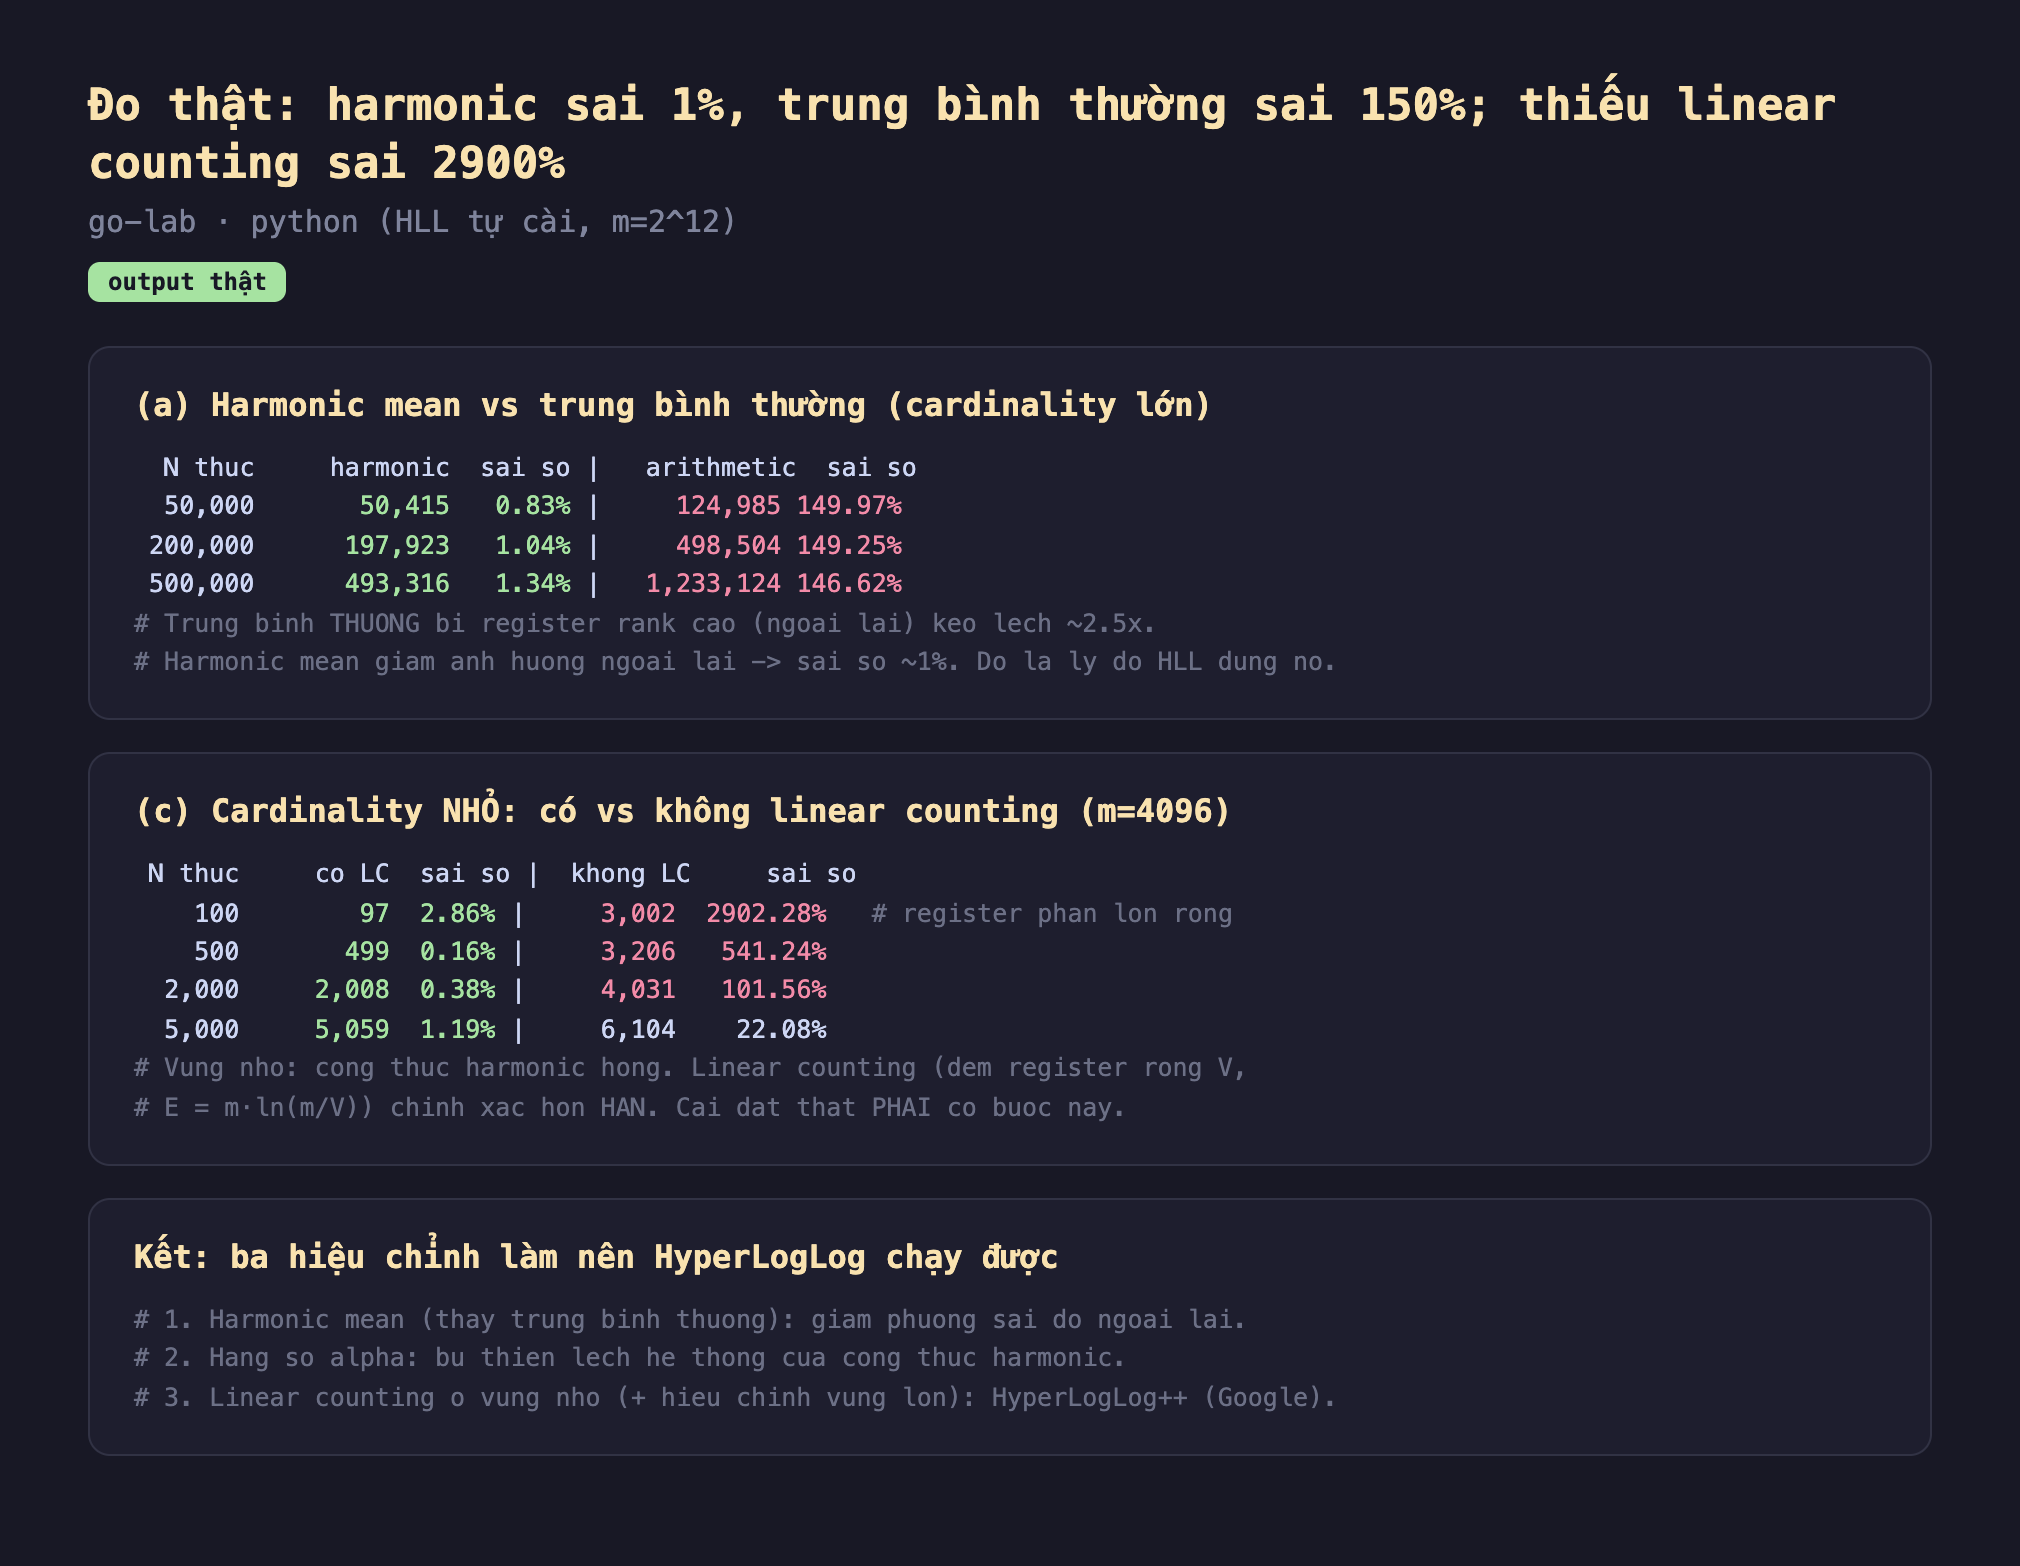
Hình 2: Chạy thật — (a) harmonic mean cho sai số 0.83-1.34% trong khi trung bình thường sai ~150% (ngoại lai kéo lệch ~2.5x); (c) cardinality nhỏ: có linear counting sai 0.16-2.86%, không có sai từ 22% tới 2902% (N=100).
- (a) Harmonic thắng trung bình thường một trời một vực: trên cardinality lớn (50k-500k), harmonic mean (công thức HLL) cho sai số 0.83-1.34%, còn một ước lượng ngây thơ dùng trung bình thường của rank sai ~150% — vượt ~2.5 lần ở mọi quy mô. Register rank cao là ngoại lai kéo trung bình cộng lên, và harmonic mean chính là liều thuốc. Đây không phải chi tiết nhỏ — nó là lý do trung tâm HLL hoạt động (LogLog cũ dùng geometric mean, HLL cải tiến bằng harmonic mean, giảm hằng số sai số).
- (c) Cardinality nhỏ: linear counting là bắt buộc: đây là hiệu chỉnh dễ bị bỏ quên nhất. Với ít phần tử (N=100 trên m=4096 register), phần lớn register còn rỗng, và công thức harmonic hỏng hoàn toàn: không có linear counting, N=100 bị ước lượng thành 3002 — sai 2902%! Nhưng dùng linear counting (
E = m·ln(m/V)với V = số register rỗng) cho 97 — sai chỉ 2.86%. Cải thiện cũng dramatic ở N=500 (541% → 0.16%) và N=2000 (101% → 0.38%). Mọi cài đặt HLL nghiêm túc phải chuyển sang linear counting ở vùng cardinality nhỏ.
Đánh đổi cần cân nhắc
Hằng số alpha nhỏ nhưng cần thiết — và khác nhau theo m. Công thức harmonic thô vẫn thiên lệch có hệ thống một chút (ước lượng lệch một hằng số), và alpha là hệ số nhân bù đúng lệch đó. Giá trị alpha = 0.7213/(1+1.079/m) cho m lớn, nhưng m nhỏ (16, 32, 64) có các hằng số riêng được tính trong bài báo gốc. Bỏ qua alpha làm ước lượng lệch ~2-3% có hệ thống — không thảm họa như hai lỗi trên, nhưng đủ để làm sai số vượt mức lý thuyết. Đừng tự chế hằng số; dùng đúng giá trị của paper.
Vùng chuyển tiếp giữa linear counting và HLL cần xử lý mượt. Cài đặt đơn giản (như demo) chuyển đột ngột từ linear counting sang harmonic ở ngưỡng E ≤ 2.5m. Nhưng ở đúng vùng chuyển tiếp, cả hai công thức đều kém chính xác, tạo một "vết lồi" sai số. HyperLogLog++ (Google, 2013) giải quyết bằng bias correction dựa trên dữ liệu thực nghiệm (bảng tra cứu độ lệch đo được) thay vì công thức cứng — cho đường cong sai số mượt trên toàn dải. Nếu dùng thư viện, chọn cái cài HLL++ chứ không phải HLL gốc.
Hash phải đủ rộng và tốt — 64 bit là chuẩn hiện nay. HLL gốc dùng hash 32 bit, nên với cardinality rất lớn (gần 2^32 ≈ 4 tỉ) xảy ra đụng độ hash (hai phần tử khác nhau băm trùng), làm ước lượng lệch xuống — cần hiệu chỉnh vùng lớn. HLL++ chuyển sang hash 64 bit, đẩy ngưỡng đụng độ lên 2^64 (thực tế không bao giờ chạm), loại bỏ nhu cầu hiệu chỉnh vùng lớn. Dùng hash 64 bit chất lượng (như xxHash, MurmurHash3) là điều kiện tiên quyết cho HLL chính xác ở quy mô lớn.
Ba ý mang về
- Trung bình điều hòa là trái tim của HLL: đo thật harmonic mean cho sai số ~1% trong khi trung bình thường sai ~150% — vì register rank cao là ngoại lai kéo lệch trung bình cộng, và harmonic mean giảm ảnh hưởng ngoại lai; đây là cải tiến chính của HLL so với LogLog cũ.
- Linear counting cứu vùng cardinality nhỏ: đo thật không có linear counting, N=100 bị ước lượng 3002 (sai 2902%); có linear counting (
m·ln(m/V)) cho 97 (sai 2.86%) — mọi cài đặt nghiêm túc phải chuyển sang linear counting khi nhiều register còn rỗng. - Hằng số alpha, hash 64 bit, và bias correction làm nên HLL++: alpha bù thiên lệch hệ thống của công thức harmonic; hash 64 bit loại đụng độ ở cardinality lớn; và HyperLogLog++ (Google) thêm bias correction thực nghiệm cho đường cong sai số mượt — dùng thư viện cài HLL++ chứ không phải HLL gốc.
Nguồn
- Flajolet et al. — HyperLogLog (harmonic mean, alpha): https://algo.inria.fr/flajolet/Publications/FlFuGaMe07.pdf
- Heule, Nunkesser, Hall (Google) — HyperLogLog in Practice: Algorithmic Engineering of a State of The Art Cardinality Estimation Algorithm (HLL++, 2013): https://research.google/pubs/pub40671/
- Wikipedia — HyperLogLog: Practical considerations: https://en.wikipedia.org/wiki/HyperLogLog#Practical_considerations
Phần sau ta chuyển sang bài toán thứ ba: không phải "có trong tập không" hay "bao nhiêu phần tử khác nhau", mà "phần tử này xuất hiện bao nhiêu lần" trong một luồng — Count-Min Sketch đếm tần suất bằng bộ nhớ nhỏ, và ta đo thật mức ước lượng vượt của nó.
