Bloom filter (phần 1-3) trả lời "x có trong tập không". Giờ ta chuyển sang một câu hỏi khác hẳn, cũng tốn RAM không kém: "có bao nhiêu phần tử khác nhau?" — đếm cardinality. "Bao nhiêu user duy nhất truy cập hôm nay?", "bao nhiêu IP khác nhau?", "bao nhiêu từ khóa tìm kiếm duy nhất?". Cách hiển nhiên là nhét vào một set rồi lấy len(), nhưng set lớn tỉ lệ số phần tử — một triệu user ngốn hàng chục MB, và nếu bạn theo dõi hàng trăm chỉ số mỗi ngày thì hết RAM. HyperLogLog (HLL) làm điều tưởng như bất khả: đếm số phần tử phân biệt bằng một lượng bộ nhớ cố định — chỉ 16KB — bất kể tập có 10 nghìn hay 1 tỉ phần tử, với sai số ~1%. Bài này (phần 4 loạt Xác suất) tự cài HLL và đo thật cái "phép màu" đó.
Trực giác: số 0 dẫn đầu hiếm báo hiệu tập lớn
Ý tưởng nền của HLL đẹp một cách bất ngờ. Băm mỗi phần tử ra một chuỗi bit ngẫu nhiên. Một chuỗi bit ngẫu nhiên bắt đầu bằng đúng k số 0 liên tiếp có xác suất 1/2^(k+1) — càng nhiều số 0 dẫn đầu càng hiếm. Vậy nếu trong tập bạn từng thấy một phần tử băm ra 0000001... (6 số 0 dẫn đầu), khả năng bạn đã thấy khoảng 2^6 = 64 phần tử khác nhau (vì trung bình phải thử ~64 lần mới gặp một chuỗi hiếm cỡ đó).
Nói cách khác: rank lớn nhất (số 0 dẫn đầu nhiều nhất từng thấy) là một ước lượng cho log của số phần tử phân biệt. Chỉ cần nhớ một con số — rank lớn nhất — là ước lượng được cardinality! Nhưng một con số thì phương sai cao (may rủi), nên HLL chia nhỏ để lấy trung bình.
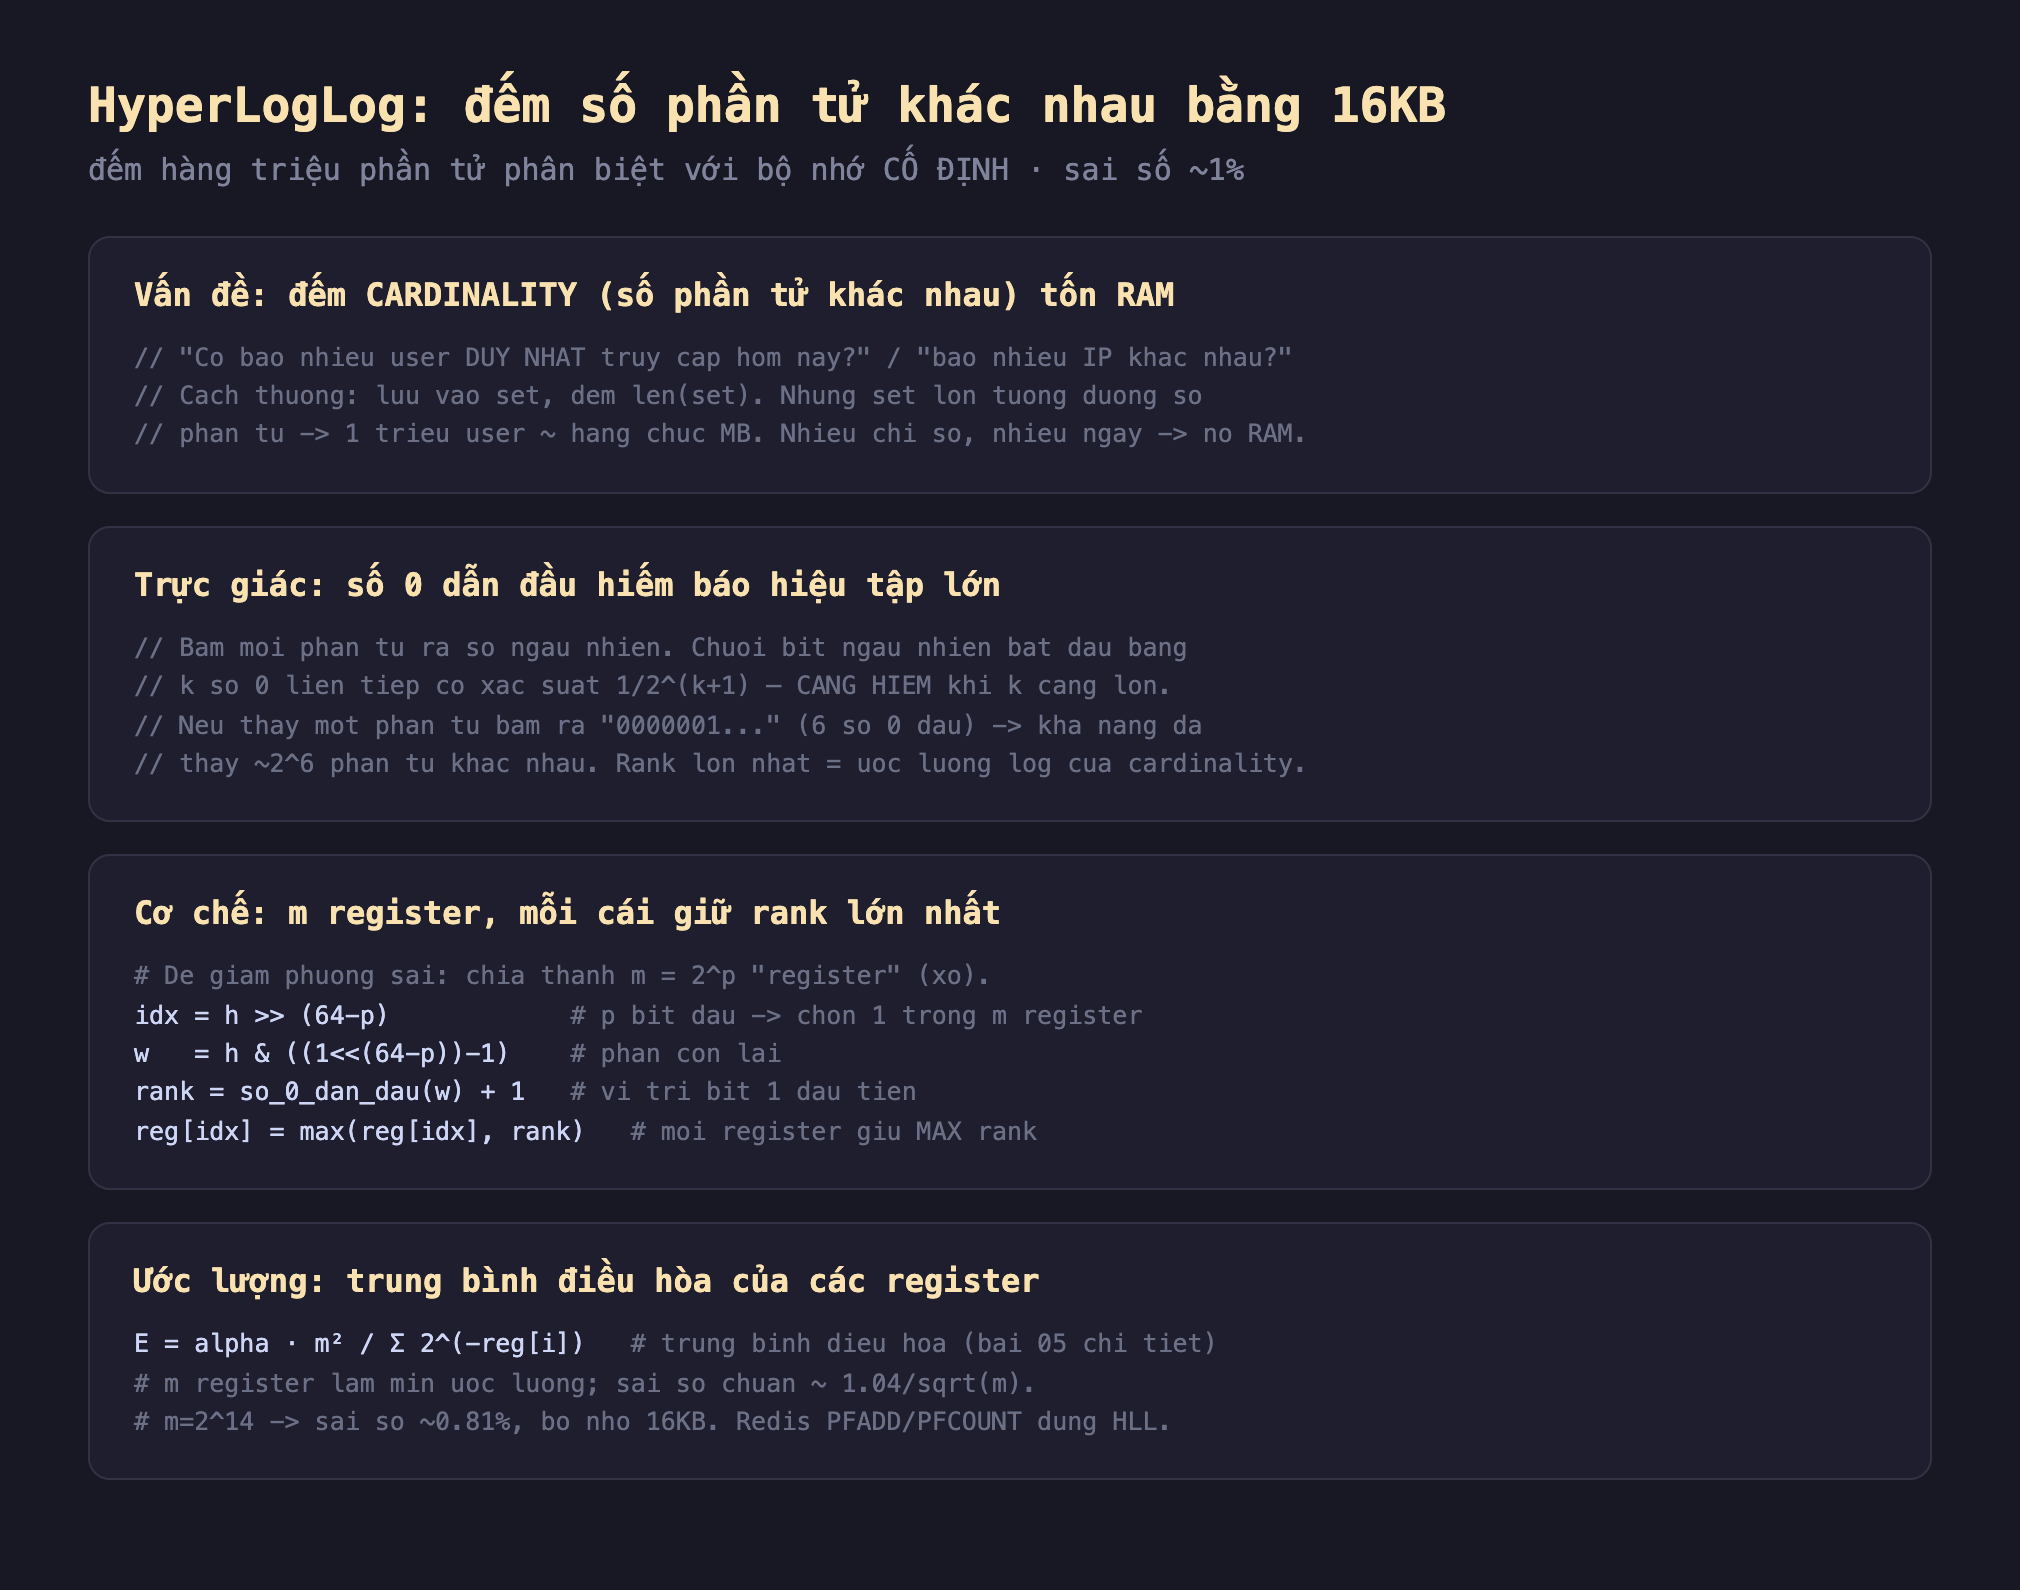
Hình 1: HLL băm mỗi phần tử; số 0 dẫn đầu hiếm báo hiệu tập lớn (rank lớn nhất ≈ log của cardinality); chia thành m register (dùng p bit đầu chọn register, phần còn lại tính rank), mỗi register giữ MAX rank; ước lượng bằng trung bình điều hòa alpha·m²/Σ2^(-reg), sai số chuẩn ~1.04/√m.
Cơ chế: m register để giảm phương sai
Một con số rank thì may rủi, nên HLL chia không gian băm thành m = 2^p register ("xô"): dùng p bit đầu của hash chọn một register, phần còn lại tính rank, và mỗi register giữ rank lớn nhất từng thấy. Cuối cùng gộp m register bằng trung bình điều hòa (phần 5 sẽ giải thích vì sao harmonic mean, không phải trung bình thường):
idx = h >> (64-p)            # p bit đầu -> chọn 1 trong m register
w   = h & ((1<<(64-p))-1)    # phần còn lại
rank = số_0_dẫn_đầu(w) + 1   # vị trí bit 1 đầu tiên
reg[idx] = max(reg[idx], rank)
# ước lượng: E = alpha · m² / Σ 2^(-reg[i])
Chia thành m register làm phương sai giảm theo √m, nên sai số chuẩn ≈ 1.04/√m. Nhiều register hơn = sai số nhỏ hơn = bộ nhớ nhiều hơn (m byte).
Đo thật: sai số 1%, bộ nhớ cố định
Mình tự cài HLL với m=2^14 register, đếm ba tập kích thước khác nhau và so với số thật (lưu bằng set để kiểm chứng):
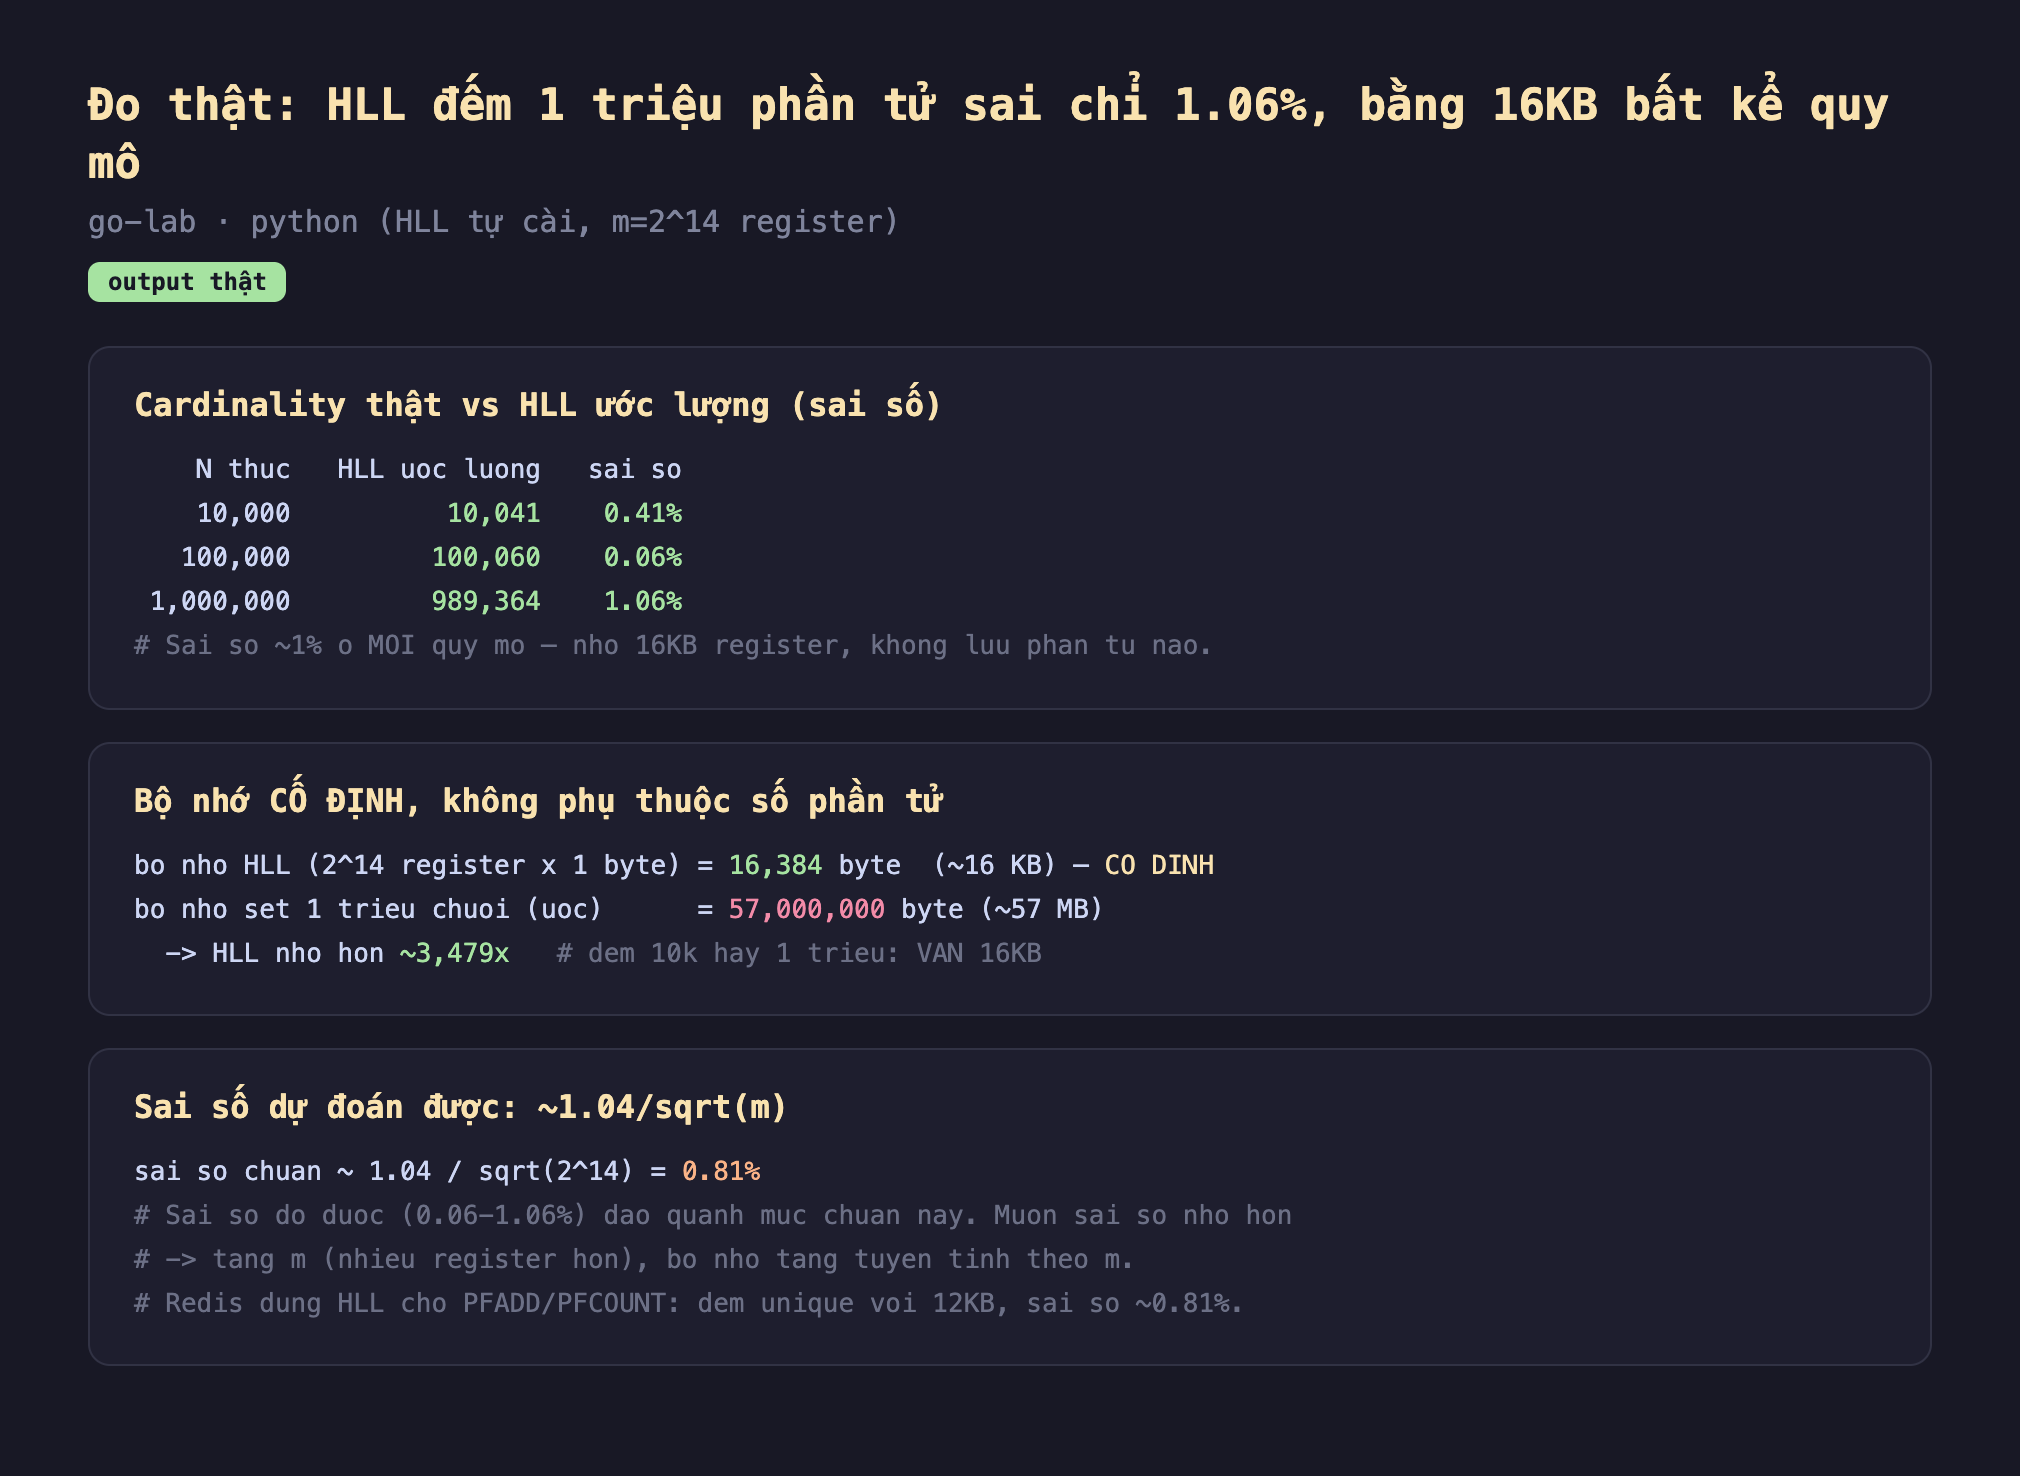
Hình 2: Chạy thật — HLL (m=2^14) đếm: N=10.000 → 10.041 (sai số 0.41%), N=100.000 → 100.060 (0.06%), N=1.000.000 → 989.364 (1.06%); bộ nhớ HLL cố định 16.384 byte (~16KB) vs set ~57MB (nhỏ hơn ~3479x); sai số chuẩn lý thuyết ~1.04/√(2^14) = 0.81%.
- Sai số ~1% ở mọi quy mô: đếm 10 nghìn sai 0.41%, 100 nghìn sai 0.06%, một triệu sai 1.06%. Tất cả nằm quanh mức sai số chuẩn lý thuyết 0.81%. HLL không lưu một phần tử nào — nó chỉ giữ 16 nghìn con số rank — mà ước lượng được số phần tử phân biệt với độ chính xác đủ cho phần lớn nhu cầu phân tích.
- Bộ nhớ CỐ ĐỊNH — đây là phép màu thật sự: HLL luôn dùng 16KB (2^14 register × 1 byte), bất kể bạn đếm 10 nghìn hay một triệu hay một tỉ phần tử. Trong khi set một triệu chuỗi ngốn ~57MB — HLL nhỏ hơn ~3479 lần. Và quan trọng hơn con số cụ thể: với set, bộ nhớ tăng theo dữ liệu; với HLL, bộ nhớ phẳng. Đây là điều khiến HLL vô giá cho hệ thống quy mô lớn.
- Sai số dự đoán được và điều chỉnh được: sai số chuẩn ≈ 1.04/√m. Muốn chính xác hơn, tăng m (nhiều register hơn) — bộ nhớ tăng tuyến tính. Đây là lý do Redis dùng HLL cho lệnh
PFADD/PFCOUNT: đếm số phần tử duy nhất với ~12KB mỗi bộ đếm, sai số ~0.81% — bạn theo dõi hàng nghìn chỉ số "unique count" mà không lo RAM.
Đánh đổi cần cân nhắc
HLL chỉ đếm cardinality — không cho biết những phần tử nào. Giống Bloom không liệt kê được, HLL không nói cho bạn user nào đã truy cập, chỉ bao nhiêu user khác nhau. Không lấy lại được danh sách, không kiểm tra thành viên (đó là việc của Bloom). HLL làm đúng một việc: ước lượng số phần tử phân biệt. Cần biết là những ai thì phải lưu thật (hoặc dùng HLL kèm sampling).
Sai số là tương đối, không tuyệt đối — và tệ hơn ở cardinality rất nhỏ. Sai số ~1% nghĩa là đếm 1 triệu có thể lệch ~10 nghìn — chấp nhận được. Nhưng với cardinality rất nhỏ (vài chục), ước lượng thô của HLL kém chính xác, nên các cài đặt thực (kể cả demo trên) dùng linear counting cho vùng nhỏ và chuyển sang công thức HLL cho vùng lớn. Nếu bạn cần đếm chính xác các tập nhỏ, HLL không phải công cụ đúng — dùng set.
Gộp được (mergeable) là siêu năng lực ít được nhắc. Hai HLL (cùng m) gộp được bằng cách lấy max từng register — cho HLL của hợp hai tập, mà không cần dữ liệu gốc. Nghĩa là bạn tính "user duy nhất tháng này" bằng cách gộp 30 HLL "user duy nhất mỗi ngày", hay gộp HLL từ nhiều máy chủ. Đây là tính chất khiến HLL cực mạnh trong hệ phân tán và phân tích theo khoảng thời gian — điều set thường không làm hiệu quả được.
Ba ý mang về
- HLL đếm cardinality bằng bộ nhớ cố định: đo thật đếm 1 triệu phần tử phân biệt sai chỉ 1.06% bằng 16KB — nhỏ hơn set ~3479 lần, và bộ nhớ phẳng bất kể 10 nghìn hay một tỉ phần tử; dựa trên trực giác "số 0 dẫn đầu hiếm báo hiệu tập lớn".
- Sai số dự đoán và điều chỉnh được: đo thật sai số dao quanh mức chuẩn ~1.04/√m = 0.81% (m=2^14); tăng m để chính xác hơn, đổi bộ nhớ tuyến tính — đây là HLL đằng sau Redis
PFADD/PFCOUNT. - Biết giới hạn và sức mạnh: HLL chỉ đếm bao nhiêu, không cho biết là ai (khác Bloom); kém chính xác ở cardinality nhỏ (dùng linear counting bù); nhưng gộp được — siêu năng lực cho phân tích phân tán và theo khoảng thời gian.
Nguồn
- Flajolet et al. — HyperLogLog: the analysis of a near-optimal cardinality estimation algorithm (2007): https://algo.inria.fr/flajolet/Publications/FlFuGaMe07.pdf
- Redis — PFADD / PFCOUNT (HyperLogLog): https://redis.io/docs/latest/develop/data-types/probabilistic/hyperloglogs/
- Wikipedia — HyperLogLog: https://en.wikipedia.org/wiki/HyperLogLog
Phần sau ta đào sâu vào HLL: vì sao dùng trung bình điều hòa chứ không phải trung bình thường, hằng số hiệu chỉnh alpha, và cách sửa thiên lệch ở hai đầu — những chi tiết biến ý tưởng đẹp thành thuật toán chạy được thật.
