Hai phần trước cho thấy Bloom filter mạnh mẽ, nhưng có một giới hạn cứng: không xóa được. Muốn xóa một phần tử, bạn tắt các bit của nó — nhưng các bit đó có thể đang được phần tử khác dùng chung, và tắt đi sẽ làm phần tử khác biến mất oan (báo sót). Với nhiều ứng dụng thực tế — cache có entry hết hạn, danh sách thành viên thay đổi liên tục — không xóa được là một hạn chế lớn. Counting Bloom filter vá điều này bằng một ý tưởng đơn giản: thay mỗi bit bằng một bộ đếm nhỏ, để "tắt" trở thành "giảm". Nhưng như mọi thứ trong loạt này, khả năng mới đến kèm cái giá. Bài này (phần 3 loạt Xác suất) tự cài Counting Bloom và đo thật khả năng xóa cùng ba cái giá của nó.
Cơ chế: bit thành bộ đếm
Thay mảng bit bằng mảng bộ đếm nhỏ (thường 4 bit mỗi ô, đếm được 0-15):
- Thêm x: tăng k bộ đếm ở
hash_1(x)..hash_k(x)(thay vì bật bit). - Xóa x: giảm k bộ đếm đó.
- Kiểm x: mọi k bộ đếm
> 0→ "có thể có"; một cái= 0→ "chắc chắn không".
Chìa khóa nằm ở "dùng chung": khi một ô được nhiều phần tử dùng, bộ đếm của nó > 1. Xóa một phần tử chỉ giảm bộ đếm một đơn vị — nó vẫn > 0 nếu phần tử khác còn dùng ô đó. Nhờ vậy xóa một phần tử không phá các phần tử khác. Đây chính là điều Bloom bit-thường không làm được.
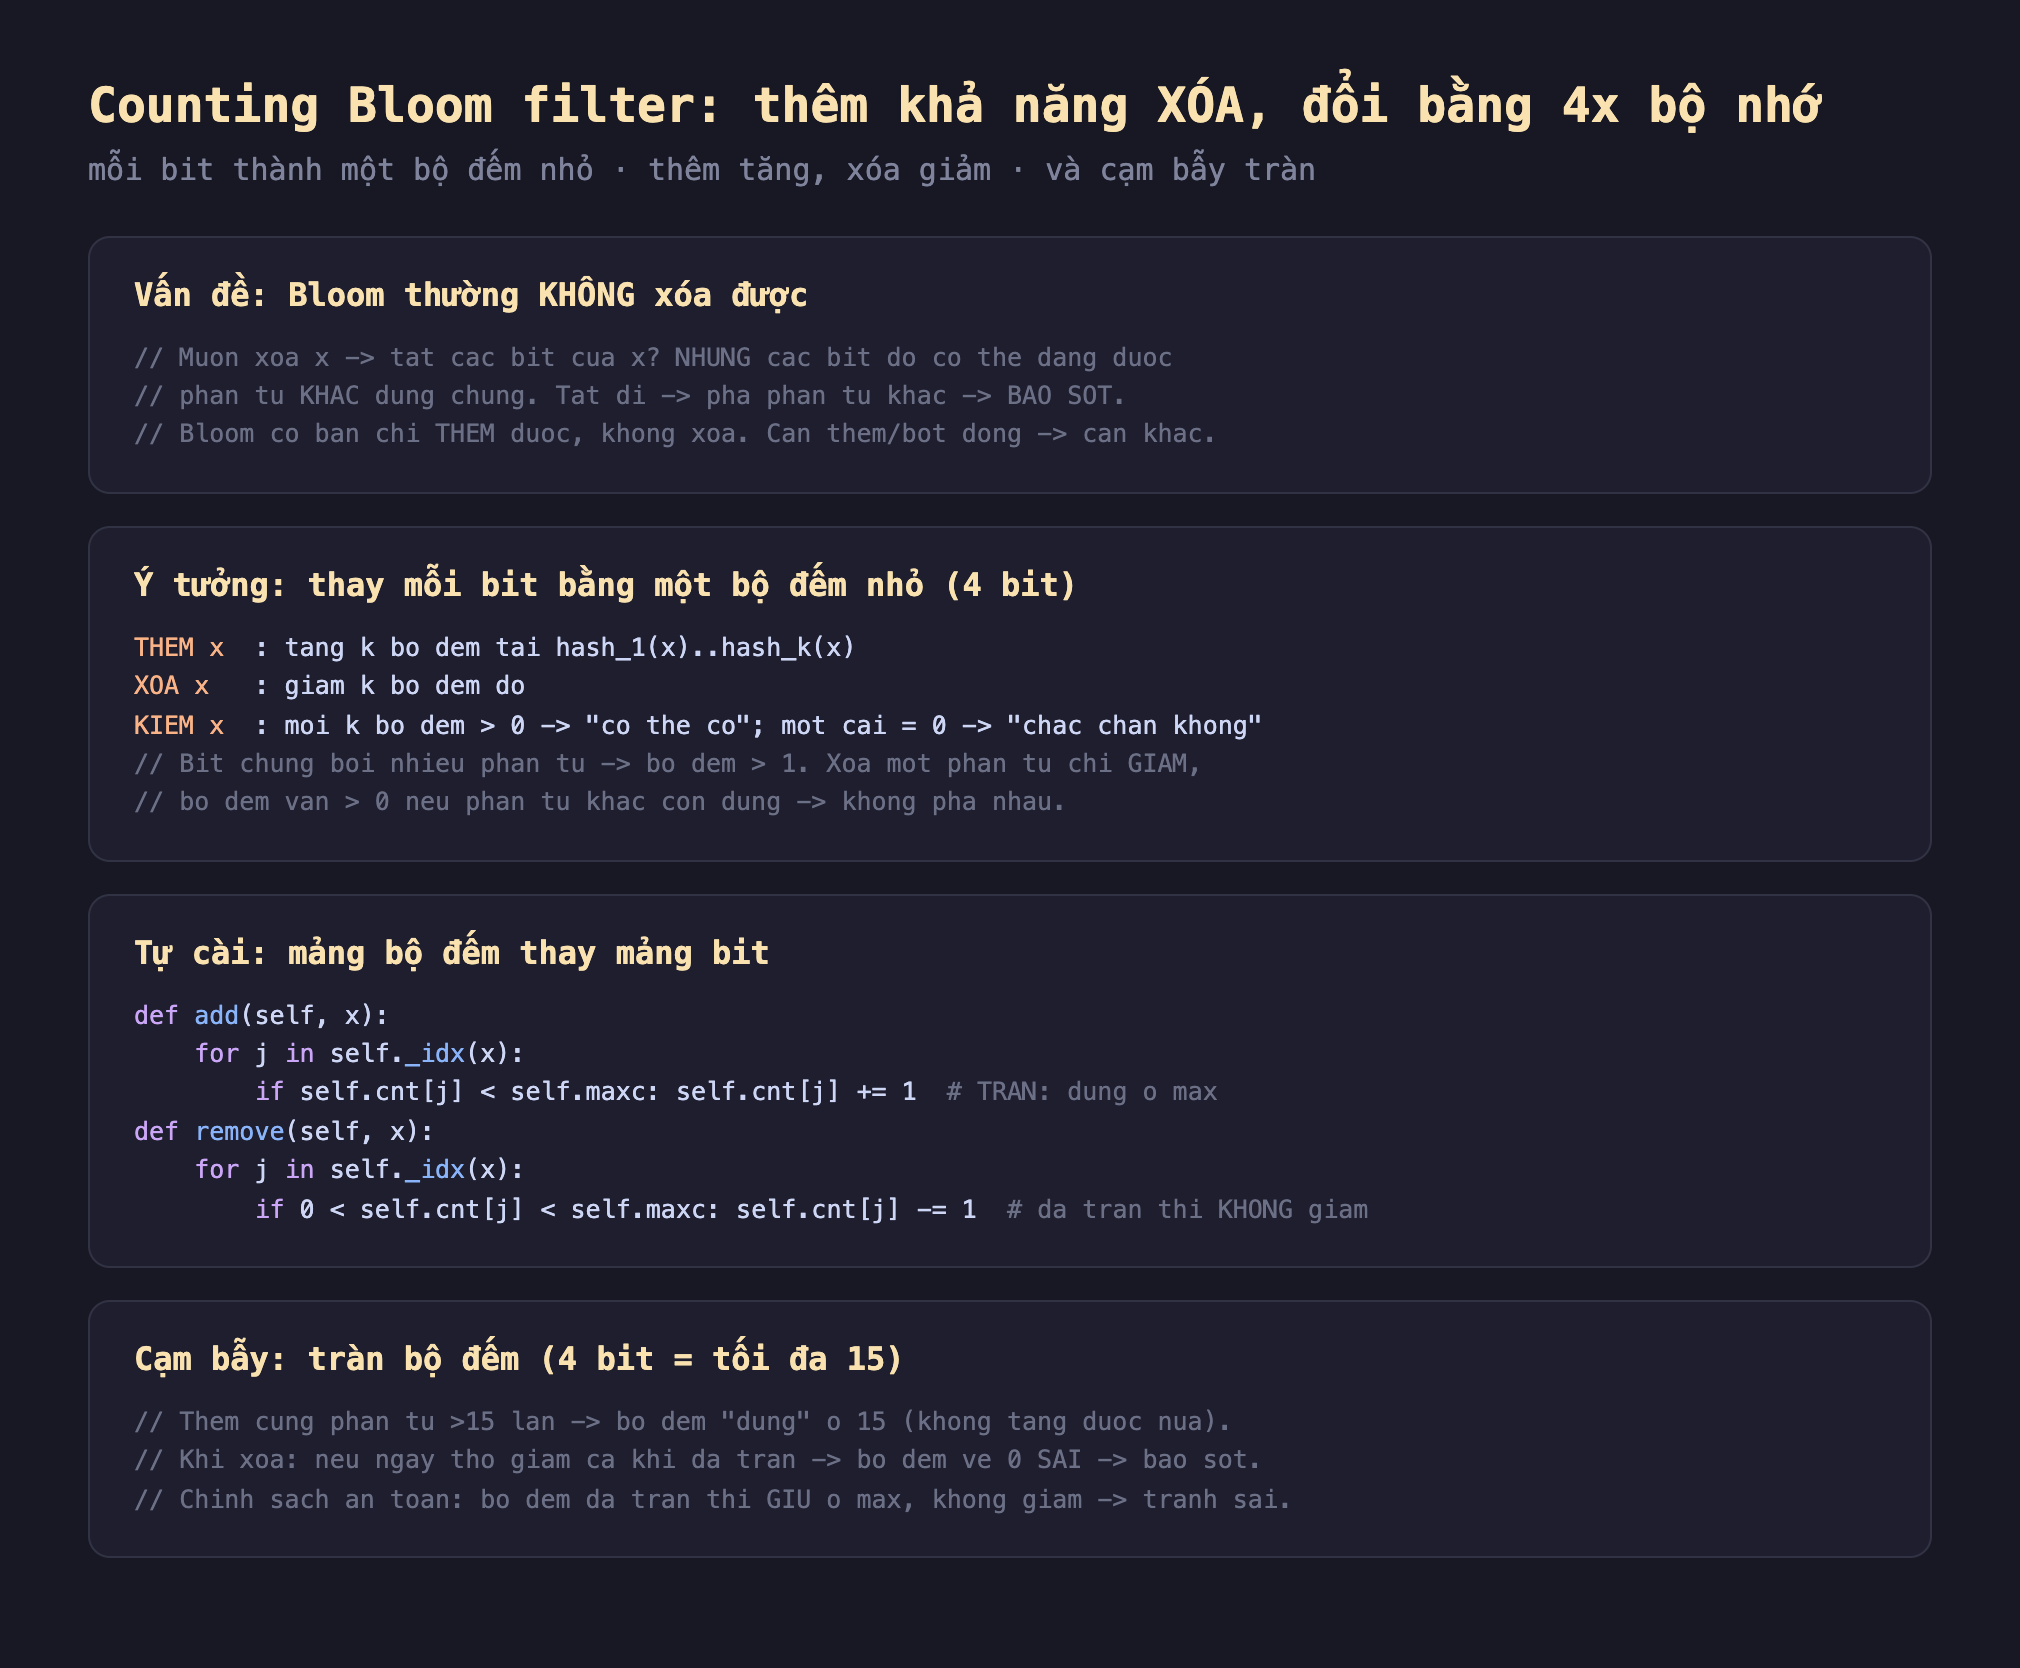
Hình 1: Counting Bloom thay mỗi bit bằng một bộ đếm nhỏ (4 bit) — thêm là tăng, xóa là giảm, kiểm là mọi bộ đếm > 0; ô dùng chung có bộ đếm > 1 nên xóa một phần tử chỉ giảm mà không phá phần tử khác; cạm bẫy là tràn bộ đếm (max 15).
Đo thật: xóa được, nhưng ba cái giá
Mình tự cài Counting Bloom (mảng bộ đếm) và chạy ba thí nghiệm:
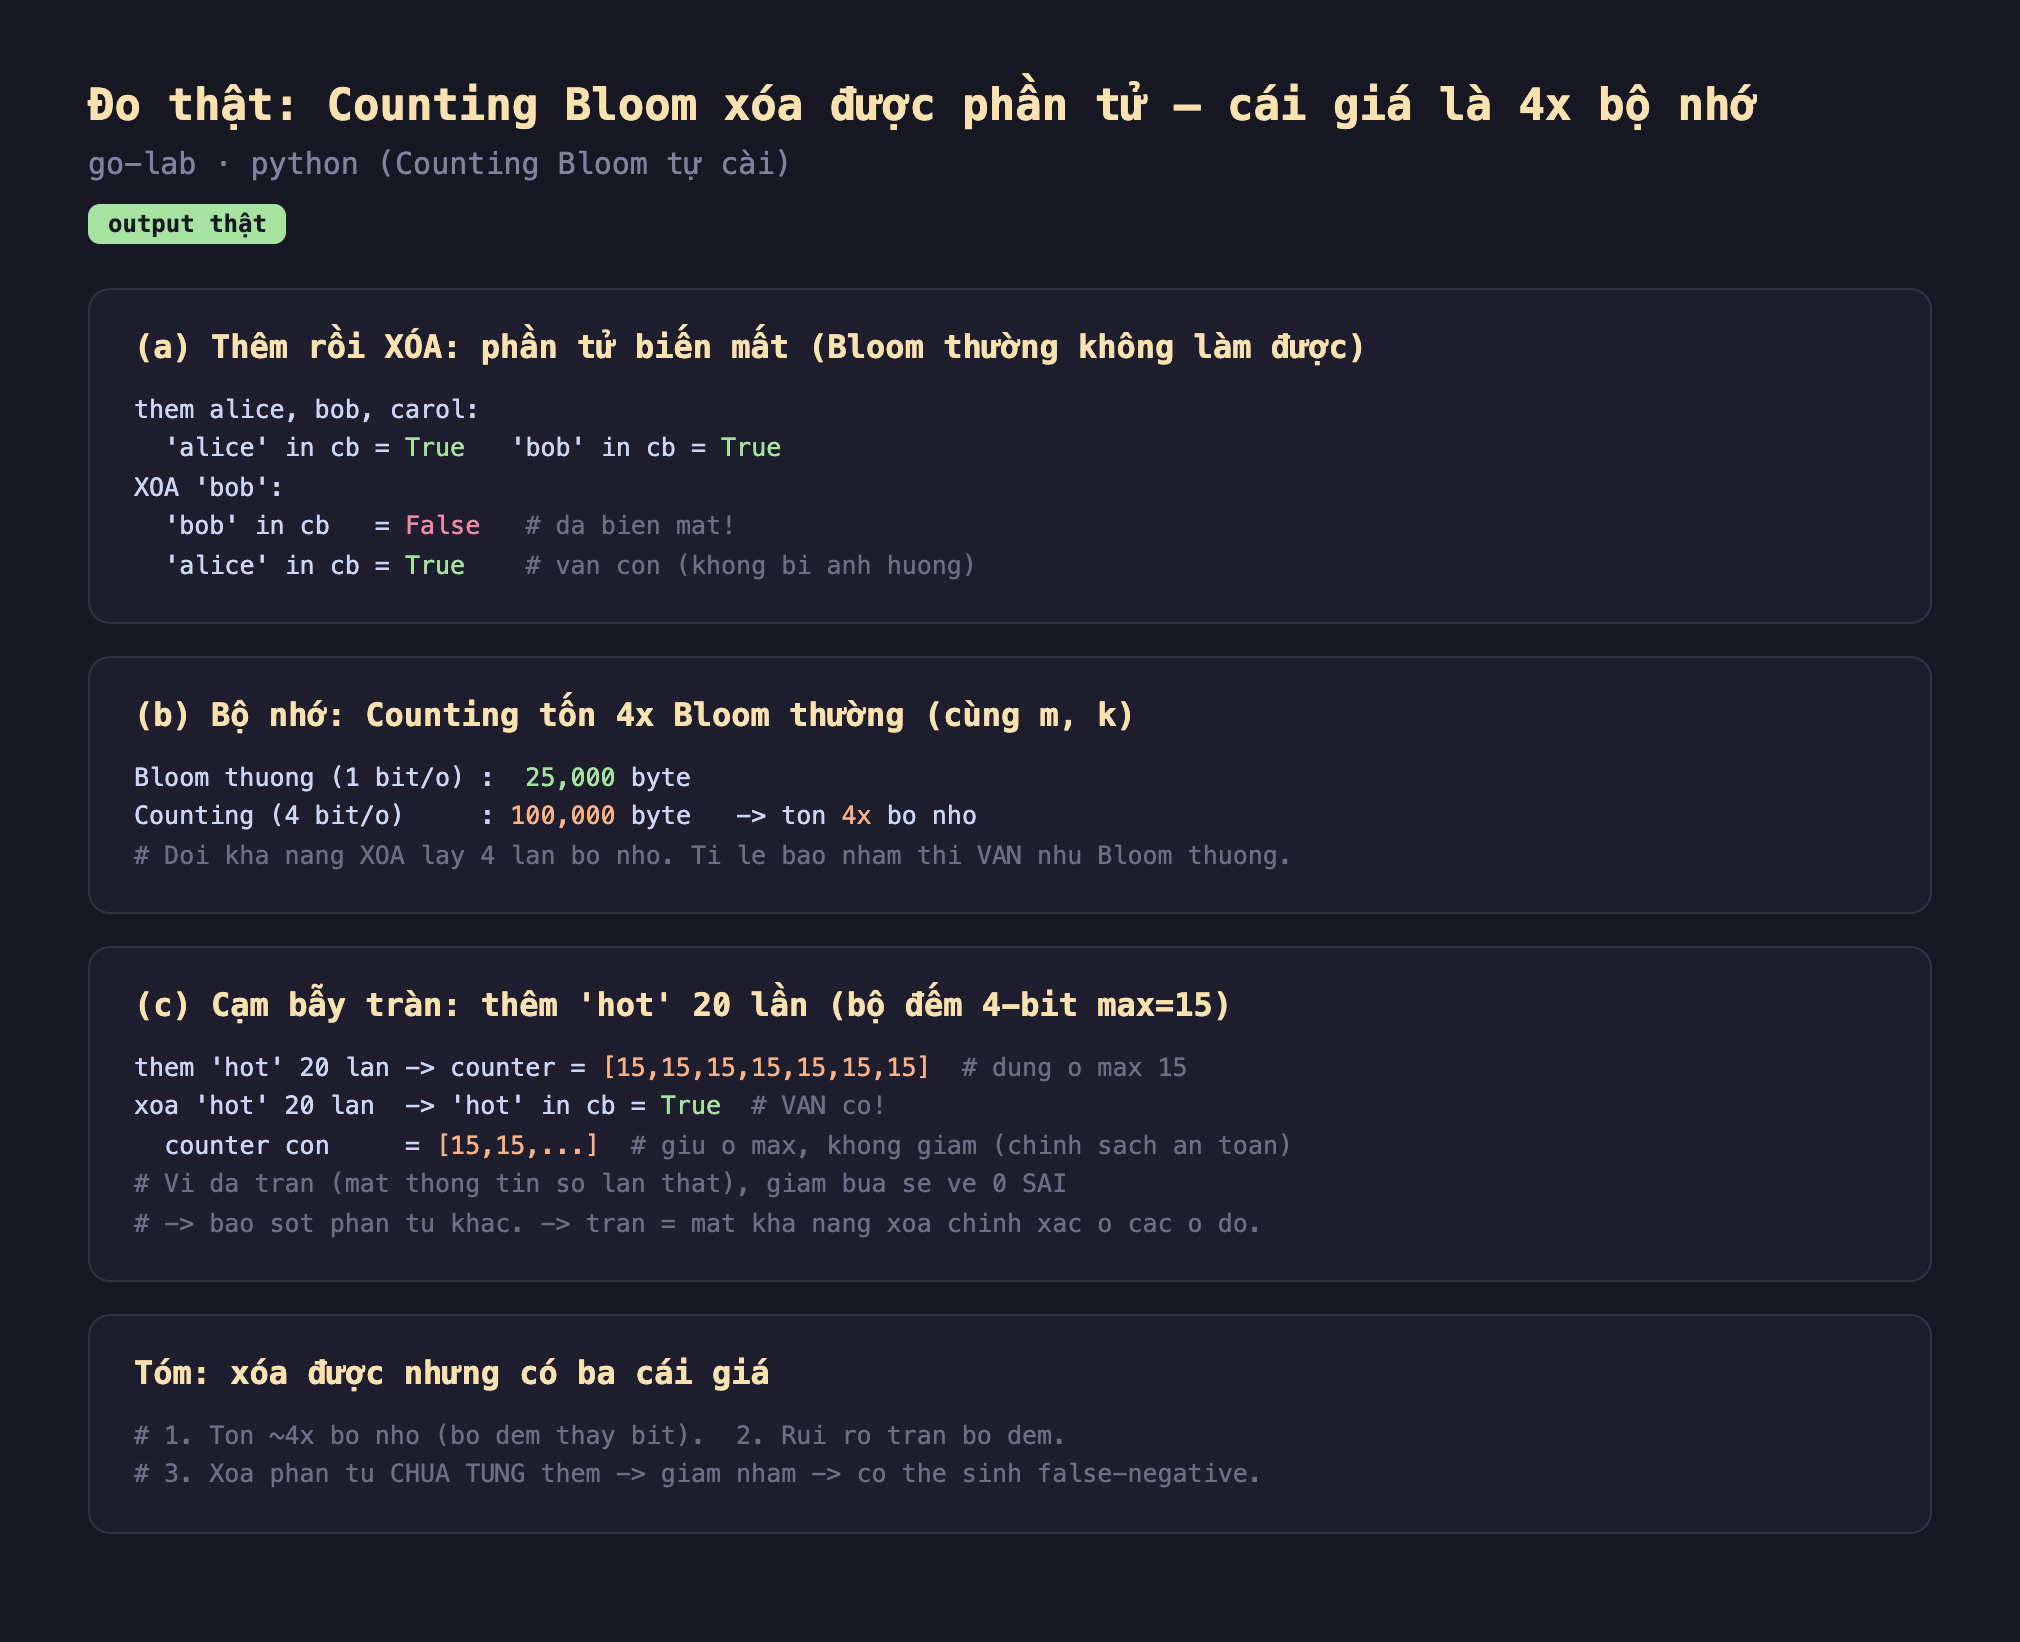
Hình 2: Chạy thật — (a) xóa 'bob' làm 'bob' in cb = False (biến mất) trong khi 'alice' in cb = True (không ảnh hưởng); (b) Counting 100.000 byte vs Bloom thường 25.000 byte (tốn 4x); (c) thêm 'hot' 20 lần làm bộ đếm bão hòa ở [15,15,...], xóa 20 lần vẫn cho 'hot' in cb = True vì bộ đếm giữ ở max (chính sách an toàn).
- (a) Xóa được — điều Bloom thường không làm: thêm
alice,bob,carol, cả ba đều "có". Xóabob→bobgiờ trả False (biến mất), trong khialicevẫn True (không hề bị ảnh hưởng). Đây chính là khả năng mà bit-thường không có: xóa một phần tử mà không phá phần tử khác dùng chung ô. - (b) Cái giá thứ nhất: 4 lần bộ nhớ: cùng m và k, Bloom thường dùng 1 bit/ô (25.000 byte), Counting dùng 4 bit/ô (100.000 byte) — tốn 4 lần bộ nhớ. Bạn đổi khả năng xóa lấy 4x dung lượng. Lưu ý: tỉ lệ báo nhầm vẫn như Bloom thường (cùng m, k) — bộ đếm chỉ thêm khả năng xóa, không cải thiện độ chính xác.
- (c) Cái giá thứ hai: tràn bộ đếm: bộ đếm 4 bit chỉ đếm tới 15. Thêm cùng một phần tử
hot20 lần làm các bộ đếm bão hòa ở[15,15,...](không tăng được nữa). Giờ xóahot20 lần — nó vẫn "có" (True), vì chính sách an toàn: bộ đếm đã tràn thì giữ ở max, không giảm. Lý do: khi tràn, ta mất thông tin về số lần thật; nếu ngây thơ giảm đủ 20 lần, bộ đếm về 0 sai, và các phần tử khác dùng chung ô đó sẽ bị báo sót. Chấp nhận "không xóa được ở ô tràn" là cái giá để giữ an toàn.
Đánh đổi cần cân nhắc
Cái giá thứ ba: xóa phần tử chưa từng thêm làm hỏng cấu trúc. Counting Bloom giả định bạn chỉ xóa những gì đã thêm. Nếu xóa một phần tử chưa từng có (do lỗi logic), bạn giảm các bộ đếm mà lẽ ra thuộc phần tử khác — và có thể đẩy một bộ đếm về 0 sai, sinh báo sót cho phần tử thật. Bloom thường không bao giờ báo sót; Counting Bloom có thể báo sót nếu bị dùng sai (xóa nhầm, hoặc tràn xử lý ẩu). Phải đảm bảo mọi lệnh xóa tương ứng một lệnh thêm trước đó.
4 bit thường đủ, nhưng phải tính theo số lần một ô bị dùng chung. Một ô bị bao nhiêu phần tử dùng chung tuân phân phối Poisson với kỳ vọng thấp (thiết kế tốt thì ~ln2 phần tử/ô), nên xác suất một ô vượt 15 là cực nhỏ trong dùng bình thường — 4 bit gần như luôn đủ (đây là kết quả trong bài báo gốc). Tràn chỉ thành vấn đề khi bạn thêm trùng nhiều lần cùng phần tử (như ca hot ở trên) hoặc tải vượt xa thiết kế. Nếu cần đếm trùng nhiều, dùng bộ đếm rộng hơn (8 bit) — đổi thêm bộ nhớ.
Khi nào dùng Counting Bloom, khi nào dùng cấu trúc khác. Counting Bloom hợp khi bạn cần xóa và chấp nhận 4x bộ nhớ. Nhưng nếu chỉ cần "kiểm tra thành viên có xóa" mà muốn tiết kiệm hơn, Cuckoo filter (phần 11) làm được điều đó với ít bộ nhớ hơn Counting Bloom và không có vấn đề tràn kiểu này. Counting Bloom là giải pháp kinh điển và đơn giản; các cấu trúc mới hơn thường tốt hơn cho cùng nhu cầu — nhưng hiểu Counting Bloom giúp bạn hiểu tại sao chúng ra đời.
Ba ý mang về
- Counting Bloom thêm khả năng xóa bằng bộ đếm: đo thật xóa
'bob'làm nó biến mất (False) mà'alice'vẫn còn (True) — thay bit bằng bộ đếm nhỏ, thêm là tăng, xóa là giảm, ô dùng chung có bộ đếm> 1nên xóa không phá nhau. - Cái giá là 4x bộ nhớ và rủi ro tràn: đo thật Counting tốn 100KB vs Bloom thường 25KB (4x, cùng m/k, cùng tỉ lệ báo nhầm); bộ đếm 4 bit bão hòa ở 15 khi thêm trùng nhiều lần, và chính sách an toàn là không giảm bộ đếm đã tràn (tránh báo sót).
- Có thể báo sót nếu dùng sai: xóa phần tử chưa từng thêm giảm nhầm bộ đếm phần tử khác → báo sót (Bloom thường không bao giờ báo sót); cân nhắc Cuckoo filter (phần 11) khi cần xóa mà muốn tiết kiệm bộ nhớ hơn.
Nguồn
- Fan et al. — Summary Cache: A Scalable Wide-Area Web Cache Sharing Protocol (Counting Bloom, 2000): https://www.cs.princeton.edu/courses/archive/spring05/cos598E/bib/summarycache.pdf
- Wikipedia — Counting Bloom filter: https://en.wikipedia.org/wiki/Counting_Bloom_filter
- Bonomi et al. — An Improved Construction for Counting Bloom Filters (2006): https://theory.stanford.edu/~rinap/papers/esa2006b.pdf
Phần sau ta chuyển sang một bài toán khác hẳn: đếm số phần tử khác nhau trong một luồng khổng lồ. HyperLogLog đếm hàng tỉ phần tử phân biệt bằng vài KB bộ nhớ — và ta sẽ đo sai số thật của phép màu đó.
