Phần 1 cho thấy Bloom filter tiết kiệm bộ nhớ khủng khiếp và có tỉ lệ báo nhầm tính trước được. Nhưng "tính trước được" chỉ có ích nếu bạn biết chọn tham số. Bloom có hai nút chỉnh: m (số bit) và k (số hàm băm), và chọn sai cả hai đều làm hỏng: quá ít bit thì báo nhầm cao, quá ít hoặc quá nhiều hàm băm cũng thế. May thay, lý thuyết cho hai công thức gọn để tính m và k tối ưu từ số phần tử và tỉ lệ báo nhầm mong muốn. Bài này (phần 2 loạt Xác suất) đo thật ba điều: có một k tối ưu thật (không phải càng nhiều càng tốt), công thức m cho đúng số bit cần, và một cái bẫy khiến Bloom "hỏng" trong thực tế — nhồi quá số phần tử dự kiến.
Hai công thức thiết kế
Cho trước n (số phần tử sẽ thêm) và p (tỉ lệ báo nhầm bạn chấp nhận), tính:
m = -n · ln(p) / (ln2)²      # số BIT cần thiết
k = (m/n) · ln2              # số HÀM BĂM tối ưu (≈ 0.7 × bit/phần tử)
m/n là số bit mỗi phần tử — nút chỉnh chính. p càng thấp cần càng nhiều bit/phần tử. Và có một điểm phản trực giác: k không phải càng nhiều càng tốt. Nhiều hàm băm hơn nghĩa là mỗi phần tử bật nhiều bit hơn, giúp phân biệt tốt hơn — nhưng cũng làm mảng bit "đầy" nhanh hơn, tăng khả năng trùng. Có một k cân bằng cho báo nhầm thấp nhất.
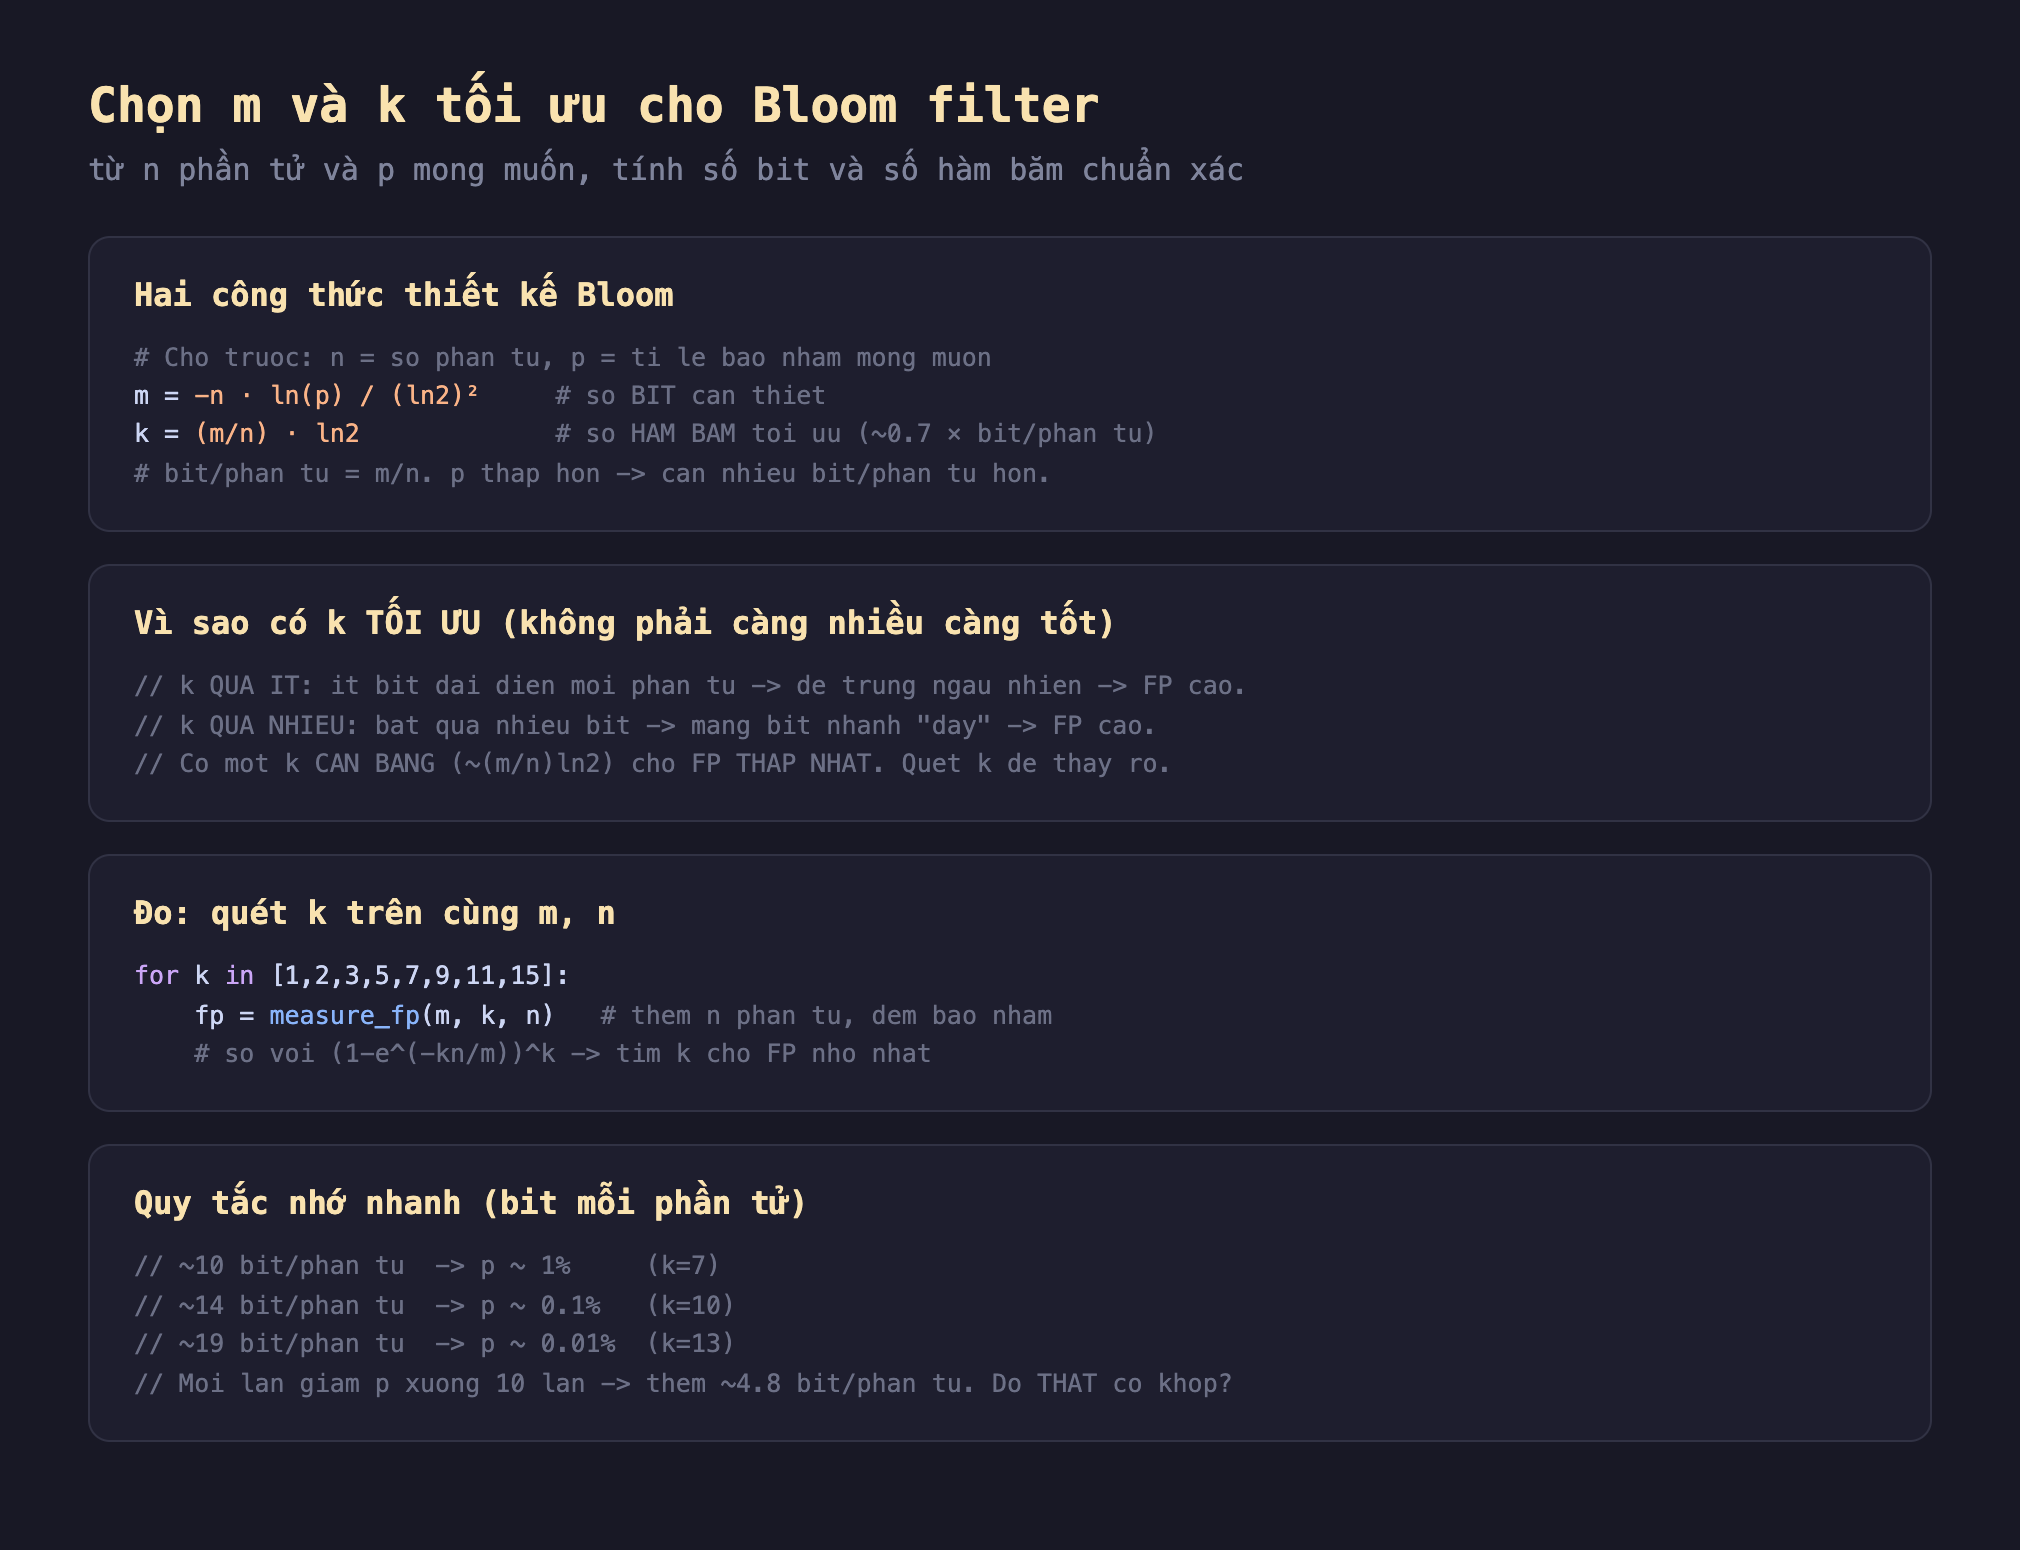
Hình 1: Hai công thức thiết kế Bloom — m = -n·ln(p)/(ln2)² (số bit), k = (m/n)·ln2 (số hàm băm tối ưu); có một k cân bằng cho báo nhầm thấp nhất (quá ít hoặc quá nhiều đều tệ); quy tắc nhớ nhanh ~10 bit/phần tử cho ~1%, ~14 bit cho ~0.1%.
Đo thật: k tối ưu, công thức m, và cái bẫy
Mình dùng Bloom tự cài (như phần 1), chạy ba thí nghiệm trên n=500.000:
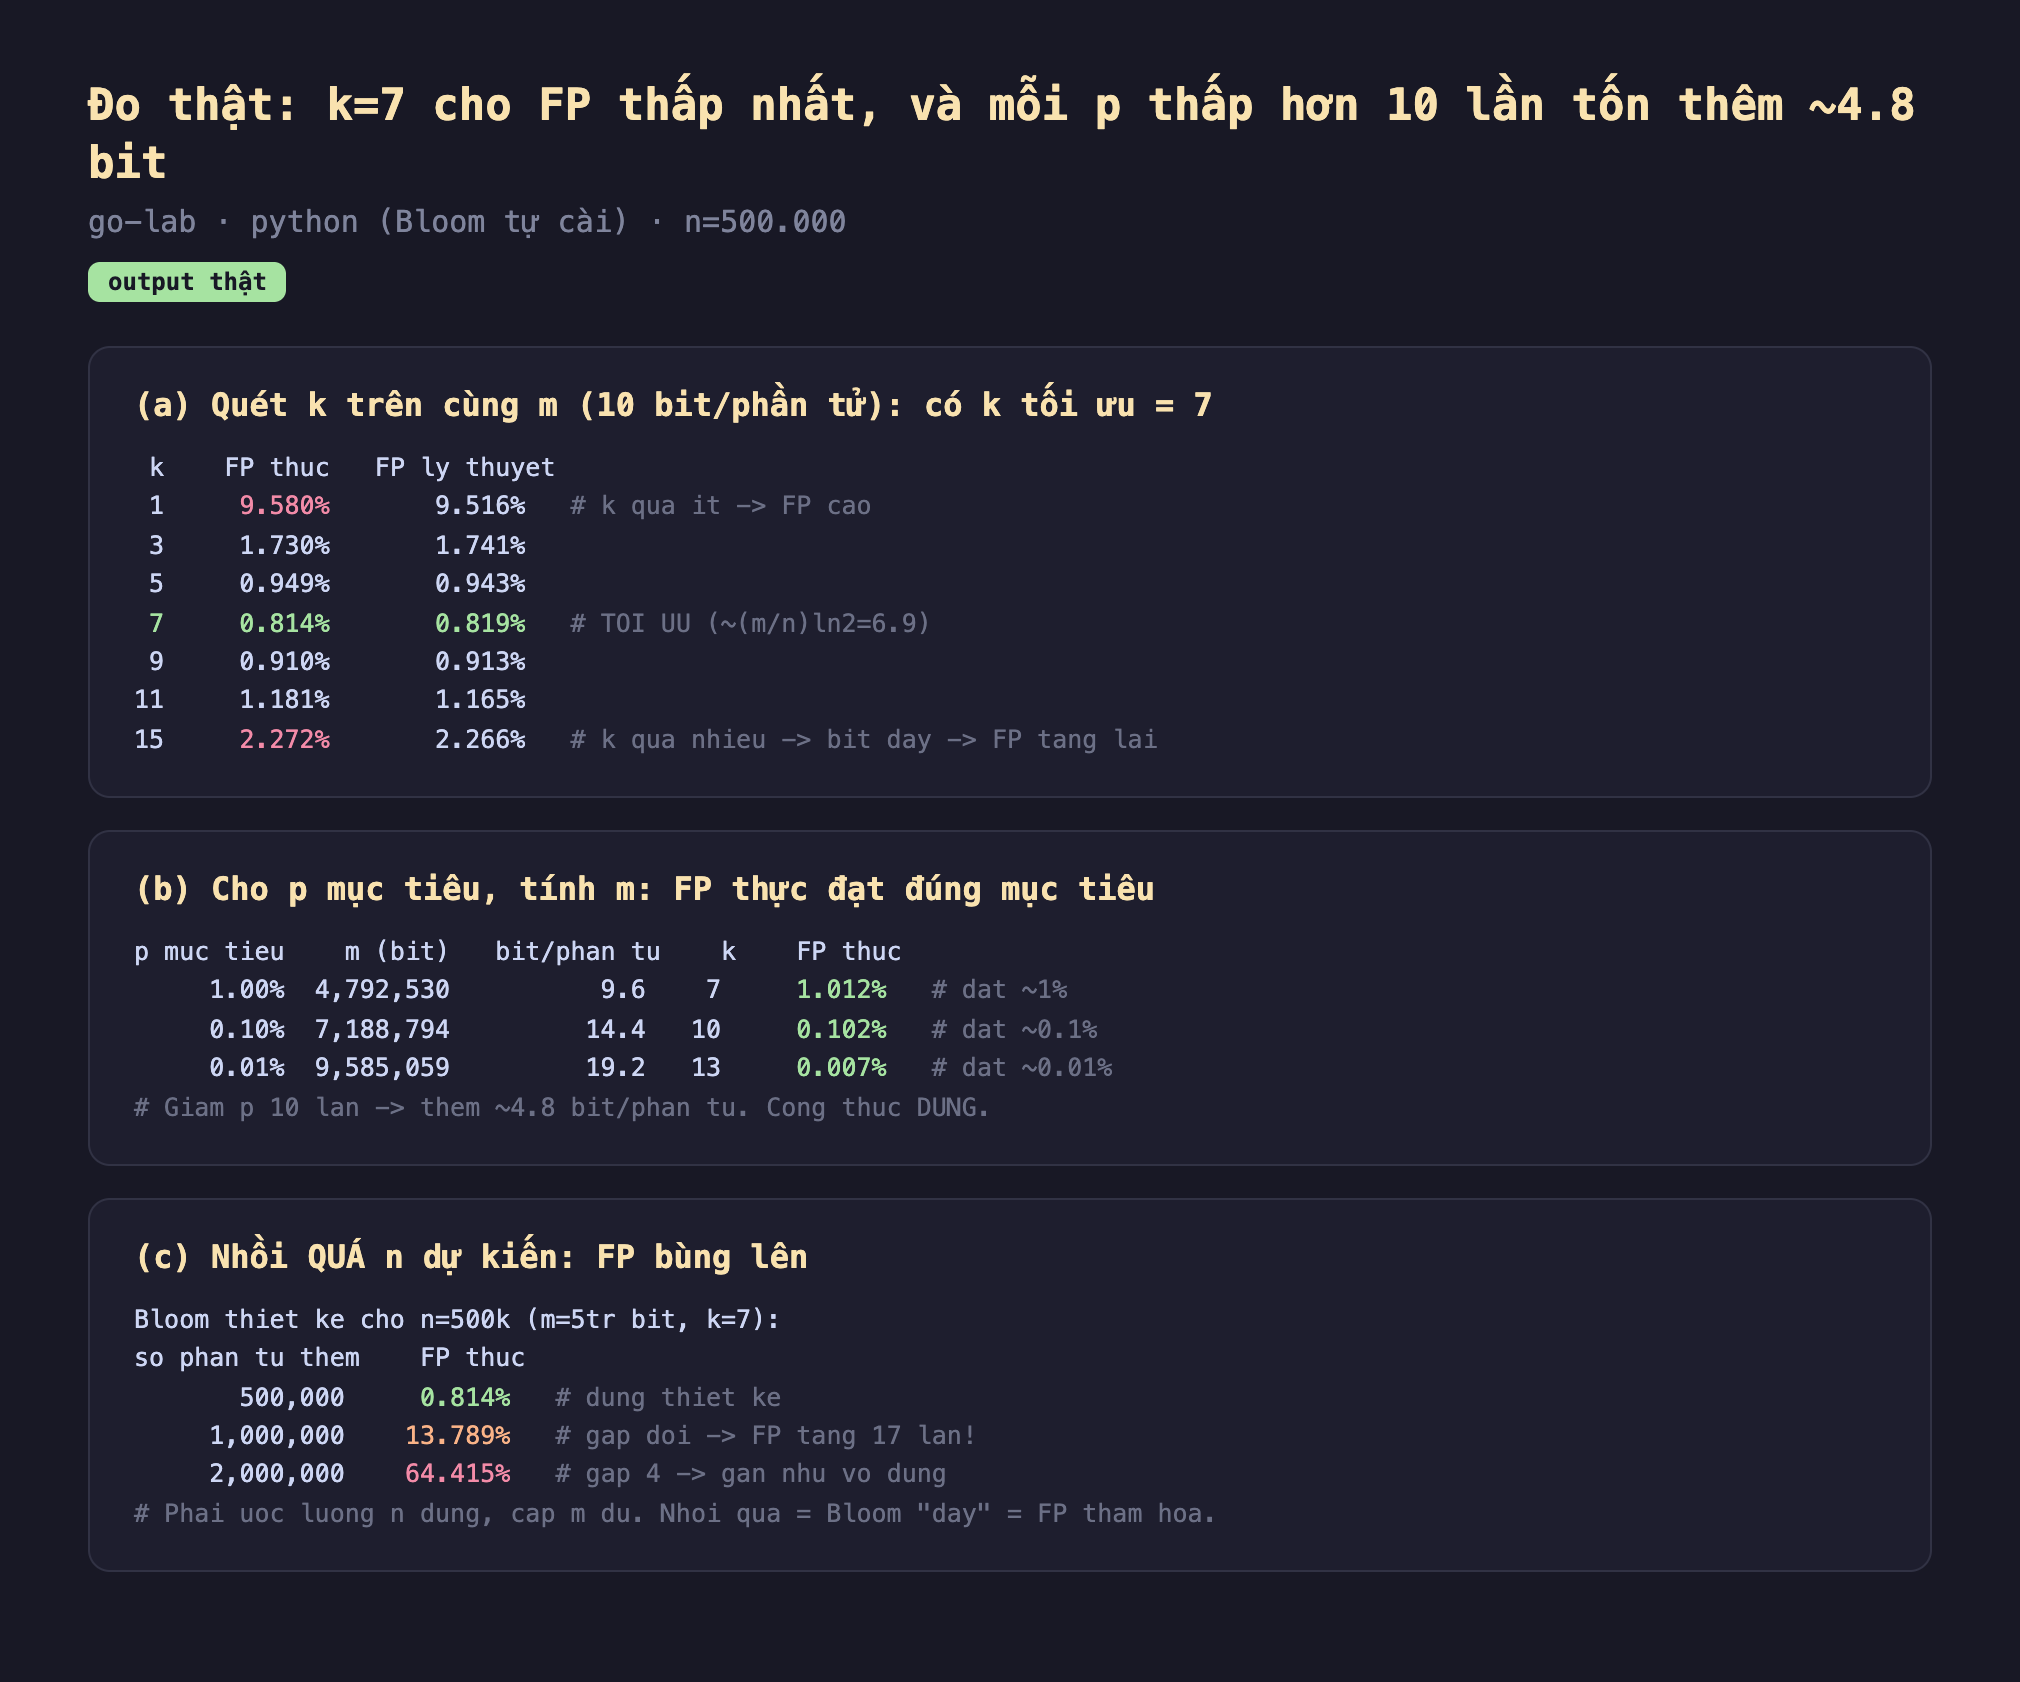
Hình 2: Chạy thật — (a) quét k trên cùng m (10 bit/phần tử): k=7 cho FP thấp nhất 0.814% (khớp lý thuyết ~6.9), k=1 cho 9.58%, k=15 cho 2.27%; (b) p mục tiêu → m: 1%→9.6 bit/phần tử (FP thực 1.012%), 0.1%→14.4 bit (0.102%), 0.01%→19.2 bit (0.007%); (c) nhồi quá: 500k→0.814%, 1M→13.789%, 2M→64.415%.
- (a) k tối ưu là thật — đường cong hình chữ V: quét k từ 1 tới 15 trên cùng một Bloom 10 bit/phần tử, FP giảm dần từ 9.58% (k=1) xuống đáy 0.814% ở k=7, rồi tăng lại lên 2.27% (k=15). Đúng như lý thuyết dự đoán: k tối ưu ≈ (m/n)·ln2 = 6.9. Ít hàm băm quá thì phân biệt kém; nhiều quá thì làm mảng bit đầy — cả hai đều tăng báo nhầm. Và FP thực khớp FP lý thuyết ở mọi giá trị k.
- (b) Công thức m cho đúng số bit cần: cho trước p mục tiêu,
m = -n·ln(p)/(ln2)²tính ra số bit, và đo thực tế FP đạt đúng mục tiêu: p=1% cần 9.6 bit/phần tử (FP thực 1.012%), p=0.1% cần 14.4 bit (0.102%), p=0.01% cần 19.2 bit (0.007%). Một quy tắc đẹp lộ ra: mỗi lần giảm p xuống 10 lần, thêm ~4.8 bit/phần tử. Đây là cách bạn dự toán bộ nhớ Bloom chính xác trước khi triển khai. - (c) Cái bẫy chết người — nhồi quá n: đây là lỗi thực tế phổ biến nhất. Một Bloom thiết kế cho 500k phần tử (m=5 triệu bit, k=7) cho báo nhầm 0.814% khi dùng đúng. Nhưng nếu bạn nhồi gấp đôi (1 triệu), báo nhầm nhảy lên 13.789% — tăng 17 lần! Nhồi gấp bốn (2 triệu) thì 64.415% — gần như vô dụng. Vì Bloom cố định m bit, thêm nhiều phần tử làm quá nhiều bit bật ("Bloom đầy"), và báo nhầm tăng theo hàm mũ. Đây là lý do phải ước lượng n cho đúng và cấp m dư.
Đánh đổi cần cân nhắc
Ước lượng n cao hơn thực tế — thà thừa bit còn hơn Bloom đầy. Vì báo nhầm bùng lên khi nhồi quá, nên khi không chắc n, hãy ước lượng cao và cấp m theo đó. Dư một chút bit chỉ tốn thêm chút bộ nhớ (tuyến tính), nhưng thiếu bit làm báo nhầm nổ theo hàm mũ. Nếu n thực sự không đoán được (tập tăng trưởng liên tục), dùng scalable Bloom filter — thêm các Bloom mới khi cái cũ đầy, giữ báo nhầm tổng dưới ngưỡng.
k phải là số nguyên — làm tròn từ công thức, và đừng sợ lệch một chút. Công thức cho k = (m/n)·ln2 thường ra số lẻ (6.9), bạn làm tròn thành 7. Đường cong FP quanh đỉnh khá phẳng (k=5, 7, 9 chênh nhau ít — 0.949%, 0.814%, 0.910%), nên lệch k một hai đơn vị không tai hại. Nếu tính toán k hash tốn kém, chọn k nhỏ hơn một chút (ví dụ 5 thay 7) đổi chút báo nhầm lấy tốc độ cũng là đánh đổi hợp lý.
Bit/phần tử là ngôn ngữ chung để nói về Bloom. Khi so sánh hoặc thiết kế, đừng nói về m tuyệt đối (phụ thuộc n) mà nói về bit/phần tử (m/n) — nó quyết định báo nhầm bất kể quy mô. "10 bit/phần tử cho ~1%" là con số đáng nhớ. Các thư viện Bloom thường nhận trực tiếp (n, p) và tự tính m, k — nhưng hiểu quan hệ này giúp bạn biết khi nào Bloom không hợp (ví dụ cần p=0.001% thì 24 bit/phần tử, có khi lưu thẳng còn rẻ hơn).
Ba ý mang về
- Có k tối ưu, không phải càng nhiều càng tốt: đo thật quét k=1..15 cho đường cong chữ V, đáy ở k=7 (0.814%) khớp công thức (m/n)·ln2=6.9; ít hàm băm quá phân biệt kém, nhiều quá làm mảng bit đầy — cả hai tăng báo nhầm.
- Công thức cho đúng số bit theo p mục tiêu: đo thật
m = -n·ln(p)/(ln2)²đạt đúng 1%/0.1%/0.01% với 9.6/14.4/19.2 bit/phần tử — mỗi lần giảm p 10 lần thêm ~4.8 bit; dùng để dự toán bộ nhớ chính xác. - Nhồi quá n là cái bẫy chết người: đo thật Bloom cho 500k khi nhồi 1M làm báo nhầm nhảy 0.814%→13.789% (17 lần), 2M→64.4% — báo nhầm bùng theo hàm mũ; ước lượng n cao, cấp m dư, hoặc dùng scalable Bloom.
Nguồn
- Wikipedia — Bloom filter: Optimal number of hash functions: https://en.wikipedia.org/wiki/Bloom_filter#Optimal_number_of_hash_functions
- Bloom filter calculator — hur.st: https://hur.st/bloomfilter/
- Almeida et al. — Scalable Bloom Filters (2007): https://haslab.uminho.pt/cbm/files/dbloom.pdf
Phần sau ta vá một giới hạn của Bloom: không xóa được. Counting Bloom filter thay mỗi bit bằng một bộ đếm nhỏ để hỗ trợ xóa — đo thật cái giá bộ nhớ phải trả cho khả năng đó.
