Có một họ cấu trúc dữ liệu mà lần đầu gặp ai cũng thấy như ma thuật: chúng trả lời câu hỏi về hàng triệu phần tử bằng bộ nhớ nhỏ đến vô lý — đổi lại một chút sai số có kiểm soát. Đây là cấu trúc dữ liệu xác suất, và chúng có mặt trong gần như mọi hệ thống lớn: database, cache, phân tích luồng, mạng CDN. Loạt bài này đi qua những cái quan trọng nhất, và mở đầu bằng cái nổi tiếng nhất: Bloom filter. Nó trả lời một câu hỏi tưởng chừng cần lưu cả tập — "x có trong tập không?" — mà chỉ dùng một mảng bit và vài hàm băm. Bài này (phần 1 loạt Xác suất) tự cài Bloom filter và đo thật để thấy nó tiết kiệm bộ nhớ khủng khiếp thế nào, và sai số của nó khớp lý thuyết ra sao.
Vấn đề và cơ chế
Bài toán: bạn có một tập lớn (1 triệu URL, email, khóa cache...) và cần kiểm tra nhanh xem một phần tử có thuộc tập không. Cách thông thường — lưu cả tập vào một set/hash — cho tra cứu O(1) nhưng tốn RAM tỉ lệ số phần tử: một triệu chuỗi có thể ngốn hàng chục MB, chỉ để trả lời CÓ/KHÔNG.
Bloom filter đổi cách nghĩ: nếu chấp nhận thỉnh thoảng báo nhầm (nói "có" khi thực ra không), ta làm được việc đó bằng một mảng m bit và k hàm băm:
- Thêm x: bật k bit ở vị trí
hash_1(x), ..., hash_k(x). - Kiểm x: nếu mọi k bit đều bật → "CÓ THỂ có"; nếu một bit tắt → "CHẮC CHẮN không".
Điểm mấu chốt về sai số: Bloom không bao giờ báo sót (no false negative) — nếu đã thêm x thì các bit của nó chắc chắn đã bật, nên luôn trả "có". Nhưng nó có thể báo nhầm (false positive): các bit của một phần tử khác vô tình bật trùng đủ k vị trí. Sai số chỉ đi một chiều.
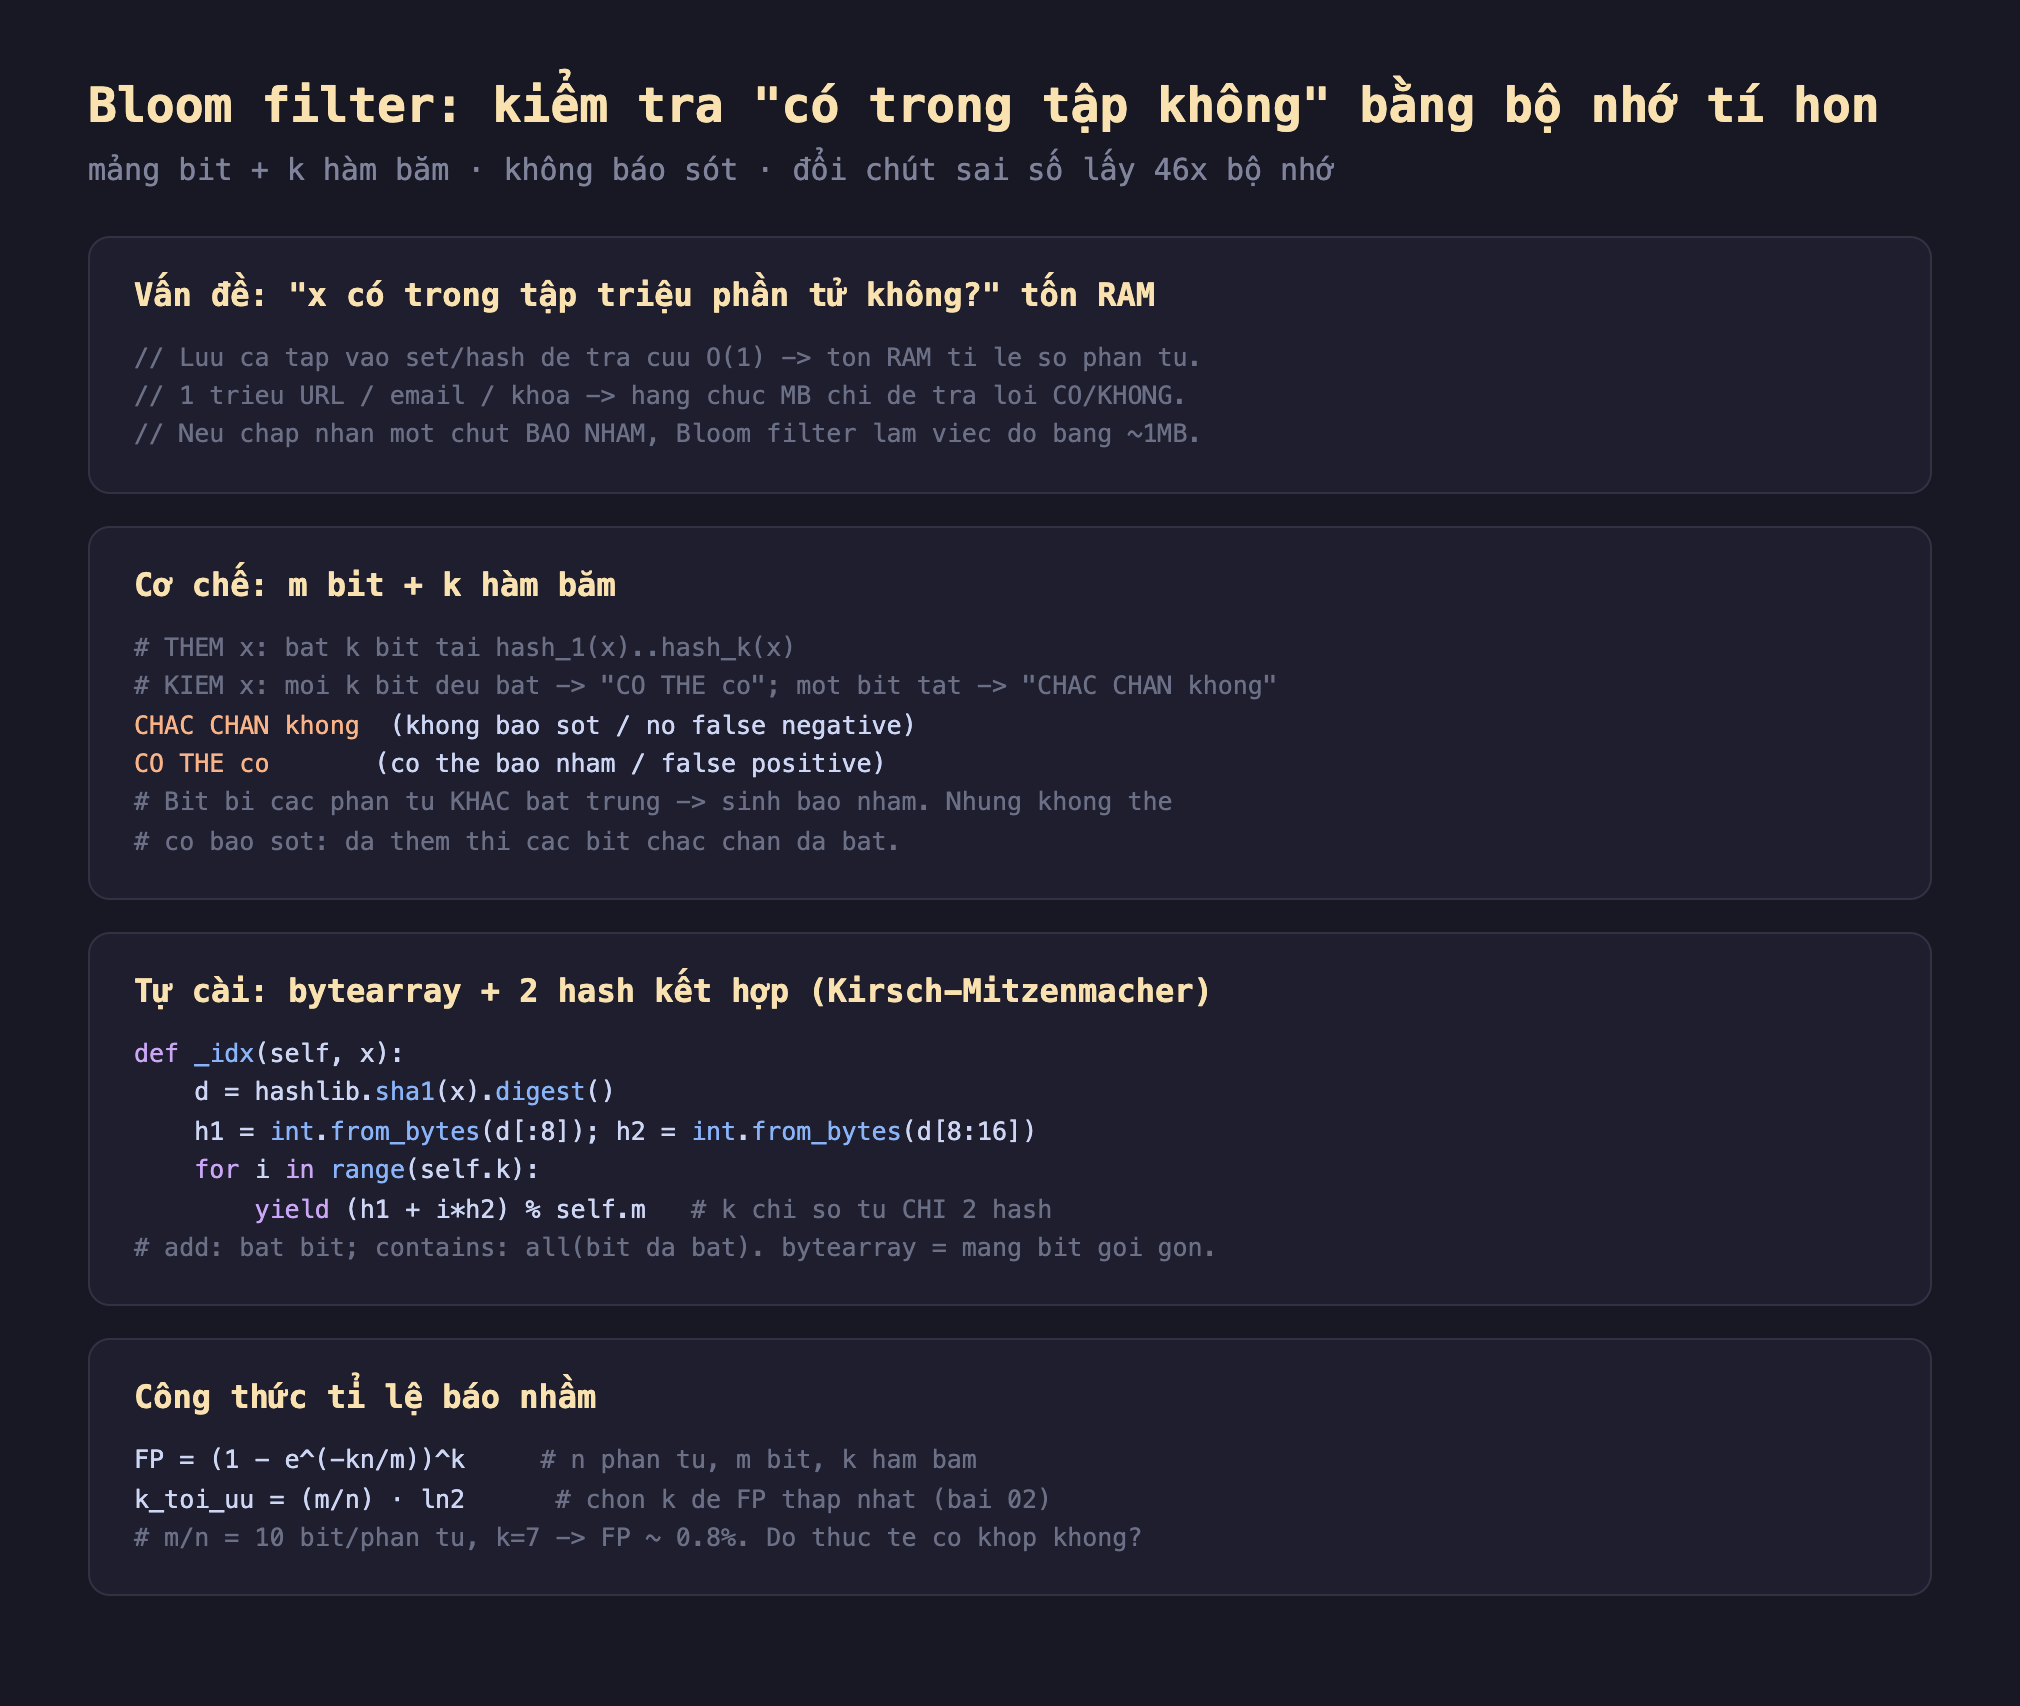
Hình 1: Bloom filter dùng m bit + k hàm băm — thêm x bật k bit, kiểm x xem k bit có bật hết; "một bit tắt = CHẮC CHẮN không" (không báo sót), "mọi bit bật = CÓ THỂ có" (có thể báo nhầm); tự cài bằng bytearray + hai hash kết hợp; tỉ lệ báo nhầm theo công thức (1-e^(-kn/m))^k.
Đo thật: 46 lần nhỏ hơn, sai số khớp công thức
Mình tự cài Bloom (dùng hai hash từ SHA-1 kết hợp kiểu Kirsch-Mitzenmacher để sinh k chỉ số), thêm 1 triệu phần tử vào một Bloom m=10 triệu bit (10 bit/phần tử), k=7, rồi kiểm 500.000 phần tử không thuộc tập để đo tỉ lệ báo nhầm:
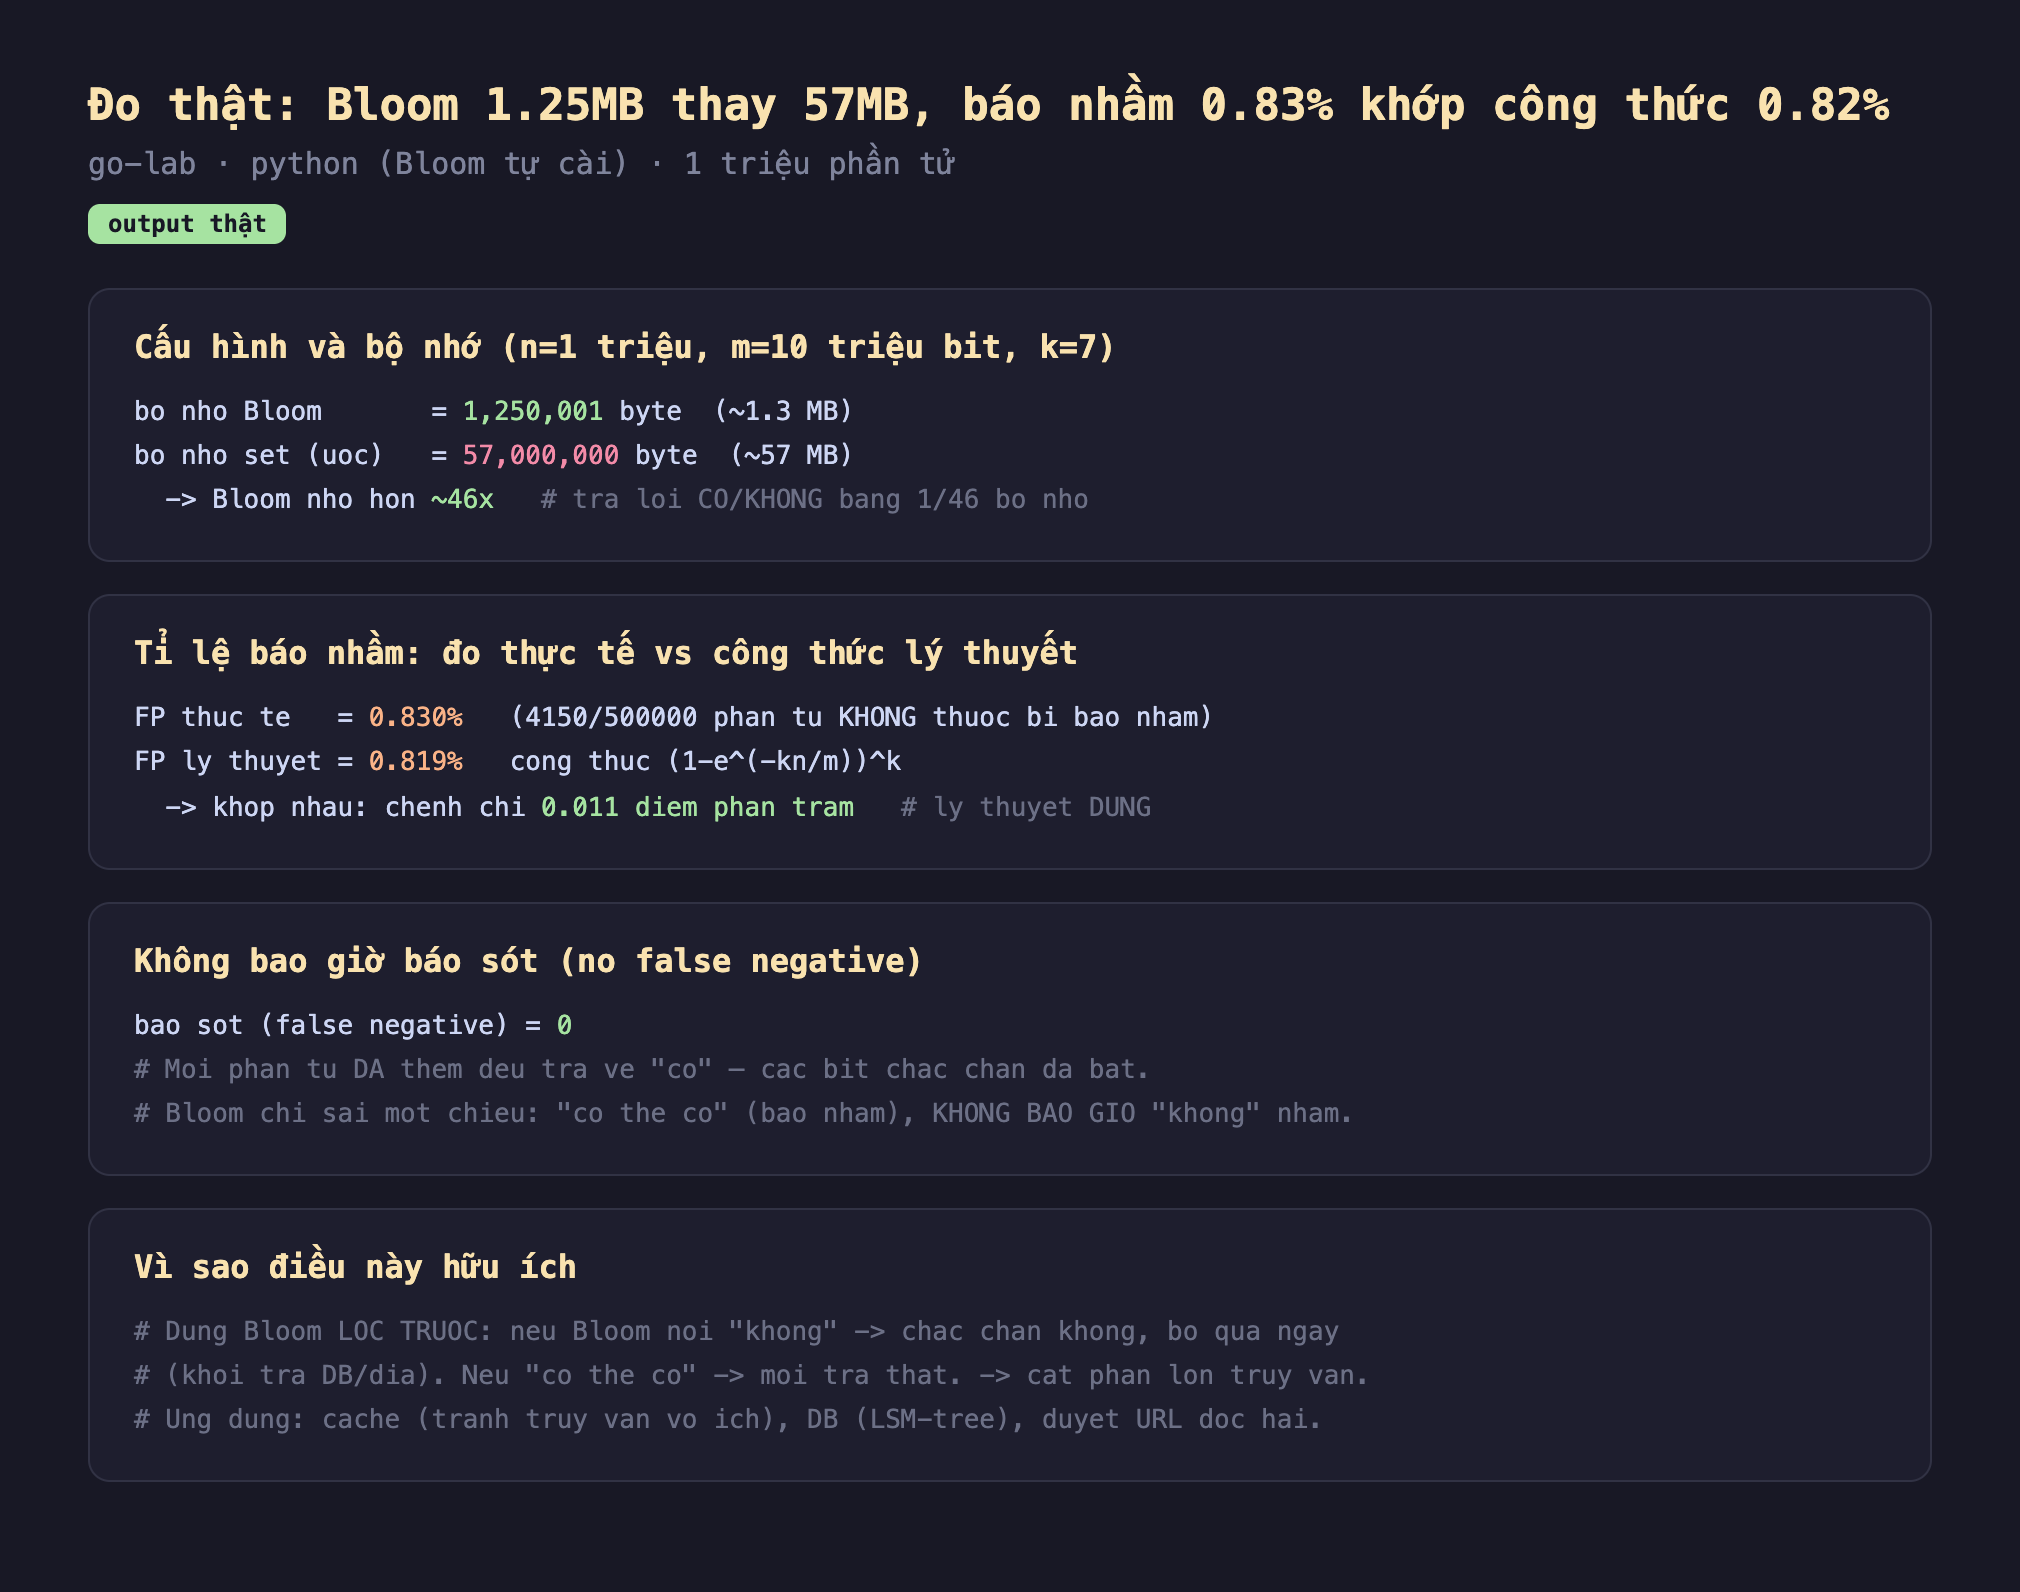
Hình 2: Chạy thật — n=1.000.000, m=10.000.000 bit, k=7: Bloom 1.250.001 byte (~1.3MB) vs set ước tính ~57MB (nhỏ hơn ~46x); FP thực tế 0.830% (4150/500000) khớp FP lý thuyết 0.819% (chênh 0.011 điểm phần trăm); báo sót = 0.
- Tiết kiệm bộ nhớ 46 lần: Bloom chỉ chiếm 1.25MB (đúng bằng 10 triệu bit gói trong bytearray), trong khi một
setpython lưu 1 triệu chuỗi ước tính ~57MB — Bloom nhỏ hơn ~46 lần. Với hệ thống có hàng chục triệu phần tử, đây là chênh lệch giữa "vừa RAM" và "hết RAM". - Sai số khớp lý thuyết gần hoàn hảo: đây là điều đẹp nhất về Bloom — sai số của nó tính trước được. Công thức
FP = (1-e^(-kn/m))^kcho 0.819%, và đo thực tế trên 500.000 phần tử ngoài tập cho 0.830% — chênh chỉ 0.011 điểm phần trăm. Bạn không phải "hy vọng" sai số nhỏ; bạn tính được nó từ m, n, k trước khi triển khai (chi tiết chọn m, k ở phần 2). - Không bao giờ báo sót: đo thật, mọi phần tử đã thêm đều trả "có" — báo sót = 0. Đây là tính chất đảm bảo (không phải xác suất): Bloom chỉ sai một chiều. Nhờ vậy nó dùng được làm bộ lọc trước an toàn.
Đánh đổi cần cân nhắc
Sai số một chiều làm Bloom thành bộ lọc trước hoàn hảo. Vì "CHẮC CHẮN không" là chắc chắn, bạn dùng Bloom để cắt các truy vấn vô ích: nếu Bloom nói "không có", bỏ qua ngay — khỏi tra database/đĩa (thao tác đắt). Chỉ khi Bloom nói "có thể có" mới tra thật; lúc đó nếu là báo nhầm, bạn chỉ tốn một lần tra thừa (hiếm, ~0.8%). Đây chính là cách LSM-tree (RocksDB, Cassandra) tránh đọc đĩa cho khóa không tồn tại, và cách cache tránh truy vấn backend vô ích. Sai số nhỏ đổi lấy việc cắt phần lớn thao tác đắt.
Không xóa được, và không đếm được — chỉ trả lời "có thể có / chắc chắn không". Bloom cơ bản không hỗ trợ xóa một phần tử (tắt bit có thể phá phần tử khác dùng chung bit đó) — cần Counting Bloom (phần 3). Nó cũng không cho biết có bao nhiêu phần tử, không liệt kê được các phần tử, không lấy lại được dữ liệu gốc. Bloom chỉ làm đúng một việc: kiểm tra thành viên với sai số một chiều. Cần thao tác khác thì dùng cấu trúc khác (các phần sau).
Chọn m, k sai làm sai số bùng lên — phải tính trước theo n dự kiến. Sai số phụ thuộc tỉ lệ m/n (số bit mỗi phần tử) và k. Nếu bạn nhét nhiều phần tử hơn dự kiến vào một Bloom cố định, m/n giảm và sai số tăng vọt (Bloom "đầy" — quá nhiều bit bật). Phải ước lượng n trước và cấp m đủ, hoặc dùng scalable Bloom filter. Đây là chủ đề của phần 2: chọn m và k tối ưu.
Ba ý mang về
- Bloom filter trả lời thành viên bằng bộ nhớ tí hon: đo thật thay 57MB set bằng 1.25MB (nhỏ hơn ~46 lần) cho 1 triệu phần tử — dùng m bit + k hàm băm, thêm là bật bit, kiểm là xem bit có bật hết.
- Sai số một chiều và tính trước được: đo thật FP thực tế 0.830% khớp công thức
(1-e^(-kn/m))^k= 0.819%, và báo sót = 0 — Bloom không bao giờ báo sót, chỉ có thể báo nhầm, nên là bộ lọc trước an toàn (cắt truy vấn DB/đĩa vô ích). - Biết giới hạn: Bloom không xóa được (cần Counting Bloom - phần 3), không đếm/liệt kê được, và sai số bùng lên nếu nhét quá nhiều phần tử — phải chọn m, k theo n dự kiến (phần 2).
Nguồn
- Burton Bloom — Space/Time Trade-offs in Hash Coding with Allowable Errors (1970): https://dl.acm.org/doi/10.1145/362686.362692
- Kirsch & Mitzenmacher — Less Hashing, Same Performance (2 hash sinh k): https://www.eecs.harvard.edu/~michaelm/postscripts/rsa2008.pdf
- Wikipedia — Bloom filter: https://en.wikipedia.org/wiki/Bloom_filter
Phần sau ta trả lời câu hỏi thực tế: cho trước số phần tử và tỉ lệ báo nhầm mong muốn, chọn m (số bit) và k (số hàm băm) bao nhiêu là tối ưu — và đo thật đường cong sai số theo từng lựa chọn.
