Cả series này ta đã dựng từng công cụ riêng lẻ: EXPLAIN, pg_stat_statements, index từng phần, pg_stat_user_tables... Bài này gộp chúng lại thành một quy trình để bạn theo khi gặp một truy vấn chậm thật ngoài đời — không phải "thử vài thứ xem sao", mà một chuỗi năm bước có hệ thống: phát hiện, đọc kế hoạch, tìm nguyên nhân, sửa, xác nhận. Tôi chẩn đoán một truy vấn thật từ đầu đến cuối để minh hoạ.
Năm bước
-- 1. PHÁT HIỆN: truy vấn nào đáng sửa (theo TỔNG thời gian)
SELECT query, calls, total_exec_time FROM pg_stat_statements
ORDER BY total_exec_time DESC LIMIT 10;
-- 2. ĐỌC KẾ HOẠCH: EXPLAIN (ANALYZE, BUFFERS) <truy vấn>
-- 3. TÌM NGUYÊN NHÂN: điều kiện lọc chọn lọc không? thống kê cũ? thiếu index?
-- 4. SỬA: thường là index đúng loại (+ ANALYZE)
-- 5. XÁC NHẬN: EXPLAIN lại, so trước/sau — ĐO, đừng đoán
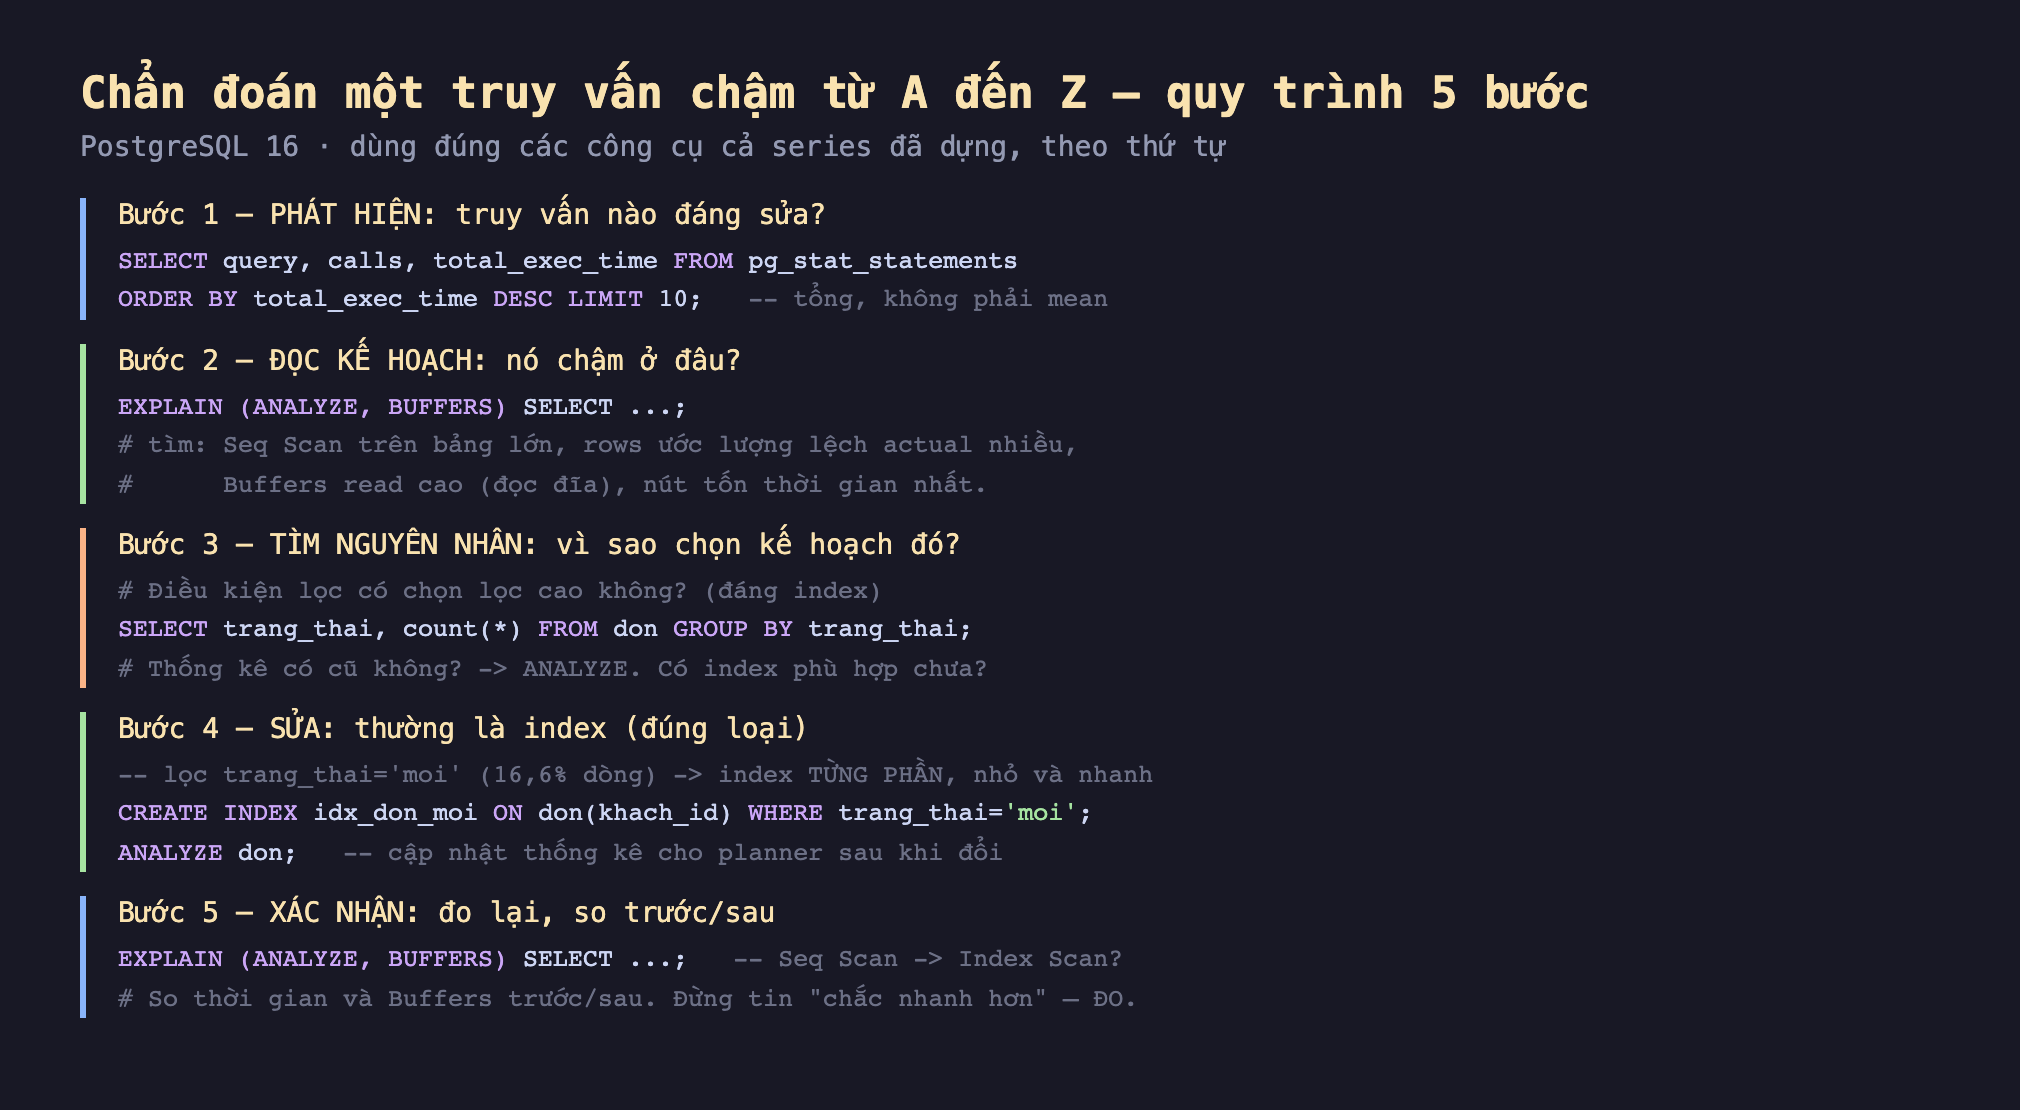
Hình 1: Quy trình năm bước — phát hiện bằng pg_stat_statements, đọc kế hoạch bằng EXPLAIN (ANALYZE, BUFFERS), tìm nguyên nhân (chọn lọc/thống kê/index), sửa (thường là index đúng loại + ANALYZE), xác nhận bằng đo lại.
Chẩn đoán thật: truy vấn đếm đơn của khách VIP
Kịch bản: bảng don 3 triệu đơn, khach 200 nghìn khách. Truy vấn đếm số đơn trạng thái 'moi' của khách VIP, gom theo tên.
Bước 2 — đọc kế hoạch TRƯỚC. EXPLAIN (ANALYZE, BUFFERS) cho thấy một Parallel Seq Scan on don — nó quét cả 3 triệu đơn để lọc ra trạng thái 'moi', Buffers read=7673` (đọc 7.673 trang từ đĩa). Thời gian: 49,331 ms.
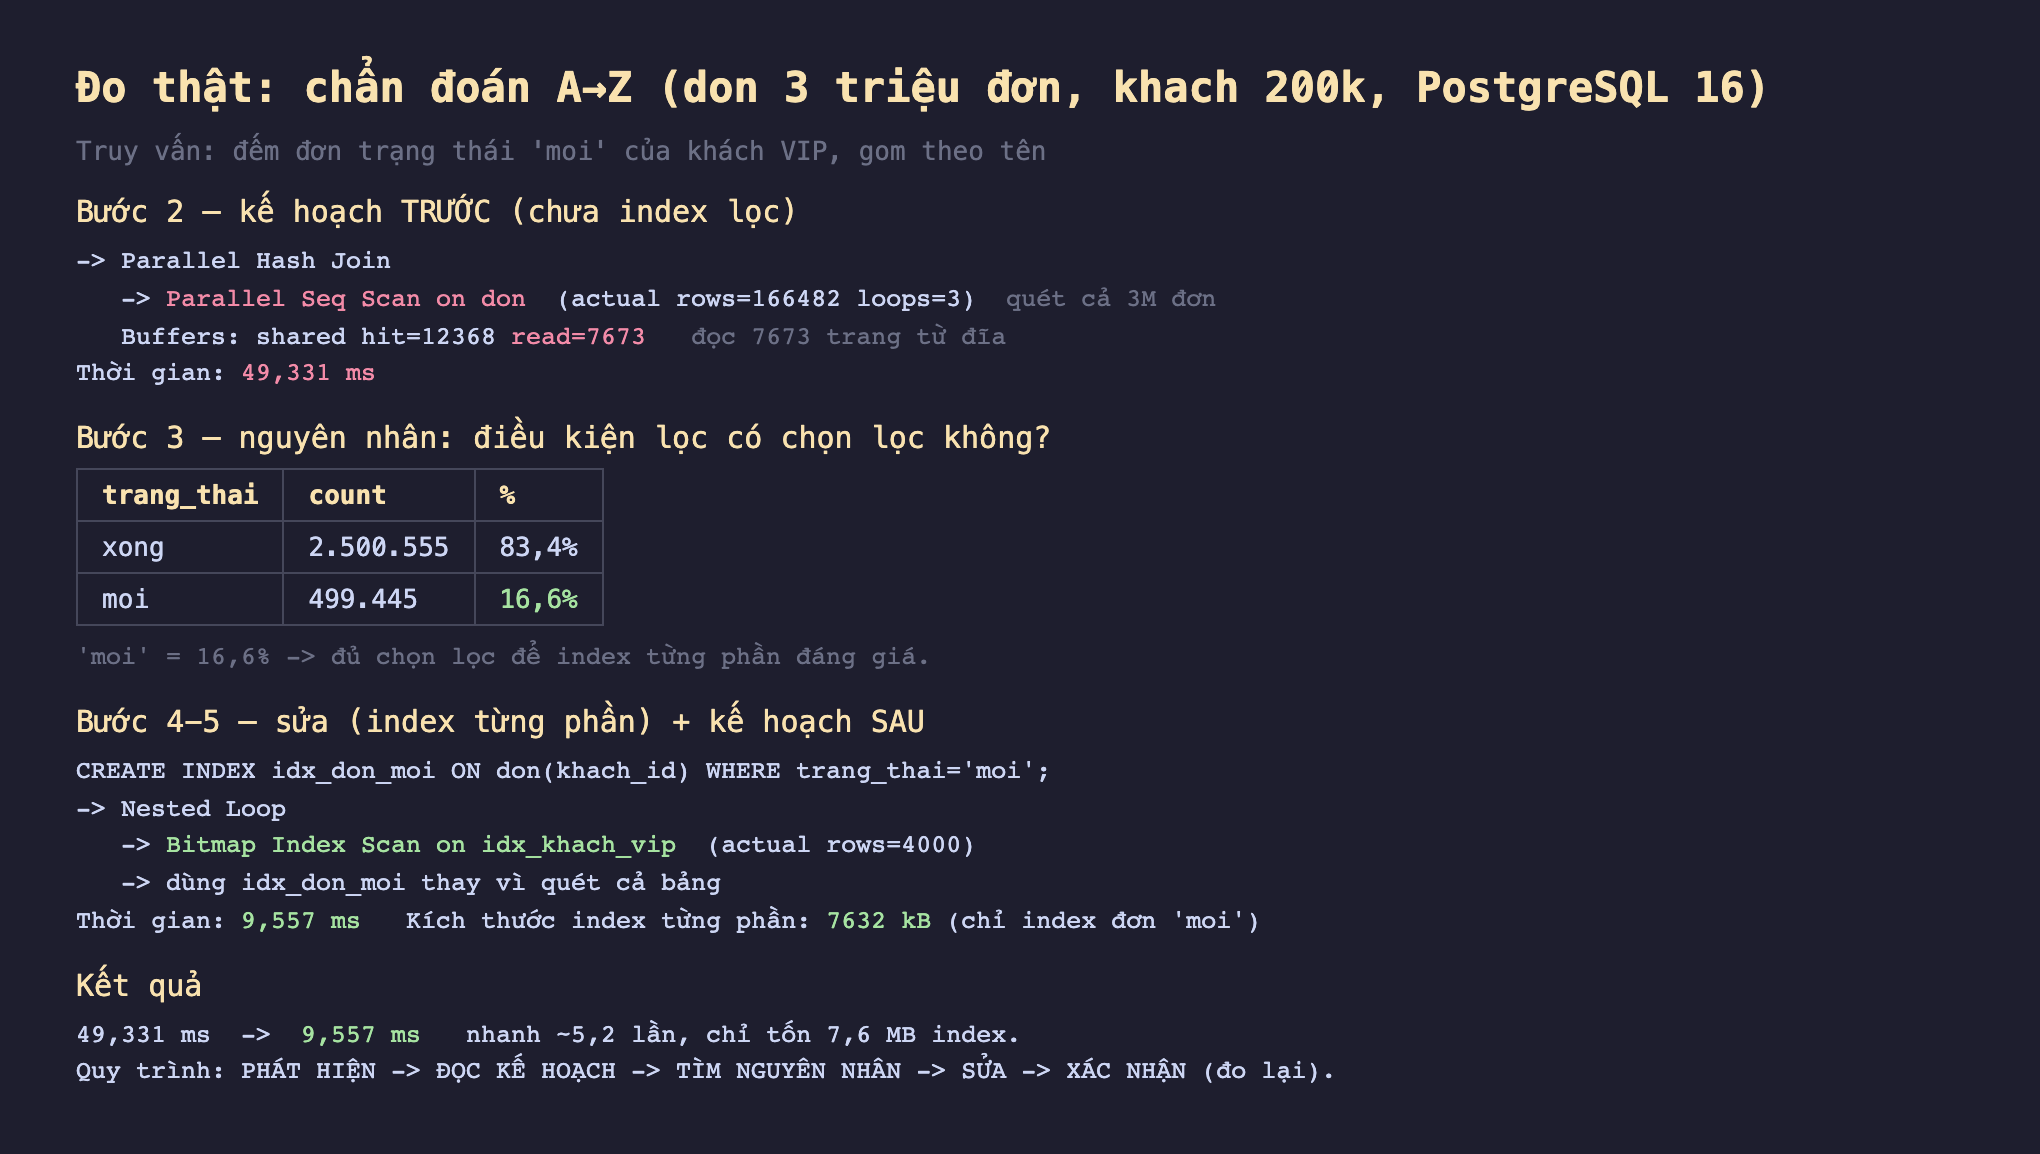
Hình 2: Kế hoạch TRƯỚC: Parallel Seq Scan on don quét cả 3 triệu đơn, 49,331 ms. Nguyên nhân: 'moi' chỉ chiếm 16,6% (đủ chọn lọc). SAU khi thêm index từng phần: Nested Loop + Bitmap Index Scan, 9,557 ms — nhanh ~5,2 lần, index chỉ 7,6 MB.
Bước 3 — tìm nguyên nhân. Vì sao planner chọn seq scan? Vì không có index cho điều kiện lọc. Nhưng thêm index có đáng không? Phải xem điều kiện có chọn lọc không: SELECT trang_thai, count(*) FROM don GROUP BY trang_thai cho thấy 'moi' chiếm 16,6% (499.445 trong 3 triệu). 16,6% đủ chọn lọc để index có ích — nếu 'moi' chiếm 90% thì index vô dụng, quét cả bảng còn nhanh hơn.
Bước 4 — sửa. Vì ta luôn chỉ quan tâm đơn 'moi', dùng index từng phần — chỉ index những dòng thoả điều kiện:
CREATE INDEX idx_don_moi ON don(khach_id) WHERE trang_thai='moi';
CREATE INDEX idx_khach_vip ON khach(id) WHERE hang='vip';
ANALYZE don; ANALYZE khach;   -- cập nhật thống kê cho planner
Index từng phần nhỏ hơn nhiều index thường vì chỉ chứa 16,6% số dòng — đo thật chỉ 7,6 MB.
Bước 5 — xác nhận. EXPLAIN (ANALYZE, BUFFERS) lại: kế hoạch đổi thành Nested Loop với Bitmap Index Scan on idx_khach_vip, dùng index thay vì quét cả bảng. Thời gian: 9,557 ms — nhanh ~5,2 lần so với 49,331 ms ban đầu. Đây là bước quan trọng nhất và hay bị bỏ qua: đo lại để xác nhận, đừng tin "chắc là nhanh hơn".
Vì sao thứ tự quan trọng
Quy trình này không phải để làm màu — mỗi bước ngăn một sai lầm phổ biến:
- Bắt đầu từ phát hiện (bước 1) tránh tối ưu nhầm truy vấn không quan trọng — như bài
pg_stat_statementsđã đo, cái "chậm mỗi lần" khác cái "tốn tổng nhiều nhất". - Đọc kế hoạch trước khi sửa (bước 2) tránh đoán mò — bạn thấy chính xác nó chậm ở đâu (seq scan? sort? nested loop lặp?).
- Kiểm chọn lọc trước khi thêm index (bước 3) tránh thêm index vô dụng — index trên cột không chọn lọc chỉ tốn chỗ và làm chậm ghi.
- ANALYZE sau khi đổi (bước 4) để planner biết về index mới.
- Đo lại (bước 5) để chắc chắn thật sự cải thiện, không phải tưởng tượng.
Đánh đổi cần cân nhắc
Index không phải luôn là câu trả lời. Ở đây index giúp vì điều kiện chọn lọc. Nhưng đôi khi nguyên nhân là thống kê cũ (chỉ cần ANALYZE), là truy vấn viết dở (subquery tương quan, NOT IN với NULL — các bài đã đo), hay là thiếu work_mem (sort tràn đĩa). Bước 3 tồn tại chính để phân biệt — đừng nhảy thẳng tới "thêm index".
Cải thiện đo được ở lab có thể khác production. 49 ms xuống 9,5 ms trên lab với dữ liệu phần lớn đã cache; trên production với bảng lớn hơn, đĩa chậm hơn, hoặc cache lạnh, khoảng cách có thể lớn hơn nhiều (seq scan đọc đĩa thật đắt hơn nhiều). Luôn đo trên môi trường gần production nhất có thể.
Mỗi index thêm chi phí ghi. Index từng phần 7,6 MB này làm mọi INSERT/UPDATE đơn 'moi' phải cập nhật thêm. Với bảng ghi rất nhiều, cân lợi ích đọc với chi phí ghi. Index từng phần giảm chi phí này (chỉ index phần liên quan) nhưng không loại bỏ hoàn toàn.
Ba ý mang về
- Chẩn đoán truy vấn chậm theo quy trình năm bước có thứ tự: phát hiện (
pg_stat_statementstheo tổng thời gian) → đọc kế hoạch (EXPLAIN ANALYZE BUFFERS) → tìm nguyên nhân (chọn lọc/thống kê/index) → sửa → xác nhận (đo lại) — thứ tự này ngăn các sai lầm phổ biến như tối ưu nhầm truy vấn hay thêm index vô dụng. - Đo thật một truy vấn 49 ms quét cả 3 triệu đơn: nguyên nhân là thiếu index cho điều kiện lọc
'moi'(16,6% dòng — đủ chọn lọc), sửa bằng index từng phần nhỏ (7,6 MB, chỉ index đơn'moi') đưa về 9,5 ms — nhanh ~5,2 lần. - Bước xác nhận (đo lại) quan trọng nhất và hay bị bỏ: đừng tin "chắc nhanh hơn" —
EXPLAINlại để thấy kế hoạch đổi từ Seq Scan sang Index Scan và so thời gian/Buffers trước-sau; và nhớ index không phải luôn là câu trả lời (đôi khi chỉ cần ANALYZE hay sửa truy vấn).
Phần sau ta xử một triệu chứng cụ thể rất hay gặp: Phần sau một bảng ngày càng chậm theo thời gian — cách phân biệt nguyên nhân là bloat (phình do dead tuple) hay thiếu index, và chữa đúng bệnh.
