Có dashboard đẹp là một chuyện; biết cảnh báo khi nào lại là chuyện khác — và quan trọng hơn nhiều. Một cảnh báo đúng, đến đúng lúc, có thể cứu bạn khỏi một sự cố mất dữ liệu; một trăm cảnh báo giả sẽ khiến bạn phớt lờ cả cái thứ 101 thật sự nghiêm trọng. Bài này không liệt kê mọi chỉ số có thể đo, mà tập trung vào những thứ thực sự cần cảnh báo trên PostgreSQL production, đo giá trị thật của từng cái trên một database đang chạy, và giải thích ngưỡng.
Cảnh báo số một: wraparound transaction ID
Nếu chỉ được đặt một cảnh báo, hãy đặt cái này. PostgreSQL đánh số mỗi giao dịch bằng một số nguyên 32-bit — tối đa khoảng 2,1 tỷ. Cơ chế MVCC dựa vào việc so sánh các số này để biết dòng nào "thấy được". Nếu autovacuum không kịp đóng băng (freeze) các dòng cũ và tuổi giao dịch chạm đỉnh, PostgreSQL sẽ từ chối mọi lệnh ghi để tự bảo vệ khỏi hỏng dữ liệu — sự cố tệ nhất có thể xảy ra, chỉ cứu được bằng VACUUM ở chế độ đơn người dùng.
SELECT datname, age(datfrozenxid) AS tuoi_xid
FROM pg_database ORDER BY age(datfrozenxid) DESC;
-- Báo động khi tuoi_xid > ~1 tỷ (nửa giới hạn 2^31)
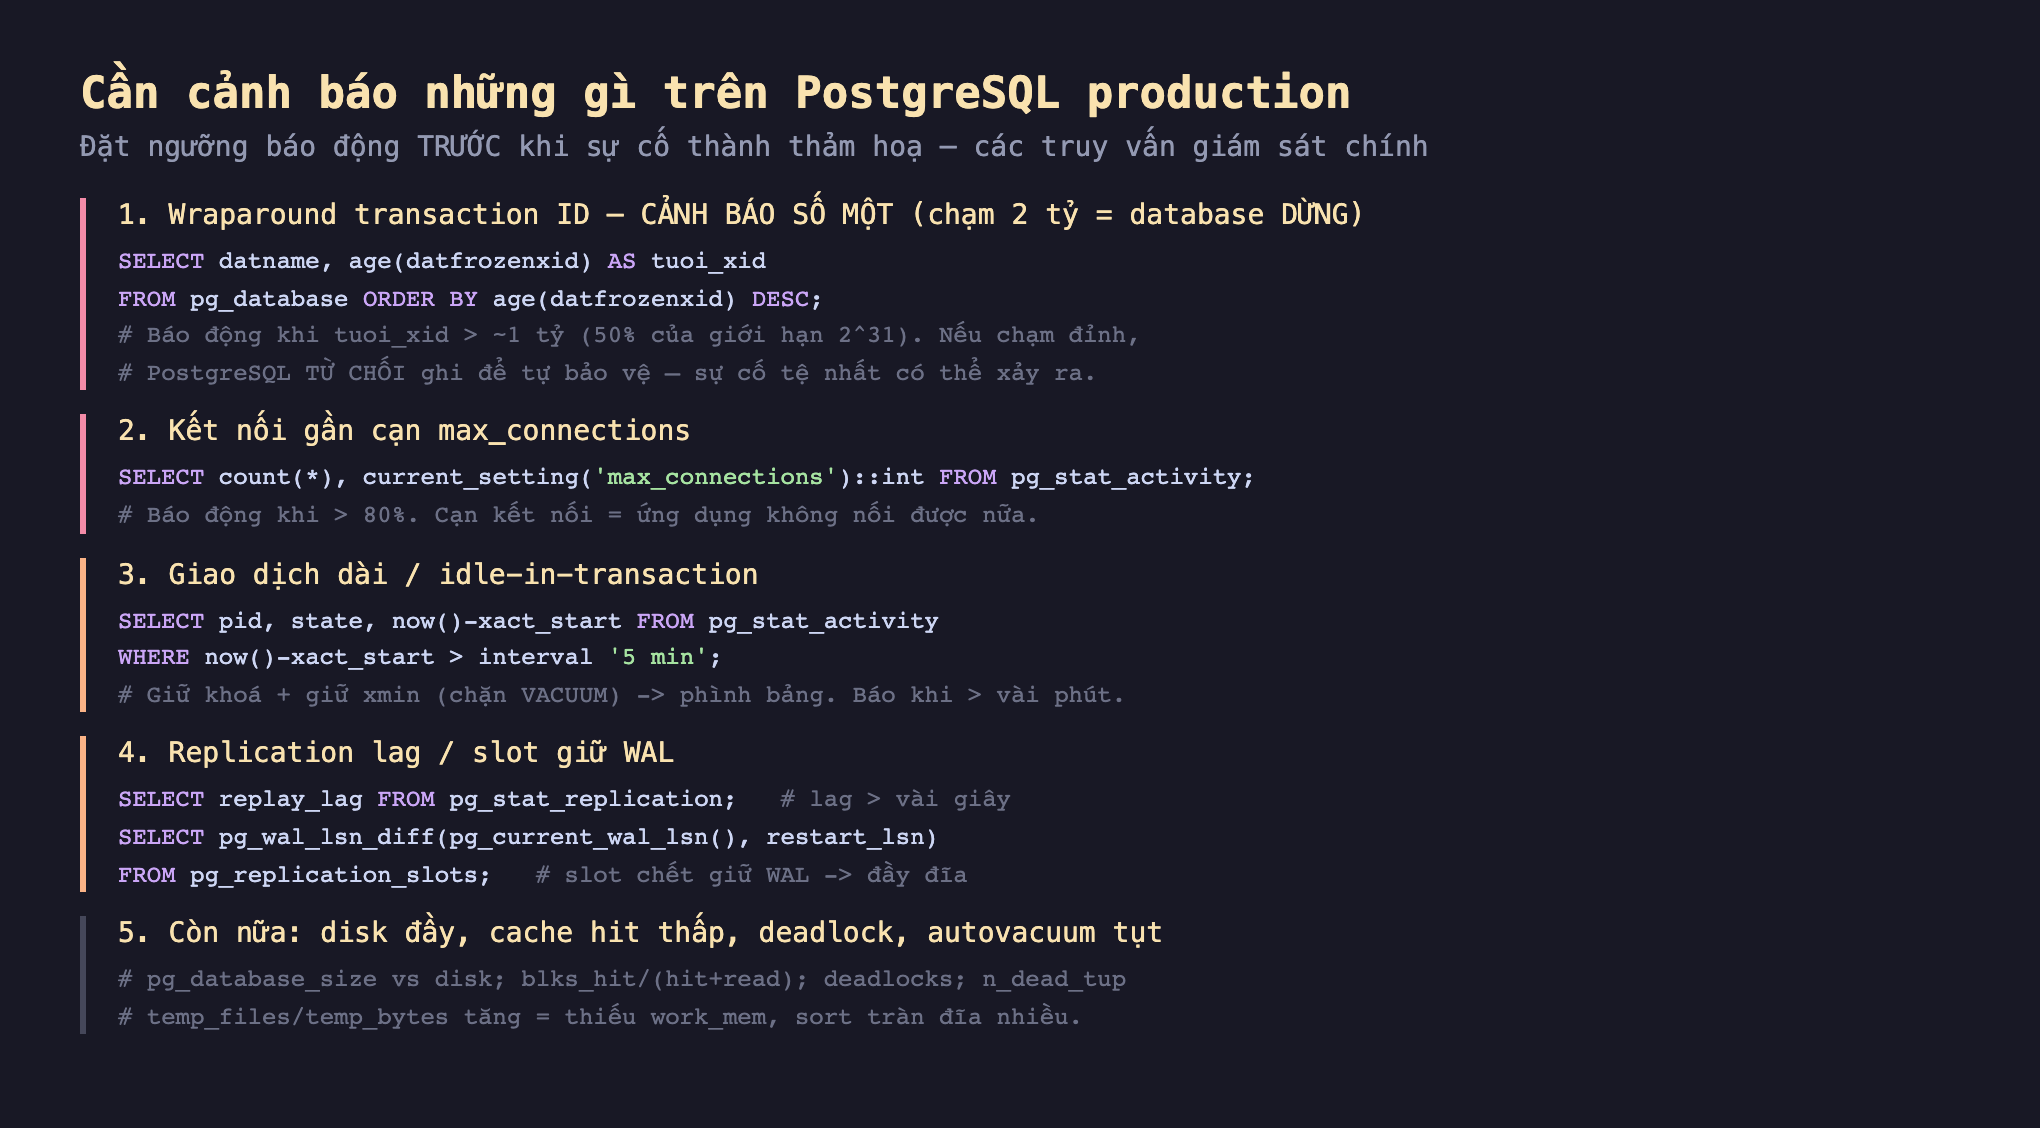
Hình 1: Các truy vấn giám sát chính — wraparound (số một), kết nối gần cạn, giao dịch dài, replication lag/slot giữ WAL, cùng disk/cache/deadlock. Mỗi cái kèm ngưỡng nên báo động.
Đo thật các chỉ số trên một database
Tôi chạy các truy vấn giám sát trên database lab để lấy giá trị thật:
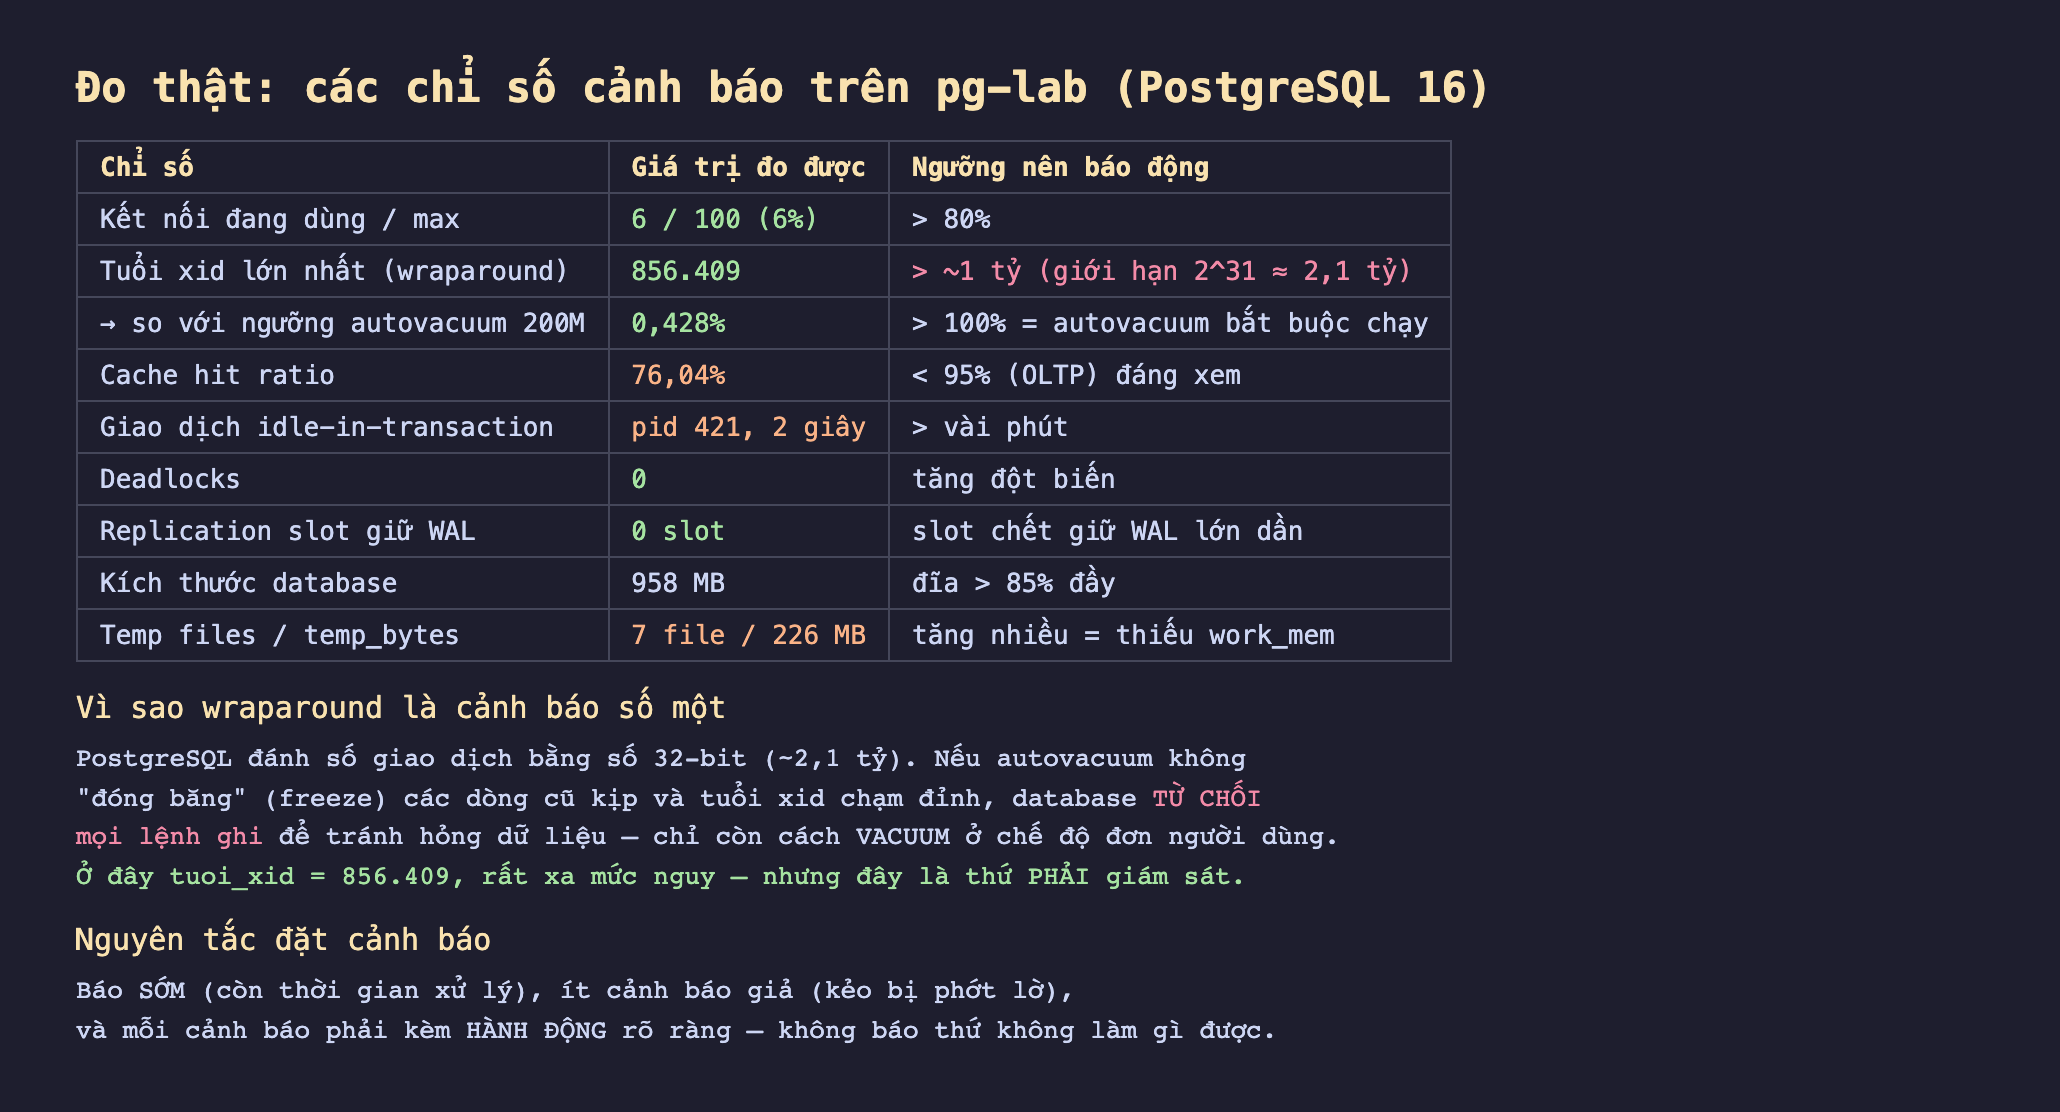
Hình 2: Giá trị thật đo được: 6/100 kết nối, tuổi xid 856.409 (0,428% ngưỡng autovacuum, rất an toàn), cache hit 76%, một idle-in-transaction 2 giây, 0 deadlock, 0 slot, DB 958 MB, 7 temp file 226 MB. Kèm ngưỡng nên báo động cho từng cái.
Đọc bảng theo mức độ ưu tiên:
Wraparound: age(datfrozenxid) lớn nhất là 856.409 — cực kỳ an toàn (0,428% của ngưỡng autovacuum 200 triệu, và chỉ 0,04% của giới hạn cứng 2,1 tỷ). Nhưng đây chính là thứ phải giám sát: nó tăng chậm và âm thầm, chỉ thành thảm hoạ nếu autovacuum bị hỏng lâu ngày mà không ai để ý.
Kết nối: 6/100 (6%). Báo động khi vượt 80% — cạn kết nối nghĩa là ứng dụng không nối được nữa, thường do rò rỉ kết nối hoặc thiếu connection pooler (bài PgBouncer đã bàn).
Giao dịch dài / idle-in-transaction: đo được một phiên idle-in-transaction 2 giây. Báo động khi vượt vài phút — nó giữ khoá và giữ xmin (chặn VACUUM), làm phình bảng như các bài trước đã đo.
Cache hit ratio: 76% — thấp ở lab này do các seq scan lớn tôi chạy trước đó. Với workload OLTP thật, tỷ lệ dưới 95-99% đáng xem (thiếu RAM). Đây là cảnh báo "mềm" — cần xem xu hướng chứ không báo động ngay.
Replication slot: 0 slot. Nếu có slot mà standby chết, slot sẽ giữ WAL vô hạn và làm đầy đĩa — cần cảnh báo khi WAL bị giữ vượt ngưỡng. Deadlocks và temp_files (7 file, 226 MB từ các sort tràn đĩa) là các chỉ số phụ nên theo dõi xu hướng.
Nguyên tắc đặt cảnh báo
Ba nguyên tắc phân biệt hệ thống cảnh báo tốt với hệ thống gây nhiễu:
Báo sớm, khi còn thời gian xử lý. Cảnh báo "đĩa đã đầy 100%" là vô dụng — lúc đó đã sự cố rồi. Báo ở 85% để còn kịp dọn. Wraparound báo ở 1 tỷ (còn cả tỷ giao dịch để chạy VACUUM), không đợi tới 2 tỷ.
Ít cảnh báo giả. Một cảnh báo kêu suốt vì ngưỡng quá nhạy sẽ bị team tắt tiếng, rồi bỏ lỡ cái thật. Đặt ngưỡng đủ cao và thêm điều kiện thời gian (ví dụ "cache hit dưới 90% liên tục 15 phút") để tránh báo động vì một đỉnh nhất thời.
Mỗi cảnh báo kèm hành động. Đừng cảnh báo thứ bạn không làm gì được. Mỗi cảnh báo nên trả lời được "khi cái này kêu, tôi phải làm gì?" — nếu không có câu trả lời, đừng đặt nó.
Đánh đổi cần cân nhắc
Không có ngưỡng đúng cho mọi hệ thống. Cache hit 76% là báo động với một OLTP nhỏ nhưng bình thường với một data warehouse chuyên quét lớn. max_connections 80% nguy với setup không pooler nhưng OK nếu có PgBouncer đệm. Ngưỡng phải hiệu chỉnh theo chính hệ thống của bạn — dùng con số trong bài làm điểm khởi đầu, không phải luật cứng.
Giám sát tốn tài nguyên và cần bảo trì. Mỗi truy vấn giám sát chạy định kỳ tốn một chút; một số (như đếm bloat trên bảng khổng lồ) khá nặng. Cân tần suất kiểm với chi phí. Và bản thân hệ thống giám sát cũng cần được giám sát — một collector chết âm thầm khiến bạn "mù" mà không biết.
Cảnh báo là lớp cuối, không thay cho thiết kế đúng. Cảnh báo wraparound quan trọng, nhưng tốt hơn là đảm bảo autovacuum khoẻ mạnh để nó không bao giờ gần ngưỡng. Cảnh báo kết nối cạn quan trọng, nhưng tốt hơn là có pooler. Cảnh báo bắt sự cố; thiết kế đúng ngăn sự cố.
Ba ý mang về
- Wraparound transaction ID là cảnh báo số một: nếu tuổi giao dịch chạm giới hạn 32-bit (~2,1 tỷ) mà autovacuum không đóng băng kịp, PostgreSQL từ chối mọi lệnh ghi — đo thật
age(datfrozenxid)= 856.409 (rất an toàn) nhưng phải giám sát vì nó tăng âm thầm, báo động ở ~1 tỷ. - Các chỉ số cần cảnh báo còn lại: kết nối gần cạn max_connections (>80%), giao dịch idle-in-transaction quá lâu (giữ khoá + chặn VACUUM), replication lag/slot giữ WAL (đầy đĩa), disk đầy, cùng cache hit thấp/deadlock/temp file như cảnh báo mềm theo xu hướng — tất cả đo được bằng các view
pg_stat_*. - Ba nguyên tắc: báo sớm (còn thời gian xử lý), ít cảnh báo giả (kẻo bị phớt lờ), mỗi cảnh báo kèm hành động rõ ràng — và nhớ ngưỡng phải hiệu chỉnh theo từng hệ thống, cảnh báo là lớp cuối chứ không thay cho thiết kế đúng (autovacuum khoẻ, có pooler).
Phần sau ta tổng hợp mọi công cụ đã học vào một quy trình thực chiến: Phần sau chẩn đoán một truy vấn chậm từ A đến Z — từ phát hiện, đọc EXPLAIN, tìm nguyên nhân, tới sửa và xác nhận, dùng đúng các công cụ cả series đã dựng.
