Hai bài trước dựng nên bài toán: mỗi kết nối tốn chi phí thiết lập (~18× khi mở lại) và throughput sập nếu quá nhiều kết nối hoạt động. PgBouncer là câu trả lời kinh điển. Bài này không chỉ nói lý thuyết — tôi cài PgBouncer thật, đặt trước pg-lab, và đo hai giá trị nó mang lại bằng chính pgbench.
PgBouncer làm gì
PgBouncer là một lớp pooler rất nhẹ (một tiến trình đơn, dùng event loop) đứng giữa ứng dụng và PostgreSQL. Ứng dụng kết nối tới PgBouncer thay vì tới PostgreSQL trực tiếp; PgBouncer giữ một pool nhỏ các kết nối thật tới PostgreSQL và cho hàng trăm client dùng chung, luân phiên.
[databases]
lab = host=127.0.0.1 port=5432 dbname=lab
[pgbouncer]
listen_port = 6432
pool_mode = transaction     # trả kết nối server về pool sau MỖI giao dịch
default_pool_size = 20      # chỉ 20 kết nối thật tới PostgreSQL
max_client_conn = 1000      # chấp nhận tới 1000 client
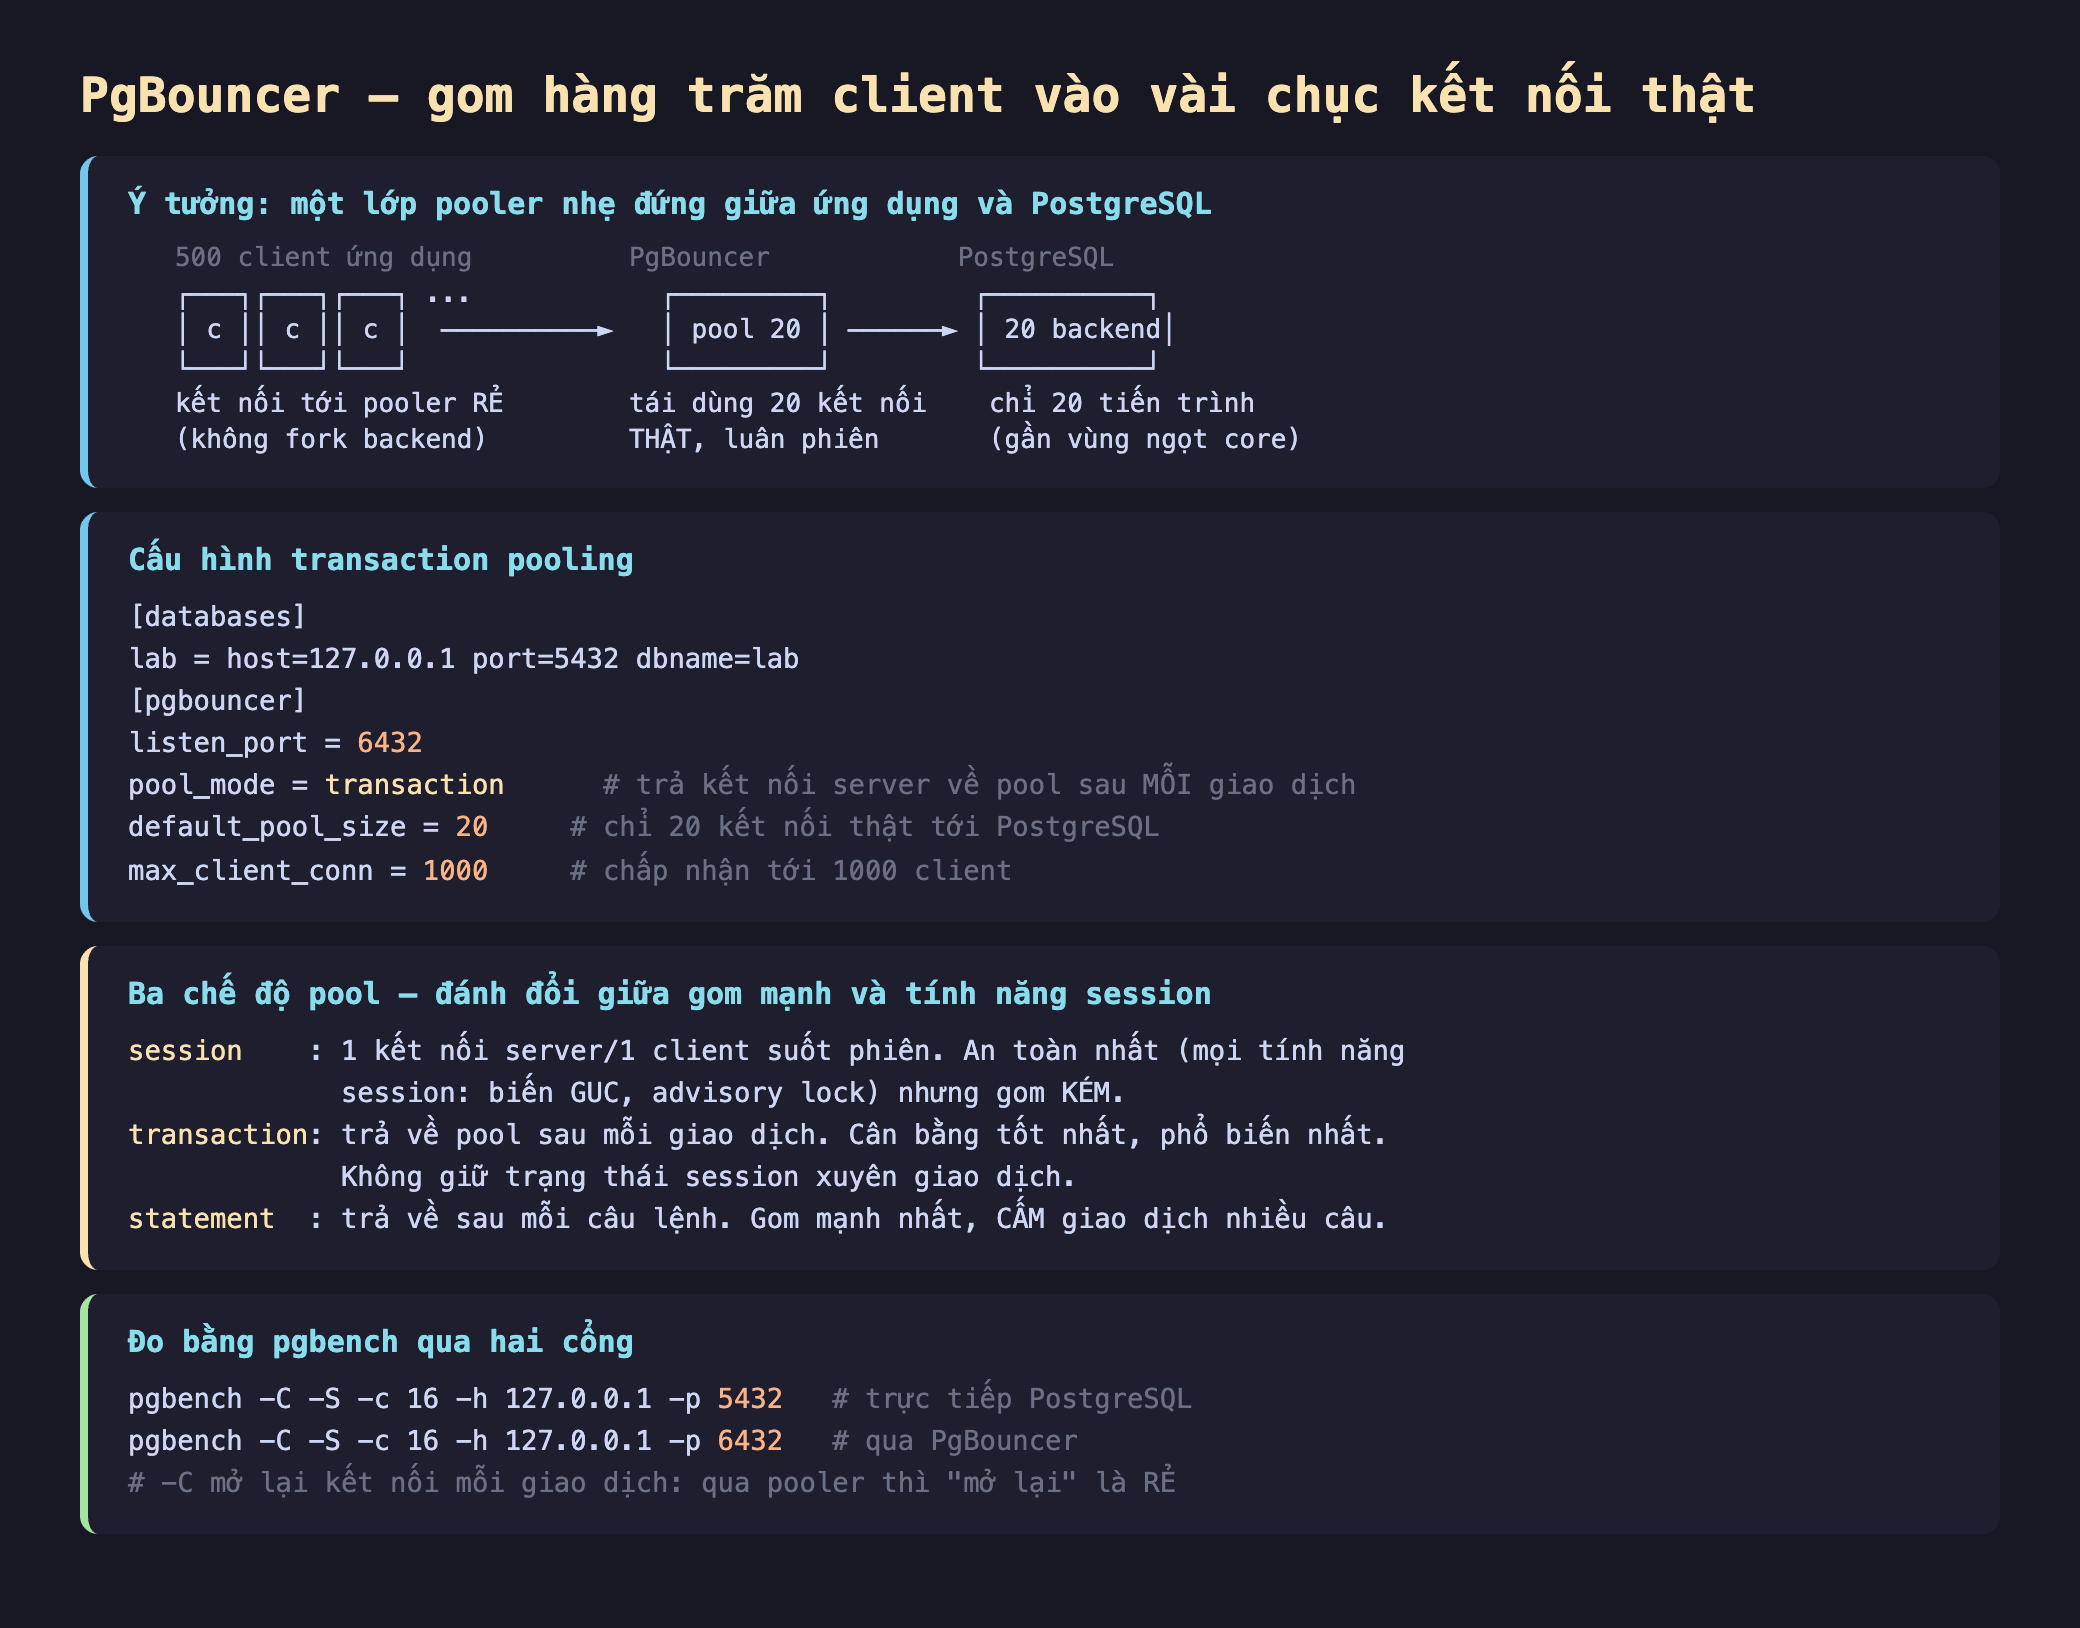
Hình 1: PgBouncer gom hàng trăm client vào một pool nhỏ (20) các kết nối thật tới PostgreSQL. Cấu hình transaction pooling; ba chế độ pool (session/transaction/statement) đánh đổi giữa gom mạnh và giữ tính năng session.
Đo thật giá trị 1: hấp thụ chi phí mở lại kết nối
Bài trước đo thấy mở lại kết nối cho mỗi giao dịch rất đắt. PgBouncer hấp thụ điều đó: client mở lại kết nối tới pooler (rẻ, không fork backend), còn kết nối thật tới PostgreSQL được tái dùng. Chạy pgbench -C (mở lại mỗi giao dịch) qua hai cổng:
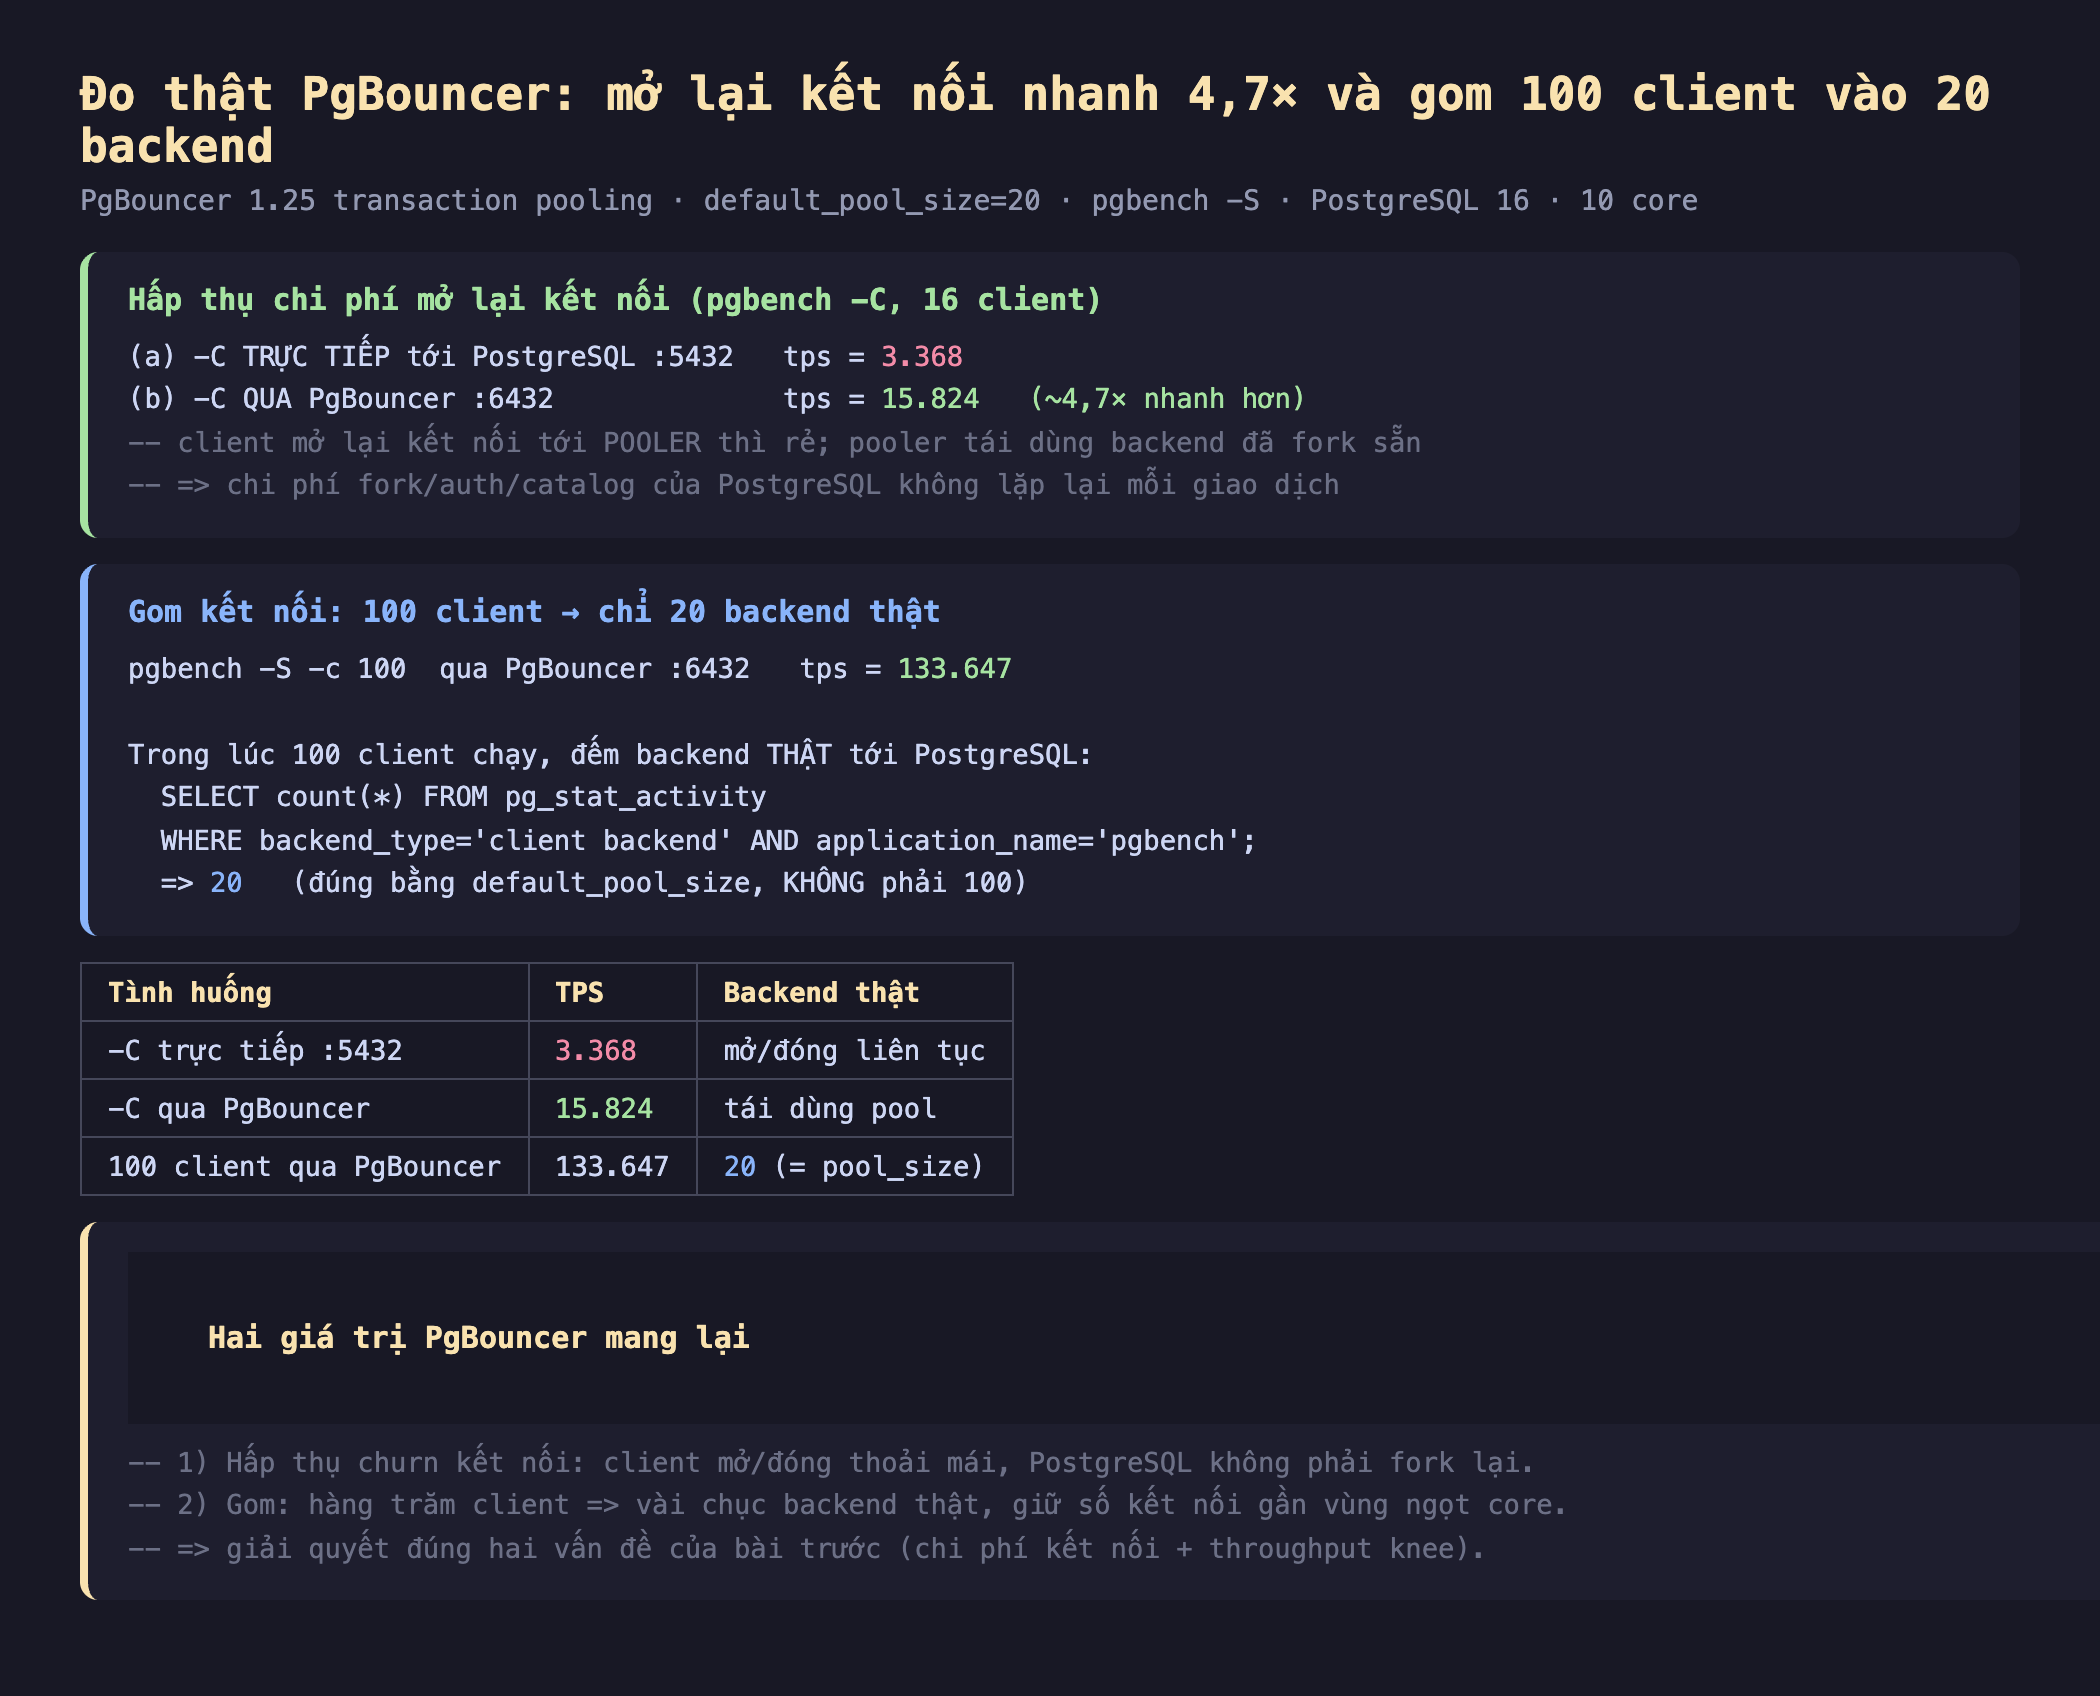
Hình 2: pgbench -C (mở lại mỗi giao dịch) trực tiếp tới PostgreSQL cho 3.368 TPS; qua PgBouncer cho 15.824 TPS — nhanh ~4,7 lần. Và 100 client qua PgBouncer chỉ tạo 20 backend thật (đúng bằng pool_size), vẫn đạt 133.647 TPS.
-Ctrực tiếp tới PostgreSQL (:5432): 3.368 TPS.-Cqua PgBouncer (:6432): 15.824 TPS — nhanh ~4,7 lần.
Vì sao? Khi client mở lại kết nối, nó chỉ mở lại tới PgBouncer — một thao tác rẻ vì PgBouncer không fork tiến trình mới. Kết nối thật tới PostgreSQL (đã fork, đã nạp catalog) được giữ trong pool và tái dùng. Chi phí đắt của PostgreSQL chỉ trả một lần lúc pool khởi tạo, không lặp lại mỗi giao dịch.
Đo thật giá trị 2: gom trăm client vào vài chục backend
Đây là giá trị quan trọng hơn. Tôi chạy 100 client đồng thời qua PgBouncer (pool_size=20), rồi trong lúc đó đếm số backend thật tới PostgreSQL:
SELECT count(*) FROM pg_stat_activity
WHERE backend_type='client backend' AND application_name='pgbench';
-- => 20  (đúng bằng default_pool_size, KHÔNG phải 100)
100 client, nhưng chỉ 20 kết nối thật tới PostgreSQL — và vẫn đạt 133.647 TPS. PgBouncer đã "gom" 100 client vào đúng 20 backend, giữ số kết nối hoạt động gần vùng ngọt số core (như bài max_connections đã đo). Đây chính là cách phục vụ 500 hay 1000 client ứng dụng mà không đặt max_connections=500: đặt PgBouncer với pool_size hợp lý (~2-4× số core).
Hai giá trị này giải quyết đúng hai vấn đề của các bài trước: chi phí thiết lập kết nối và đường cong throughput sập khi quá nhiều kết nối.
Ba chế độ pooling
PgBouncer có ba pool_mode, đánh đổi giữa gom mạnh và giữ tính năng session:
- session: mỗi client giữ một kết nối server suốt phiên của nó. An toàn nhất — hỗ trợ mọi tính năng session (biến GUC
SET, advisory lock, prepared statement session-level). Nhưng gom kém: nếu client giữ kết nối lâu mà không làm gì, kết nối server vẫn bị chiếm. - transaction (tôi dùng ở trên): trả kết nối server về pool sau mỗi giao dịch. Cân bằng tốt nhất và phổ biến nhất — client chỉ chiếm backend khi đang trong giao dịch. Đánh đổi: không giữ được trạng thái session xuyên giao dịch (biến
SETphiên, một số kiểu prepared statement). - statement: trả về pool sau mỗi câu lệnh. Gom mạnh nhất nhưng cấm giao dịch nhiều câu — rất ít dùng.
Với hầu hết ứng dụng web, transaction pooling là lựa chọn đúng.
Đánh đổi cần cân nhắc
Transaction pooling phá vỡ một số tính năng session. Vì kết nối server bị luân chuyển giữa các client sau mỗi giao dịch, các thứ bám vào session cụ thể sẽ hỏng: SET biến phiên (dùng SET LOCAL trong giao dịch thay thế), advisory lock kiểu session, LISTEN/NOTIFY, và prepared statement kiểu cũ. PgBouncer 1.21+ có hỗ trợ prepared statement ở tầng protocol trong transaction mode, nhưng vẫn cần kiểm ứng dụng/driver. Nếu ứng dụng phụ thuộc nặng vào trạng thái session, dùng session pooling (đổi lại gom kém hơn).
PgBouncer là điểm lỗi đơn — cần tính sẵn dự phòng. Mọi kết nối đi qua nó, nên nó sập là cả ứng dụng mất DB. Sản xuất thường chạy nhiều instance PgBouncer sau một load balancer, hoặc mỗi máy ứng dụng một PgBouncer cục bộ.
Pool_size vẫn phải tính đúng. PgBouncer không xóa bỏ giới hạn số core — nó chỉ giúp giữ số kết nối thật ở mức tối ưu. Đặt pool_size quá cao thì vẫn dẫn tới throughput knee; quá thấp thì client phải xếp hàng chờ. Ngắm quanh 2-4× số core, và đo.
Ba ý mang về
- PgBouncer hấp thụ chi phí thiết lập kết nối: đo thật, mở lại kết nối mỗi giao dịch qua PgBouncer cho 15.824 TPS so với 3.368 TPS trực tiếp — nhanh ~4,7 lần, vì client mở lại tới pooler (rẻ) còn backend PostgreSQL đã fork được tái dùng.
- PgBouncer gom hàng trăm client vào vài chục backend thật: đo thật, 100 client qua PgBouncer chỉ tạo 20 kết nối thật (đúng bằng pool_size) — đây là cách phục vụ nhiều client mà không đặt max_connections cao, giữ số kết nối gần vùng ngọt số core.
- Transaction pooling là lựa chọn phổ biến nhất: cân bằng tốt giữa gom mạnh và tính năng, nhưng phá vỡ trạng thái session xuyên giao dịch (dùng SET LOCAL, kiểm prepared statement) — và nhớ PgBouncer là điểm lỗi đơn cần dự phòng.
Phần sau ta xét một cơ chế tăng tốc truy vấn lặp lại, liên quan trực tiếp tới pooling: Phần sau mổ xẻ prepared statement và plan cache — cách PostgreSQL tái dùng kế hoạch truy vấn, generic plan vs custom plan, và tương tác với transaction pooling.
