Prepared statement (PREPARE/EXECUTE) là cách chuẩn để tái dùng một truy vấn tham số hóa — vừa chống SQL injection, vừa bỏ qua công đoạn phân tích cú pháp và lập kế hoạch mỗi lần chạy. Nhưng phần "bỏ qua lập kế hoạch" ẩn một cái bẫy tinh vi: PostgreSQL có thể chuyển sang generic plan — một kế hoạch chung dùng cho mọi giá trị tham số — và trên dữ liệu lệch, kế hoạch chung đó có thể sai nghiêm trọng. Bài này đo thật cả lợi ích lẫn cái bẫy.
Prepared statement làm gì
Khi bạn PREPARE một truy vấn rồi EXECUTE nhiều lần, PostgreSQL không phải phân tích cú pháp và lập kế hoạch lại mỗi lần — nó tái dùng kế hoạch đã cache:
PREPARE q(int) AS SELECT ... WHERE grp=$1;
EXECUTE q(100);   -- lần sau chỉ EXECUTE, không parse/plan lại
Phần tiết kiệm là Planning Time (thời gian lập kế hoạch). Với truy vấn cực đơn giản (tra khóa chính một dòng), phần này vốn đã rất nhỏ nên tái dùng gần như không đo được lợi — đo thật pgbench -M simple (239k TPS) so với -M prepared (234k) gần như bằng nhau vì query của pgbench quá đơn giản. Nhưng với truy vấn phức tạp nhiều JOIN, Planning Time có thể lên vài mili-giây, và tái dùng plan lúc đó rất đáng giá.
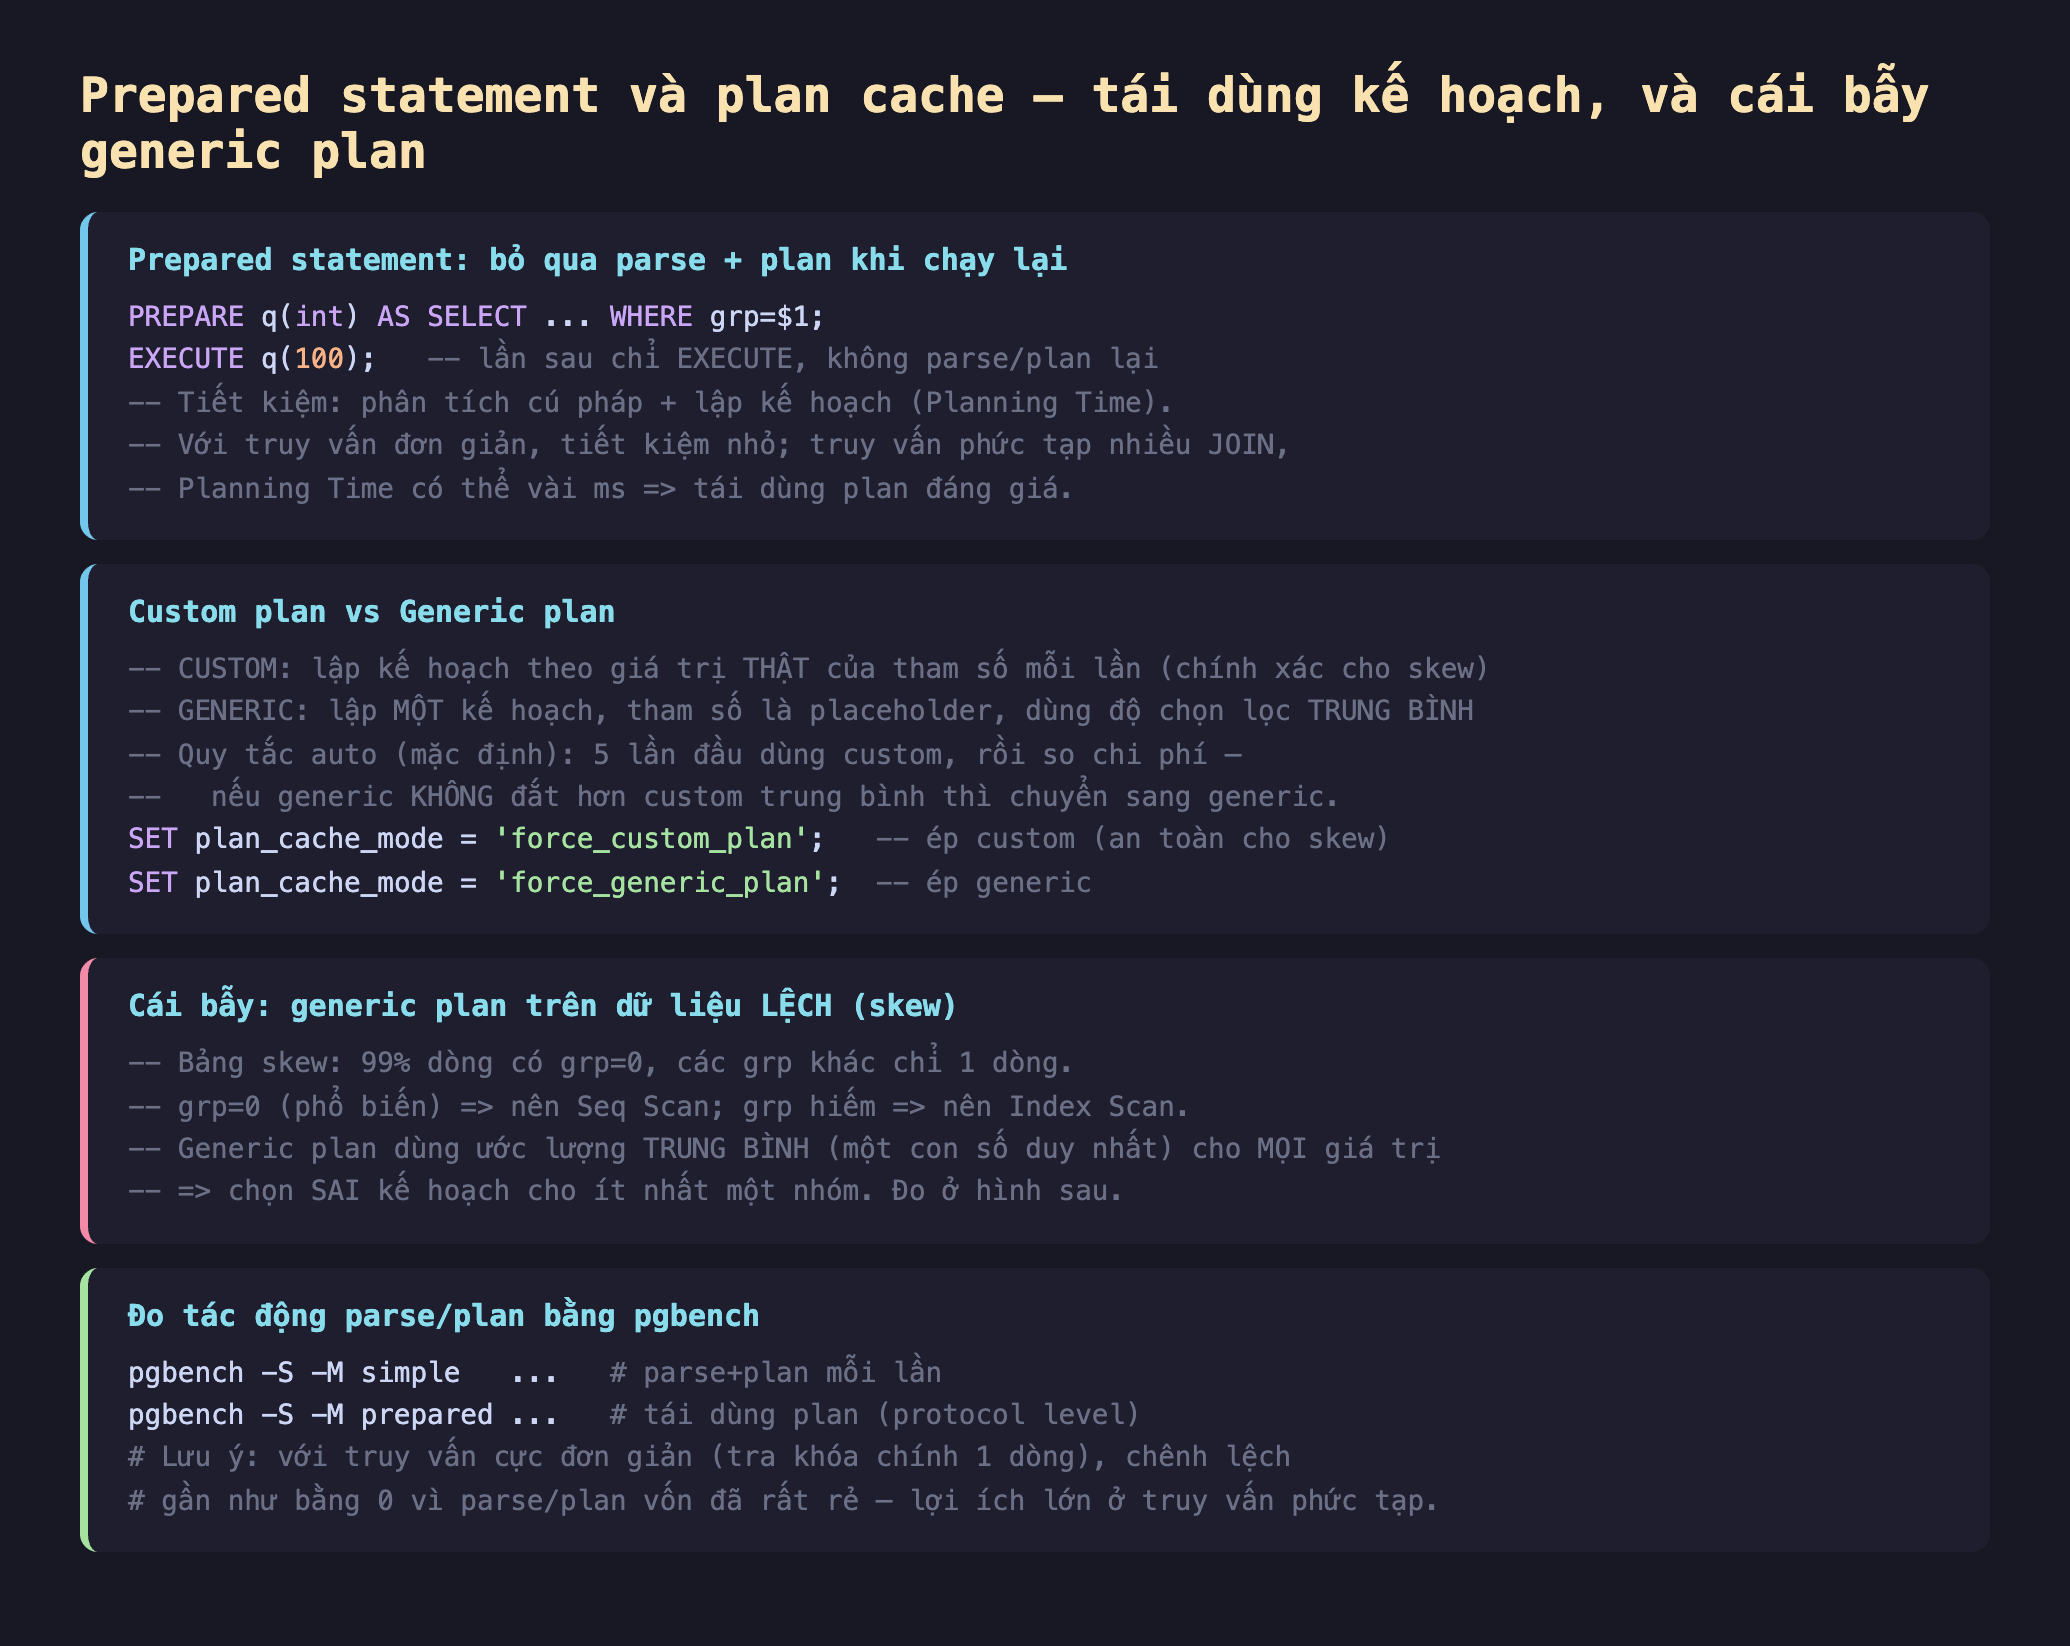
Hình 1: Prepared statement bỏ qua parse+plan khi chạy lại. PostgreSQL chọn giữa custom plan (lập theo giá trị thật mỗi lần) và generic plan (một kế hoạch dùng ước lượng trung bình). Cơ chế auto: 5 lần đầu custom, rồi có thể chuyển generic.
Đo thật: generic plan ước lượng sai 313 lần
Để lộ cái bẫy, tôi dựng bảng skew 2 triệu dòng cực lệch: 99% số dòng có grp=0, còn các giá trị grp khác mỗi cái chỉ 1 dòng. Với truy vấn WHERE grp=$1:
grp=0(phổ biến, 1,98 triệu dòng) → kế hoạch đúng là Seq Scan (index vô dụng khi lấy gần hết bảng).grphiếm (1 dòng) → kế hoạch đúng là Index Scan.
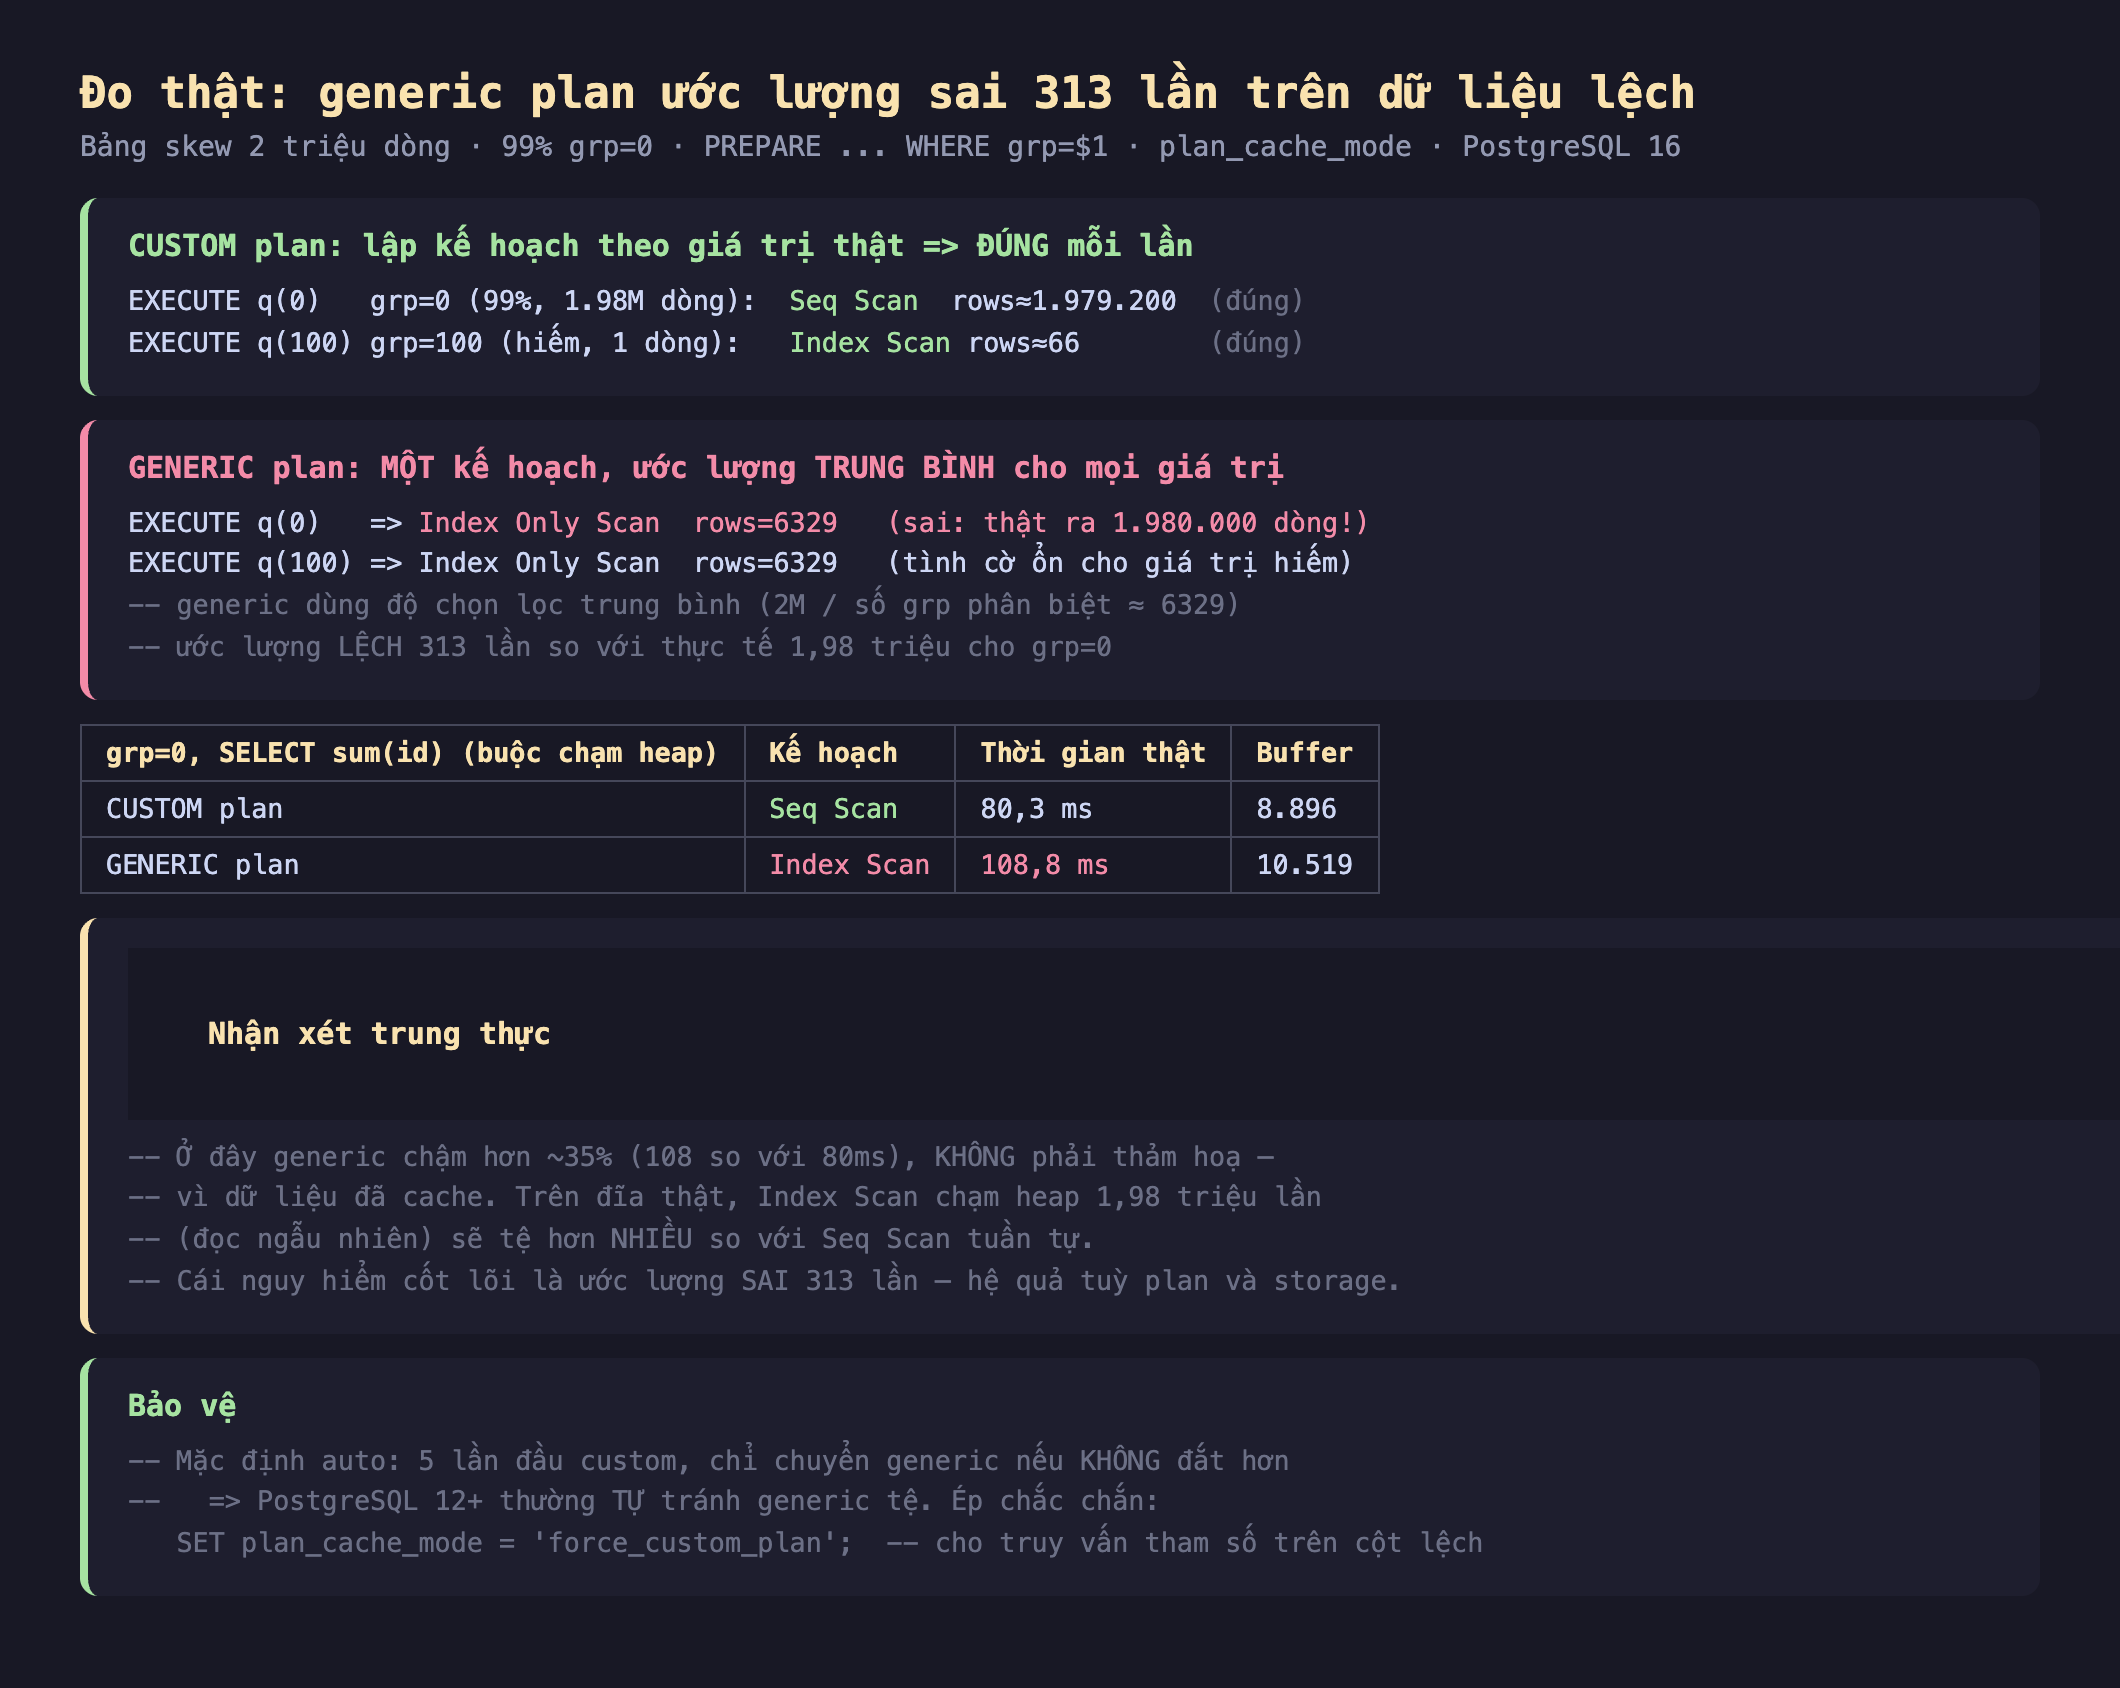
Hình 2: Custom plan chọn đúng (Seq Scan cho grp=0, Index Scan cho grp hiếm). Generic plan dùng một ước lượng trung bình 6329 dòng cho mọi giá trị — sai 313 lần so với thực tế 1,98 triệu của grp=0. Đo thời gian: generic (Index Scan) 108,8 ms so với custom (Seq Scan) 80,3 ms.
- Custom plan:
EXECUTE q(0)→ Seq Scan (ước lượng ~1.979.200 dòng, đúng);EXECUTE q(100)→ Index Scan (ước lượng ~66, đúng). Mỗi lần lập kế hoạch theo giá trị thật nên chọn đúng. - Generic plan: cả
q(0)lẫnq(100)đều dùng Index Only Scan với ước lượng 6329 dòng — con số "trung bình" (2 triệu chia cho số giá trị grp phân biệt). Vớigrp=0, ước lượng này lệch 313 lần so với thực tế 1,98 triệu dòng.
Đo thời gian thật cho grp=0 với SELECT sum(id) (buộc chạm heap): custom plan (Seq Scan) mất 80,3 ms, generic plan (Index Scan) mất 108,8 ms — chậm hơn ~35% và chạm nhiều buffer hơn.
Nhận xét trung thực và cách bảo vệ
Ở lab này, generic plan chỉ chậm hơn ~35%, không phải thảm họa — vì dữ liệu đã nằm trong cache. Trên đĩa thật với cache nguội, Index Scan phải chạm heap 1,98 triệu lần bằng đọc ngẫu nhiên, sẽ tệ hơn nhiều so với Seq Scan tuần tự. Cái nguy hiểm cốt lõi là ước lượng sai 313 lần; hệ quả cụ thể tệ đến đâu tùy vào plan được chọn và loại storage.
Tin tốt: PostgreSQL bảo vệ bạn khá tốt theo mặc định. Với plan_cache_mode='auto' (mặc định), PostgreSQL dùng custom plan cho 5 lần EXECUTE đầu, rồi mới so sánh chi phí generic với chi phí custom trung bình — và chỉ chuyển sang generic nếu generic không đắt hơn. Nhờ vậy PostgreSQL 12+ thường tự tránh generic plan tệ. Khi bạn muốn chắc chắn (truy vấn tham số trên cột lệch quan trọng):
SET plan_cache_mode = 'force_custom_plan'; -- luôn lập kế hoạch theo giá trị thật
Đánh đổi cần cân nhắc
Generic plan không xấu — nó tiết kiệm lập kế hoạch cho dữ liệu phân bố đều. Với cột phân bố đồng đều (không lệch), generic plan cho kết quả gần như custom mà bỏ được chi phí lập kế hoạch lặp lại. force_custom_plan đánh đổi bằng việc lập kế hoạch lại mỗi lần — tốn CPU hơn cho truy vấn phức tạp. Chỉ ép custom khi dữ liệu thật sự lệch.
Prepared statement tương tác với connection pooling. Như bài PgBouncer đã nhắc: prepared statement kiểu server-side gắn với một backend cụ thể. Trong transaction pooling, mỗi giao dịch có thể rơi vào backend khác nên prepared statement "biến mất". PgBouncer 1.21+ hỗ trợ protocol-level prepared statement trong transaction mode, nhưng phải kiểm driver. Nếu dùng pool, cân nhắc tắt prepared ở tầng driver hoặc dùng session pooling.
Đây là nguồn gốc của "truy vấn nhanh rồi bỗng chậm". Một triệu chứng kinh điển: truy vấn tham số chạy nhanh vài lần đầu (custom plan) rồi đột ngột chậm ở lần thứ 6+ (chuyển sang generic plan tệ). Nếu gặp, kiểm plan_cache_mode và cân nhắc force_custom_plan.
Ba ý mang về
- Prepared statement bỏ qua parse+plan khi chạy lại — tiết kiệm Planning Time (nhỏ với truy vấn đơn giản, đáng kể với truy vấn phức tạp nhiều JOIN); đo pgbench simple vs prepared gần bằng nhau vì query pgbench quá đơn giản.
- Generic plan dùng ước lượng trung bình, nguy hiểm trên dữ liệu lệch: đo thật, generic plan ước lượng 6329 dòng trong khi grp=0 thực tế có 1,98 triệu — sai 313 lần, chọn Index Scan 108ms thay vì Seq Scan 80ms của custom plan.
- PostgreSQL 12+ tự bảo vệ qua cơ chế auto (5 lần đầu custom, chỉ chuyển generic nếu không đắt hơn) — nhưng với cột lệch quan trọng, ép
plan_cache_mode='force_custom_plan', và nhớ prepared statement tương tác với transaction pooling.
Phần sau ta chuyển sang cơ chế đồng thời cốt lõi: Phần sau mổ xẻ khóa hàng, khóa bảng và advisory lock — các mức khóa PostgreSQL dùng, khi nào chúng chặn nhau, và cách quan sát bằng pg_locks.
