Sang mảng kết nối. Có một câu người ta hay lặp lại: "PostgreSQL không thích nhiều kết nối, mỗi kết nối tốn ~10 MB RAM". Câu này đúng về kết luận nhưng sai về con số — và hiểu sai con số dẫn tới quyết định sai (như tăng max_connections để "cho phép nhiều kết nối"). Bài này đo thật cả mô hình tiến trình lẫn RAM tiêu tốn, và tách bạch con số ảo với con số thật.
Mô hình: mỗi kết nối là một tiến trình
Khác MySQL (một thread cho mỗi kết nối trong cùng tiến trình), PostgreSQL dùng mô hình tiến trình-mỗi-kết-nối: khi một client kết nối, postmaster fork một tiến trình backend hoàn toàn riêng. 60 kết nối nghĩa là 60 tiến trình hệ điều hành mới.
SHOW max_connections;   -- mặc định 100
SELECT count(*) FROM pg_stat_activity WHERE backend_type='client backend';
Đo thật: baseline có 6 tiến trình postgres; sau khi mở 60 kết nối, số tiến trình lên 66 — đúng 60 backend mới. Mỗi tiến trình có không gian địa chỉ riêng, ngăn xếp riêng, và các cache riêng. Đó là gốc rễ của chi phí RAM.
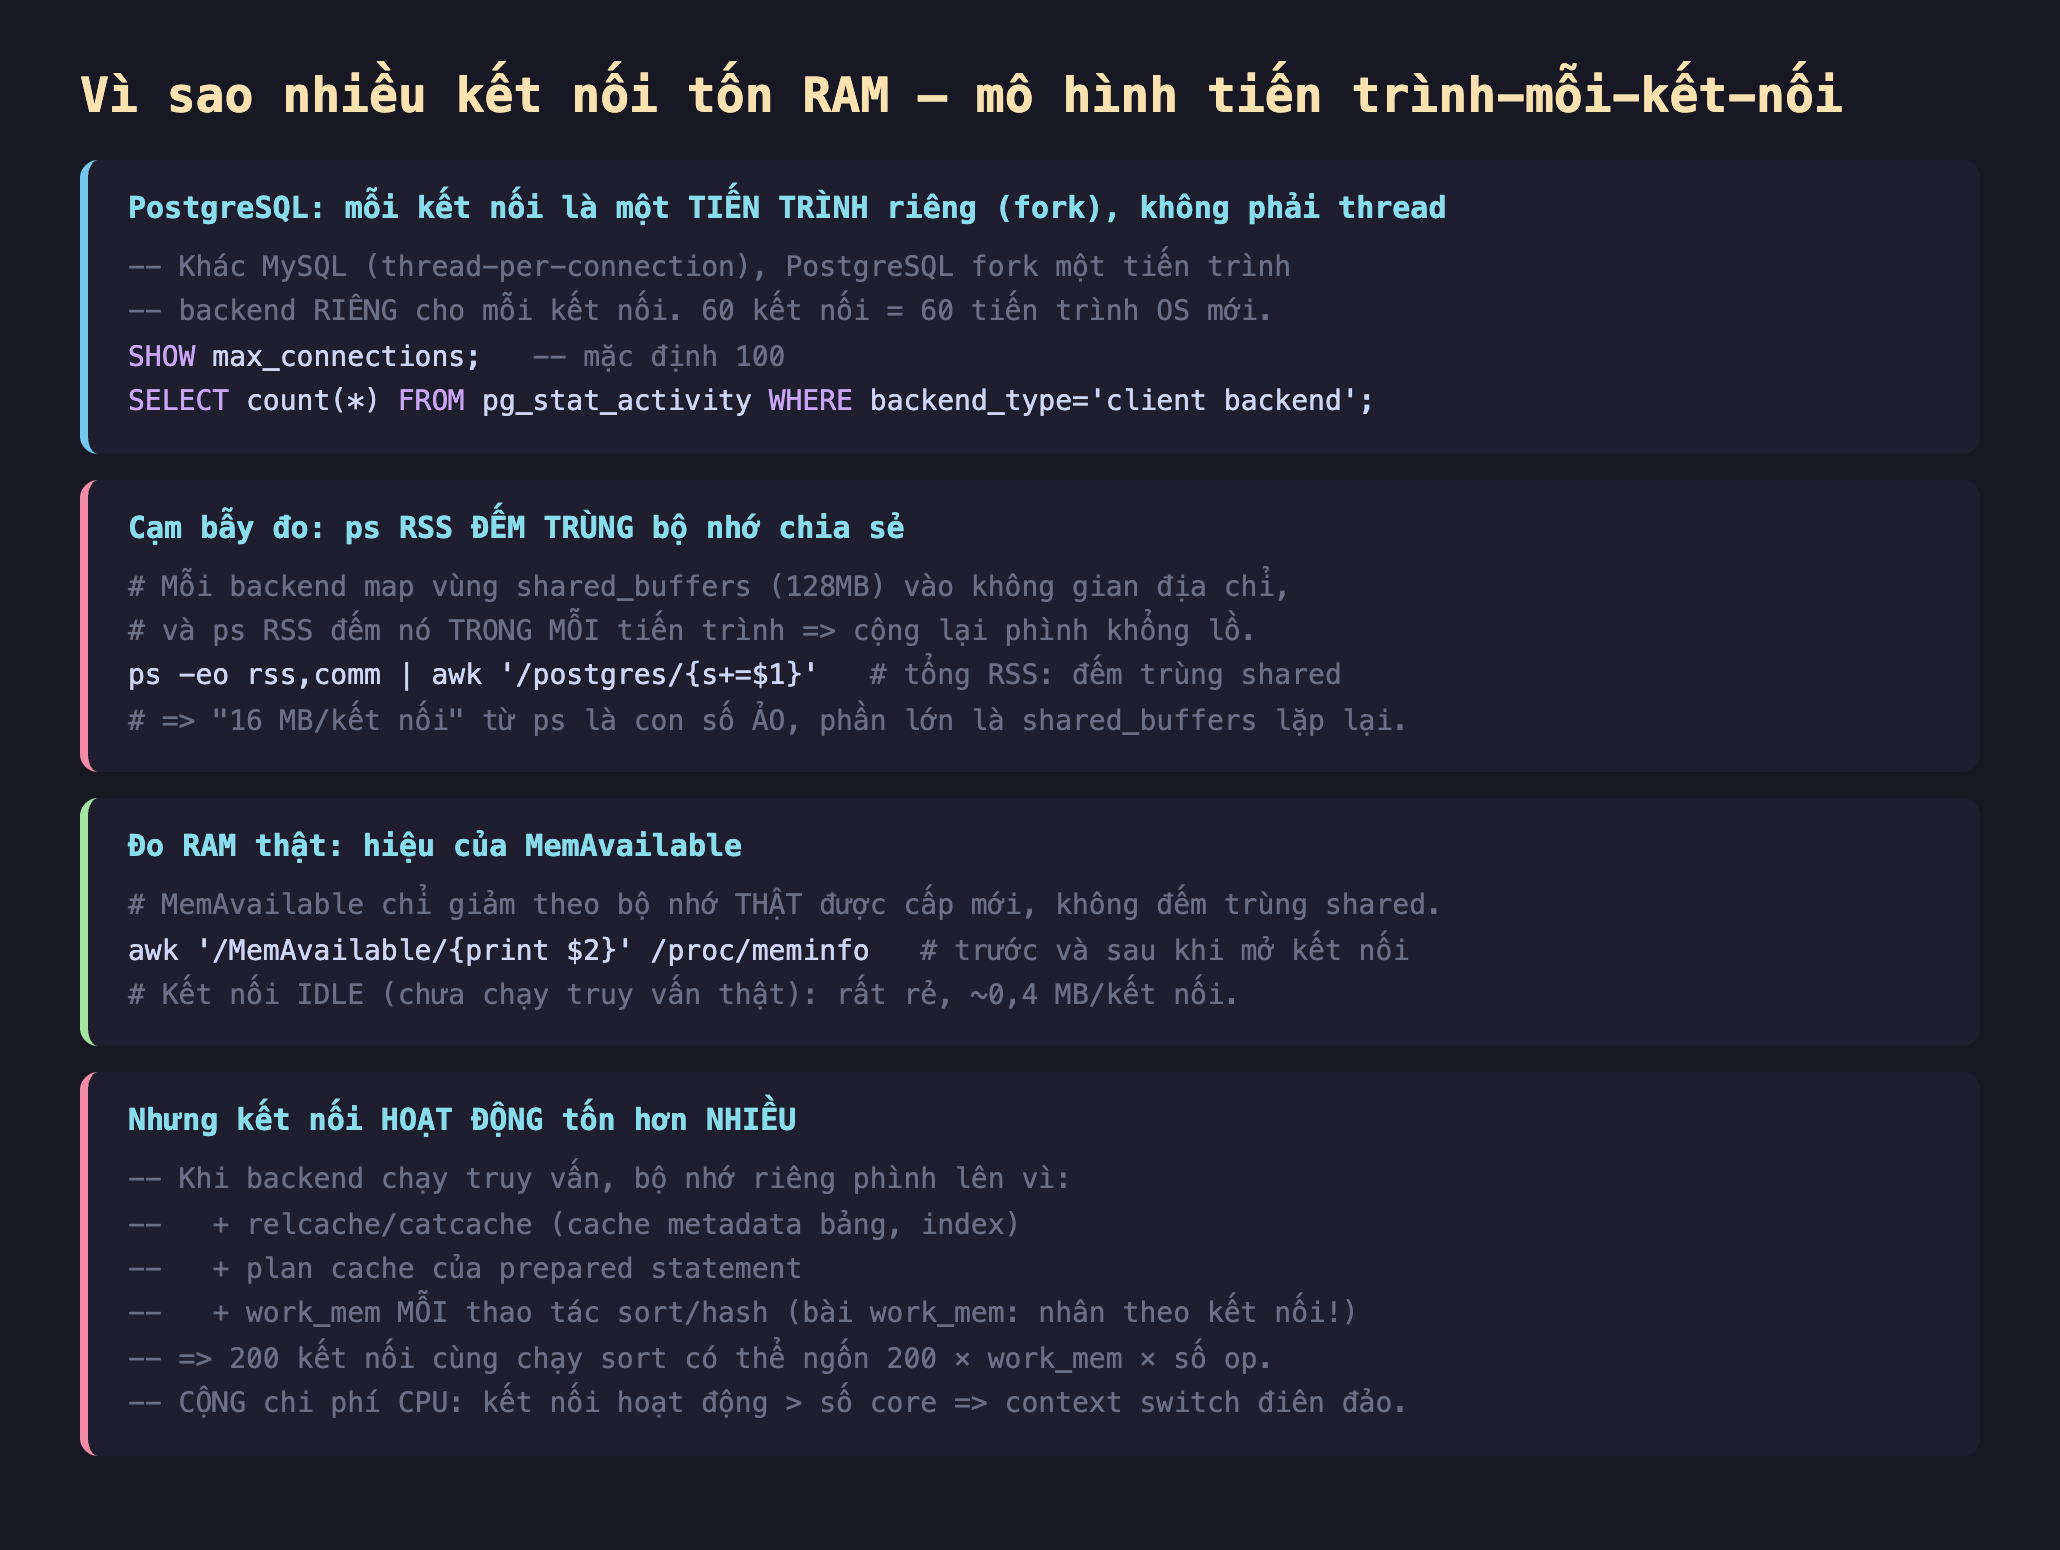
Hình 1: PostgreSQL fork một tiến trình backend riêng cho mỗi kết nối (không phải thread). Đo RAM bằng ps RSS đếm trùng shared_buffers; đo đúng bằng hiệu MemAvailable. Kết nối idle rẻ, nhưng kết nối hoạt động tốn nhiều hơn (caches + work_mem/op) cộng chi phí CPU context switch.
Đo thật: 16 MB/kết nối là con số ảo
Đây là chỗ hầu hết mọi người bị lừa. Cách đo ngây thơ là cộng RSS của tất cả tiến trình postgres qua ps:
ps -eo rss,comm | awk '/postgres/{s+=$1} END{print s/1024 " MB"}'
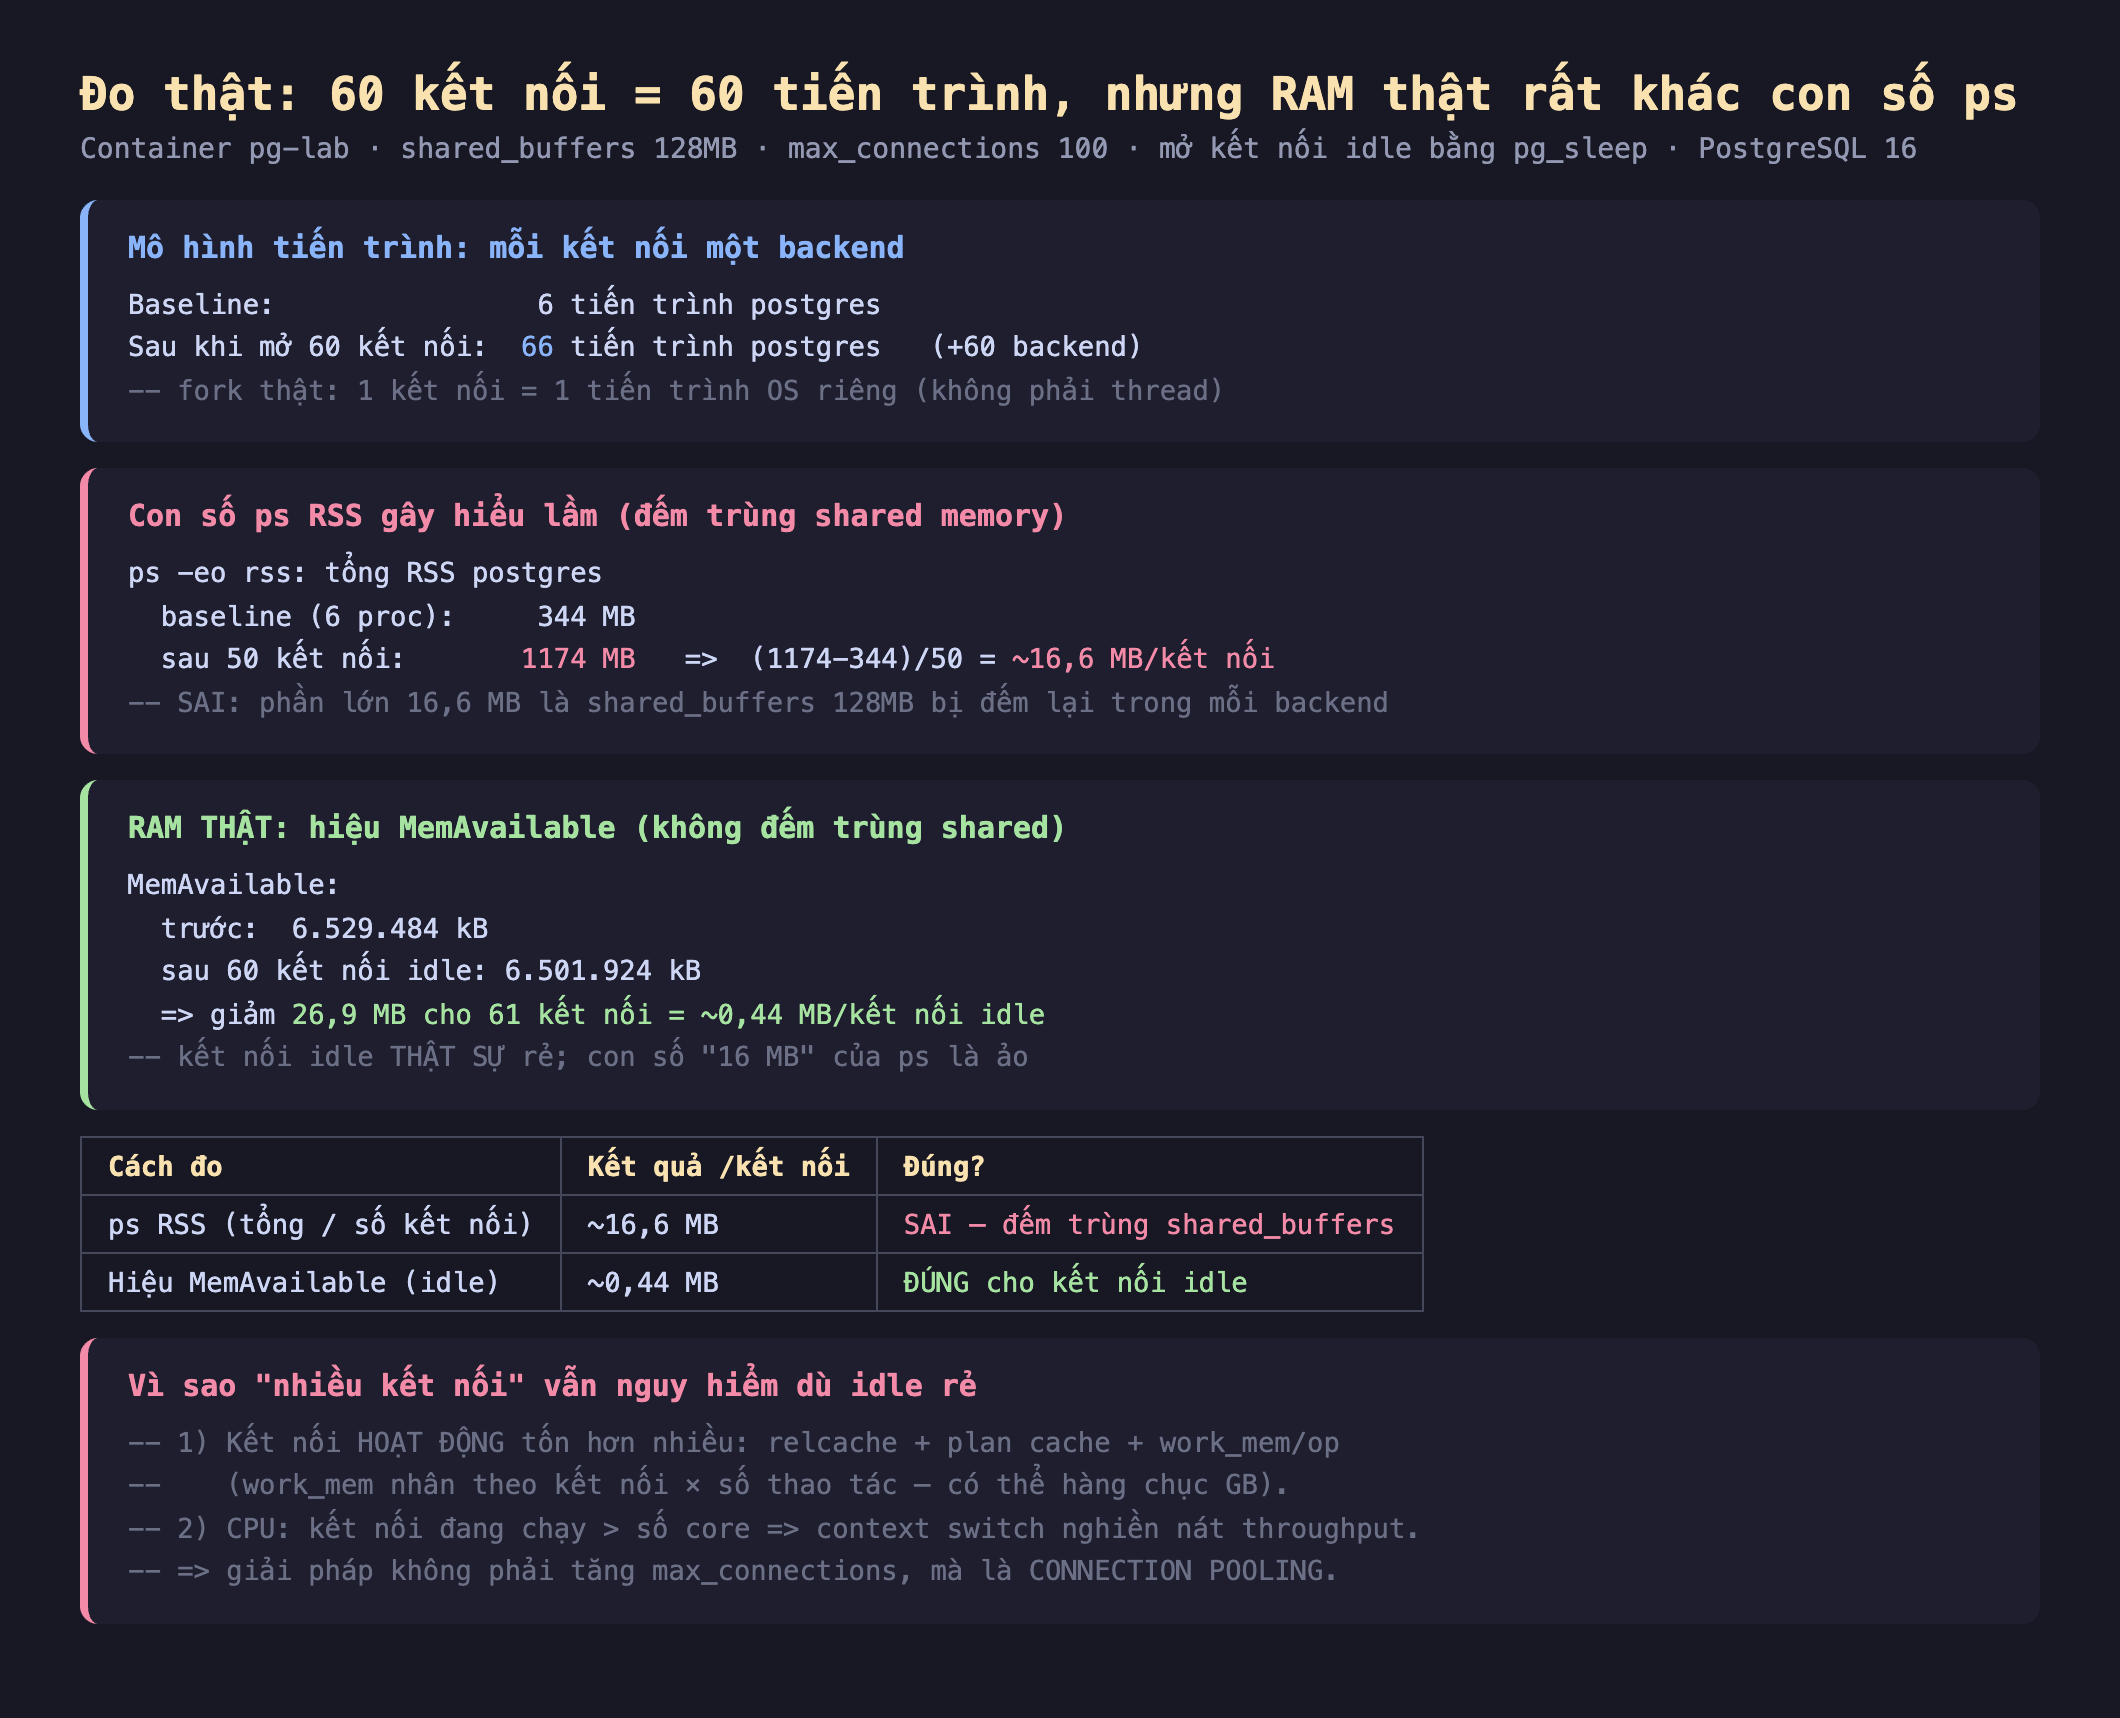
Hình 2: 60 kết nối → 66 tiến trình. ps RSS cho ~16,6 MB/kết nối, nhưng đó là con số sai vì đếm trùng shared_buffers 128MB trong mỗi backend. Hiệu MemAvailable cho RAM thật của kết nối idle chỉ ~0,44 MB. Vấn đề thật nằm ở kết nối hoạt động và context switch.
- ps RSS (con số ảo): tổng RSS từ 344 MB (6 tiến trình) lên 1174 MB sau 50 kết nối → có vẻ 16,6 MB/kết nối. Nhưng RSS đếm cả bộ nhớ chia sẻ (
shared_buffers128MB) mà mỗi backend map vào, nên 128MB đó bị đếm lại 50 lần. Con số 16,6 MB phần lớn là ảo. - Hiệu MemAvailable (con số thật):
MemAvailablechỉ giảm theo bộ nhớ thật được cấp mới, không đếm trùng shared. Trước khi mở kết nối: 6.529.484 kB; sau 60 kết nối idle: 6.501.924 kB → giảm 26,9 MB cho 61 kết nối = ~0,44 MB/kết nối idle.
Kết nối idle thật sự rất rẻ — chưa tới nửa MB. Nếu chỉ có vậy thì "nhiều kết nối" chẳng đáng lo. Vấn đề nằm ở chỗ khác.
Vì sao "nhiều kết nối" vẫn nguy hiểm
1. Kết nối HOẠT ĐỘNG tốn hơn nhiều. Khi backend thực sự chạy truy vấn, bộ nhớ riêng của nó phình lên: relcache/catcache (cache metadata của bảng, index đã dùng), plan cache của prepared statement, và quan trọng nhất — work_mem cho mỗi thao tác sort/hash. Như bài work_mem đã đo, con số này nhân theo số kết nối × số thao tác: 200 kết nối cùng chạy truy vấn có sort có thể ngốn 200 × work_mem × vài op = hàng chục GB. Đây mới là chỗ RAM biến mất thật sự, và nó tỉ lệ với số kết nối đang làm việc, không phải số kết nối idle.
2. Chi phí CPU: context switch. Khi số kết nối đang chạy vượt quá số core CPU, hệ điều hành phải liên tục chuyển ngữ cảnh (context switch) giữa các tiến trình — mỗi lần chuyển tốn CPU cho việc lưu/khôi phục trạng thái và làm nguội cache. Vượt ngưỡng, throughput giảm dù bạn thêm kết nối. Đây là lý do một server 16 core thường xử lý tốt nhất với vài chục kết nối hoạt động, không phải hàng trăm.
Kết luận quan trọng: giải pháp cho "ứng dụng cần 500 kết nối" không phải tăng max_connections lên 500 — mà là connection pooling: một lớp trung gian (PgBouncer, hay pool trong ứng dụng) giữ vài chục kết nối thật tới PostgreSQL và cho hàng trăm client dùng chung. Đó là chủ đề các bài sau.
Đánh đổi cần cân nhắc
Tăng max_connections không "miễn phí" dù kết nối idle rẻ. Mỗi slot kết nối cấp sẵn một ít bộ nhớ cấu trúc trong shared memory (lock table, proc array) ngay khi khởi động, và mở đường cho nguy cơ hàng trăm kết nối cùng hoạt động làm cạn RAM/CPU. Đặt max_connections cao là mời gọi vấn đề, không phải giải quyết nó.
Con số "MB mỗi kết nối" luôn phụ thuộc tải. Đừng trích một con số cố định. Kết nối idle ~0,5 MB; kết nối chạy truy vấn phức tạp với sort lớn có thể tạm thời dùng hàng trăm MB (work_mem × op). Khi ước lượng RAM, tính theo số kết nối hoạt động đồng thời × work_mem × số op điển hình, cộng phần cache dần tích lũy.
Đo RAM bằng đúng công cụ. ps/top RSS đếm trùng shared memory nên luôn phóng đại. Dùng hiệu MemAvailable, hoặc PSS (Proportional Set Size, chia đều shared memory) nếu đọc được /proc/PID/smaps. Con số bạn báo cáo chỉ đúng khi công cụ đo đúng.
Ba ý mang về
- PostgreSQL fork một tiến trình riêng cho mỗi kết nối: đo thật, 60 kết nối tạo 60 backend (6→66 tiến trình) — mô hình tiến trình-mỗi-kết-nối này là gốc rễ chi phí RAM và CPU khi có nhiều kết nối.
- Con số "16 MB/kết nối" từ ps là ảo: nó đếm trùng shared_buffers 128MB trong mỗi backend; đo bằng hiệu MemAvailable cho thấy kết nối idle thật sự chỉ tốn ~0,44 MB — dùng đúng công cụ đo (MemAvailable/PSS), đừng tin ps RSS.
- Vấn đề thật là kết nối hoạt động, không phải idle: relcache + plan cache + work_mem × op (nhân theo kết nối, có thể hàng chục GB) cộng context switch khi kết nối chạy vượt số core — giải pháp là connection pooling, không phải tăng max_connections.
Phần sau ta bóc tách chi tiết hơn con số vừa ước lượng: Phần sau đo chính xác chi phí một kết nối PostgreSQL — bộ nhớ khởi tạo, cache tích lũy khi chạy truy vấn, và vì sao con số tăng dần theo thời gian sống của kết nối.
