Bài trước đo thấy một kết nối idle rất rẻ (~0,44 MB) và làm rõ mô hình tiến trình-mỗi-kết-nối. Nhưng "rẻ khi idle" không phải toàn bộ câu chuyện. Một kết nối có hai loại chi phí thật sự đáng kể: chi phí thiết lập (mở kết nối) và bộ nhớ tích lũy theo đời sống của nó. Bài này đo cả hai — và con số thiết lập chính là lý do kỹ thuật vì sao connection pooling không chỉ để giới hạn số kết nối, mà còn giúp nhanh hơn hàng chục lần.
Chi phí thiết lập: đắt hơn bạn nghĩ
Mở một kết nối mới không phải chuyện nhẹ nhàng. Postmaster phải fork một tiến trình backend mới, chạy xác thực, nạp catalog ban đầu, và hoàn tất bắt tay TCP (cộng TLS nếu có). Để đo chi phí này, pgbench có cờ -C — mở lại kết nối cho mỗi giao dịch, thay vì tái dùng một kết nối:
pgbench -S -T 10 -c 1        # tái dùng 1 kết nối, chỉ SELECT
pgbench -C -S -T 10 -c 1     # -C: mở mới kết nối MỖI giao dịch
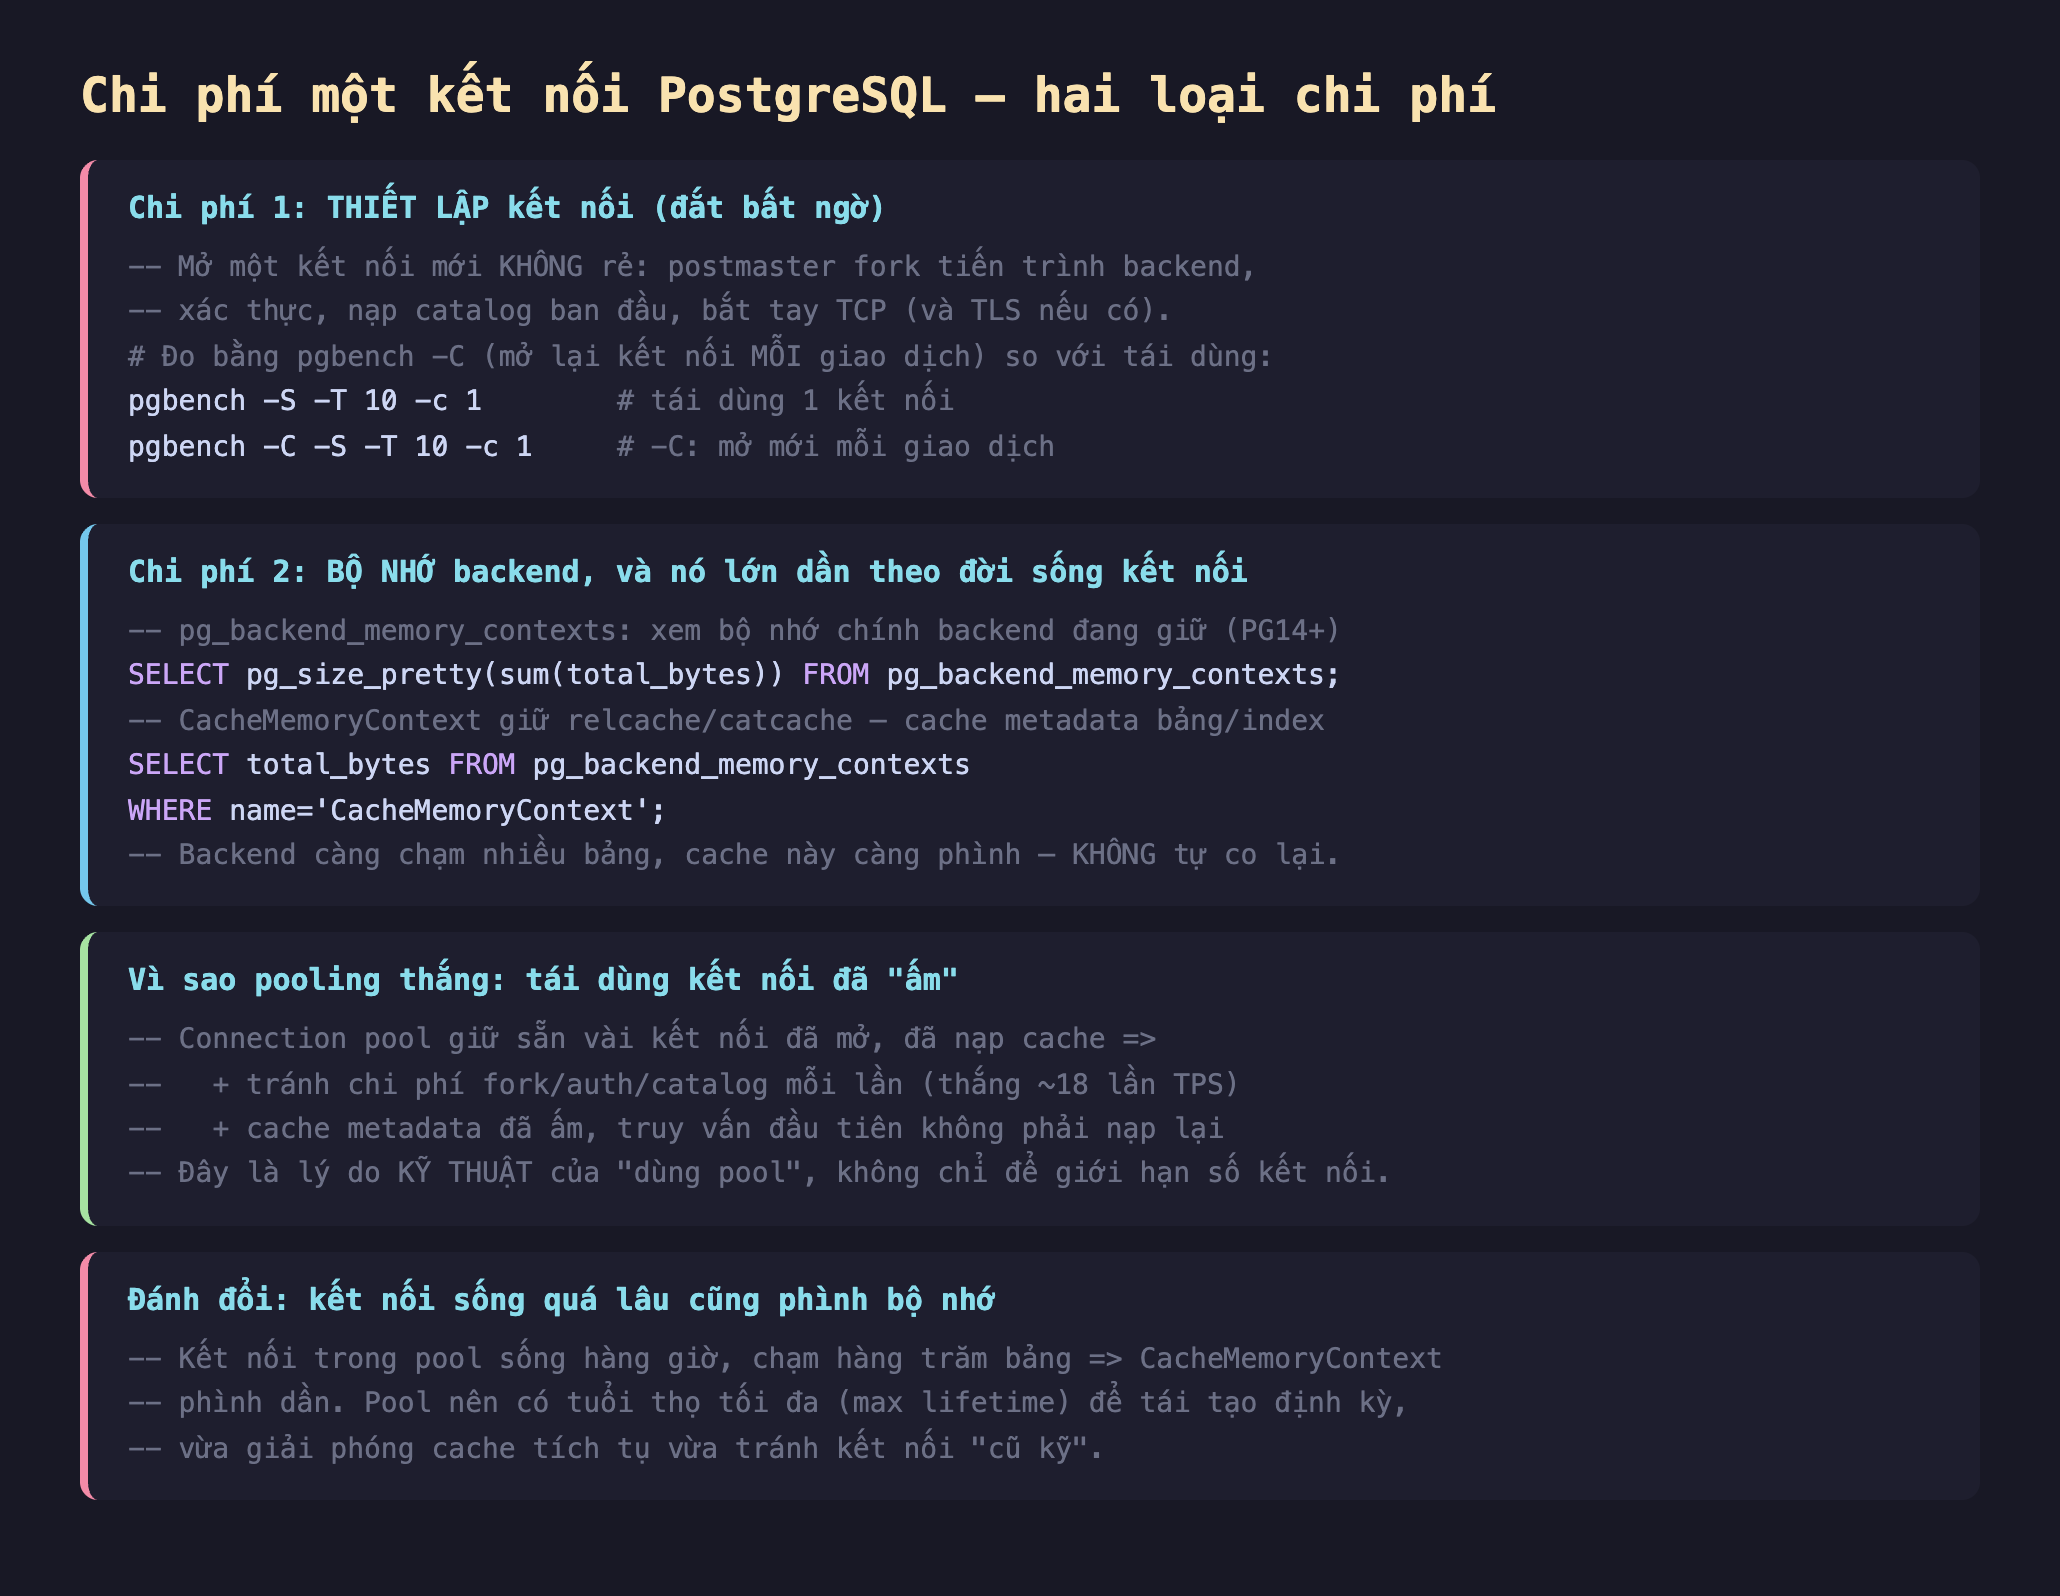
Hình 1: Một kết nối có hai chi phí — thiết lập (fork backend + auth + nạp catalog) và bộ nhớ backend (lớn dần theo đời sống). Đo bằng pgbench -C và pg_backend_memory_contexts. Pooling thắng vì tái dùng kết nối đã "ấm".
Đo thật: pool nhanh gấp 18 lần
Kết quả thật cho một truy vấn SELECT đơn giản trên socket cục bộ:
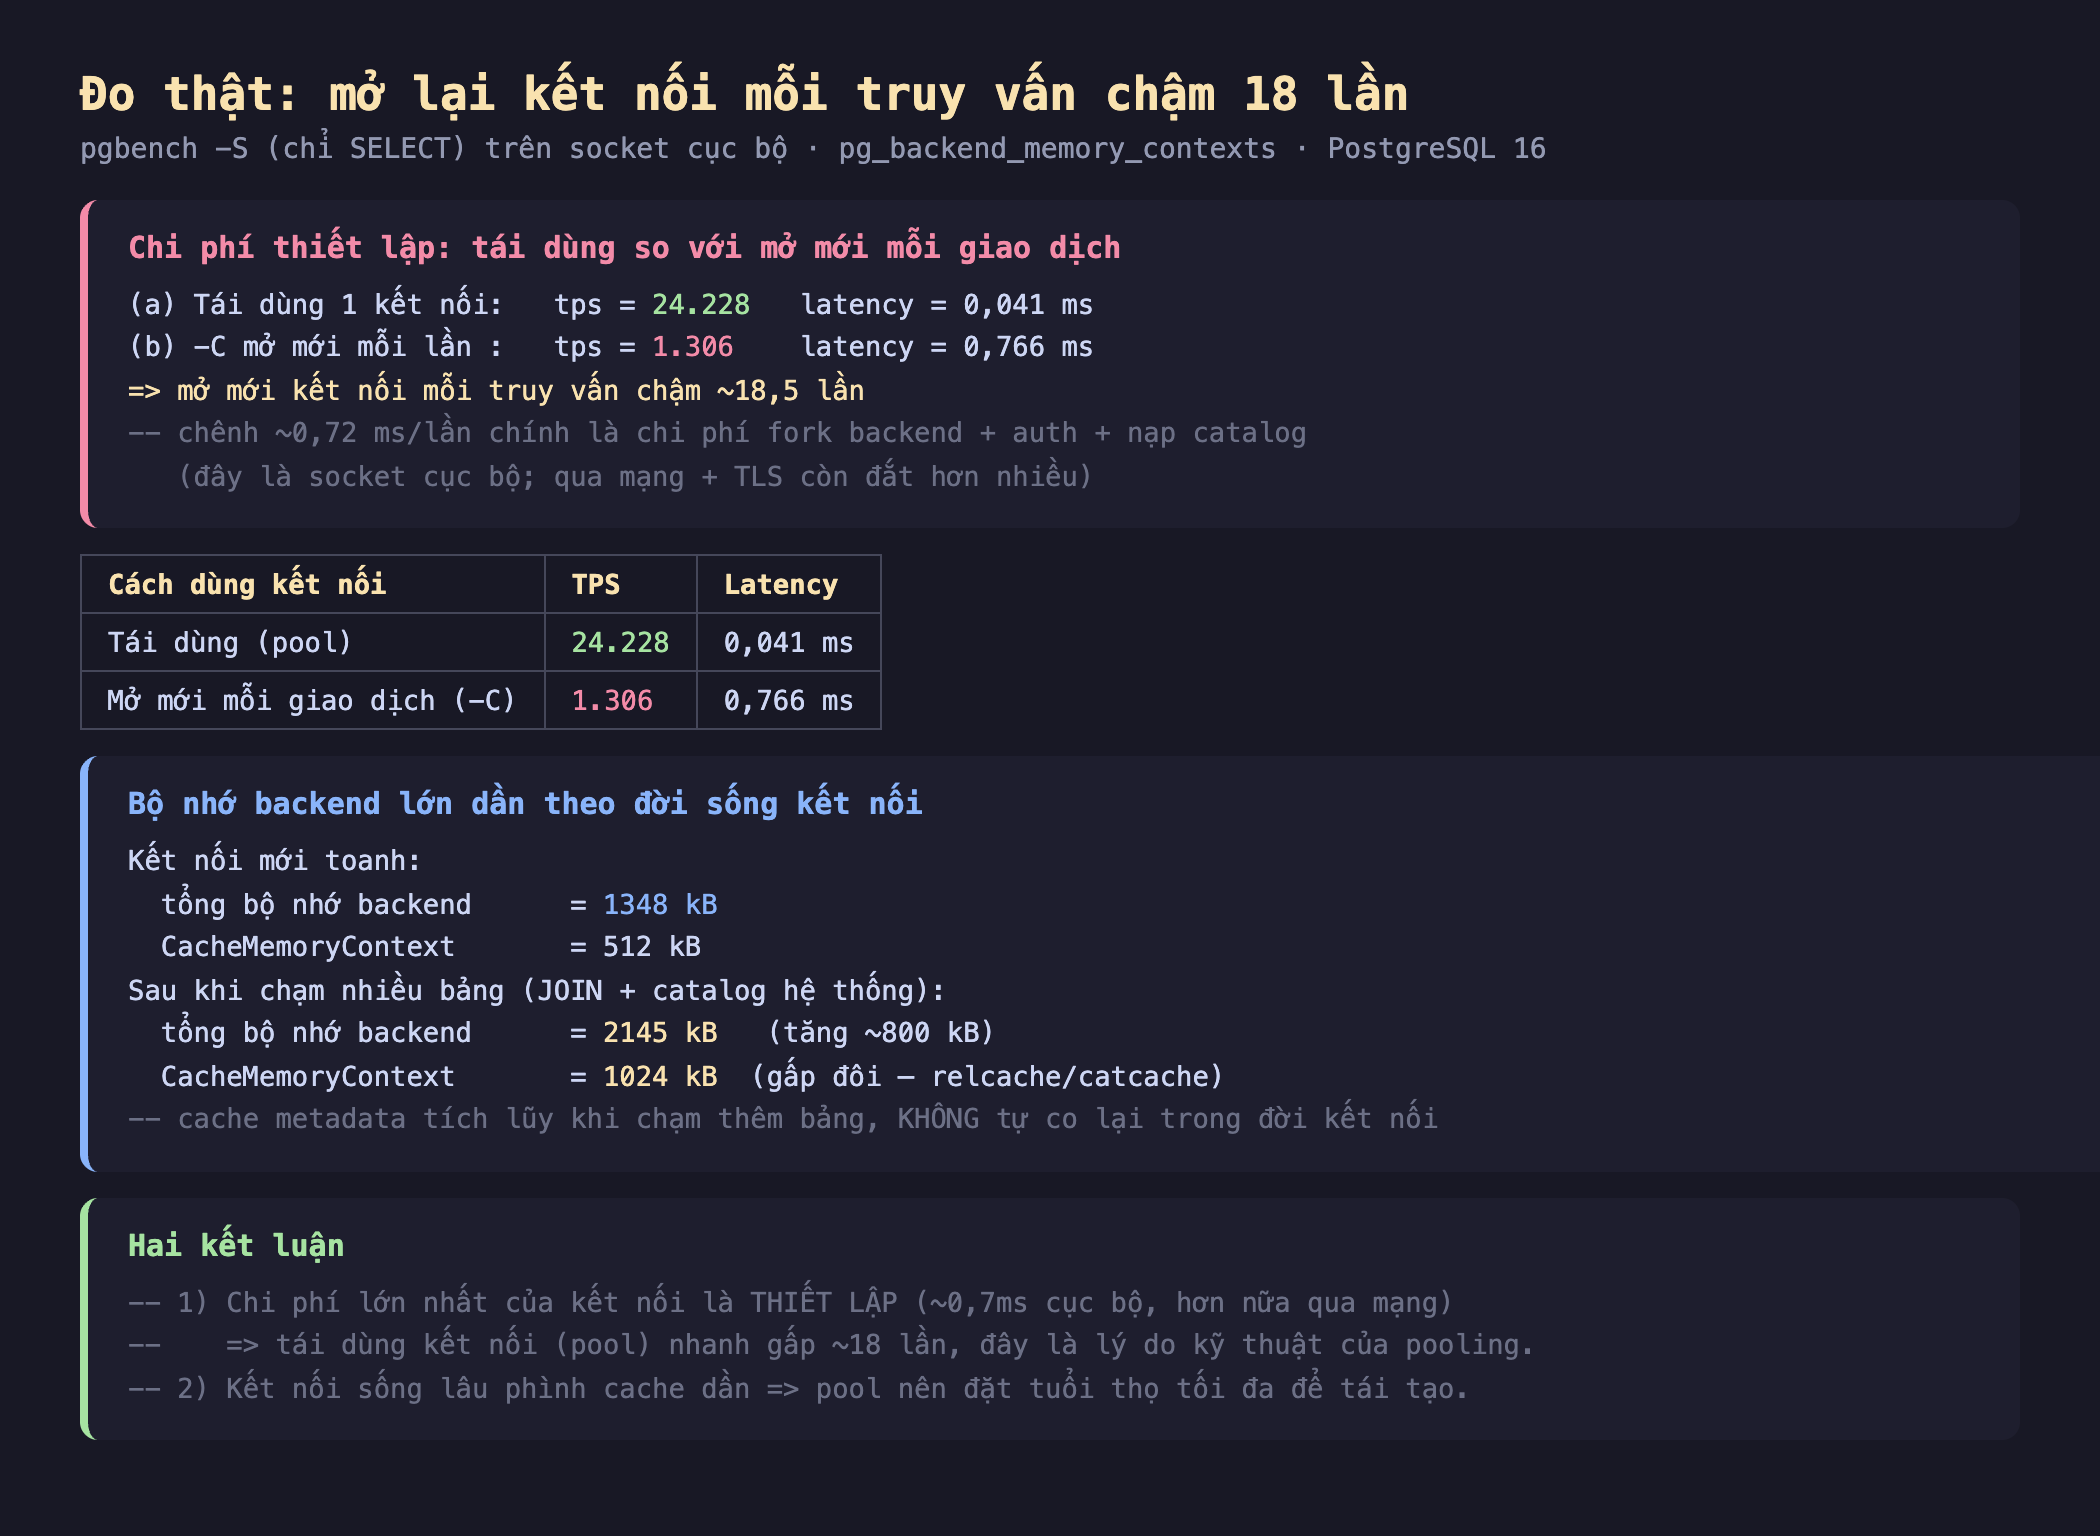
Hình 2: Tái dùng kết nối cho 24.228 TPS (0,041 ms); mở mới mỗi giao dịch chỉ 1.306 TPS (0,766 ms) — chậm ~18,5 lần. Bộ nhớ backend phình từ 1.348 kB (mới) lên 2.145 kB sau khi chạm nhiều bảng, CacheMemoryContext gấp đôi (512→1024 kB).
- Tái dùng kết nối: 24.228 TPS, latency 0,041 ms/truy vấn.
- Mở mới mỗi giao dịch (
-C): 1.306 TPS, latency 0,766 ms — chậm ~18,5 lần.
Chênh lệch ~0,72 ms mỗi lần chính là chi phí thiết lập một kết nối: fork backend, xác thực, nạp catalog. Và nhớ rằng đây là socket cục bộ trong container — qua mạng thật với bắt tay TCP và TLS, chi phí này còn cao hơn nhiều (thường vài ms). Đó là lý do một ứng dụng mở kết nối mới cho mỗi request HTTP sẽ chậm thảm hại.
Chi phí bộ nhớ tăng dần theo đời sống
Chi phí thứ hai tinh vi hơn: bộ nhớ của một backend lớn dần theo thời gian nó sống. PostgreSQL 14+ cho phép xem trực tiếp qua pg_backend_memory_contexts:
SELECT pg_size_pretty(sum(total_bytes)) FROM pg_backend_memory_contexts;
SELECT total_bytes FROM pg_backend_memory_contexts WHERE name='CacheMemoryContext';
Đo thật trên cùng một backend: kết nối mới toanh có tổng bộ nhớ 1.348 kB, CacheMemoryContext 512 kB. Sau khi chạy vài truy vấn chạm nhiều bảng (JOIN các bảng pgbench + quét catalog hệ thống), tổng lên 2.145 kB và CacheMemoryContext gấp đôi thành 1.024 kB. CacheMemoryContext giữ relcache/catcache — cache metadata của mọi bảng, index, kiểu dữ liệu mà backend đã chạm tới. Cache này không tự co lại trong đời sống của kết nối: một backend chạm càng nhiều bảng thì càng phình.
Đây là lý do kết nối hoạt động lâu (như kết nối trong pool sống hàng giờ) có thể tích tụ vài MB đến hàng chục MB cache metadata, khác hẳn con số ~0,44 MB của kết nối idle vừa mở ở bài trước.
Vì sao pooling là giải pháp kỹ thuật
Gộp hai chi phí lại, ta thấy connection pooling không chỉ để giới hạn số kết nối (tránh cạn RAM/CPU như bài trước), mà còn là tối ưu tốc độ trực tiếp: một pool giữ sẵn vài kết nối đã mở và đã "ấm" cache, nên:
- Tránh chi phí thiết lập mỗi lần — thắng ~18 lần TPS như đo ở trên.
- Cache metadata đã ấm — truy vấn đầu tiên qua kết nối pool không phải nạp lại relcache.
Đó là lý do mọi ứng dụng nghiêm túc đều dùng pool (PgBouncer ở tầng hạ tầng, hoặc HikariCP/pgxpool trong ứng dụng), thay vì mở kết nối mới cho mỗi thao tác.
Đánh đổi cần cân nhắc
Kết nối sống quá lâu cũng phình bộ nhớ. Vì CacheMemoryContext không co lại, một kết nối pool sống nhiều ngày chạm hàng trăm bảng có thể tích tụ bộ nhớ đáng kể. Pool nên đặt tuổi thọ tối đa (max lifetime, ví dụ 30 phút) để đóng và tái tạo kết nối định kỳ — vừa giải phóng cache tích tụ, vừa tránh kết nối "cũ kỹ" giữ tài nguyên phía server.
Pool quá nhỏ gây chờ; pool quá lớn mất ý nghĩa. Kích thước pool phải cân bằng: đủ để phục vụ tải đồng thời nhưng không vượt số kết nối server chịu được hiệu quả (thường liên quan số core). Đây là chủ đề của bài max_connections.
pgbench -C đo cực đoan, tải thật ở giữa. Con số 18× là trường hợp cực đoan (mở lại kết nối cho mỗi truy vấn đơn giản 0,04 ms). Với truy vấn nặng hơn, tỉ lệ chi phí thiết lập nhỏ đi. Nhưng nguyên tắc không đổi: đừng mở kết nối mới cho mỗi thao tác ngắn.
Ba ý mang về
- Chi phí lớn nhất của một kết nối là thiết lập: đo thật, mở lại kết nối mỗi giao dịch cho 1.306 TPS so với 24.228 TPS khi tái dùng — chậm ~18 lần (chênh ~0,72 ms/lần cho fork backend + auth + nạp catalog, còn đắt hơn qua mạng + TLS).
- Bộ nhớ backend tăng dần theo đời sống kết nối: đo qua
pg_backend_memory_contexts, kết nối mới 1.348 kB phình lên 2.145 kB khi chạm nhiều bảng,CacheMemoryContextgấp đôi (relcache/catcache không tự co lại). - Pooling là giải pháp kỹ thuật, không chỉ giới hạn số kết nối: tái dùng kết nối đã ấm cache thắng ~18 lần tốc độ — nhưng đặt tuổi thọ tối đa cho kết nối pool để giải phóng cache tích tụ.
Phần sau ta trả lời câu hỏi thực dụng tiếp theo: Phần sau đo và lý giải max_connections nên đặt bao nhiêu — vì sao con số phụ thuộc số core hơn là RAM, và công thức ước lượng thực tế.
