Cache hit ratio là một trong những chỉ số đầu tiên mọi bài hướng dẫn PostgreSQL bảo bạn nhìn, kèm quy tắc "trên 99% là khỏe". Nó không sai, nhưng nó đánh lừa nhiều hơn người ta tưởng. Bài này đo thật một truy vấn có hit ratio 100% mà vẫn chậm 1,4 giây, và làm rõ ba cách con số này dẫn bạn đi lạc — cùng công cụ đọc cho đúng.
Cache hit ratio là gì
Cache hit ratio đo tỉ lệ các trang được lấy từ shared_buffers (hit) so với các trang phải đọc thêm từ ngoài (read):
SELECT datname, blks_hit, blks_read,
       round(100.0*blks_hit/nullif(blks_hit+blks_read,0),2) AS hit_pct
FROM pg_stat_database WHERE datname='lab';
Trên lab của tôi, con số tổng thể là 93,21% (blks_hit 812 triệu, blks_read 59 triệu), pgbench_accounts là 86,09%. Nghe có vẻ "cần cải thiện" so với quy tắc 99%. Nhưng trước khi vội tăng shared_buffers, hãy hiểu con số này thực sự nói gì — và không nói gì.
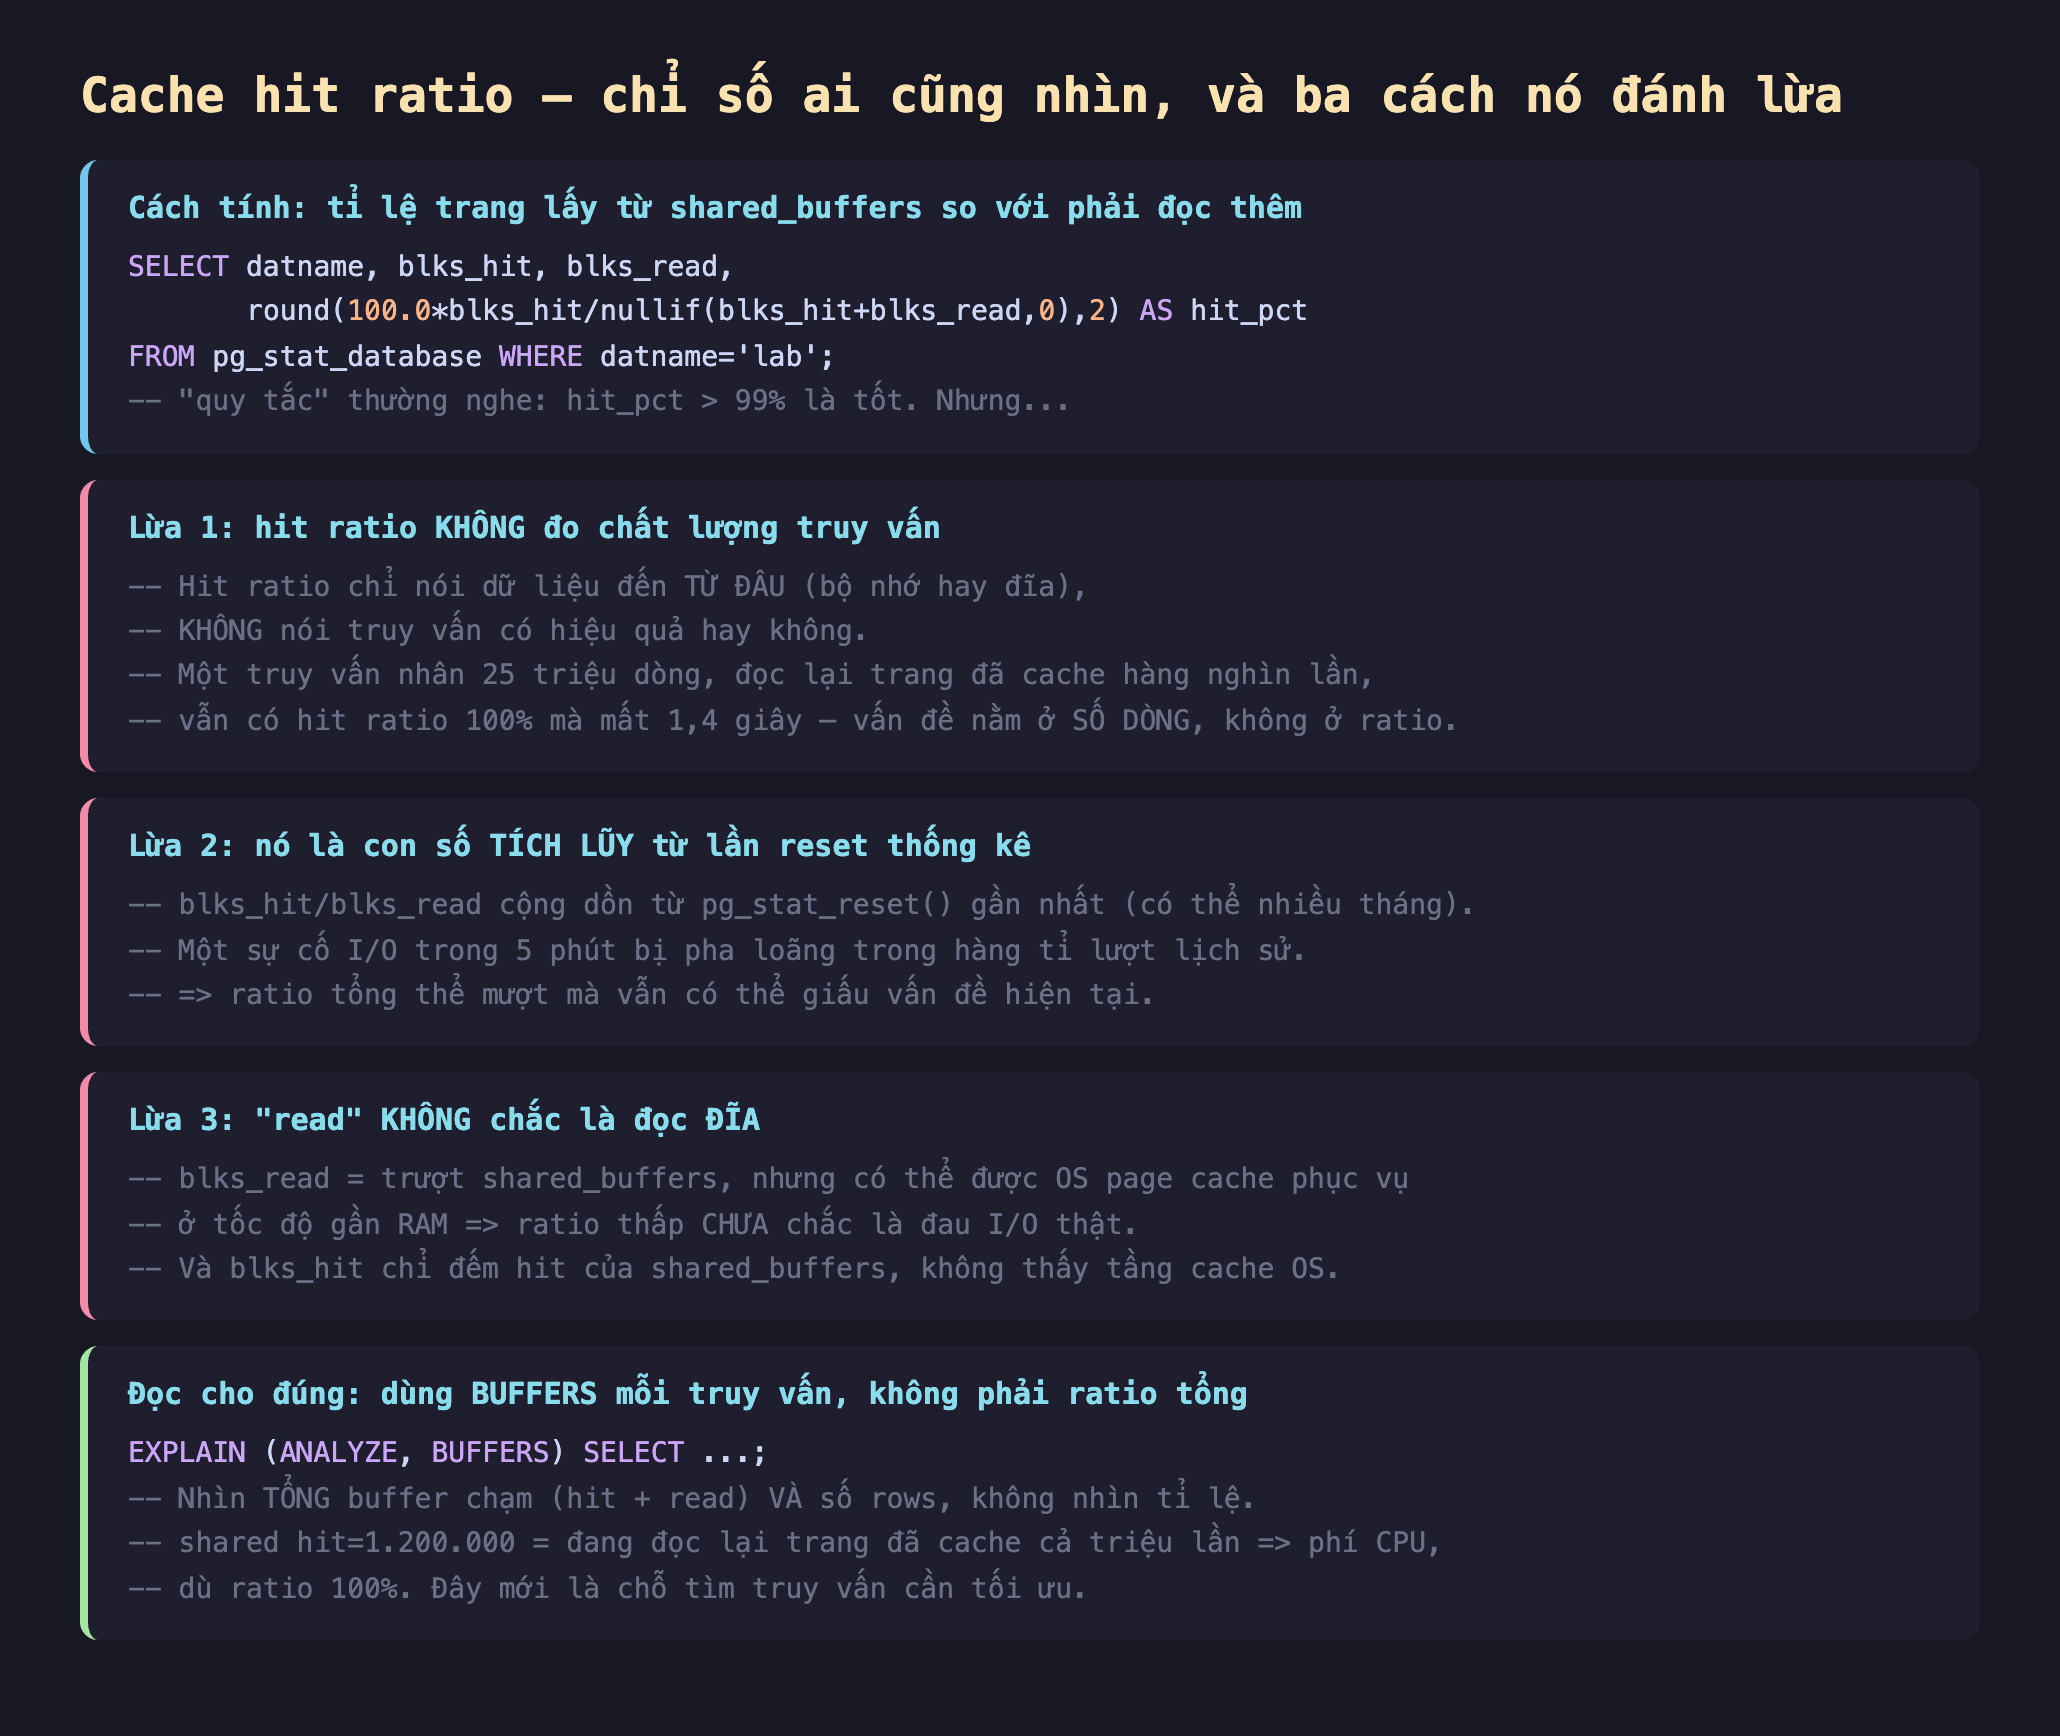
Hình 1: Cache hit ratio tính từ blks_hit/blks_read. Ba cách nó đánh lừa: không đo chất lượng truy vấn, là con số tích lũy, và "read" chưa chắc là đọc đĩa. Công cụ đọc đúng là EXPLAIN BUFFERS mỗi truy vấn.
Đo thật: hit ratio 100% mà vẫn 1,4 giây
Đây là bằng chứng quan trọng nhất. Tôi tạo bảng hot nhỏ (50.000 dòng) đã nằm gọn trong cache, rồi chạy một self-join trên cột grp (chỉ 100 nhóm, nên mỗi nhóm khớp rất nhiều dòng):
SELECT count(*) FROM hot a JOIN hot b ON a.grp=b.grp;
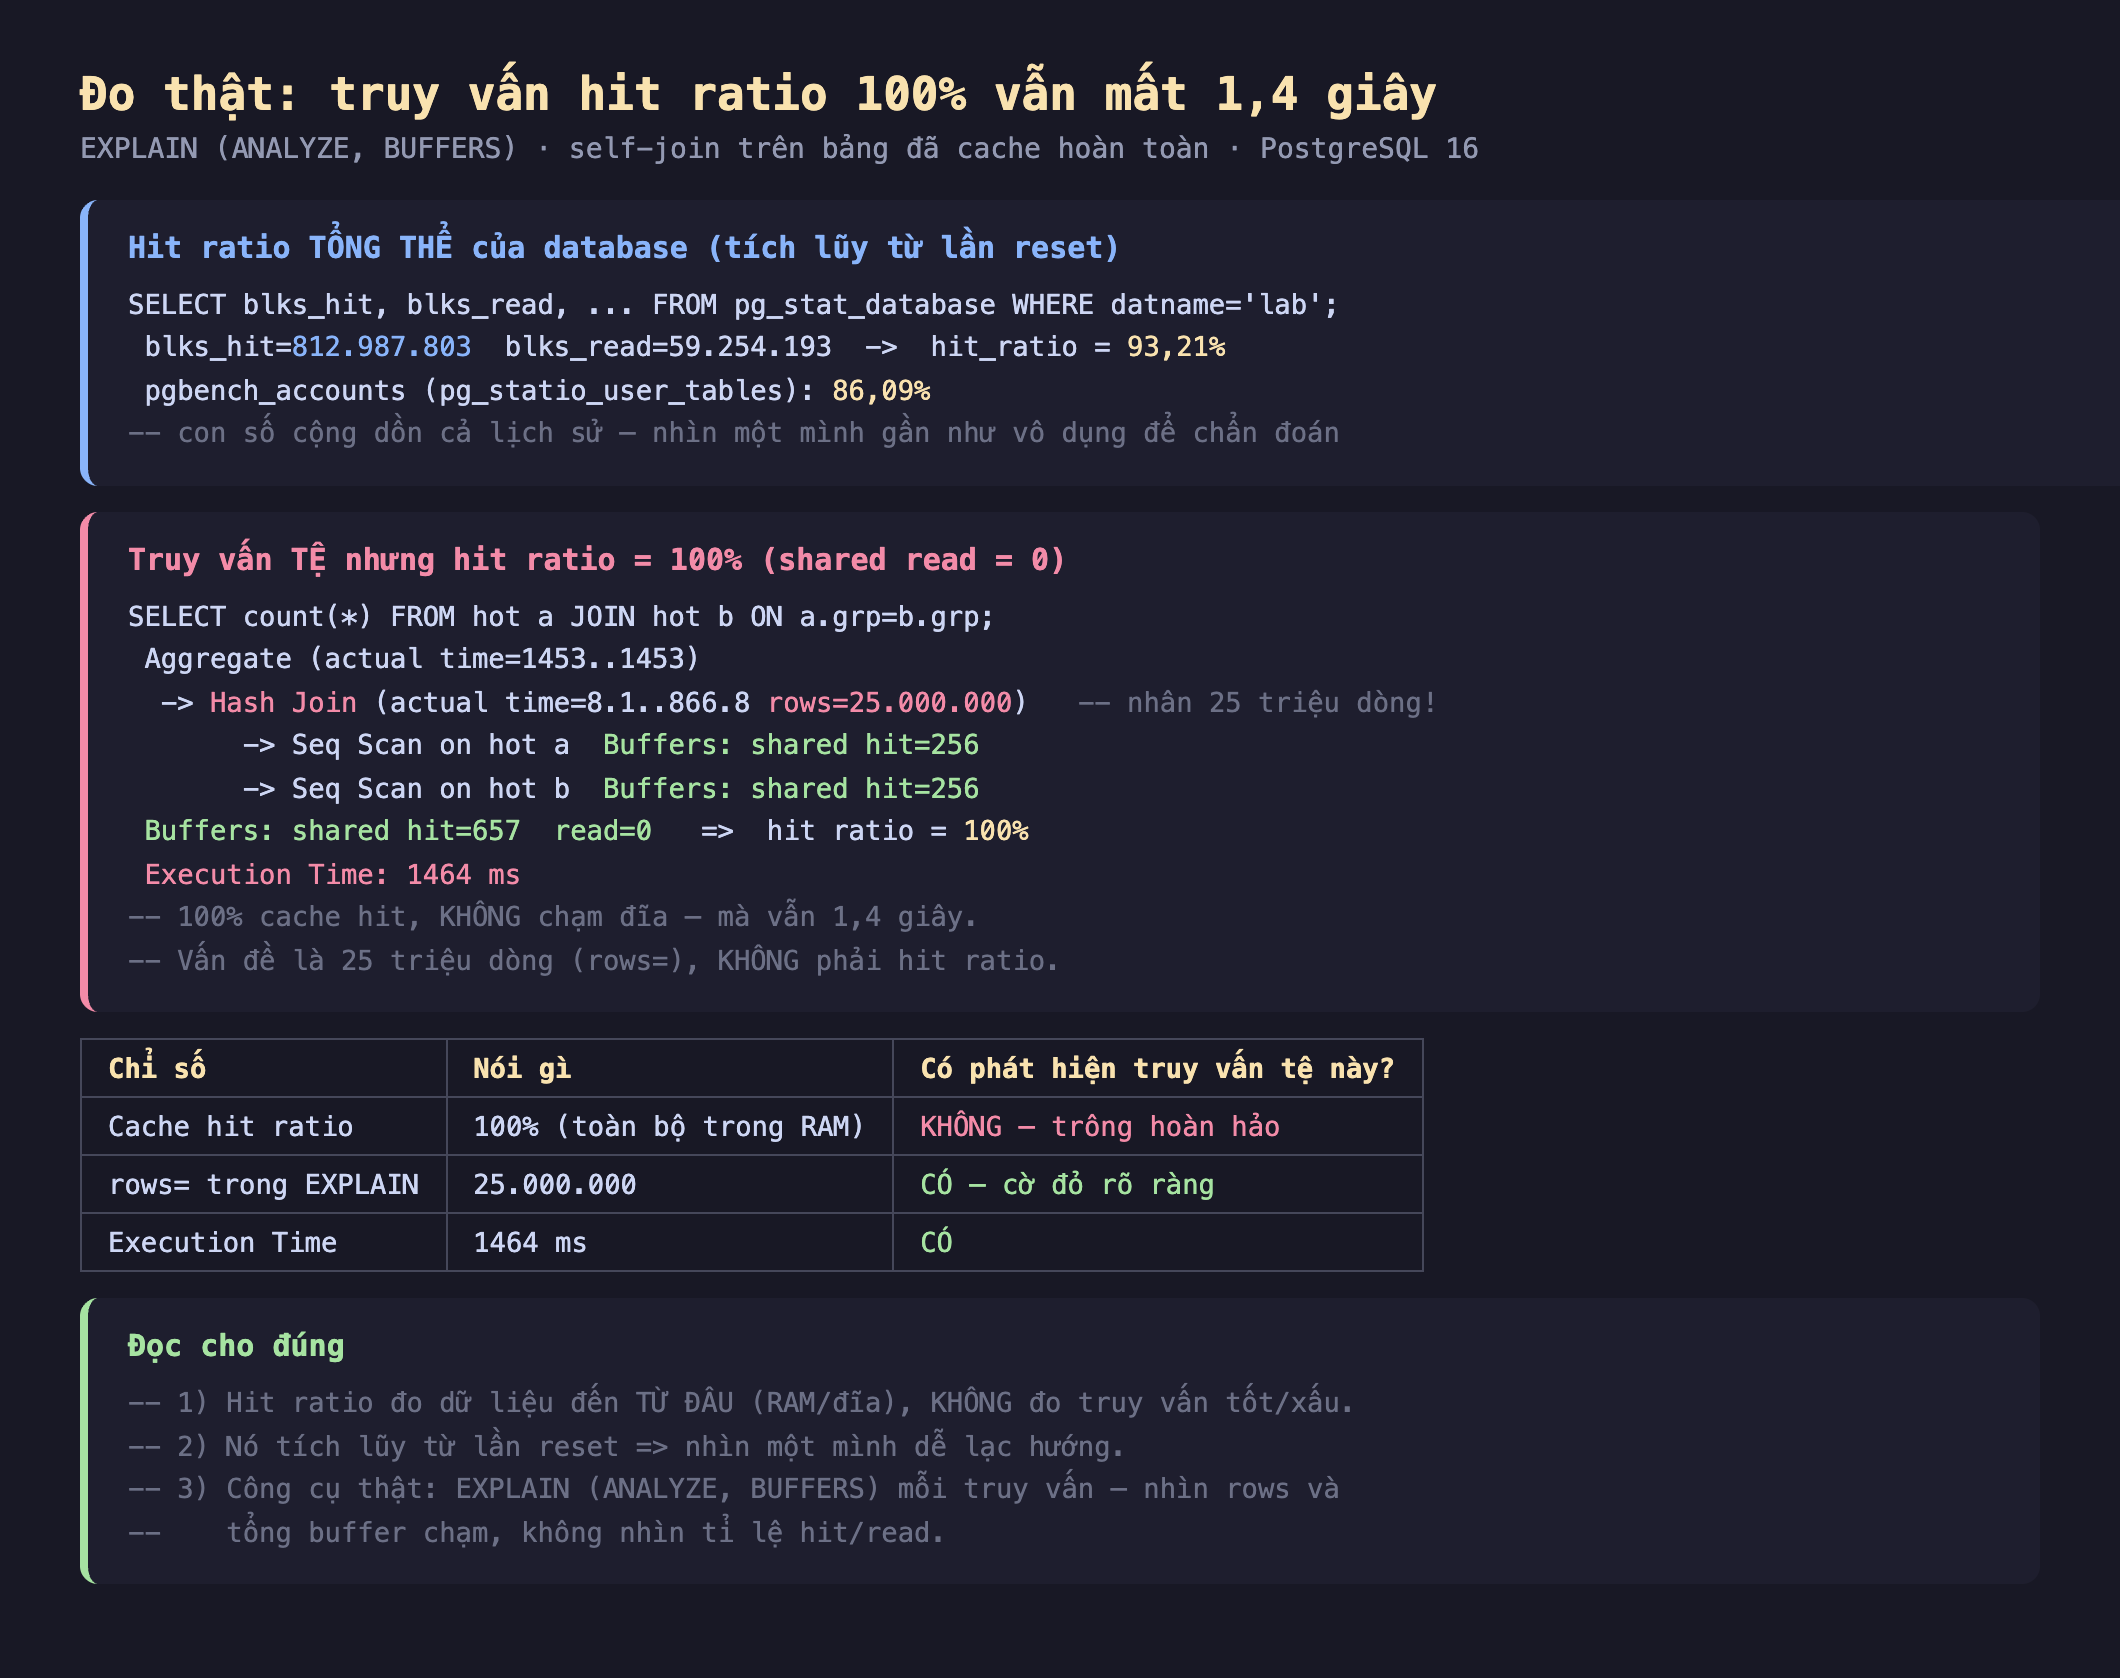
Hình 2: Self-join có Buffers: shared hit=657, read=0 → hit ratio 100%, không chạm đĩa. Nhưng nhân ra 25 triệu dòng và mất 1.464 ms. Hit ratio hoàn hảo không hề phát hiện truy vấn tệ này; chỉ rows= và Execution Time mới lộ ra.
Kết quả: Buffers: shared hit=657, read=0 — hit ratio 100%, không đọc một trang nào từ đĩa. Vậy mà truy vấn mất 1.464 ms vì nó nhân ra 25 triệu dòng. Đây là minh chứng cô đọng cho cái bẫy: hit ratio đo dữ liệu đến TỪ ĐÂU (bộ nhớ hay đĩa), không đo truy vấn có HIỆU QUẢ hay không. Một truy vấn thảm họa hoàn toàn có thể có hit ratio hoàn hảo.
Ba cách hit ratio đánh lừa
1. Nó không đo chất lượng truy vấn. Như đo ở trên, 100% hit ratio nói lên đúng một điều: dữ liệu nằm trong RAM. Nó không thấy việc truy vấn đọc lại cùng trang cache hàng triệu lần (phí CPU), hay nhân dòng ra khổng lồ. Cờ đỏ thật là rows= và tổng số buffer chạm, không phải tỉ lệ hit/read.
2. Nó là con số tích lũy từ lần reset thống kê. blks_hit/blks_read cộng dồn từ pg_stat_reset() gần nhất — có thể là nhiều tháng trước. Một đợt I/O tồi tệ kéo dài 5 phút bị pha loãng trong hàng tỉ lượt lịch sử, nên ratio tổng thể vẫn mượt mà trong khi hệ thống đang khổ sở ngay bây giờ. Muốn thấy hiện tại, phải chụp hai thời điểm và lấy hiệu.
3. "read" chưa chắc là đọc đĩa. blks_read chỉ có nghĩa "trượt shared_buffers" — nhưng trang đó rất có thể được OS page cache phục vụ ở tốc độ gần RAM (như bài effective_io_concurrency đã thấy). Nên hit ratio 90% chưa chắc là đau I/O thật. Ngược lại, blks_hit chỉ đếm hit của shared_buffers, hoàn toàn mù với tầng cache của hệ điều hành — bức tranh bộ nhớ thật lớn hơn con số này.
Đọc cho đúng
Công cụ thật không phải ratio tổng thể, mà là EXPLAIN (ANALYZE, BUFFERS) cho từng truy vấn. Nhìn hai thứ: tổng số buffer chạm (shared hit + read) và số rows. Một truy vấn với shared hit=1.200.000 đang đọc lại trang đã cache cả triệu lần — phí CPU khủng khiếp dù ratio 100%. Đó mới là chỗ tìm truy vấn cần tối ưu.
Hit ratio tổng thể vẫn có ích như một tín hiệu thô: nếu nó tụt đột ngột, đó là dấu hiệu working set vừa vượt quá shared_buffers hoặc một job quét bảng lớn đang chạy. Nhưng đó là điểm khởi đầu để điều tra, không phải kết luận, và càng không phải thước đo sức khỏe truy vấn.
Đánh đổi cần cân nhắc
Đừng tăng shared_buffers chỉ vì hit ratio "thấp". Ratio 93% có thể hoàn toàn ổn nếu phần "read" được OS cache phục vụ nhanh. Tăng shared_buffers mù quáng có thể phản tác dụng (double buffering như bài shared_buffers đã bàn). Chỉ tăng khi đo thấy I/O đĩa thật là nút cổ chai.
Ratio cao đột biến cũng đáng ngờ. Một hệ thống mới khởi động, hoặc một tải toàn truy vấn lặp trên cùng vài trang, cho ratio ~100% mà chẳng nói lên hệ thống khỏe — có khi đang bận rộn làm việc vô ích (như self-join ở trên). Ratio là mô tả, không phải mục tiêu để tối ưu.
Per-table statio giúp khoanh vùng, nhưng vẫn tích lũy. pg_statio_user_tables cho ratio từng bảng, hữu ích để biết bảng nào hay trượt cache. Nhưng nó cũng cộng dồn từ lần reset, nên vẫn phải chụp hai thời điểm nếu muốn thấy hành vi hiện tại.
Ba ý mang về
- Cache hit ratio đo dữ liệu đến từ đâu (RAM hay đĩa), KHÔNG đo truy vấn tốt hay xấu: đo thật, một self-join có hit ratio 100% (shared read=0, không chạm đĩa) vẫn mất 1,4 giây vì nhân 25 triệu dòng — ratio hoàn hảo không phát hiện được truy vấn tệ.
- Con số tích lũy dễ đánh lừa: nó cộng dồn từ lần reset thống kê (có thể nhiều tháng), nên sự cố hiện tại bị pha loãng; và "read" chưa chắc là đọc đĩa vì OS page cache có thể phục vụ nhanh — ratio 93% chưa chắc là vấn đề.
- Công cụ đọc đúng là EXPLAIN (ANALYZE, BUFFERS) mỗi truy vấn: nhìn
rows=và tổng buffer chạm (hit+read), không nhìn tỉ lệ —shared hitcả triệu là dấu hiệu đọc lại trang cache lãng phí CPU dù ratio 100%; đừng tăng shared_buffers chỉ vì ratio "thấp".
Phần sau ta chuyển sang chủ đề kết nối — nơi RAM biến mất theo cách ít ai ngờ: Phần sau mổ xẻ vì sao mỗi kết nối PostgreSQL là một tiến trình tốn RAM riêng, và điều đó dẫn tới nhu cầu connection pooling thế nào.
