Các bài trước chỉnh cách PostgreSQL dùng bộ nhớ và đĩa. huge_pages đi xuống một tầng sâu hơn — cách hệ điều hành và CPU ánh xạ bộ nhớ ảo sang vật lý. Đây là một tối ưu ít người bật nhưng đáng giá với các server có shared_buffers lớn, và nó minh hoạ một khái niệm phần cứng quan trọng: TLB. Bài này đo thật số lượng mục page table cho các cấu hình khác nhau, và quan sát trạng thái huge page thật trong container để rút ra khi nào và cách bật.
Vấn đề: TLB quá tải với shared_buffers lớn
Mỗi lần chương trình truy cập một địa chỉ bộ nhớ, CPU phải dịch địa chỉ ảo sang địa chỉ vật lý qua bảng page table. Để khỏi tra bảng mỗi lần (chậm), CPU có một cache nhỏ tên TLB (Translation Lookaside Buffer) giữ các bản dịch gần đây — nhưng TLB chỉ chứa được khoảng 1.500-3.000 mục.
Với trang nhớ thường 4KB, một vùng shared_buffers lớn cần rất nhiều mục page table (PTE — page table entry). Đo thật con số:
-- shared_buffers 8GB với trang 4KB:  8GB / 4KB = 2.097.152 PTE
-- shared_buffers 8GB với huge 2MB:   8GB / 2MB = 4.096 PTE
2 triệu PTE so với TLB chỉ giữ vài nghìn mục → TLB miss triền miên: mỗi miss buộc CPU "page walk" (đi bộ qua bảng page table nhiều tầng), làm chậm mọi truy cập bộ nhớ. Huge page 2MB thay cho 4KB giảm số PTE đi 512 lần — 4.096 mục vừa gọn trong TLB, gần như luôn trúng, ít stall CPU.
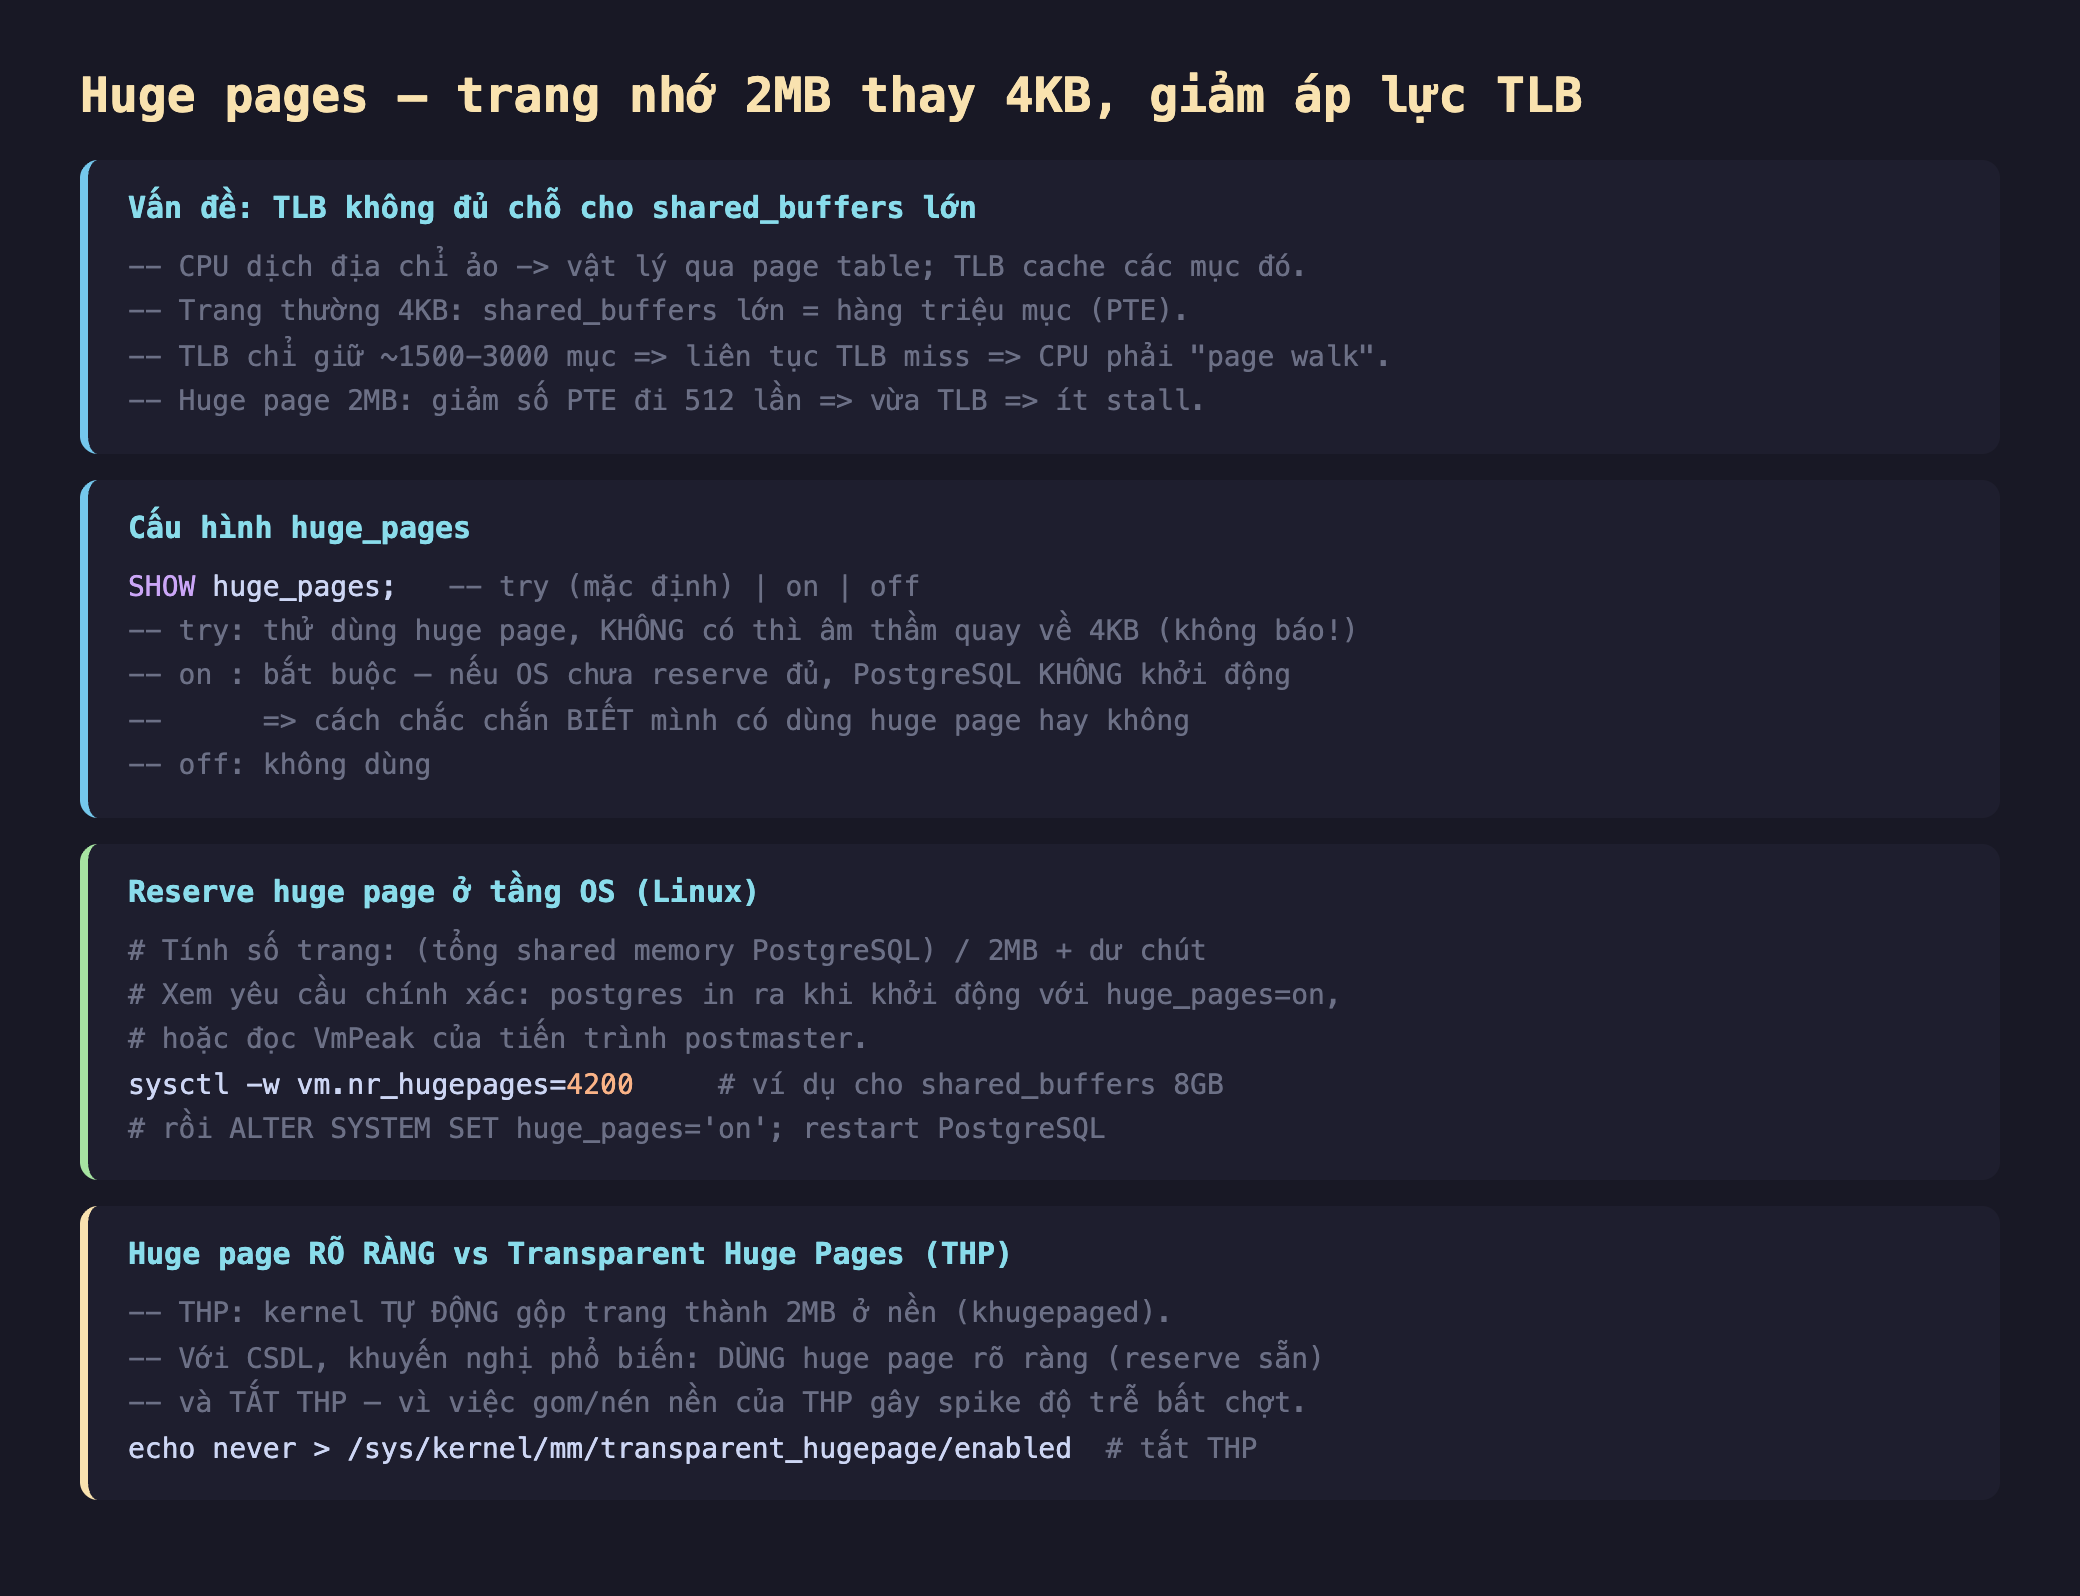
Hình 1: Trang 4KB khiến shared_buffers lớn sinh hàng triệu PTE, làm TLB quá tải. Huge page 2MB giảm số PTE 512 lần. huge_pages: try (fallback lặng lẽ), on (fail-fast, chắc chắn), off. Nên dùng huge page rõ ràng + tắt THP với CSDL.
Đo thật trạng thái huge page trong container
Con số PTE ở trên tính trực tiếp từ kích thước bộ nhớ. Quan trọng hơn, tôi đọc trạng thái huge page thật của container để thấy cái bẫy phổ biến:
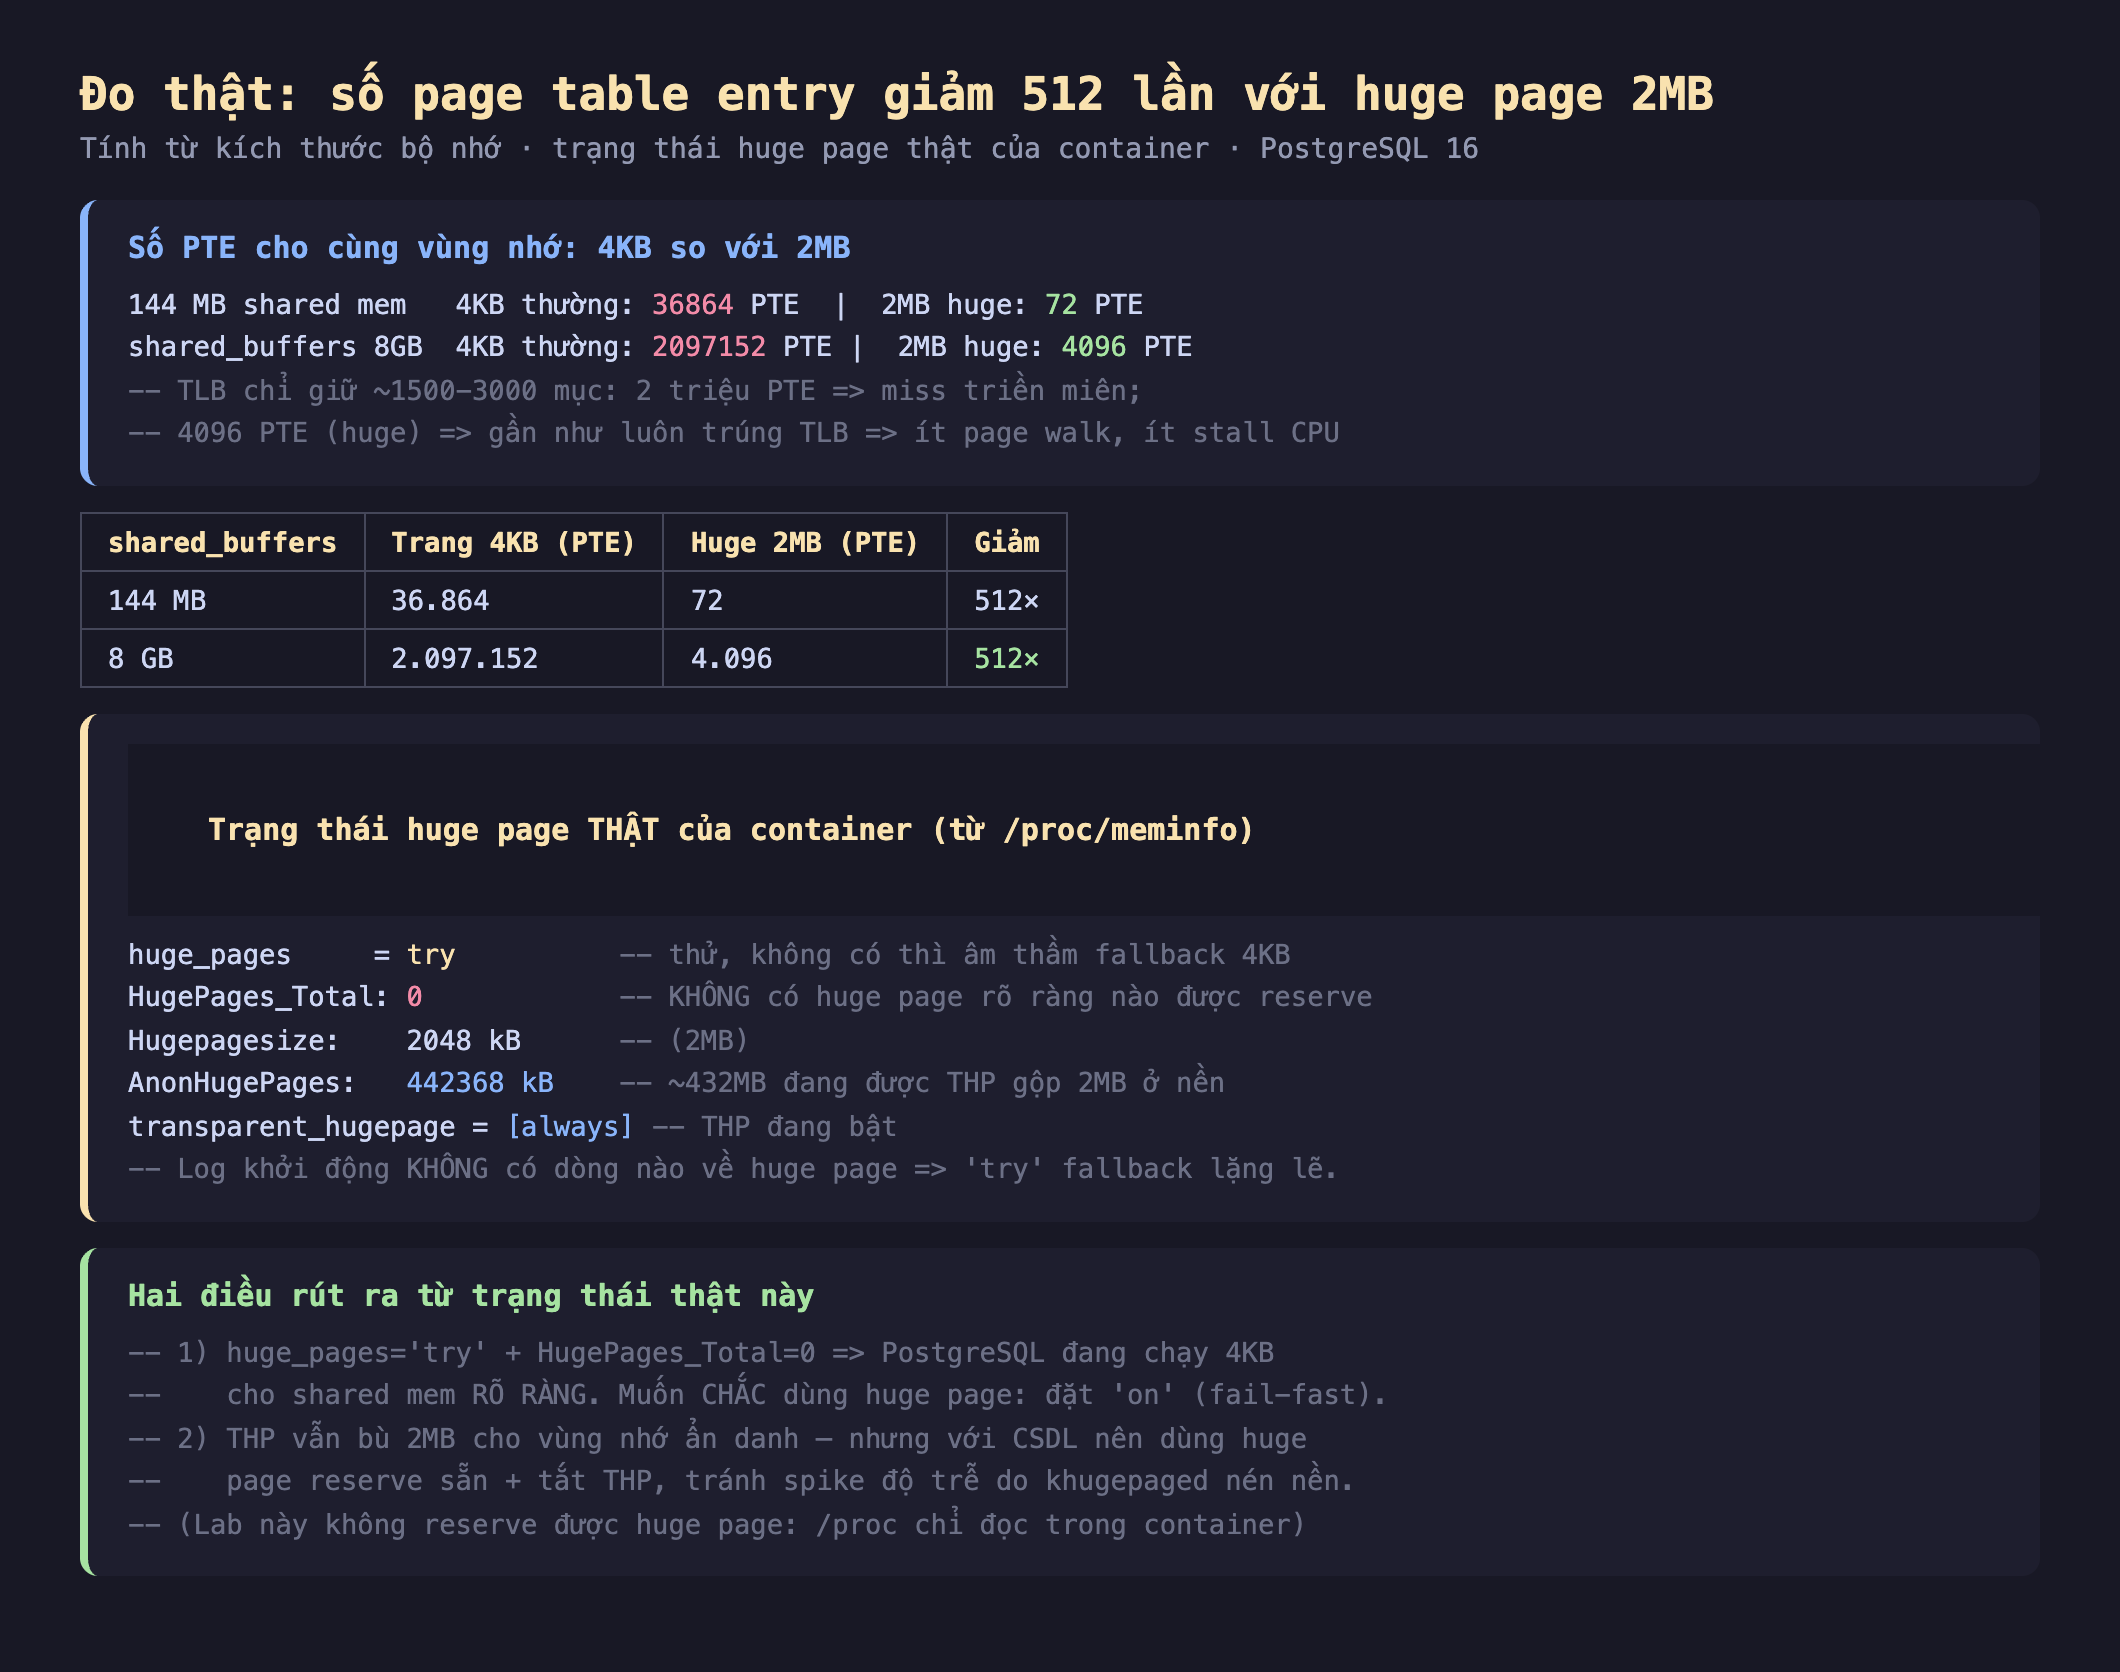
Hình 2: Số PTE giảm 512× với huge page (2.097.152 → 4.096 cho 8GB). Trạng thái thật: huge_pages=try nhưng HugePages_Total=0 (không reserve được) nên PostgreSQL chạy 4KB; THP lại đang bù (AnonHugePages=442MB, THP=[always]). Log khởi động không nhắc gì → 'try' fallback lặng lẽ.
Trạng thái thật cho ta hai bài học:
1. huge_pages='try' fallback lặng lẽ — bạn có thể tưởng đang dùng mà không. Container có huge_pages=try nhưng HugePages_Total=0 (OS chưa reserve huge page nào), nên PostgreSQL âm thầm quay về trang 4KB cho vùng shared memory rõ ràng — và không có dòng log nào cảnh báo. Đây là bẫy phổ biến: đặt try rồi tưởng mình được hưởng huge page. Muốn chắc chắn, đặt huge_pages='on': nếu OS chưa reserve đủ, PostgreSQL sẽ không khởi động — thà fail rõ ràng còn hơn im lặng chạy 4KB.
2. THP đang bù, nhưng đó không phải cái CSDL muốn. Dù không có huge page rõ ràng, AnonHugePages=442MB và transparent_hugepage=[always] cho thấy kernel đang tự gộp trang thành 2MB ở nền (THP — Transparent Huge Pages). Nghe có vẻ tốt, nhưng với CSDL, khuyến nghị phổ biến là dùng huge page reserve sẵn và TẮT THP — vì tiến trình nền khugepaged gom/nén trang có thể gây spike độ trễ bất chợt đúng lúc CSDL đang bận.
(Giới hạn lab: container này không reserve được huge page rõ ràng vì /proc/sys/vm/nr_hugepages chỉ-đọc trong môi trường không đặc quyền. Các con số PTE và trạng thái /proc/meminfo là thật; phần reserve phải làm ở host.)
Cách bật đúng
# 1. Tính số huge page cần: (tổng shared memory) / 2MB, dư ra chút cho overhead.
#    Xem yêu cầu CHÍNH XÁC: khởi động postgres với huge_pages=on, nó in ra số cần;
#    hoặc đọc VmPeak của tiến trình postmaster.
sysctl -w vm.nr_hugepages=4200          # ví dụ cho shared_buffers ~8GB

# 2. Trong PostgreSQL:
#    ALTER SYSTEM SET huge_pages = 'on';   rồi restart

# 3. Tắt THP để tránh spike độ trễ:
echo never > /sys/kernel/mm/transparent_hugepage/enabled
Đánh đổi cần cân nhắc
Huge page reserve là bộ nhớ bị "khoá cứng". Khi bạn vm.nr_hugepages=4200, kernel giữ riêng ~8GB đó cho huge page — các tiến trình khác không dùng được, kể cả khi PostgreSQL chưa chiếm hết. Tính đúng số cần, đừng reserve thừa. Và nếu đặt huge_pages=on mà reserve thiếu, PostgreSQL không khởi động — nhớ đồng bộ hai con số.
Lợi ích rõ nhất khi shared_buffers lớn. Với shared_buffers vài trăm MB, chênh lệch TLB nhỏ, huge page gần như không đáng kể. Nó phát huy ở server CSDL nghiêm túc với shared_buffers nhiều GB — nơi 2 triệu PTE thật sự làm TLB nghẹt. Server nhỏ thì đừng bận tâm.
Đây là tối ưu CPU/độ trễ, không phải I/O. Huge page không làm đọc/ghi đĩa nhanh hơn; nó giảm overhead CPU khi truy cập bộ nhớ (ít page walk). Lợi ích đo bằng độ trễ truy vấn ổn định hơn và CPU nhàn hơn dưới tải nặng, không phải bằng throughput I/O — nên phải benchmark trên tải thật của bạn để thấy, và mức cải thiện thường vài phần trăm chứ không phải phép màu.
Ba ý mang về
- Trang 4KB khiến shared_buffers lớn sinh hàng triệu mục page table, làm TLB của CPU quá tải: đo thật, shared_buffers 8GB cần 2.097.152 PTE với trang 4KB nhưng chỉ 4.096 PTE với huge page 2MB — giảm 512 lần, giúp bản dịch địa chỉ gần như luôn trúng TLB.
- huge_pages='try' fallback lặng lẽ: trạng thái container thật cho thấy
try+HugePages_Total=0nghĩa là PostgreSQL đang chạy 4KB mà không báo — muốn chắc chắn dùng huge page, đặthuge_pages='on'(fail-fast nếu OS chưa reserve đủ). - Với CSDL nên dùng huge page rõ ràng và tắt THP: dù THP tự bù 2MB (đo thấy AnonHugePages=442MB), tiến trình nền khugepaged của THP gây spike độ trễ — reserve huge page sẵn qua
vm.nr_hugepagesrồi tắt THP an toàn hơn; nhớ đây là tối ưu CPU/độ trễ cho server shared_buffers lớn.
Phần sau ta quay lại một chỉ số ai cũng nhìn nhưng hay hiểu sai: Phần sau mổ xẻ cache hit ratio — vì sao con số 99% có thể đánh lừa, cách đọc pg_statio đúng, và khi nào hit ratio cao vẫn là dấu hiệu xấu.
