Hai bài trước chỉnh cách planner ước lượng chi phí (effective_cache_size, random_page_cost). effective_io_concurrency thì khác: nó không đổi kế hoạch, nó đổi cách PostgreSQL thực thi việc đọc đĩa trong một Bitmap Heap Scan — cho phép nạp trước nhiều trang song song. Đây là một tham số SSD rất đáng bật. Nhưng bài này còn có một bài học lớn hơn cả bản thân tham số: tôi sẽ cho bạn thấy một phép đo thật mà eic=1 và eic=200 cho kết quả y hệt nhau — và vì sao đó chính là điều bạn phải hiểu để benchmark nó cho đúng.
effective_io_concurrency làm gì
Khi PostgreSQL chạy một Bitmap Heap Scan, nó có một lợi thế đặc biệt: từ bitmap dựng ở bước index, nó biết trước toàn bộ danh sách trang heap cần đọc. effective_io_concurrency (mặc định 1) nói cho nó biết được phép phát bao nhiêu yêu cầu đọc song song cho danh sách đó — qua lời gọi posix_fadvise(POSIX_FADV_WILLNEED) báo hệ điều hành nạp trước các trang. Thay vì đọc từng trang một rồi chờ, nó bảo HĐH "nạp trước 200 trang này đi" và xử lý các trang đến trước trong khi phần còn lại đang được đọc.
SHOW effective_io_concurrency; -- mặc định 1 (gần như tắt prefetch)
Điểm mấu chốt: nó chỉ áp dụng cho Bitmap Heap Scan. Seq Scan dựa vào cơ chế readahead của HĐH; Index Scan thuần đi lắt nhắt từng dòng nên không prefetch hàng loạt được. Chỉ Bitmap Heap Scan mới biết trước cả tập trang để nạp song song hiệu quả.
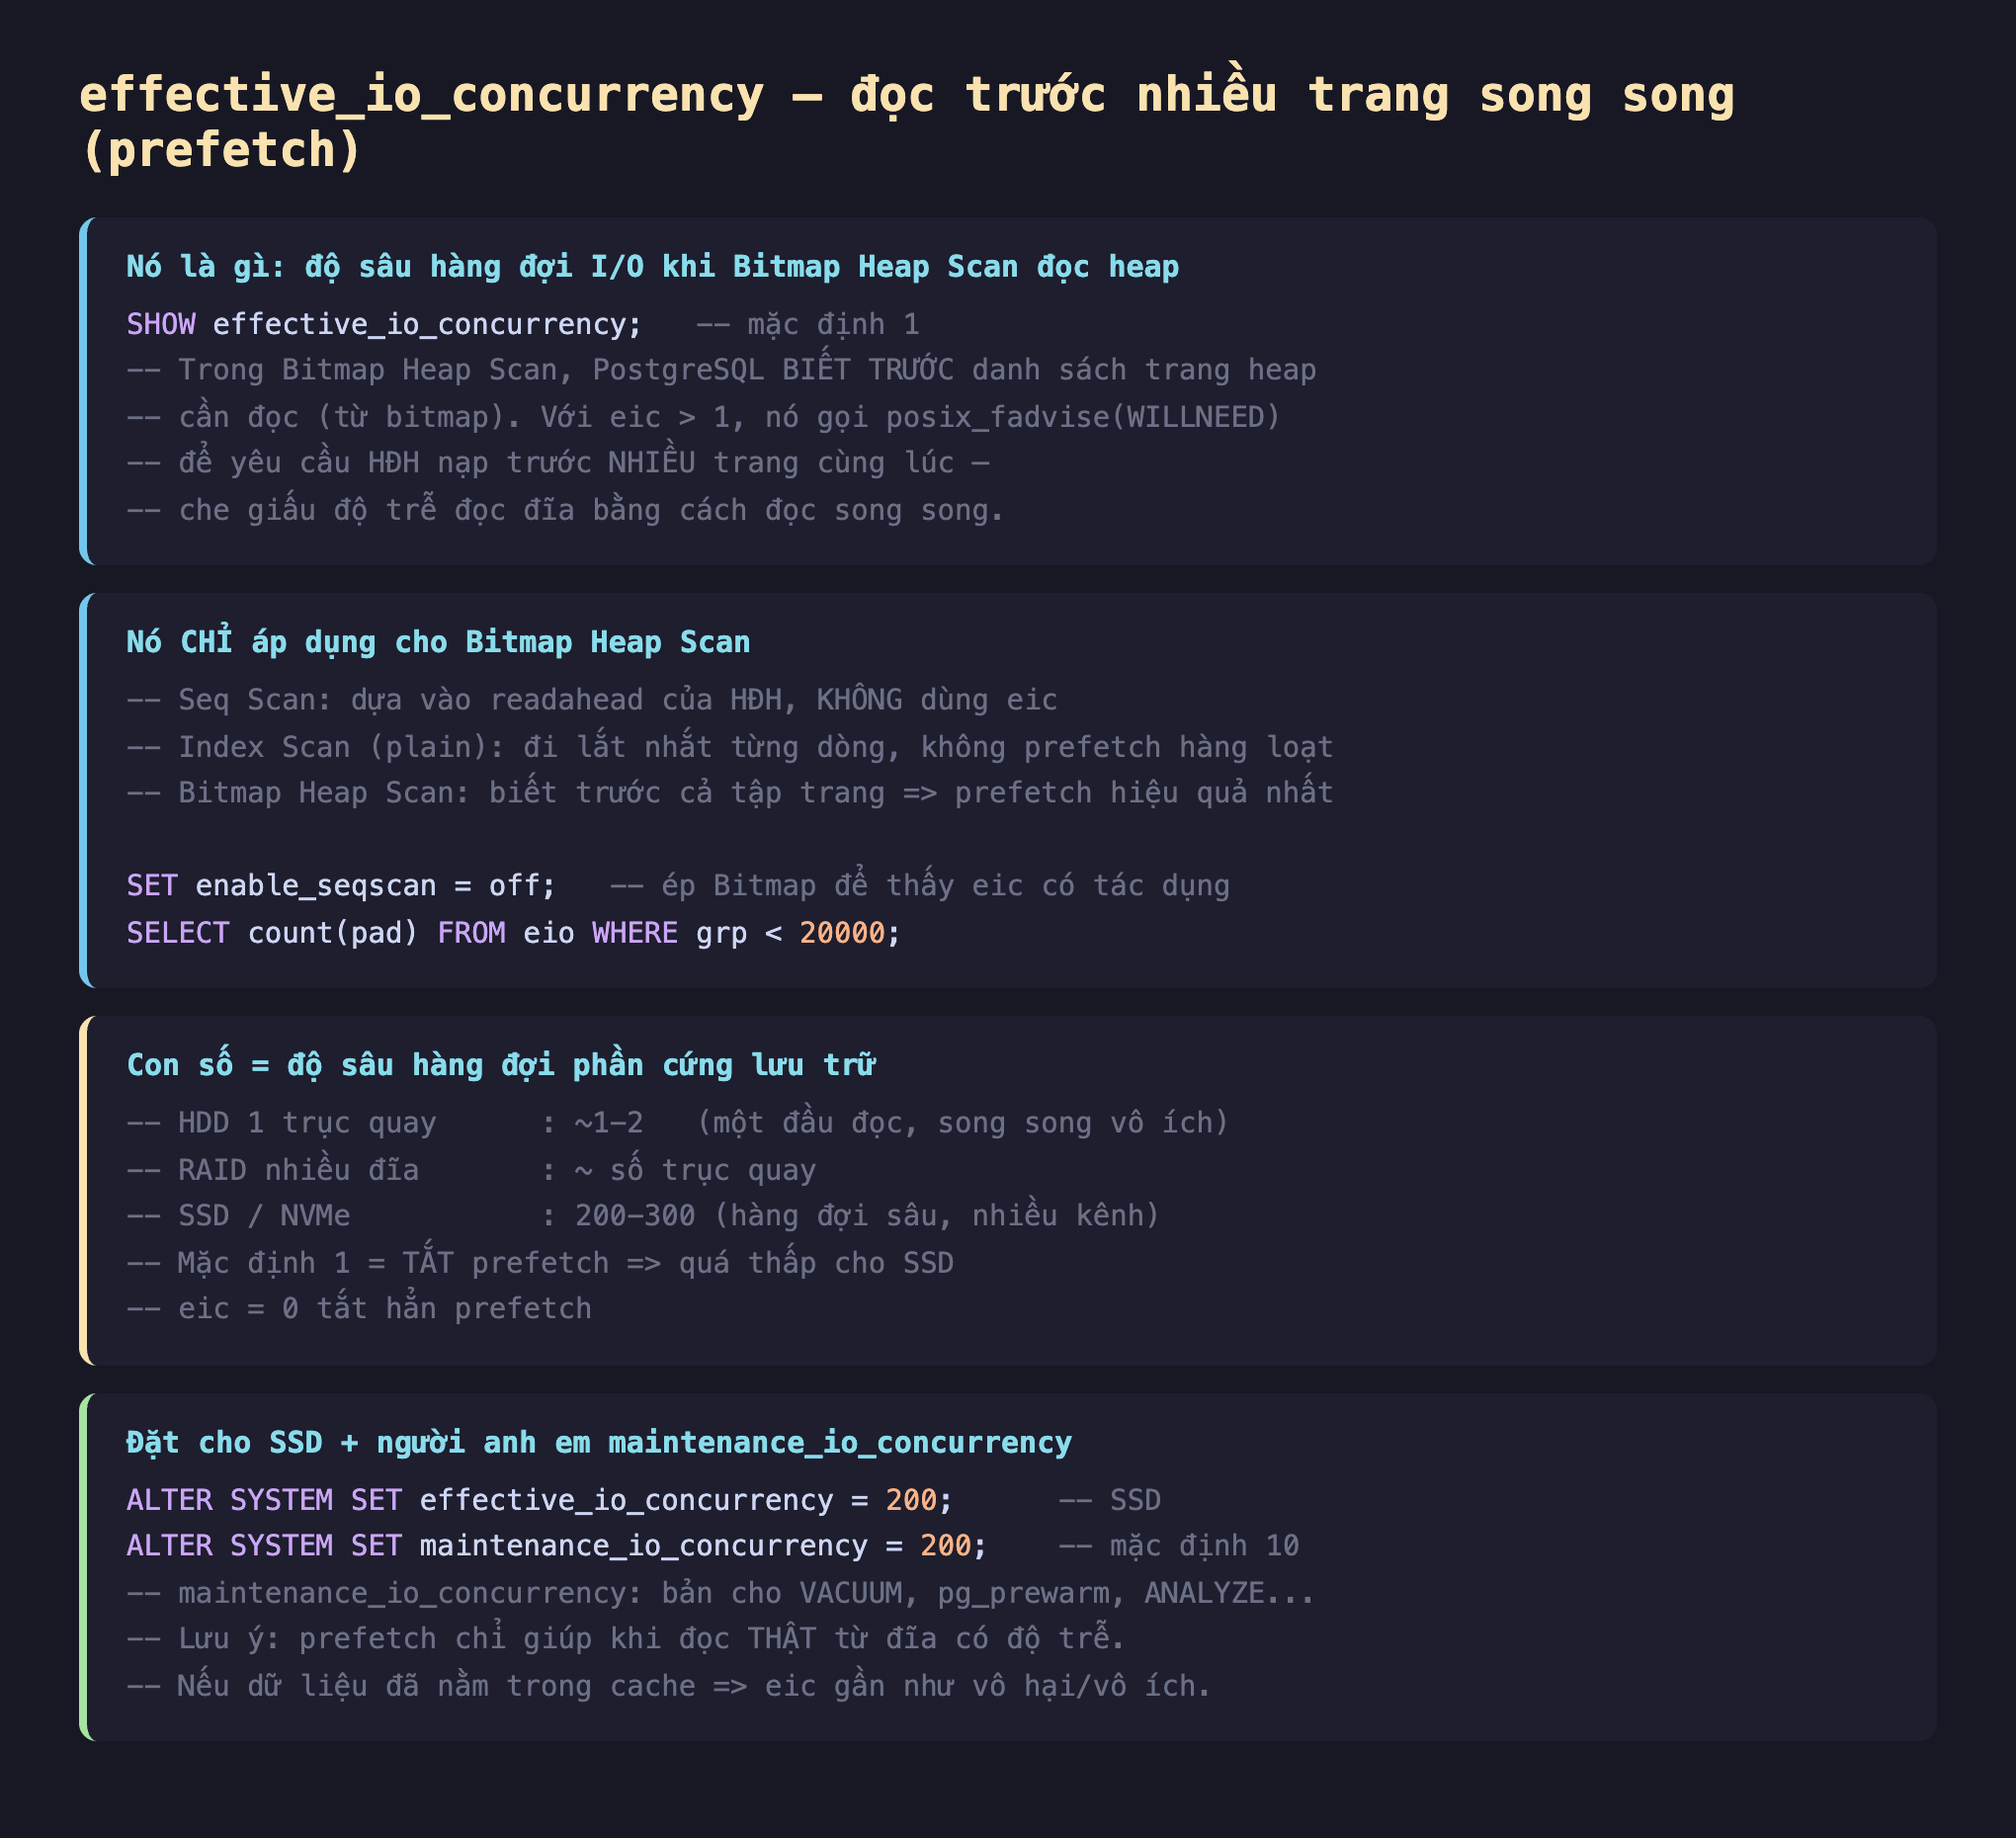
Hình 1: effective_io_concurrency cho phép Bitmap Heap Scan nạp trước nhiều trang heap song song qua posix_fadvise. Con số phản ánh độ sâu hàng đợi I/O của phần cứng — SSD 200-300, HDD ~1. Mặc định 1 là tắt prefetch.
Đo thật: eic=1 và eic=200 cho thời gian y hệt
Tôi dựng bảng eio 1,9GB (8 triệu dòng, lớn hơn nhiều shared_buffers 128MB) với cột grp rải rác khắp bảng. Truy vấn grp < 20000 khớp 320.000 dòng nằm rải rác — buộc Bitmap Heap Scan phải đọc hàng nghìn trang heap ở khắp nơi. Để bắt đầu từ cache nguội, tôi restart container trước mỗi lần đo (xoá sạch shared_buffers), và ép Bitmap Heap Scan bằng enable_seqscan=off:
SET enable_seqscan = off;
SELECT count(pad) FROM eio WHERE grp < 20000;   -- Bitmap Heap Scan, read=10121 trang
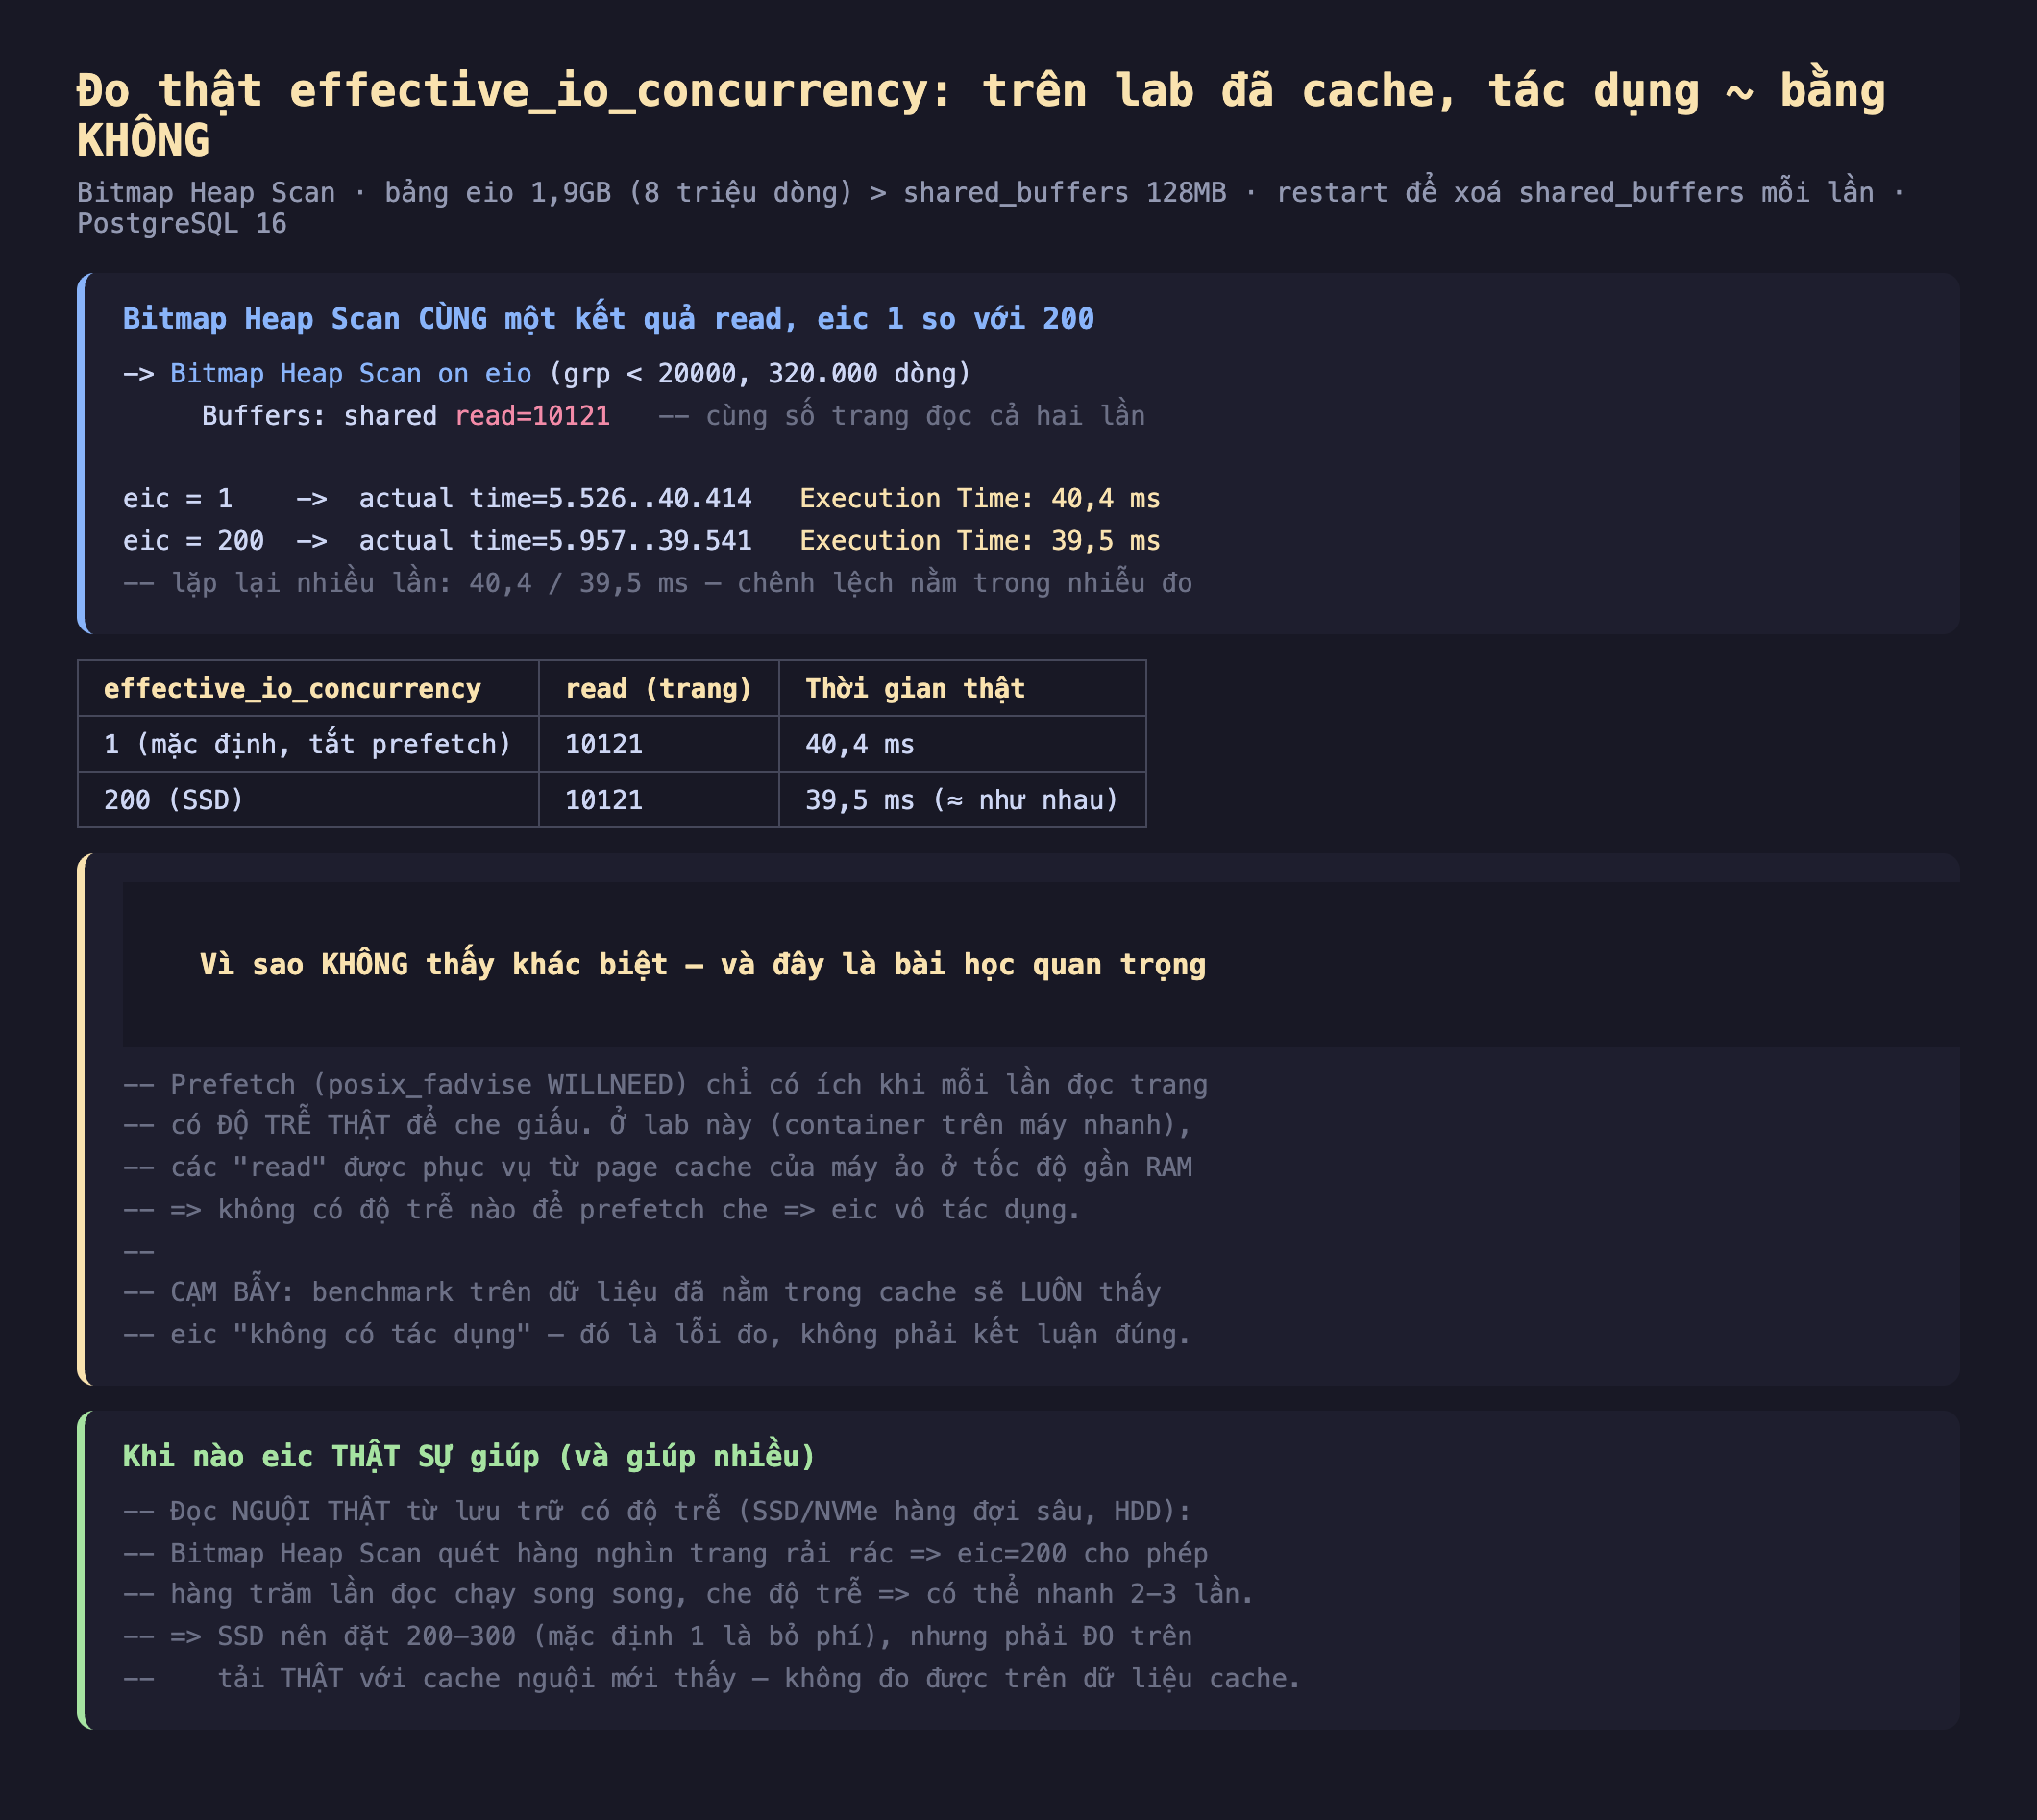
Hình 2: Bitmap Heap Scan đọc read=10121 trang. eic=1 → 40,4 ms; eic=200 → 39,5 ms — chênh lệch nằm trong nhiễu đo. Trên lab đã cache, prefetch không có độ trễ nào để che nên tác dụng gần như bằng không.
Kết quả trung thực: eic=1 cho 40,4 ms, eic=200 cho 39,5 ms — cùng read=10121 trang, chênh lệch nằm trong sai số đo. Lặp lại nhiều lần vẫn vậy. Trên lab này, effective_io_concurrency không có tác dụng đo được.
Vì sao không thấy khác biệt — và bài học benchmark
Đây mới là phần đáng giá. Prefetch chỉ có ích khi mỗi lần đọc trang có độ trễ thật để che giấu. Container này chạy trên máy nhanh, và các trang "read" mà PostgreSQL báo thật ra được phục vụ từ page cache của máy ảo ở tốc độ gần RAM. Khi mỗi lần đọc gần như tức thì, posix_fadvise(WILLNEED) chẳng có độ trễ nào để giấu — nó thành lời khuyên vô nghĩa. Tệ hơn, prefetch một trang đã nằm trong cache là thao tác không làm gì cả.
Bài học: benchmark effective_io_concurrency trên dữ liệu đã nằm trong cache sẽ LUÔN cho kết quả "không có tác dụng" — và đó là lỗi phương pháp đo, không phải kết luận đúng về tham số. Rất nhiều người kết luận nhầm "eic vô dụng" chỉ vì họ đo trên dữ liệu nóng. Tham số này chỉ bộc lộ giá trị khi đọc nguội thật từ lưu trữ có độ trễ thật.
Khi nào eic thật sự giúp
Trên storage thật với độ trễ mỗi lần đọc đáng kể — HDD, hay SSD/NVMe khi khai thác hàng đợi sâu — một Bitmap Heap Scan quét hàng nghìn trang rải rác được lợi rõ: eic=200 cho phép hàng trăm lần đọc chạy song song, che độ trễ chồng lên nhau, có thể nhanh gấp 2-3 lần so với đọc tuần tự từng trang. Con số nên phản ánh độ sâu hàng đợi của thiết bị:
ALTER SYSTEM SET effective_io_concurrency = 200;      -- SSD/NVMe
ALTER SYSTEM SET maintenance_io_concurrency = 200;    -- mặc định 10, cho VACUUM/prewarm
SELECT pg_reload_conf();
Có một người anh em ít biết: maintenance_io_concurrency (mặc định 10) là biến thể dùng cho công việc bảo trì — VACUUM, pg_prewarm, một số thao tác ANALYZE. Trên SSD cũng nên nâng nó lên tương ứng.
Đánh đổi cần cân nhắc
Trên HDD một trục quay, để mặc định 1. Đĩa cơ chỉ có một đầu đọc; phát nhiều yêu cầu song song không giúp gì mà còn có thể làm đầu đọc nhảy loạn. Giá trị cao chỉ hợp với thiết bị thật sự xử lý song song được (RAID nhiều trục, SSD nhiều kênh).
Đây không phải song song hoá truy vấn. effective_io_concurrency chỉ là prefetch I/O trong một tiến trình, khác hẳn parallel query (max_parallel_workers_per_gather) vốn dùng nhiều CPU worker. Đừng nhầm hai thứ.
Phải đo trên tải thật, cache nguội — không đo được trên dữ liệu cache. Như chính lab này cho thấy, nếu working set nằm gọn trong RAM/OS cache thì eic gần như vô hình. Nó chỉ đáng chỉnh khi hệ thống của bạn thường xuyên đọc dữ liệu vượt cache từ đĩa — và cách kiểm chứng đúng là đo trên chính tải đó, sau khi cache nguội, không phải trên bảng vừa quét xong.
Ba ý mang về
- effective_io_concurrency cho Bitmap Heap Scan nạp trước nhiều trang heap song song qua
posix_fadvise— nó biết trước cả tập trang từ bitmap; mặc định 1 tắt prefetch, SSD nên đặt 200-300 (vàmaintenance_io_concurrencycho VACUUM/prewarm). - Đo thật trên lab đã cache: eic=1 và eic=200 cho thời gian y hệt (40,4 so với 39,5 ms, cùng read=10121) — vì prefetch chỉ che được độ trễ đọc đĩa thật, mà ở đây reads phục vụ từ page cache ở tốc độ gần RAM nên không có gì để che.
- Bài học benchmark: đo eic trên dữ liệu đã cache sẽ luôn thấy nó "vô dụng" — đó là lỗi phương pháp; tham số chỉ bộc lộ giá trị (có thể 2-3 lần) khi đọc nguội thật từ storage có độ trễ, và chỉ trên HDD một trục quay mới nên để mặc định 1.
Phần sau ta chuyển sang mảng ghi và độ bền: Phần sau mổ xẻ WAL và checkpoint — vì sao mọi thay đổi ghi vào WAL trước, checkpoint dồn ghi ra sao, và chỉnh chúng thế nào để tránh sốc I/O.
