Bài trước nói về effective_cache_size — một gợi ý ảnh hưởng planner. random_page_cost cũng là tham số cost, nhưng nó gắn thẳng với loại phần cứng lưu trữ bạn đang chạy. Đây có lẽ là tham số cost quan trọng nhất mà rất nhiều hệ thống để nguyên mặc định một cách sai lầm: giá trị mặc định 4.0 được chọn cho ổ cứng cơ (HDD) từ thời PostgreSQL còn non trẻ, và trên SSD hiện đại nó khiến planner né index một cách oan uổng. Bài này đo thật cái giá của việc để mặc định trên SSD.
random_page_cost là một tỉ số
Điều quan trọng đầu tiên: random_page_cost không phải một đơn vị thời gian tuyệt đối. Nó là một tỉ số so với seq_page_cost (mặc định 1.0):
SHOW random_page_cost;   -- mặc định 4.0
SHOW seq_page_cost;      -- mặc định 1.0 (mốc quy chiếu)
-- 4.0 nghĩa là: đọc một trang NGẪU NHIÊN được planner coi là
-- đắt gấp 4 lần đọc một trang TUẦN TỰ.
Con số 4.0 phản ánh vật lý của ổ cứng cơ: để đọc một trang ngẫu nhiên, đầu đọc phải nhấc lên và di chuyển tới đúng track — thời gian seek. Đọc tuần tự thì đầu đọc trượt liền một mạch, nhanh hơn nhiều. Tỉ số ~4 là hợp lý cho HDD.
Nhưng SSD/NVMe không có đầu đọc cơ học. Đọc ngẫu nhiên gần như ngang đọc tuần tự. Tỉ số thật trên SSD gần 1.0-1.5, không phải 4.0. Để mặc định 4.0 trên SSD nghĩa là bạn đang nói dối planner rằng random read đắt gấp 4 — và nó sẽ thiên về Seq Scan quét cả bảng ngay cả khi một Index Scan tốt hơn nhiều.
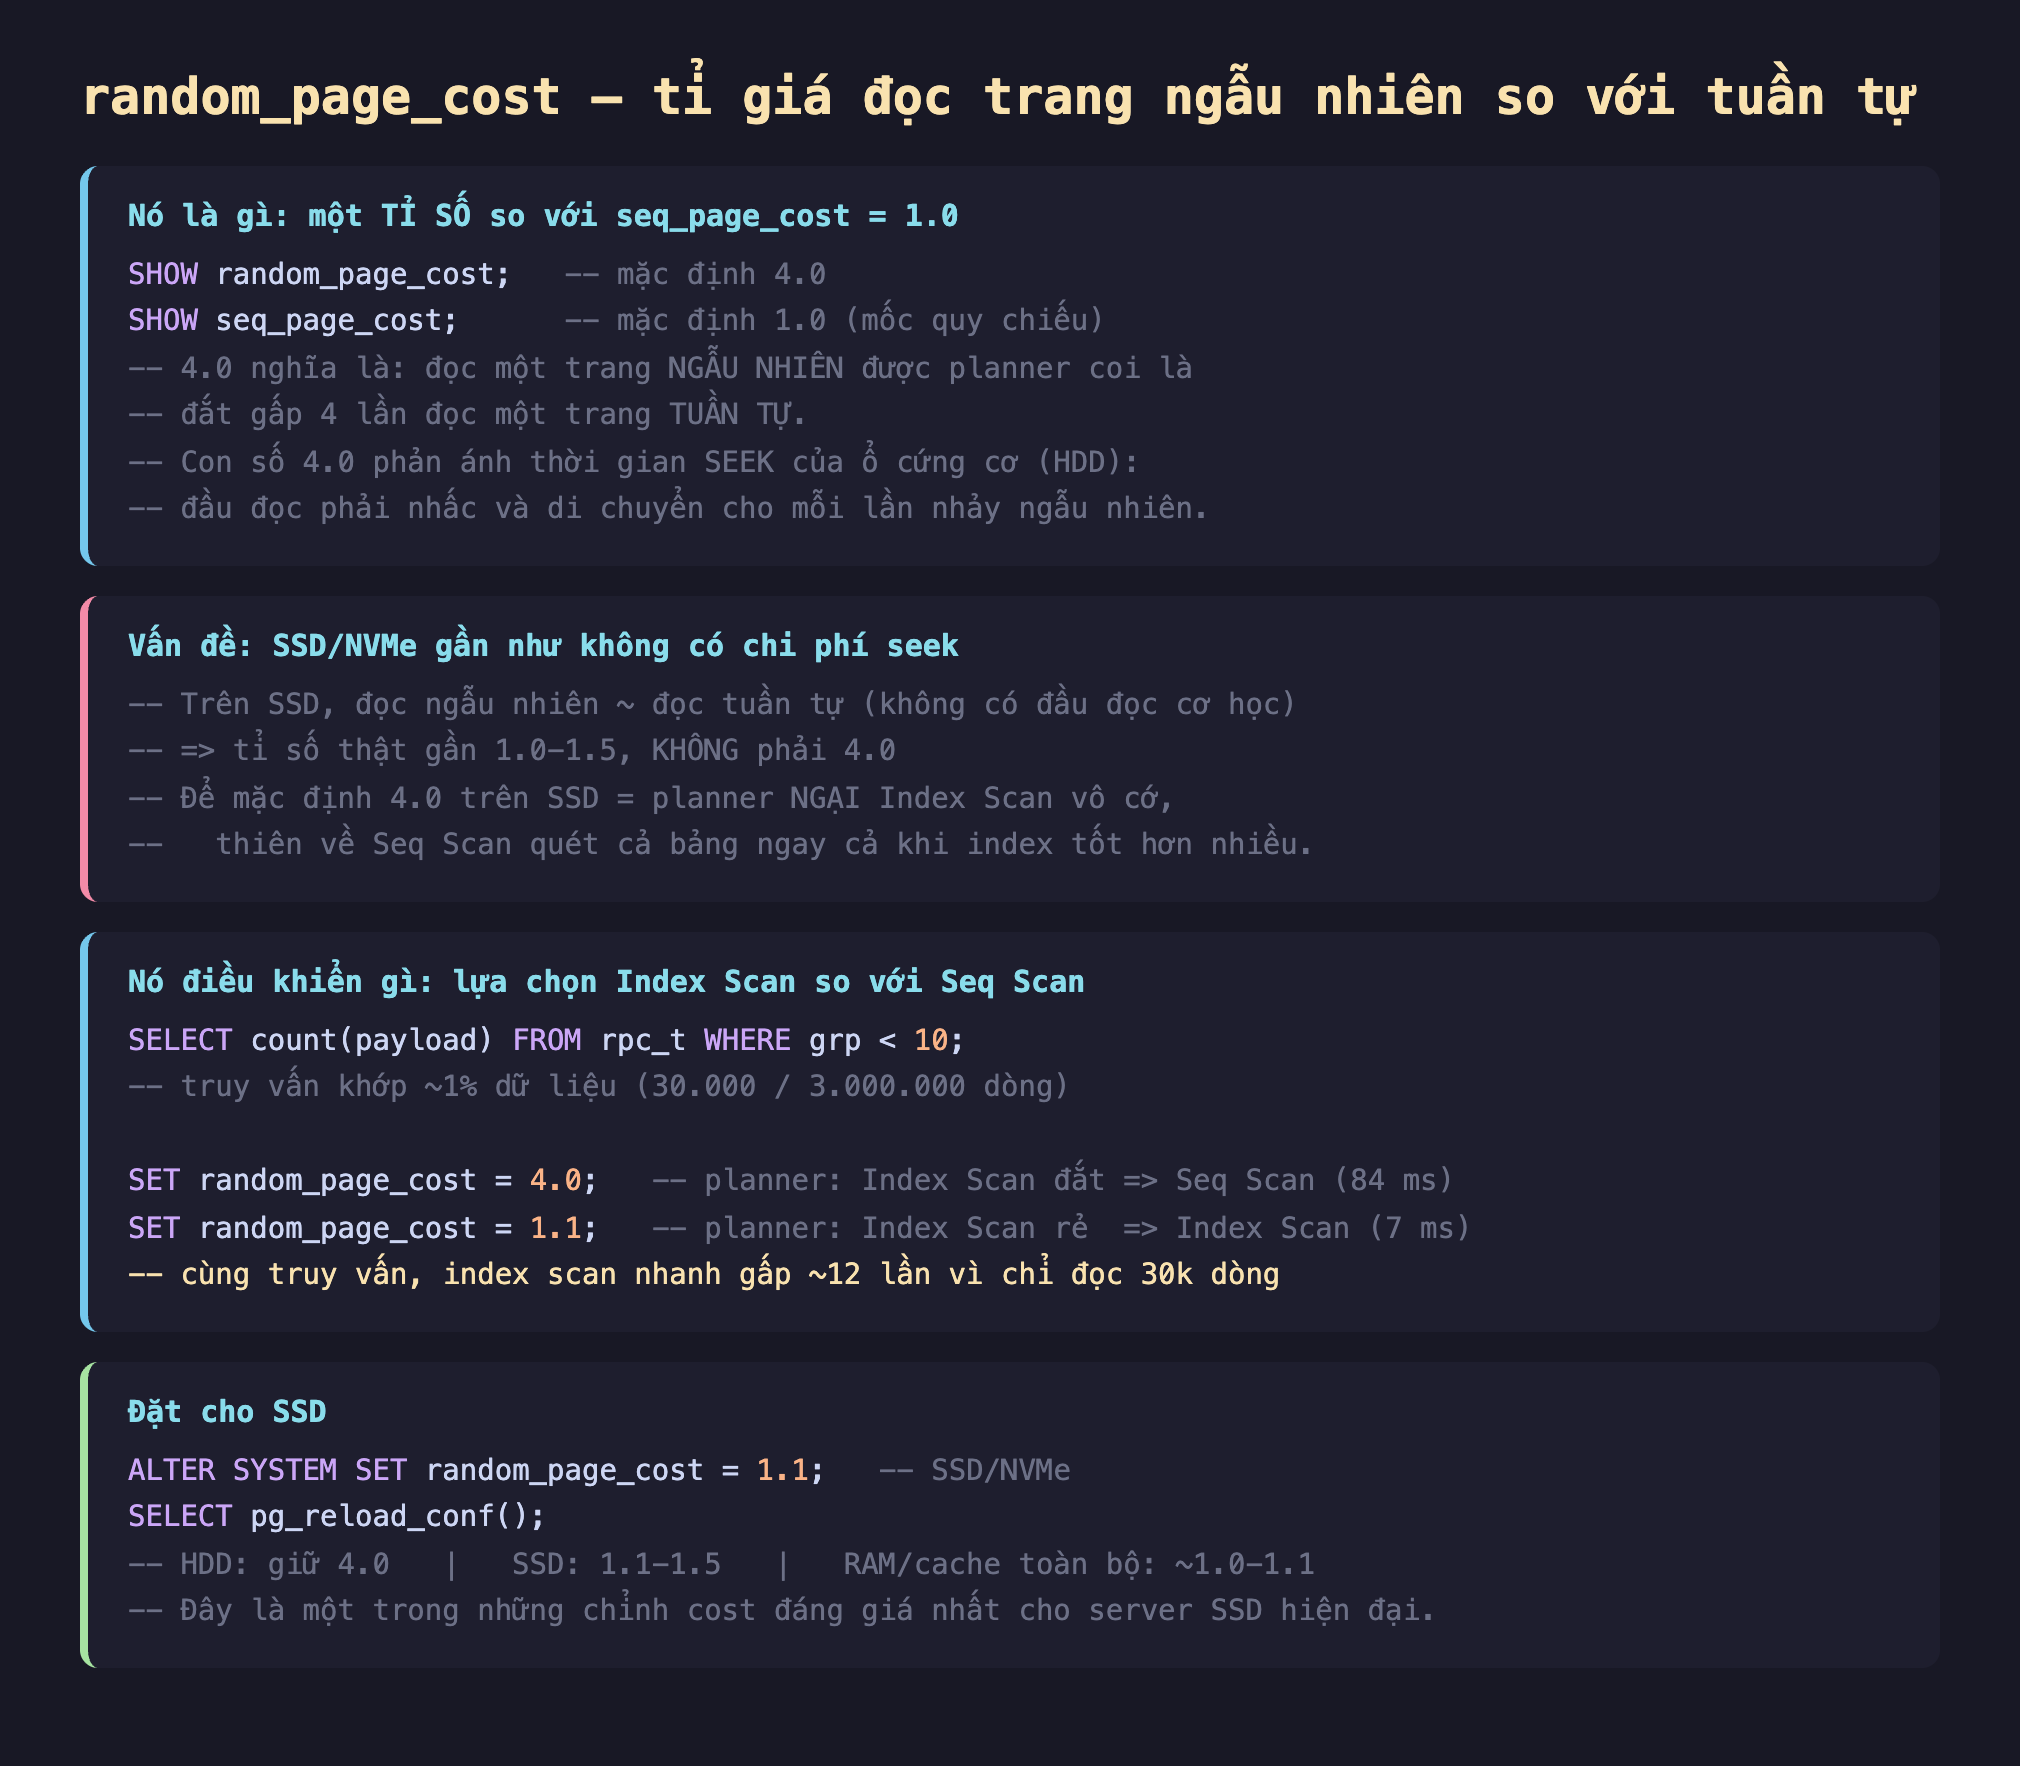
Hình 1: random_page_cost là tỉ số so với seq_page_cost=1.0. Mặc định 4.0 phản ánh thời gian seek của HDD; SSD gần như không có seek nên tỉ số thật gần 1.0-1.5. Nó điều khiển lựa chọn Index Scan so với Seq Scan.
Đo thật: 84 ms hay 7 ms
Tôi dựng bảng rpc_t 3 triệu dòng với cột grp (1.000 nhóm, mỗi nhóm ~3.000 dòng, có index). Truy vấn khớp ~1% dữ liệu (grp < 10, tức 30.000 dòng), chỉ đổi random_page_cost:
SELECT count(payload) FROM rpc_t WHERE grp < 10; -- khớp ~1% (30k/3M dòng)
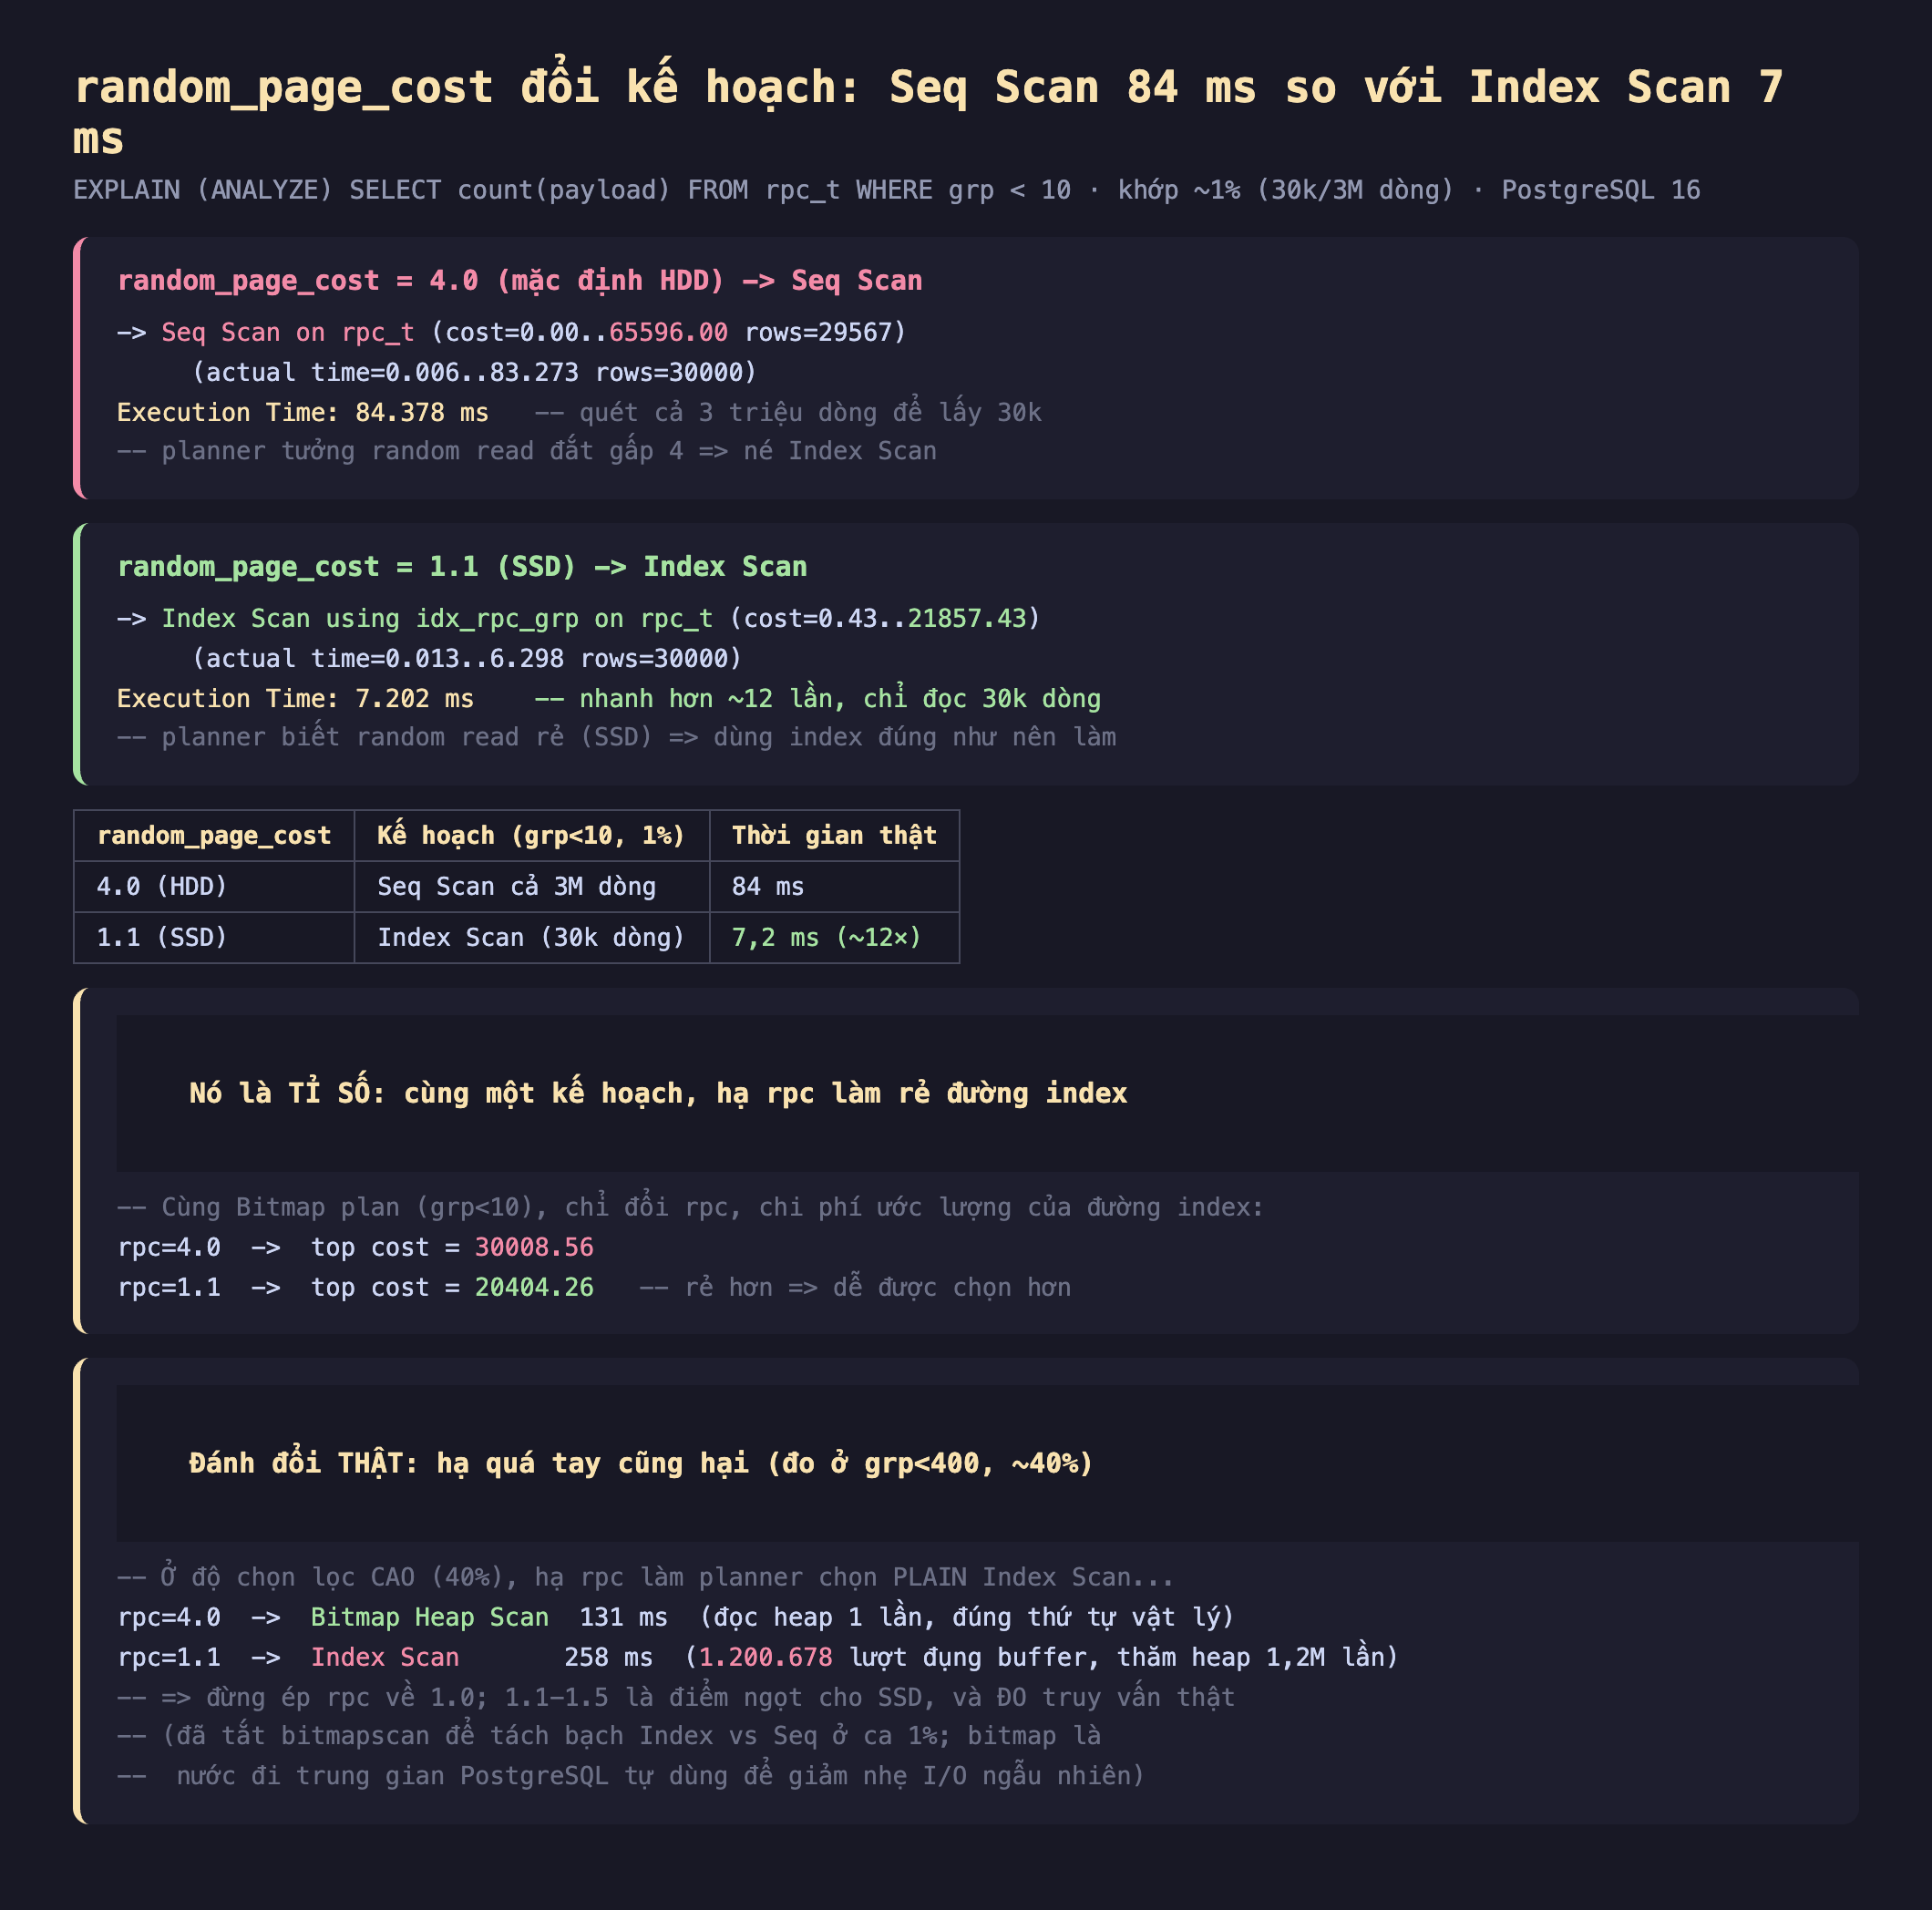
Hình 2: random_page_cost=4.0 → Seq Scan quét cả 3M dòng, 84 ms. random_page_cost=1.1 → Index Scan chỉ đọc 30k dòng, 7,2 ms — nhanh gấp ~12 lần. Cùng kế hoạch, hạ rpc làm chi phí đường index rẻ đi (30008→20404). Nhưng hạ quá tay ở 40% selectivity lại hại.
- random_page_cost = 4.0: planner tin random read đắt gấp 4, nên với 30.000 lần tra index (mỗi lần một trang heap ngẫu nhiên) nó kết luận thà quét tuần tự cả 3 triệu dòng —
Seq Scan, 84 ms. - random_page_cost = 1.1: planner biết random read rẻ, chọn Index Scan chỉ đọc đúng 30.000 dòng — 7,2 ms, nhanh gấp ~12 lần.
Trên SSD, rpc=1.1 là con số đúng với thực tế phần cứng, và nó dẫn tới kế hoạch đúng. Con số 4.0 mặc định đã lừa planner né index một cách oan uổng.
(Lưu ý trung thực: tôi tắt enable_bitmapscan ở ca 1% để tách bạch lựa chọn Index Scan so với Seq Scan. Trong đời thực, PostgreSQL thường tự chọn Bitmap Heap Scan — một nước đi trung gian gom các trang heap rồi đọc gần như tuần tự, chính là để giảm nhẹ chi phí I/O ngẫu nhiên. Bitmap scan làm cho các cú lật hẳn sang Seq Scan hiếm hơn, nhưng random_page_cost vẫn quyết định ranh giới Index/Bitmap và toàn bộ chi phí đường index.)
Nó là tỉ số: hạ rpc làm rẻ mọi đường index
Ngay cả khi kế hoạch không đổi, random_page_cost vẫn thay đổi chi phí ước lượng của các đường dùng index. Trên cùng một Bitmap plan (grp < 10), chỉ đổi rpc: chi phí đỉnh từ 30008.56 (rpc=4.0) xuống 20404.26 (rpc=1.1). Đường index rẻ hơn nghĩa là ở mọi truy vấn ranh giới, planner dễ chọn index hơn. Đó là hiệu ứng lan tỏa của việc hạ rpc trên toàn bộ tải công việc.
Cách đặt cho SSD:
ALTER SYSTEM SET random_page_cost = 1.1;   -- SSD/NVMe
SELECT pg_reload_conf();
-- HDD: giữ 4.0  |  SSD: 1.1-1.5  |  dữ liệu nằm gần hết trong RAM: ~1.0-1.1
Đánh đổi cần cân nhắc
Đừng ép rpc về 1.0 — hạ quá tay cũng hại. Đây là phát hiện đo thật quan trọng: ở độ chọn lọc cao (grp < 400, ~40% dữ liệu), hạ rpc xuống 1.1 làm planner chọn plain Index Scan (258 ms) thay vì Bitmap Heap Scan (131 ms) — chậm gấp đôi! Vì plain Index Scan thăm heap một lần cho mỗi dòng (1.200.678 lượt đụng buffer), còn Bitmap Heap Scan đọc mỗi trang heap đúng một lần theo thứ tự vật lý. Khi rpc quá thấp, planner đánh giá thấp cái giá của việc thăm heap lộn xộn. 1.1-1.5 là điểm ngọt cho SSD, không phải 1.0.
Luôn đo với truy vấn thật của bạn. Giá trị tối ưu phụ thuộc phần cứng và tỉ lệ cache. Nếu dữ liệu nóng nằm gần hết trong RAM (shared_buffers + OS cache), thì mọi read đều là cache hit và tỉ số random/sequential thật càng gần 1.0 — nhưng cách chuẩn là đo EXPLAIN ANALYZE trên tải thật, không đoán.
random_page_cost đi cặp với effective_cache_size. Hai tham số này cùng định hình quyết định index-vs-seq: effective_cache_size cho biết bao nhiêu dữ liệu nằm trong cache, random_page_cost cho biết đọc ngoài cache đắt cỡ nào. Chỉnh một cái mà quên cái kia thì mô hình cost vẫn lệch.
Ba ý mang về
- random_page_cost là tỉ số so với seq_page_cost=1.0: mặc định 4.0 phản ánh thời gian seek của ổ cứng cơ HDD; SSD gần như không có seek nên tỉ số thật gần 1.0-1.5 — để mặc định 4.0 trên SSD làm planner né index oan.
- Đo thật, để mặc định trên SSD rất đắt: cùng truy vấn khớp 1% dữ liệu, rpc=4.0 quét tuần tự cả 3M dòng mất 84 ms, rpc=1.1 dùng Index Scan chỉ đọc 30k dòng còn 7 ms — nhanh gấp ~12 lần; và hạ rpc làm rẻ chi phí mọi đường index (30008→20404).
- Đừng hạ quá tay — 1.1-1.5 là điểm ngọt: đo thật ở 40% selectivity, rpc quá thấp khiến planner chọn plain Index Scan (258 ms, thăm heap 1,2M lần) thay vì Bitmap Heap Scan (131 ms) — luôn đo truy vấn thật, và nhớ rpc đi cặp với effective_cache_size.
Phần sau ta xét một tham số I/O ít người biết nhưng đáng giá trên SSD: Phần sau mổ xẻ effective_io_concurrency — vì sao nó cho phép Bitmap Heap Scan đọc nhiều trang song song (prefetch), và đặt bao nhiêu cho SSD.
