Bài shared_buffers nói về vùng nhớ PostgreSQL thực sự cấp phát để cache trang. effective_cache_size nghe rất giống — nhưng nó là một con thú hoàn toàn khác, và hiểu nhầm nó là chuyện rất phổ biến. Nó không cấp phát một byte bộ nhớ nào. Nó chỉ là một con số ước lượng mà bạn khai để planner đoán xem: khi một truy vấn đọc đi đọc lại các trang index, những lần đọc đó là cache hit (rẻ) hay đọc đĩa (đắt)? Và đo thật cho thấy con số này đủ sức làm một truy vấn nhanh gấp 26 lần — hoặc chậm gấp 26 lần.
effective_cache_size là một gợi ý, không phải vùng nhớ
Đây là điểm dễ nhầm nhất. shared_buffers và work_mem cấp phát RAM thật. effective_cache_size thì không — nó chỉ nói với planner một điều: "cả hệ thống có khoảng ngần này cache dùng được cho dữ liệu" (gồm shared_buffers cộng page cache của hệ điều hành).
SHOW effective_cache_size;   -- mặc định 4GB
-- KHÔNG cấp phát 4GB. Chỉ nói với planner:
-- "hệ thống có ~4GB cache (shared_buffers + OS page cache)"
Planner dùng con số này trong công thức Mackert-Lohman để ước lượng: với một Index Scan chạy lặp lại nhiều lần (ví dụ vế trong của Nested Loop), có bao nhiêu phần trăm lần đọc trang là cache hit. effective_cache_size càng lớn, planner càng tin các trang index nằm sẵn trong cache, nên nó đánh giá Index Scan lặp lại là rẻ và dám chọn Nested Loop. effective_cache_size nhỏ thì ngược lại — planner sợ mỗi lần tra index là một cú đọc đĩa, nên né Nested Loop và thà quét tuần tự cả bảng một lần.
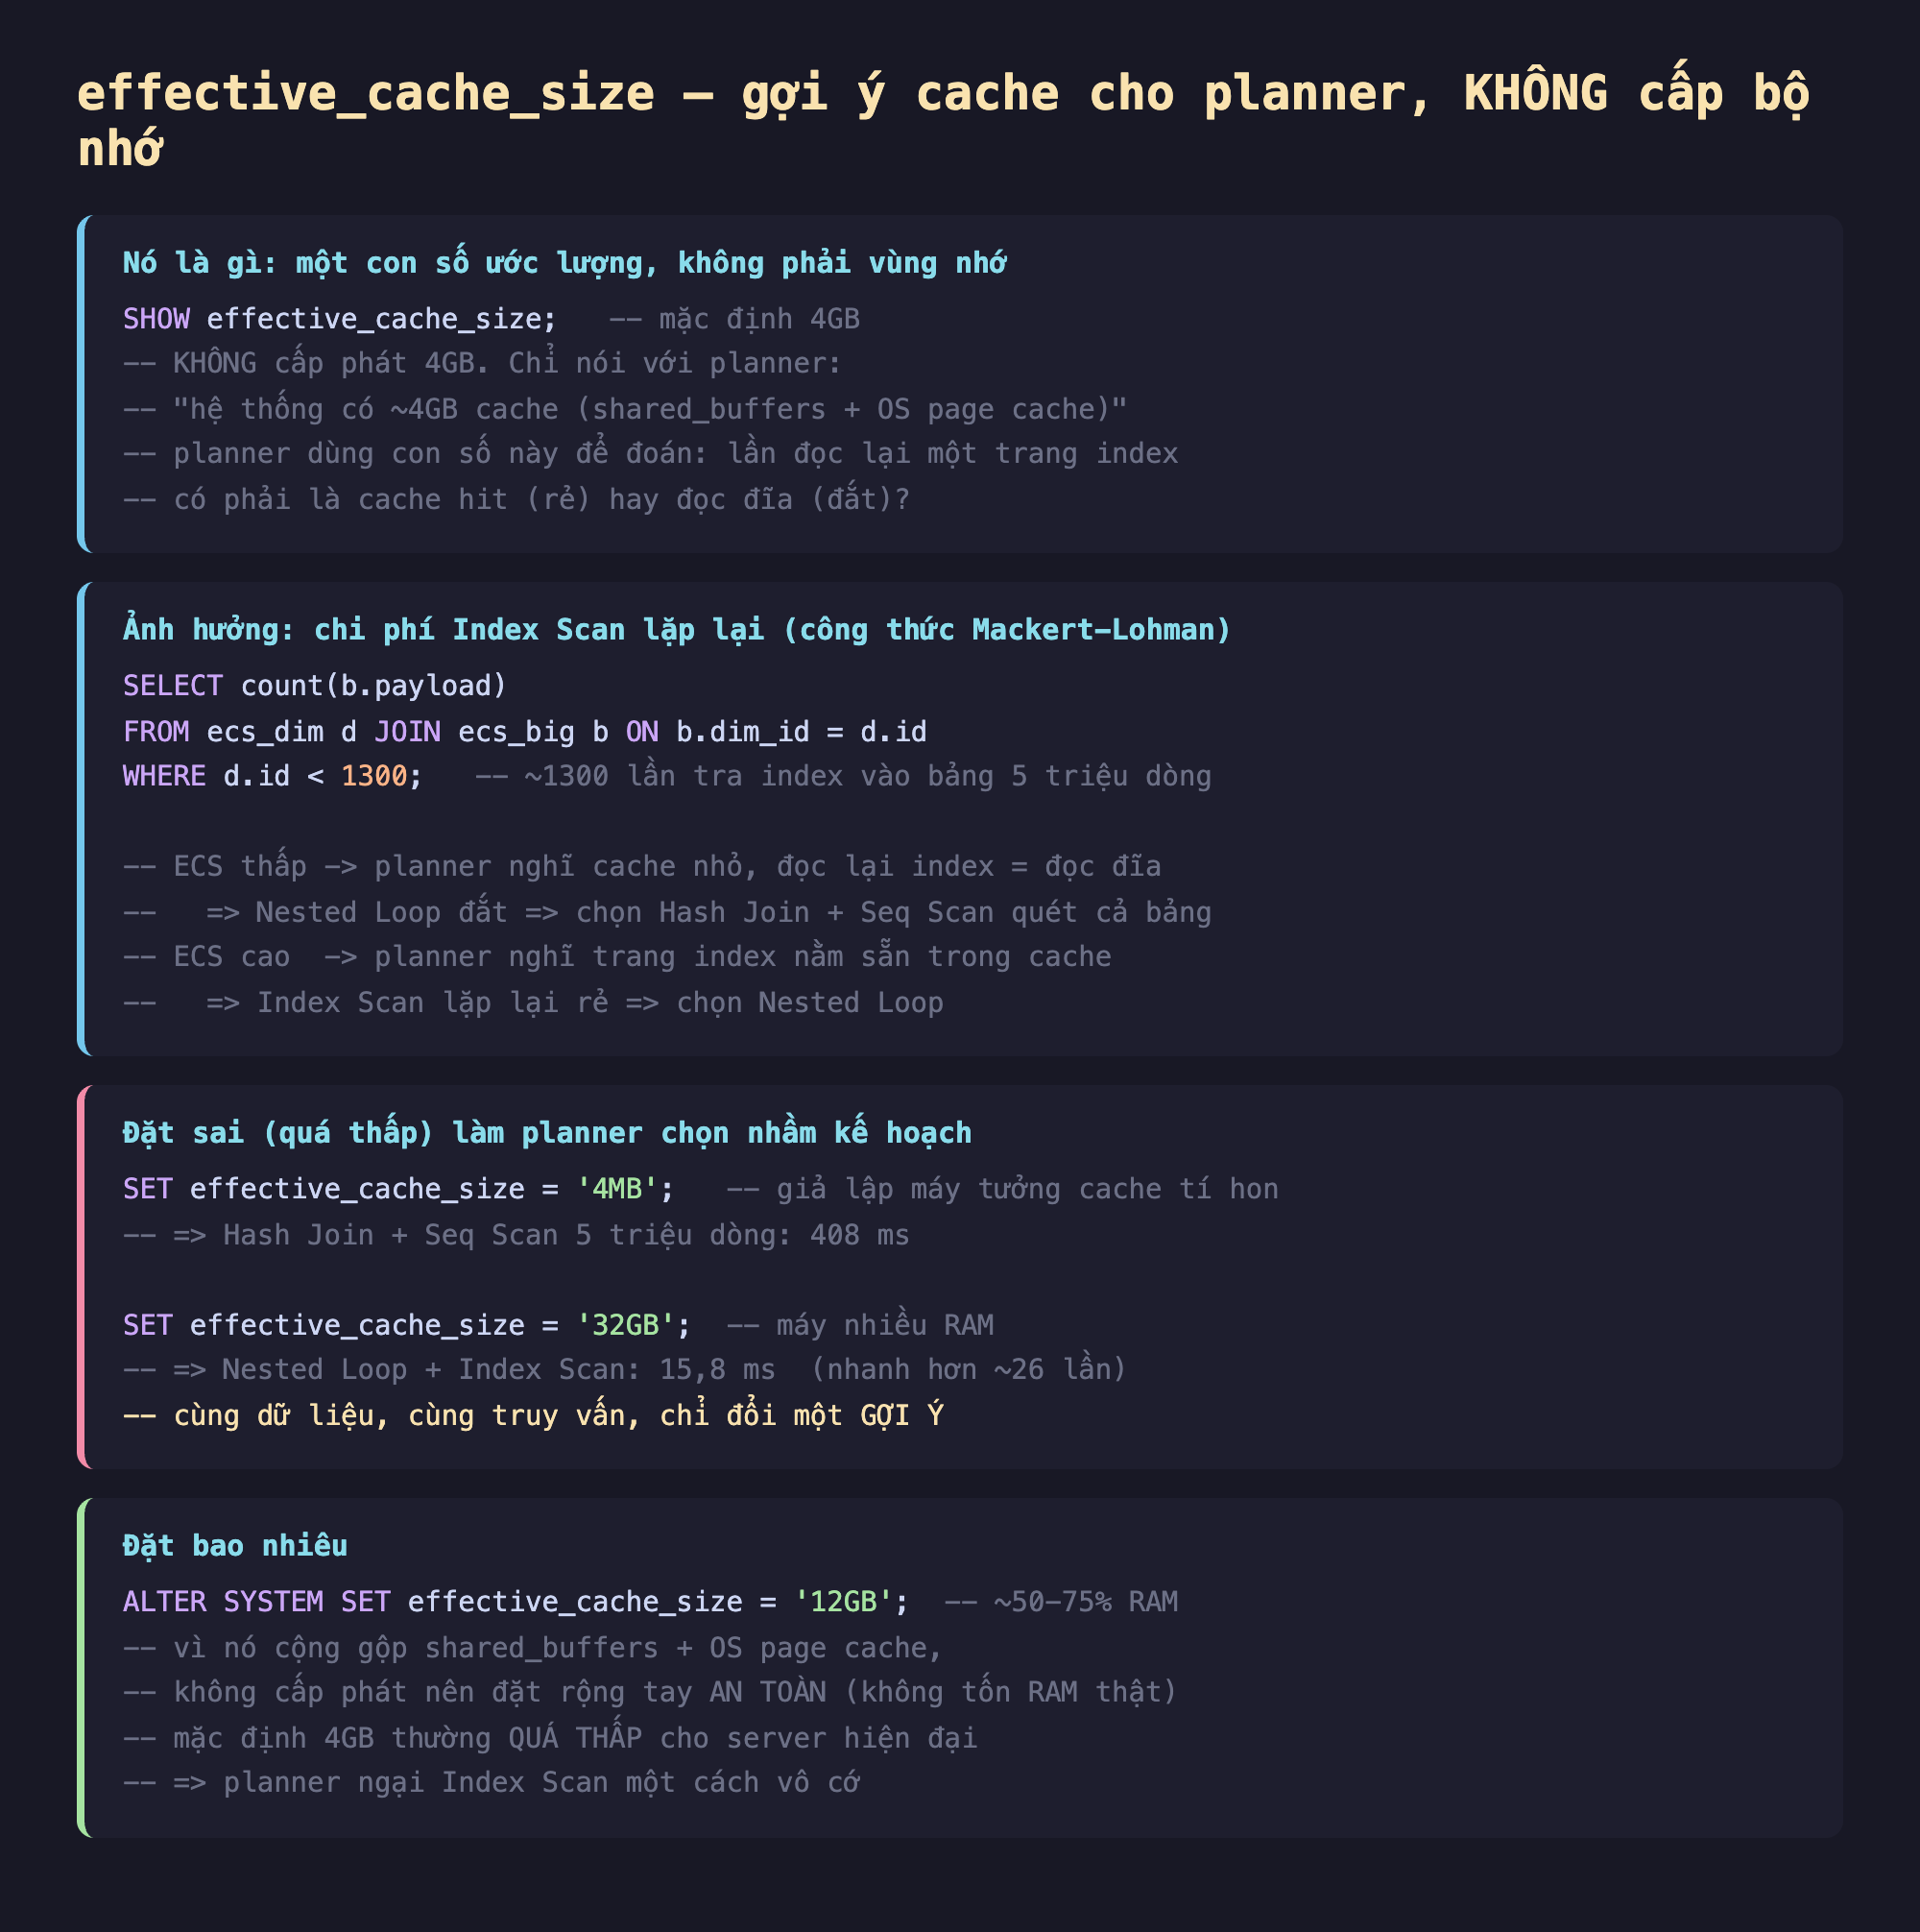
Hình 1: effective_cache_size là gợi ý cho planner (gồm shared_buffers + OS page cache), không cấp phát RAM. Nó điều chỉnh chi phí ước lượng của Index Scan lặp lại, từ đó ảnh hưởng lựa chọn Nested Loop hay Hash Join.
Đo thật: cùng truy vấn, 408 ms hay 15,8 ms
Để thấy tác động, tôi dựng bảng ecs_big 5 triệu dòng (mỗi giá trị dim_id có ~25 dòng, có index trên dim_id) và ecs_dim 200.000 dòng. Truy vấn JOIN một dải nhỏ (~1.300 dòng của ecs_dim) vào bảng lớn — đúng cái ngưỡng mà planner phân vân giữa hai kế hoạch:
SELECT count(b.payload)
FROM ecs_dim d JOIN ecs_big b ON b.dim_id = d.id
WHERE d.id < 1300;
Chỉ đổi một tham số effective_cache_size (không đụng gì khác), planner chọn hai kế hoạch khác hẳn nhau:
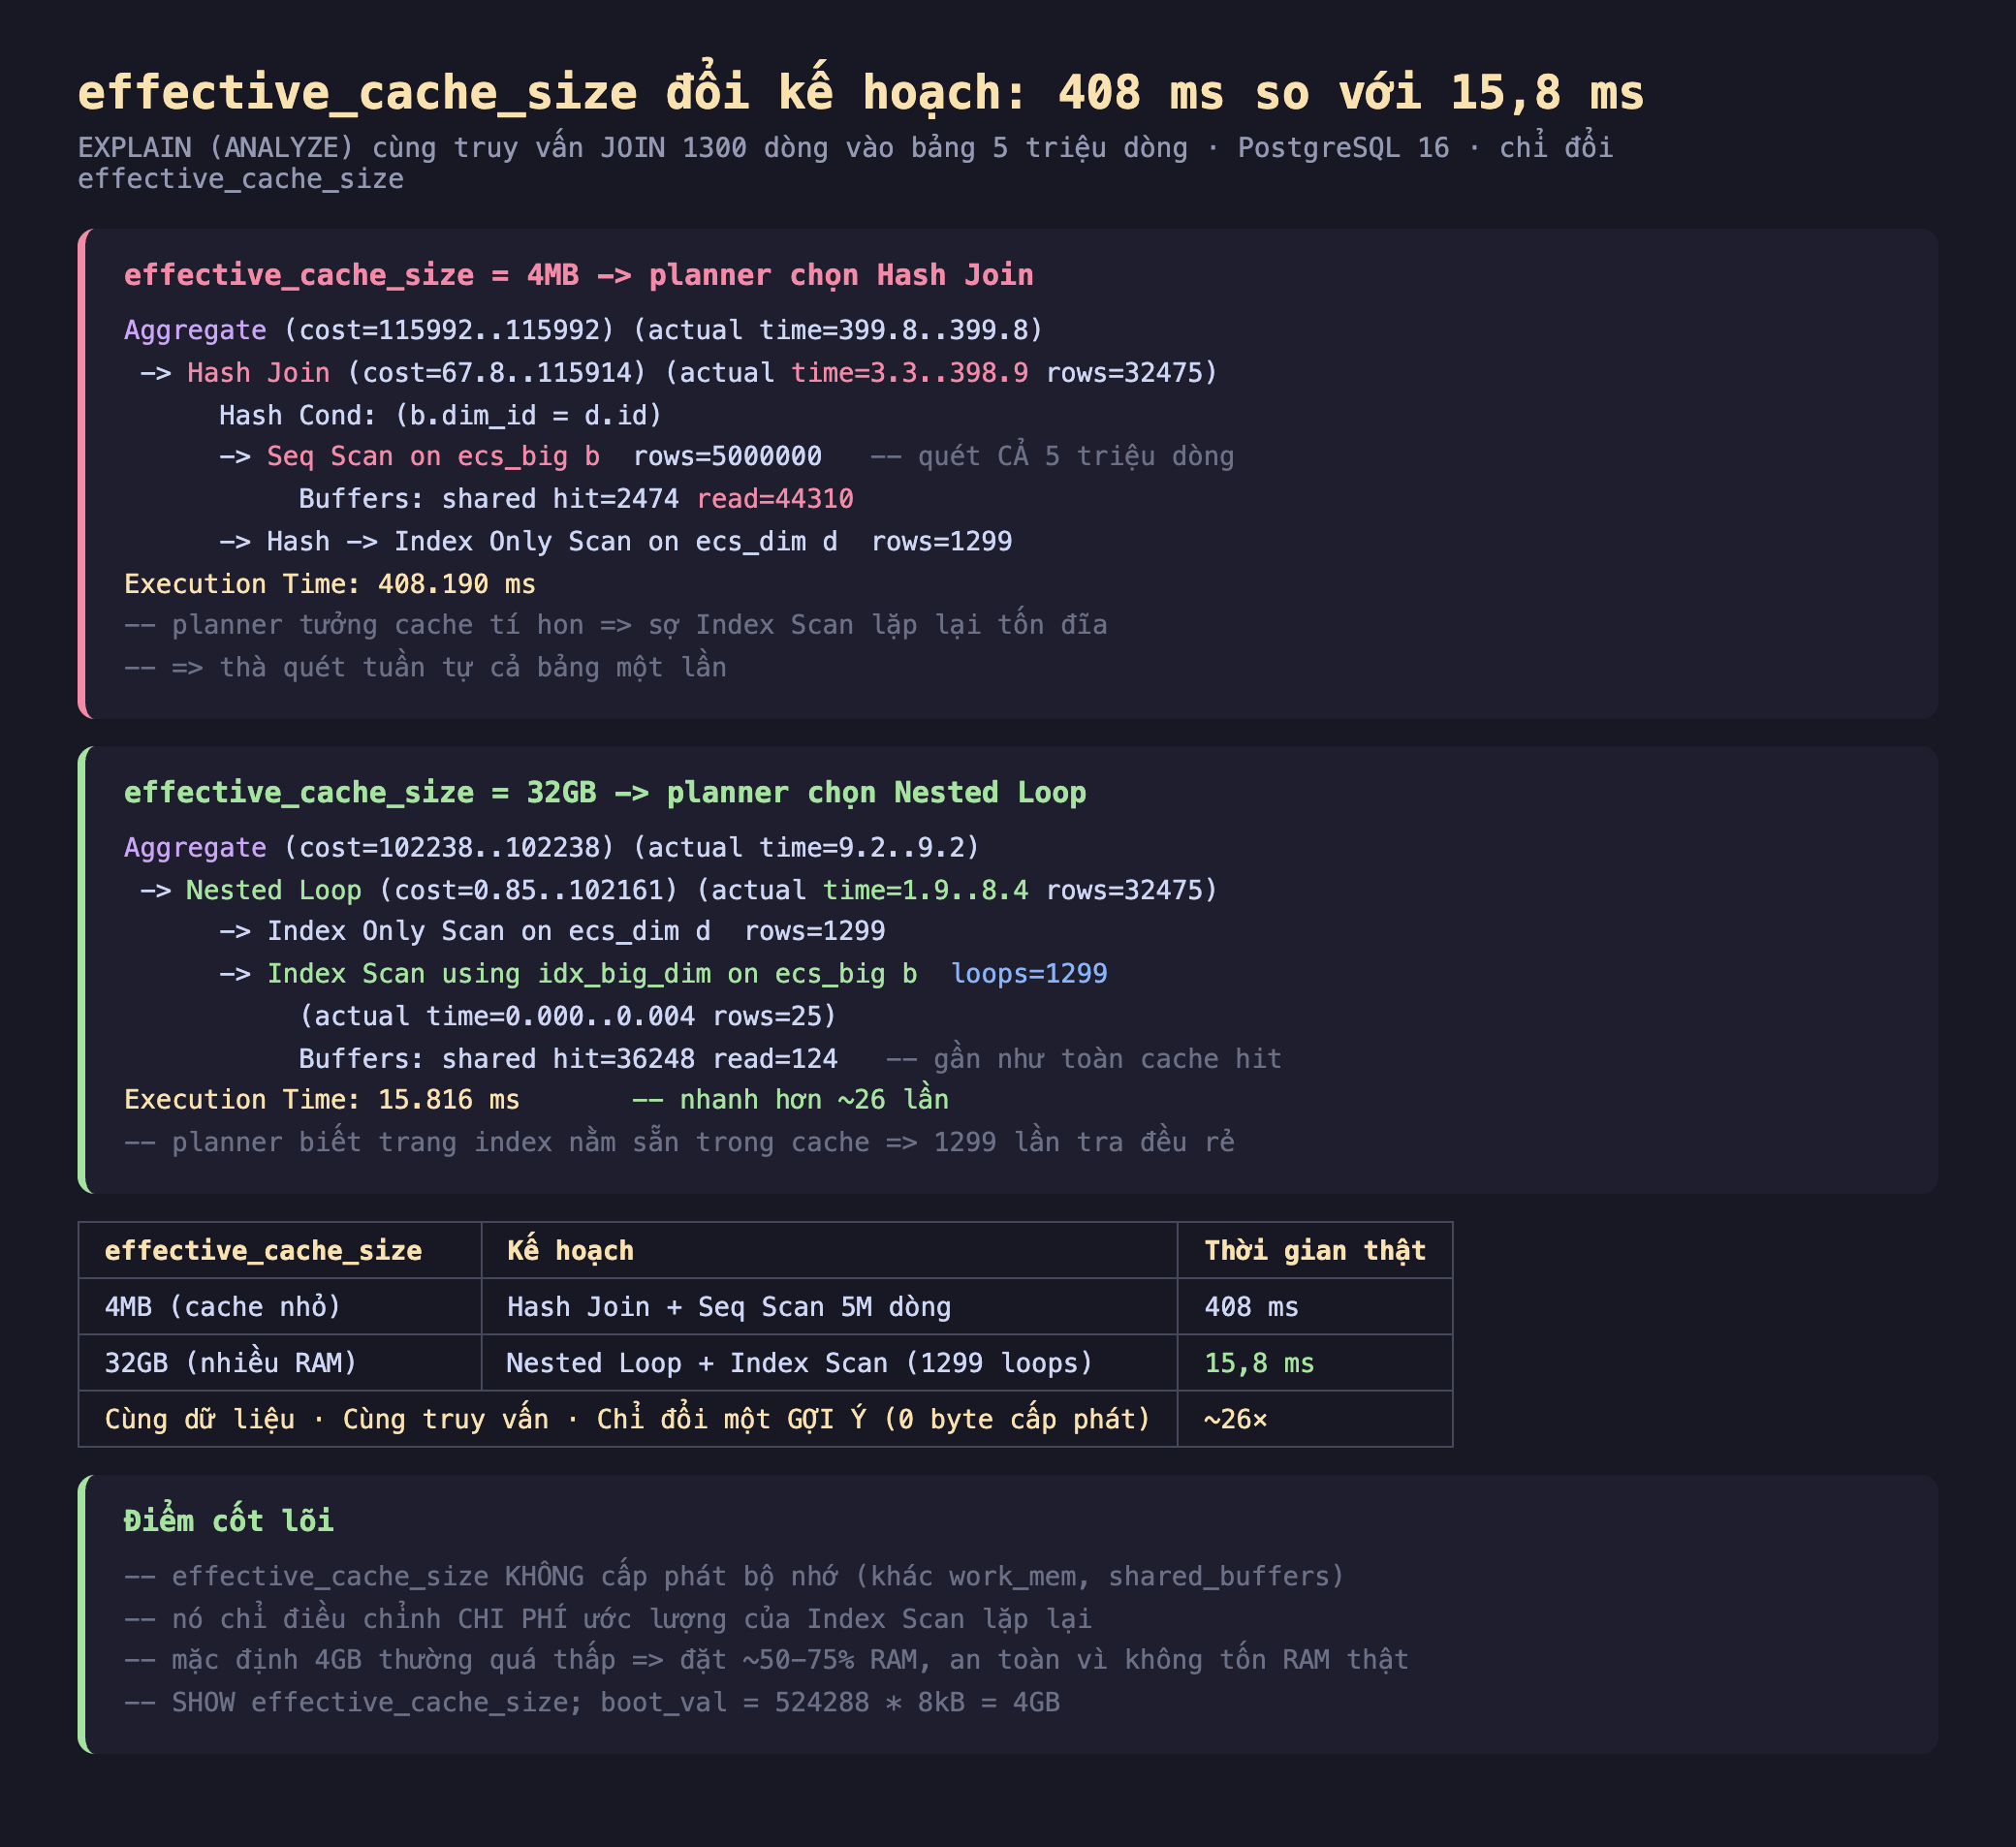
Hình 2: effective_cache_size=4MB → planner chọn Hash Join + Seq Scan cả 5 triệu dòng, 408 ms. effective_cache_size=32GB → Nested Loop + Index Scan (1.299 loops, gần như toàn cache hit), 15,8 ms — nhanh gấp ~26 lần. Cùng dữ liệu, cùng truy vấn.
Đọc kỹ hai kế hoạch:
- effective_cache_size = 4MB: planner tin cache tí hon nên sợ 1.299 lần tra index (mỗi lần có thể là một cú đọc đĩa). Nó kết luận thà quét tuần tự cả bảng 5 triệu dòng một lần (
Seq Scan,read=44310trang) rồi Hash Join — 408 ms. - effective_cache_size = 32GB: planner tin trang index nằm sẵn trong cache nên 1.299 lần tra đều rẻ. Nó chọn Nested Loop + Index Scan (
loops=1299, mỗi lần chỉ đụng 25 dòng,Buffers hit=36248gần như toàn cache hit) — 15,8 ms.
Kế hoạch Nested Loop là đúng ở đây: đọc ~32.000 dòng qua index rẻ hơn nhiều so với quét cả 5 triệu dòng. Nhưng planner chỉ dám chọn nó khi tin rằng cache đủ lớn. Con số effective_cache_size chính là thứ nói cho nó biết niềm tin đó có cơ sở hay không — và nó không tốn một byte RAM nào để "bật" niềm tin đó lên.
Đặt bao nhiêu
Vì effective_cache_size không cấp phát bộ nhớ, bạn có thể (và nên) đặt nó rộng tay. Khuyến nghị phổ biến là 50-75% RAM của máy — vì nó phản ánh tổng cache khả dụng: shared_buffers của PostgreSQL cộng với page cache của hệ điều hành (thứ này thường lớn hơn shared_buffers nhiều).
ALTER SYSTEM SET effective_cache_size = '12GB';  -- ~50-75% RAM máy 16-24GB
SELECT pg_reload_conf();
Giá trị mặc định là 4GB (boot_val = 524288 × 8kB). Với server hiện đại 32GB, 64GB RAM, con số 4GB này quá thấp — nó khiến planner ngại chọn Index Scan một cách vô cớ, đúng như ca 4MB phóng đại ở trên. Nâng nó lên là một trong những chỉnh sửa rẻ nhất và an toàn nhất: không tốn RAM, chỉ giúp planner ra quyết định sát thực tế hơn.
Đánh đổi cần cân nhắc
Đây là con dao hai lưỡi — đặt quá cao cũng sai. Nếu bạn khai effective_cache_size lớn hơn cache thật sự có, planner sẽ quá lạc quan về cache hit và chọn Nested Loop + Index Scan cả khi dữ liệu thật ra không nằm trong cache — lúc đó mỗi lần tra index là một cú đọc đĩa thật và truy vấn chậm. Con số nên phản ánh cache thật, đừng thổi phồng.
Nó không thay thế việc chạy ANALYZE. effective_cache_size chỉ điều chỉnh mô hình chi phí; planner vẫn cần thống kê đúng (số dòng ước lượng, độ chọn lọc) từ ANALYZE. Đặt effective_cache_size chuẩn mà thống kê cũ thì planner vẫn chọn sai.
Tác động chỉ rõ ở truy vấn có Index Scan lặp lại. Nếu tải của bạn toàn full-table scan hoặc truy vấn điểm đơn giản, đổi effective_cache_size gần như không thấy khác biệt. Nó phát huy đúng ở các JOIN kiểu Nested Loop trên bảng lớn — nơi lựa chọn "index nhiều lần" so với "quét một lần" là ranh giới sát nhau.
Ba ý mang về
- effective_cache_size là gợi ý cho planner, KHÔNG cấp phát bộ nhớ: khác hẳn
shared_buffers/work_mem, nó chỉ là con số ước lượng tổng cache (shared_buffers + OS page cache) để planner đoán chi phí Index Scan lặp lại qua công thức Mackert-Lohman. - Nó đổi hẳn kế hoạch: đo thật, cùng một truy vấn JOIN vào bảng 5 triệu dòng — đặt 4MB planner quét tuần tự cả bảng mất 408 ms, đặt 32GB planner chọn Nested Loop + Index Scan còn 15,8 ms, nhanh gấp ~26 lần, mà không tốn thêm một byte RAM.
- Đặt ~50-75% RAM, an toàn vì không tốn RAM thật: mặc định 4GB thường quá thấp cho server hiện đại khiến planner ngại Index Scan vô cớ — nhưng đừng thổi phồng quá cache thật, và nhớ nó không thay thế
ANALYZE.
Phần sau ta xét một tham số cost gắn liền với phần cứng lưu trữ: Phần sau mổ xẻ random_page_cost — vì sao mặc định 4.0 hợp với ổ cứng cơ mà quá cao với SSD, và hạ nó xuống đổi lựa chọn index thế nào.
