Từ đây sê-ri chuyển sang mảng ghi và độ bền. Nền tảng của cả hai là WAL (Write-Ahead Log) và checkpoint — cơ chế đảm bảo PostgreSQL không mất dữ liệu khi máy sập, nhưng cũng là nguồn gốc của phần lớn tải ghi ra đĩa. Hiểu chúng giúp bạn giải thích một hiện tượng gây bối rối: vì sao một UPDATE chạm vài byte mỗi dòng lại sinh ra hàng chục MB WAL? Bài này đo thật câu trả lời.
WAL: ghi nhật ký trước, sửa dữ liệu sau
Nguyên tắc write-ahead: trước khi PostgreSQL sửa một trang dữ liệu trong bộ nhớ, nó ghi bản ghi mô tả thay đổi đó vào WAL — một dòng ghi tuần tự, rất nhanh. Chỉ khi WAL đã an toàn trên đĩa, giao dịch mới được coi là bền. Nếu máy sập, khi khởi động lại PostgreSQL phát lại WAL từ checkpoint gần nhất để dựng lại mọi thay đổi chưa kịp ghi vào file dữ liệu. Đây là lý do một CSDL có thể chịu mất điện mà không hỏng.
SELECT wal_records, wal_fpi, wal_bytes FROM pg_stat_wal;
FPI: lần chạm trang đầu tiên sau checkpoint ghi cả trang 8KB
Đây là chi tiết giải thích "WAL phình to". Để chống torn page (trang bị ghi dở khi máy sập giữa chừng — một trang 8KB có thể chỉ ghi được nửa), PostgreSQL dùng cơ chế full-page image (FPI): lần đầu tiên một trang bị sửa sau mỗi checkpoint, WAL chép nguyên cả trang 8KB vào nhật ký, chứ không chỉ phần thay đổi. Các lần sửa sau đó (trước checkpoint kế) chỉ ghi phần delta nhỏ.
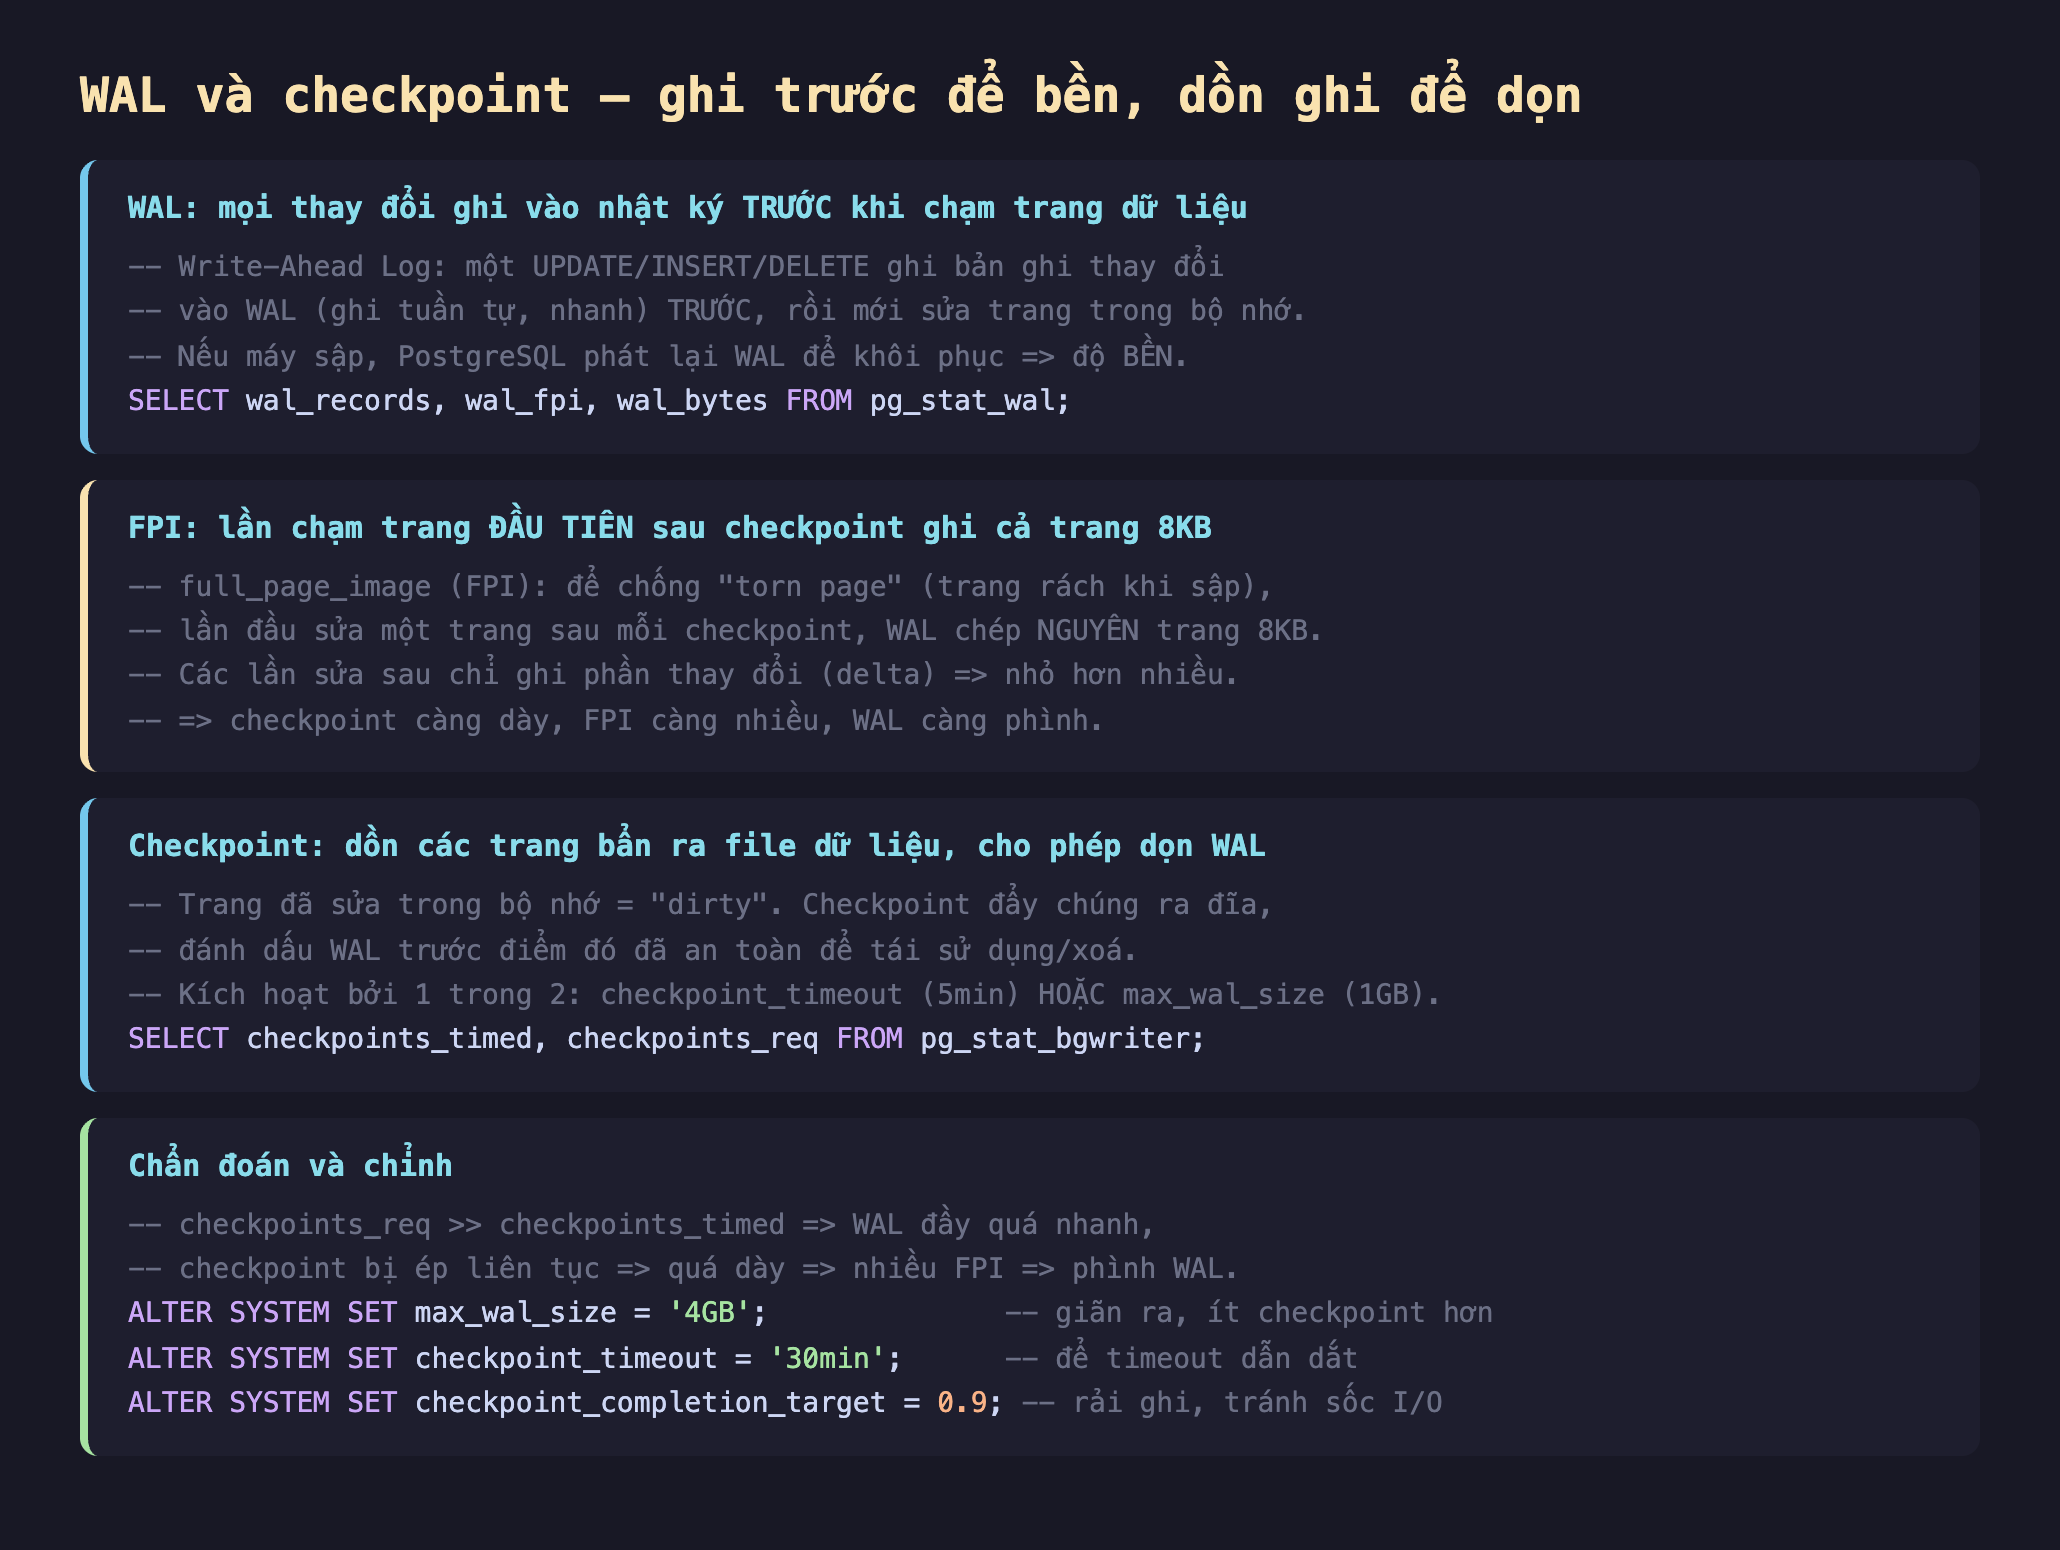
Hình 1: WAL ghi mọi thay đổi trước khi chạm trang dữ liệu (độ bền). FPI chép nguyên trang 8KB ở lần chạm đầu sau mỗi checkpoint (chống torn page). Checkpoint dồn trang bẩn ra đĩa, cho phép dọn WAL; kích hoạt bởi timeout hoặc max_wal_size.
Đo thật: cùng UPDATE, 48 MB hay 28 MB
Tôi chạy đúng một câu UPDATE pgbench_accounts SET abalance = abalance + 1 WHERE aid <= 100000 (100.000 dòng) trong hai tình huống, đọc pg_stat_wal:
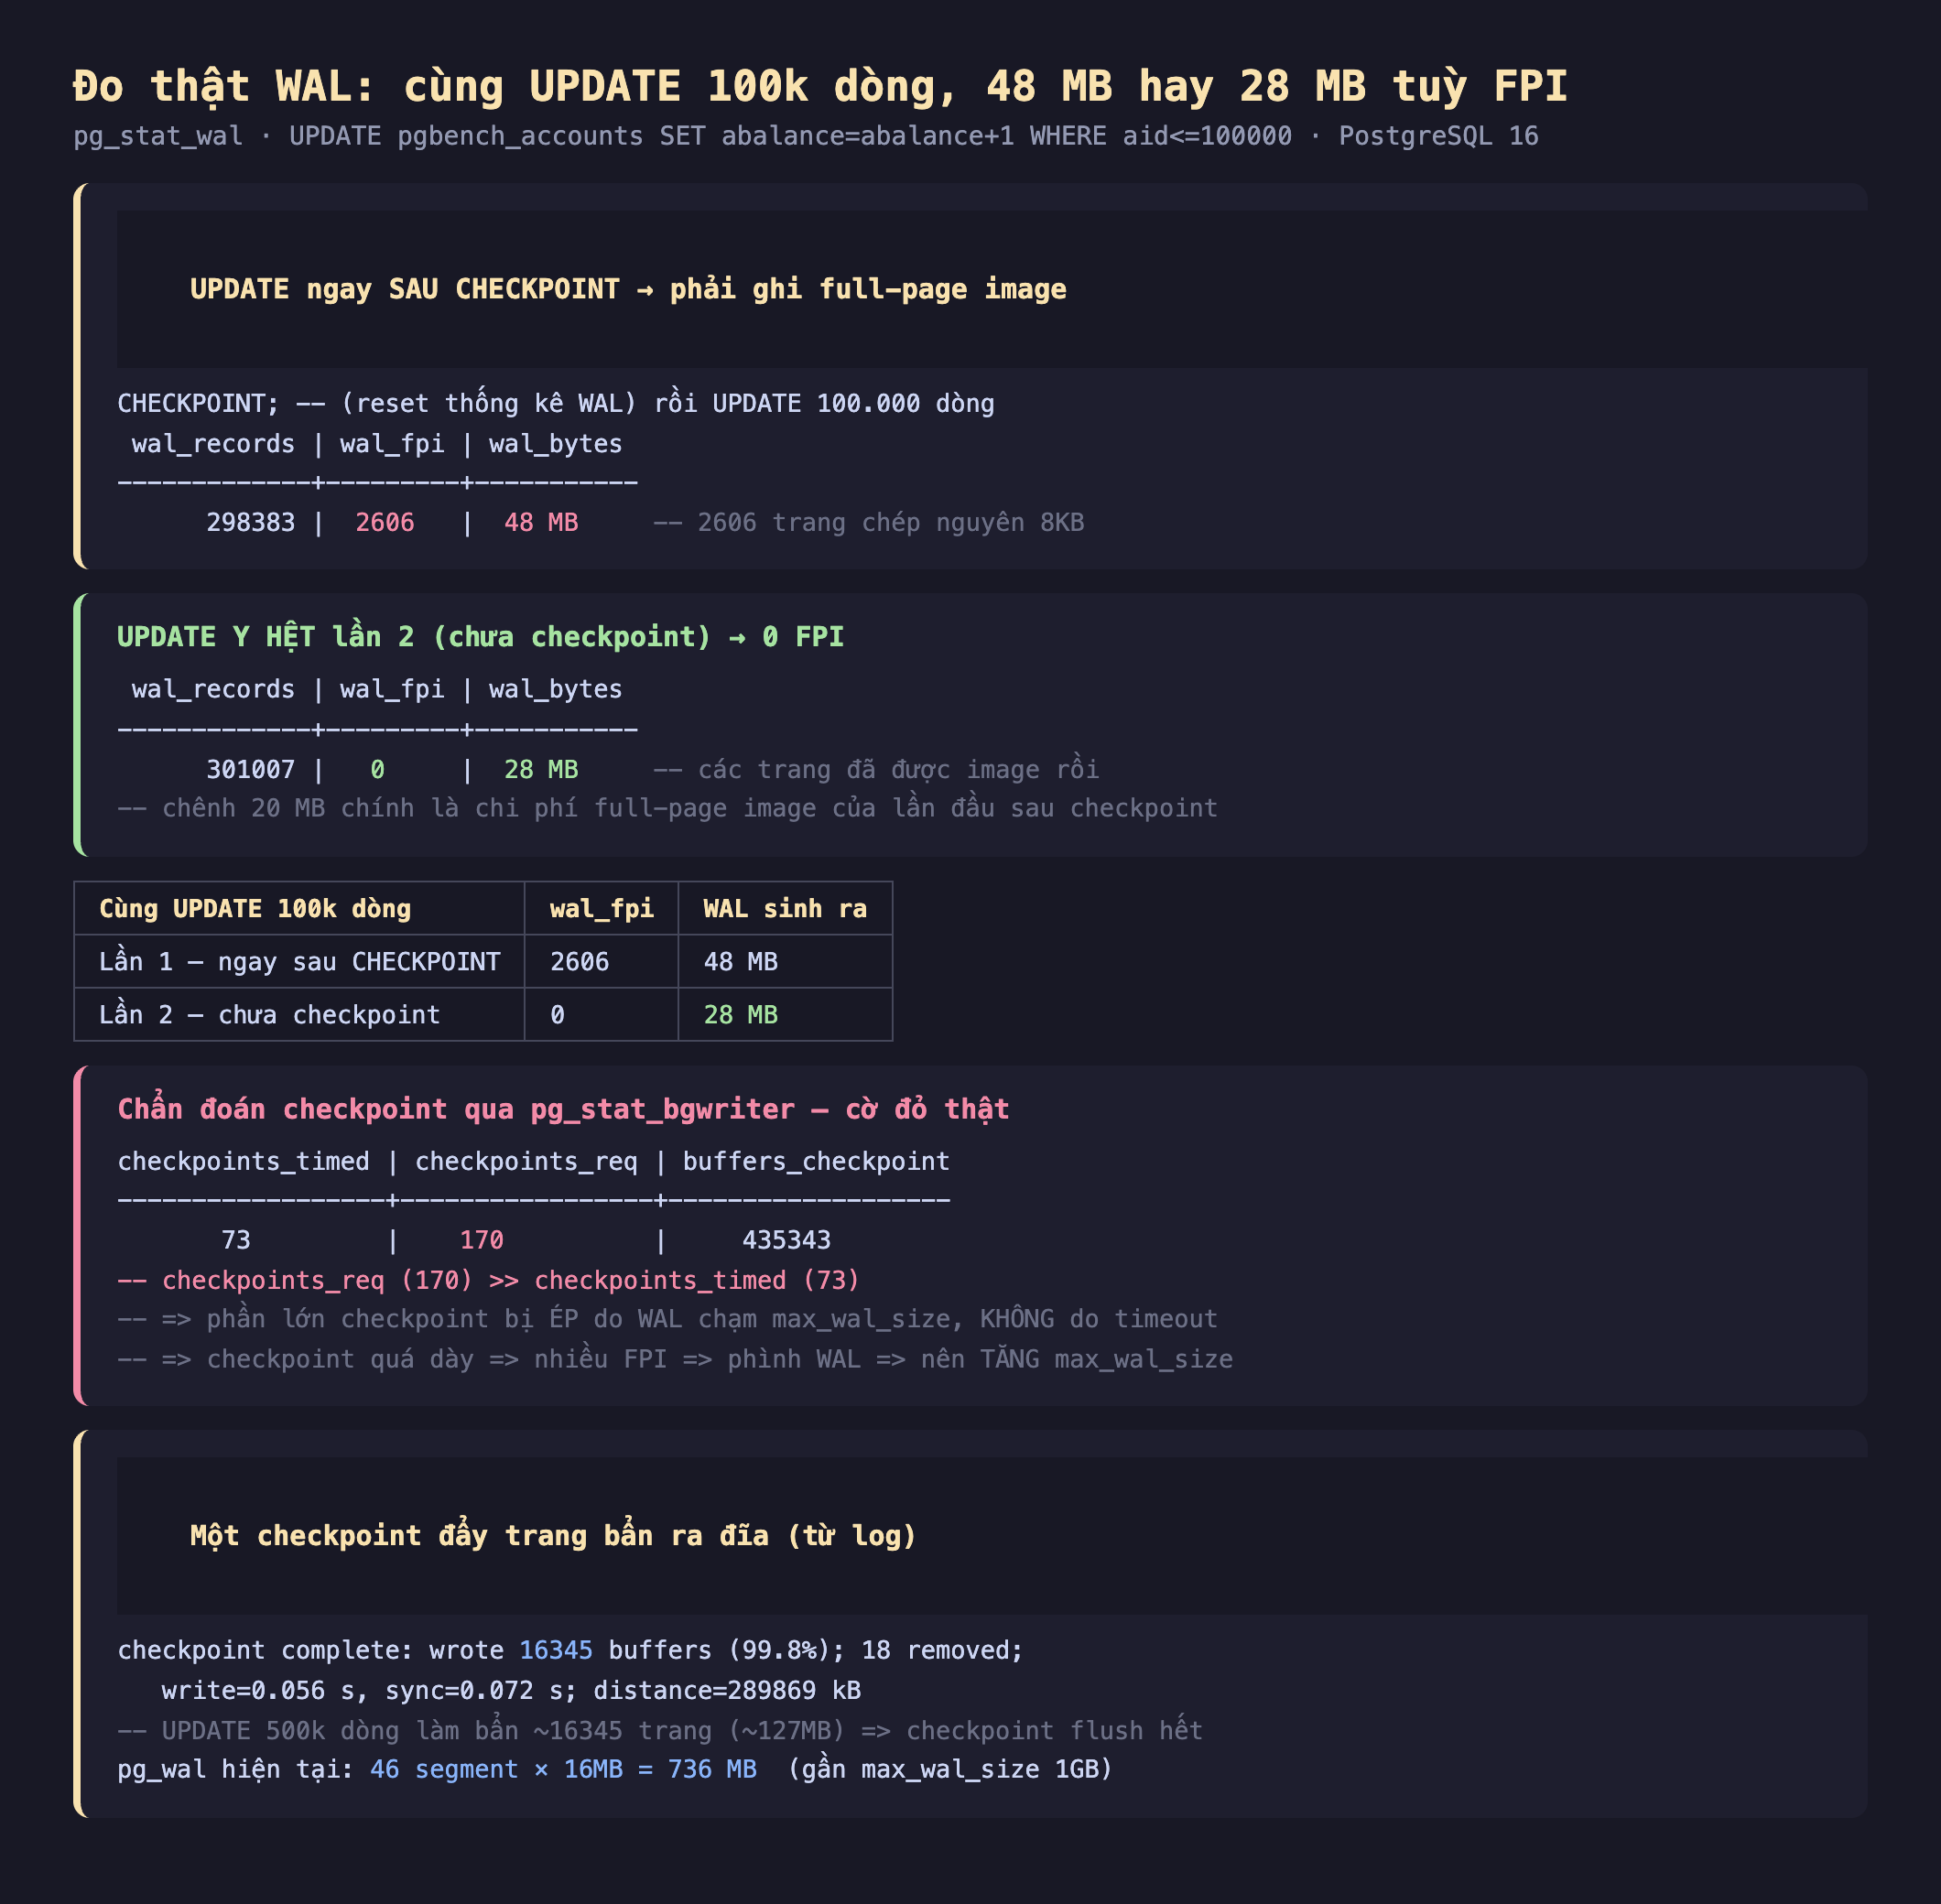
Hình 2: UPDATE 100k dòng ngay sau CHECKPOINT sinh 48 MB WAL với 2606 FPI; lặp lại y hệt (chưa checkpoint) chỉ 28 MB với 0 FPI. Chênh 20 MB chính là chi phí full-page image. checkpoints_req (170) ≫ checkpoints_timed (73) là cờ đỏ max_wal_size quá nhỏ.
- UPDATE ngay sau CHECKPOINT:
wal_fpi = 2606,wal_bytes = 48 MB. Vì mọi trang bị chạm đều là "lần đầu sau checkpoint", nên 2606 trang bị chép nguyên 8KB vào WAL. - UPDATE y hệt lần 2 (chưa checkpoint giữa chừng):
wal_fpi = 0,wal_bytes = 28 MB. Các trang đó đã được image ở lần 1 rồi, nên lần này chỉ ghi delta.
Chênh lệch 20 MB chính là chi phí full-page image. Rút ra điều quan trọng: checkpoint càng dày, càng nhiều lần "chạm trang đầu tiên", càng nhiều FPI, WAL càng phình. Đây là mắt xích nối checkpoint với tải ghi.
Checkpoint và cách chẩn đoán
Checkpoint là điểm PostgreSQL dồn tất cả các trang bẩn (đã sửa trong bộ nhớ) ra file dữ liệu, rồi đánh dấu phần WAL trước điểm đó là an toàn để tái sử dụng. Nó được kích hoạt bởi một trong hai: checkpoint_timeout (mặc định 5 phút) hoặc max_wal_size (mặc định 1GB) — cái nào đến trước.
pg_stat_bgwriter cho ta chẩn đoán quý giá: đo thật trên lab này, checkpoints_timed = 73 nhưng checkpoints_req = 170. checkpoints_req ≫ checkpoints_timed nghĩa là phần lớn checkpoint bị ép do WAL chạm max_wal_size, chứ không phải do hết checkpoint_timeout. Đây là cờ đỏ kinh điển: WAL sinh ra quá nhanh so với max_wal_size, khiến checkpoint dồn dập — mà mỗi checkpoint lại làm tăng số FPI ở đợt ghi kế → phình WAL → vòng luẩn quẩn. Trong log, một checkpoint thủ công cho thấy nó đẩy 16.345 trang bẩn (~127MB) ra đĩa; pg_wal đang giữ 46 segment × 16MB = 736 MB, gần chạm max_wal_size 1GB.
Cách chỉnh:
ALTER SYSTEM SET max_wal_size = '4GB';              -- giãn ra, checkpoint thưa hơn
ALTER SYSTEM SET checkpoint_timeout = '30min';      -- để timeout dẫn dắt, không phải WAL đầy
ALTER SYSTEM SET checkpoint_completion_target = 0.9; -- rải ghi khắp 90% chu kỳ, tránh sốc I/O
SELECT pg_reload_conf();
Đánh đổi cần cân nhắc
Checkpoint thưa hơn = ít FPI, nhưng thời gian phục hồi lâu hơn. Tăng max_wal_size và checkpoint_timeout giảm tải ghi (ít FPI, ít dồn trang bẩn), nhưng nếu máy sập, PostgreSQL phải phát lại nhiều WAL hơn để khôi phục — thời gian khởi động sau sự cố dài hơn. Đây là cân bằng giữa hiệu năng lúc chạy và thời gian phục hồi (RTO).
checkpoint_completion_target rải ghi để tránh sốc I/O. Mặc định 0.9 nghĩa là checkpoint cố hoàn tất việc ghi trang bẩn trong 90% khoảng cách tới checkpoint kế, thay vì ghi ồ ạt một lúc. Điều này làm mượt tải đĩa — quan trọng trên hệ thống ghi nặng. Hầu như luôn nên để 0.9.
WAL cũng cần cho replication và PITR. Đừng chỉ nghĩ WAL là chi phí. Nó là nền tảng của streaming replication (bản sao đọc WAL để đồng bộ) và Point-in-Time Recovery (khôi phục về đúng thời điểm). Chỉnh max_wal_size, wal_keep_size phải cân nhắc cả các nhu cầu này.
Ba ý mang về
- Mọi thay đổi ghi vào WAL trước khi chạm trang dữ liệu (write-ahead, đảm bảo độ bền và phục hồi sau sập) — WAL ghi tuần tự nhanh, còn checkpoint dồn các trang bẩn ra file dữ liệu để cho phép dọn/tái dùng WAL.
- Full-page image làm WAL phình ở lần chạm trang đầu sau mỗi checkpoint: đo thật, cùng UPDATE 100k dòng sinh 48 MB (2606 FPI) ngay sau checkpoint nhưng chỉ 28 MB (0 FPI) khi lặp lại — nên checkpoint càng dày, WAL càng nhiều.
- checkpoints_req ≫ checkpoints_timed là cờ đỏ max_wal_size quá nhỏ: đo thật 170 so với 73 — checkpoint bị ép do WAL đầy, nên tăng
max_wal_size/checkpoint_timeout(đánh đổi: phục hồi sau sập lâu hơn) và giữcheckpoint_completion_target=0.9để tránh sốc I/O.
Phần sau ta đi sâu vào hai công tắc liên quan trực tiếp tới FPI vừa đo: Phần sau mổ xẻ wal_compression và full_page_writes — nén full-page image để giảm WAL, và vì sao gần như không bao giờ nên tắt full_page_writes.
