LIKE và trigram tìm theo chuỗi ký tự thô — chúng không biết queries và query là cùng một từ, cũng không biết the là từ vô nghĩa để bỏ qua. Full-text search (FTS) của PostgreSQL làm điều khác hẳn: nó tìm theo từ đã chuẩn hóa về gốc, hiểu ngữ pháp cơ bản của ngôn ngữ. Bài này đo thật FTS so với LIKE, chỉ ra vì sao FTS không index còn chậm hơn LIKE, và cách một cột tsvector cộng GIN index biến nó thành công cụ tìm kiếm nghiêm túc.
tsvector: văn bản thành danh sách từ chuẩn hóa
Nền tảng của FTS là kiểu tsvector — kết quả của việc "xử lý" một đoạn văn bản: tách từ, đưa mỗi từ về gốc (stemming), và loại các stop word (từ quá phổ biến, vô nghĩa cho tìm kiếm):
SELECT to_tsvector('english', 'Optimizing slow queries using EXPLAIN');
-- 'explain':5 'optim':1 'queri':3 'slow':2 'use':4
Chú ý: queries thành queri, optimizing thành optim, using thành use — tất cả về gốc. Và:
SELECT to_tsvector('english', 'The quick brown fox');
-- 'brown':3 'fox':4 'quick':2      ← 'the' bị loại (stop word)
the biến mất hoàn toàn. Đây là thứ LIKE không bao giờ làm được.
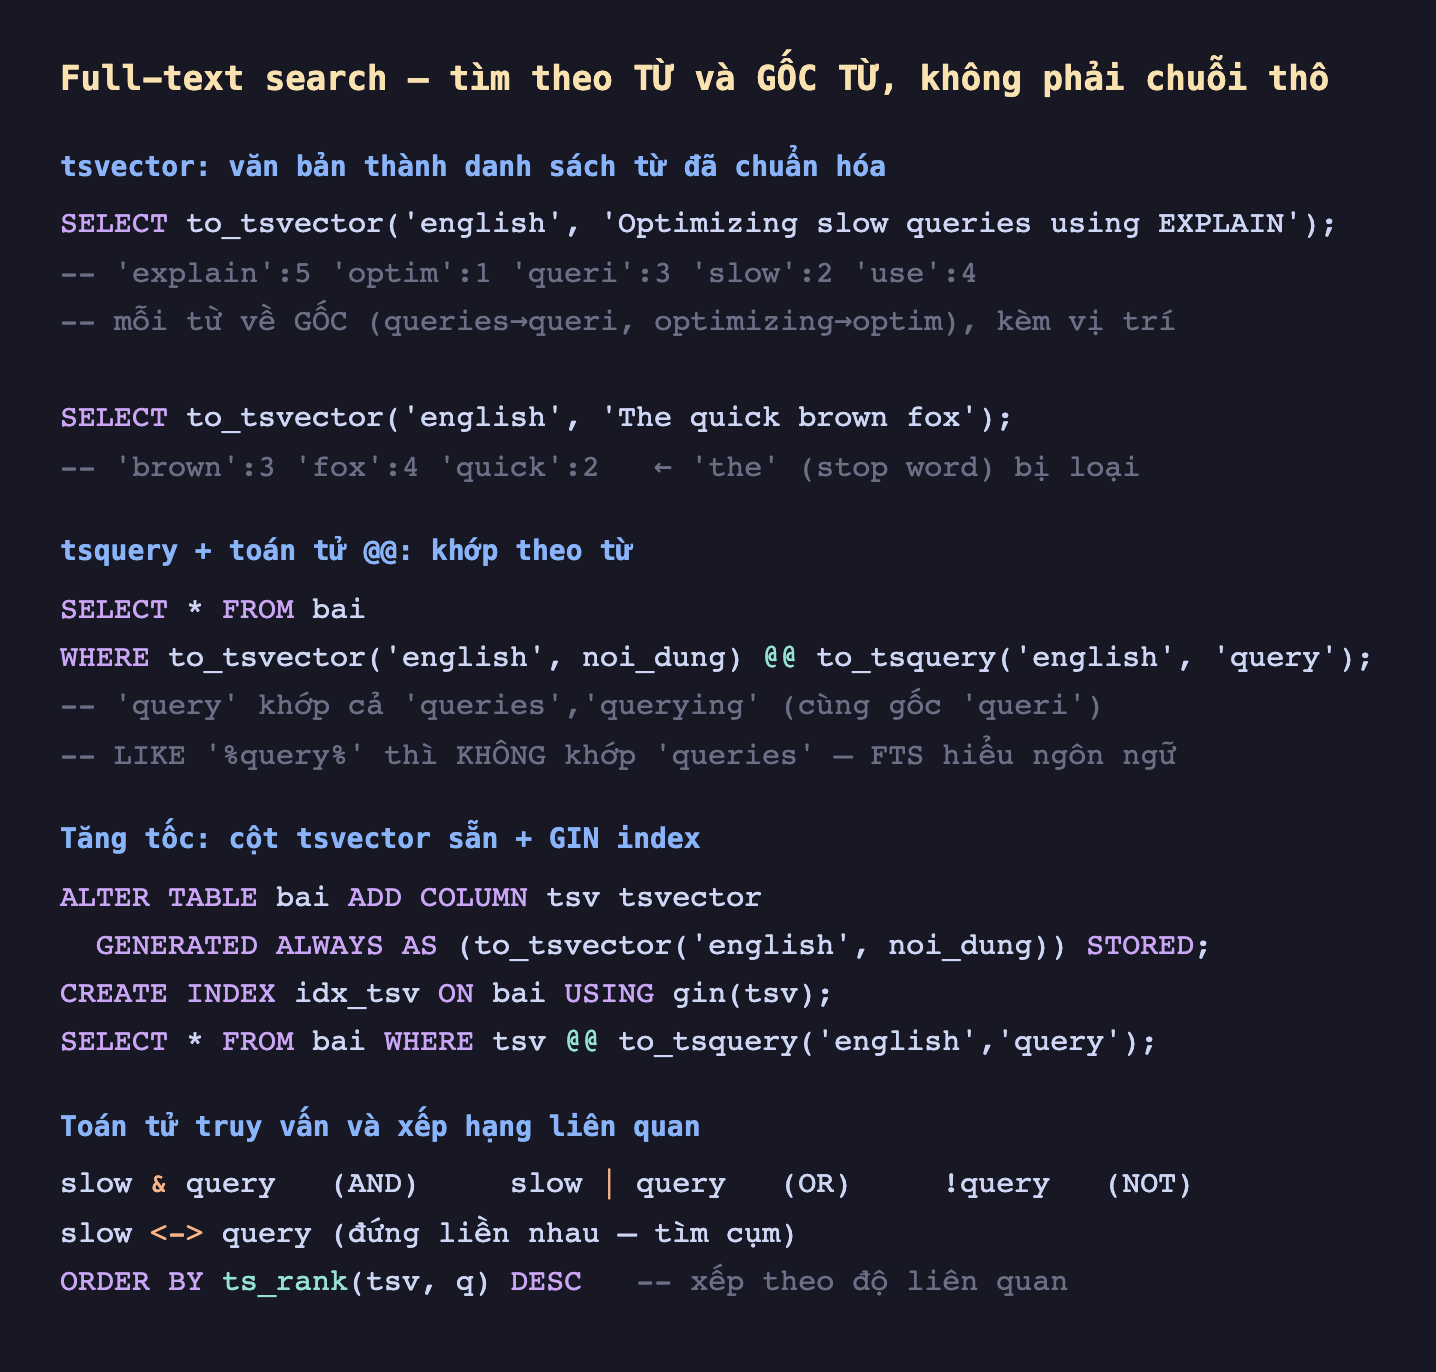
Hình 1: to_tsvector đưa văn bản về danh sách từ gốc (stemming) và bỏ stop word. to_tsquery cùng @@ khớp theo từ, nên query tìm được queries. Tăng tốc bằng cột tsvector STORED + GIN.
tsquery và @@: khớp theo từ, hiểu ngôn ngữ
Tìm kiếm dùng toán tử @@ giữa tsvector và tsquery:
SELECT * FROM bai
WHERE to_tsvector('english', noi_dung) @@ to_tsquery('english', 'query');
Vì cả hai vế đều được stem về gốc queri, truy vấn query khớp mọi biến thể: queries, querying, queried. So sánh trực tiếp:
- Tìm
querybằng FTS: khớpOptimizing slow queries— TRUE. 'Optimizing slow queries' LIKE '%query%': FALSE —LIKEchỉ so ký tự,querykhông phải chuỗi con củaqueries.
Đây là khác biệt bản chất: FTS hiểu rằng người dùng gõ query là muốn tìm mọi dạng của từ đó, còn LIKE mù về ngữ nghĩa.
Đo thật: FTS không index còn chậm hơn LIKE
Điều quan trọng nhất về hiệu năng, đo trên bảng bai 2 triệu tài liệu:
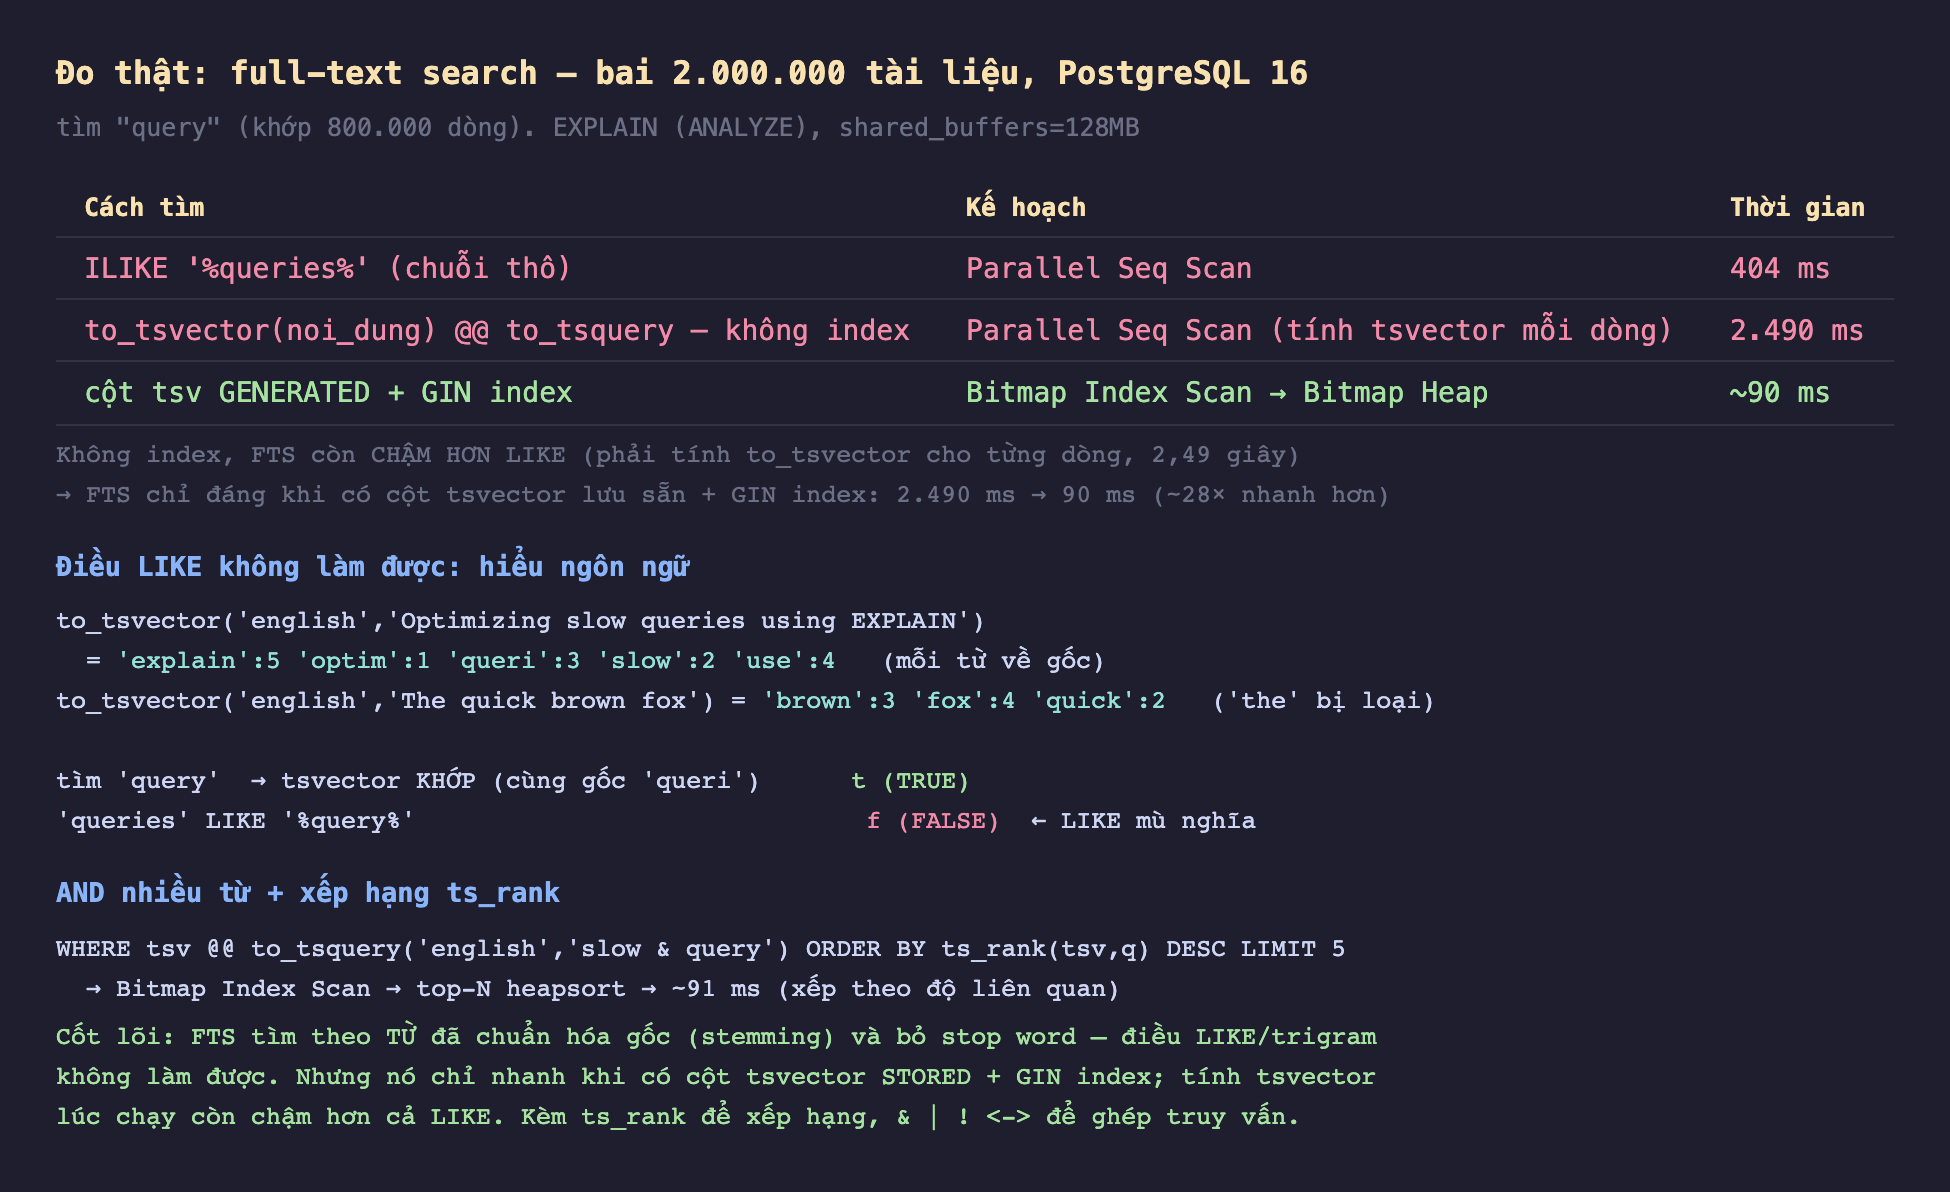
Hình 2: ILIKE '%queries%' seq scan 404 ms; FTS không index (to_tsvector(...) @@ ...) còn chậm hơn — 2.490 ms vì tính tsvector cho mỗi dòng; cột tsvector STORED + GIN index đưa về ~90 ms (~28 lần nhanh hơn).
ILIKE '%queries%':Seq Scan, 404 ms.- FTS không index (
to_tsvector(noi_dung) @@ to_tsquery('query')):Seq Scan, 2.490 ms — chậm hơn cảLIKE. Vì PostgreSQL phải tínhto_tsvectorcho từng dòng ngay lúc chạy, đắt hơn nhiều so với so chuỗi. - Cột
tsvectorSTORED + GIN index:Bitmap Index Scan, ~90 ms.
Bài học then chốt: FTS chỉ đáng dùng khi có cột tsvector lưu sẵn và GIN index. Viết WHERE to_tsvector(cột) @@ ... trực tiếp là tệ nhất trong ba lựa chọn. Cách đúng là dựng cột sinh tự động và index nó:
ALTER TABLE bai ADD COLUMN tsv tsvector
  GENERATED ALWAYS AS (to_tsvector('english', noi_dung)) STORED;
CREATE INDEX idx_bai_tsv ON bai USING gin(tsv);
SELECT * FROM bai WHERE tsv @@ to_tsquery('english', 'query');
Cột GENERATED ... STORED tự cập nhật mỗi khi noi_dung đổi, nên bạn không phải lo đồng bộ tay.
Toán tử truy vấn và xếp hạng
tsquery hỗ trợ ghép điều kiện phong phú, và ts_rank xếp kết quả theo độ liên quan:
WHERE tsv @@ to_tsquery('english', 'slow & query')   -- AND
ORDER BY ts_rank(tsv, to_tsquery('english','slow & query')) DESC LIMIT 5;
Các toán tử: & (AND), | (OR), ! (NOT), <-> (hai từ đứng liền nhau — tìm cụm). Đo thật truy vấn AND + xếp hạng: Bitmap Index Scan → top-N heapsort, ~91 ms. ts_rank cho điểm dựa trên tần suất và vị trí từ khớp, để bạn trả về kết quả liên quan nhất trước — thứ mà LIKE hoàn toàn không có.
Đánh đổi cần cân nhắc
FTS mạnh về từ, yếu về khớp gần đúng và lỗi chính tả. Nó tìm theo từ chuẩn hóa nên tuyệt cho tìm tài liệu, nhưng không tìm được PostgreSQL khi người dùng gõ postgre (thiếu ký tự) hay gõ sai chính tả. Cho tìm gần đúng, tự động hoàn thành, chịu lỗi gõ, trigram (pg_trgm) mới là công cụ — hai thứ bổ sung nhau, không thay thế.
Chọn đúng cấu hình ngôn ngữ. to_tsvector('english', ...) dùng luật stemming và stop word của tiếng Anh. Với tiếng Việt, tiếng không có bộ stemmer tích hợp, thường phải dùng cấu hình simple (chỉ tách từ, không stem, không bỏ stop word) hoặc một extension riêng. Dùng sai cấu hình cho ngôn ngữ khác sẽ stem bậy hoặc bỏ nhầm từ.
Cột STORED tốn dung lượng và chi phí ghi. Cột tsvector sinh tự động chiếm chỗ và phải tính lại mỗi lần cột nguồn đổi. Với bảng ghi rất nhiều mà tìm kiếm ít, cân nhắc. Nhưng trong hầu hết ca (tìm nhiều hơn ghi), đánh đổi này rất đáng.
Ba ý mang về
- FTS tìm theo từ đã chuẩn hóa gốc và bỏ stop word —
to_tsvectorđưaqueriesvềquerivà loạithe, nênquerykhớp cảqueries,querying; điềuLIKEkhông làm được (đo thậtLIKE '%query%'không khớpqueries). - FTS chỉ nhanh khi có cột
tsvectorSTORED + GIN index: đo thật,to_tsvector(cột) @@ ...không index còn chậm hơnLIKE(2.490 ms so với 404 ms) vì tính lại mỗi dòng; cột sinh tự động + GIN đưa về ~90 ms. - Dùng
ts_rankđể xếp hạng liên quan và&|!<->để ghép truy vấn — FTS mạnh cho tìm tài liệu theo từ, nhưng cho khớp gần đúng và chịu lỗi chính tả thì trigram mới là công cụ đúng, hai thứ bổ sung nhau.
Phần sau ta quay lại công cụ vừa nhắc, đào sâu hơn: Phần sau mổ xẻ trigram pg_trgm cho tìm gần đúng — cách nó đo độ tương tự chuỗi, tìm được cả khi gõ sai chính tả, và index GiST/GIN cho nó.
