Bài về LIKE cho thấy trigram phục vụ được tìm chuỗi con '%abc%'; bài về full-text search cho thấy FTS tìm theo từ. Nhưng cả hai đều có một điểm mù: chúng không tìm được khi người dùng gõ sai chính tả. LIKE '%Postgersql%' (đảo hai chữ) trả về 0 dòng; FTS cũng không khớp. Đây là lúc pg_trgm tỏa sáng ở khía cạnh mạnh nhất của nó: tìm gần đúng — đo độ tương tự giữa hai chuỗi thay vì đòi khớp chính xác. Bài này đo thật sức mạnh đó và cách chọn index đúng.
Trigram và độ tương tự
pg_trgm băm mỗi chuỗi thành tập các trigram — bộ ba ký tự liên tiếp (kèm đệm khoảng trắng ở đầu/cuối):
SELECT show_trgm('Nguyen');
-- {"  n"," ng","en ","guy","ngu","uye","yen"}
Từ đó, similarity(a, b) cho một điểm từ 0 đến 1 = tỉ lệ trigram chung giữa hai chuỗi. Điều then chốt: nó cho điểm dương ngay cả khi gõ sai, vì hai chuỗi gần giống nhau vẫn chia sẻ phần lớn trigram:
SELECT similarity('PostgreSQL', 'Postgres');     -- 0.667  (thiếu đuôi)
SELECT similarity('PostgreSQL', 'Postgersql');   -- 0.467  (đảo chữ — gõ sai!)
Postgersql (đảo re thành er) vẫn được 0.467 — đủ để nhận ra người dùng muốn tìm PostgreSQL. LIKE và FTS trả về không khớp cho cùng chuỗi này.
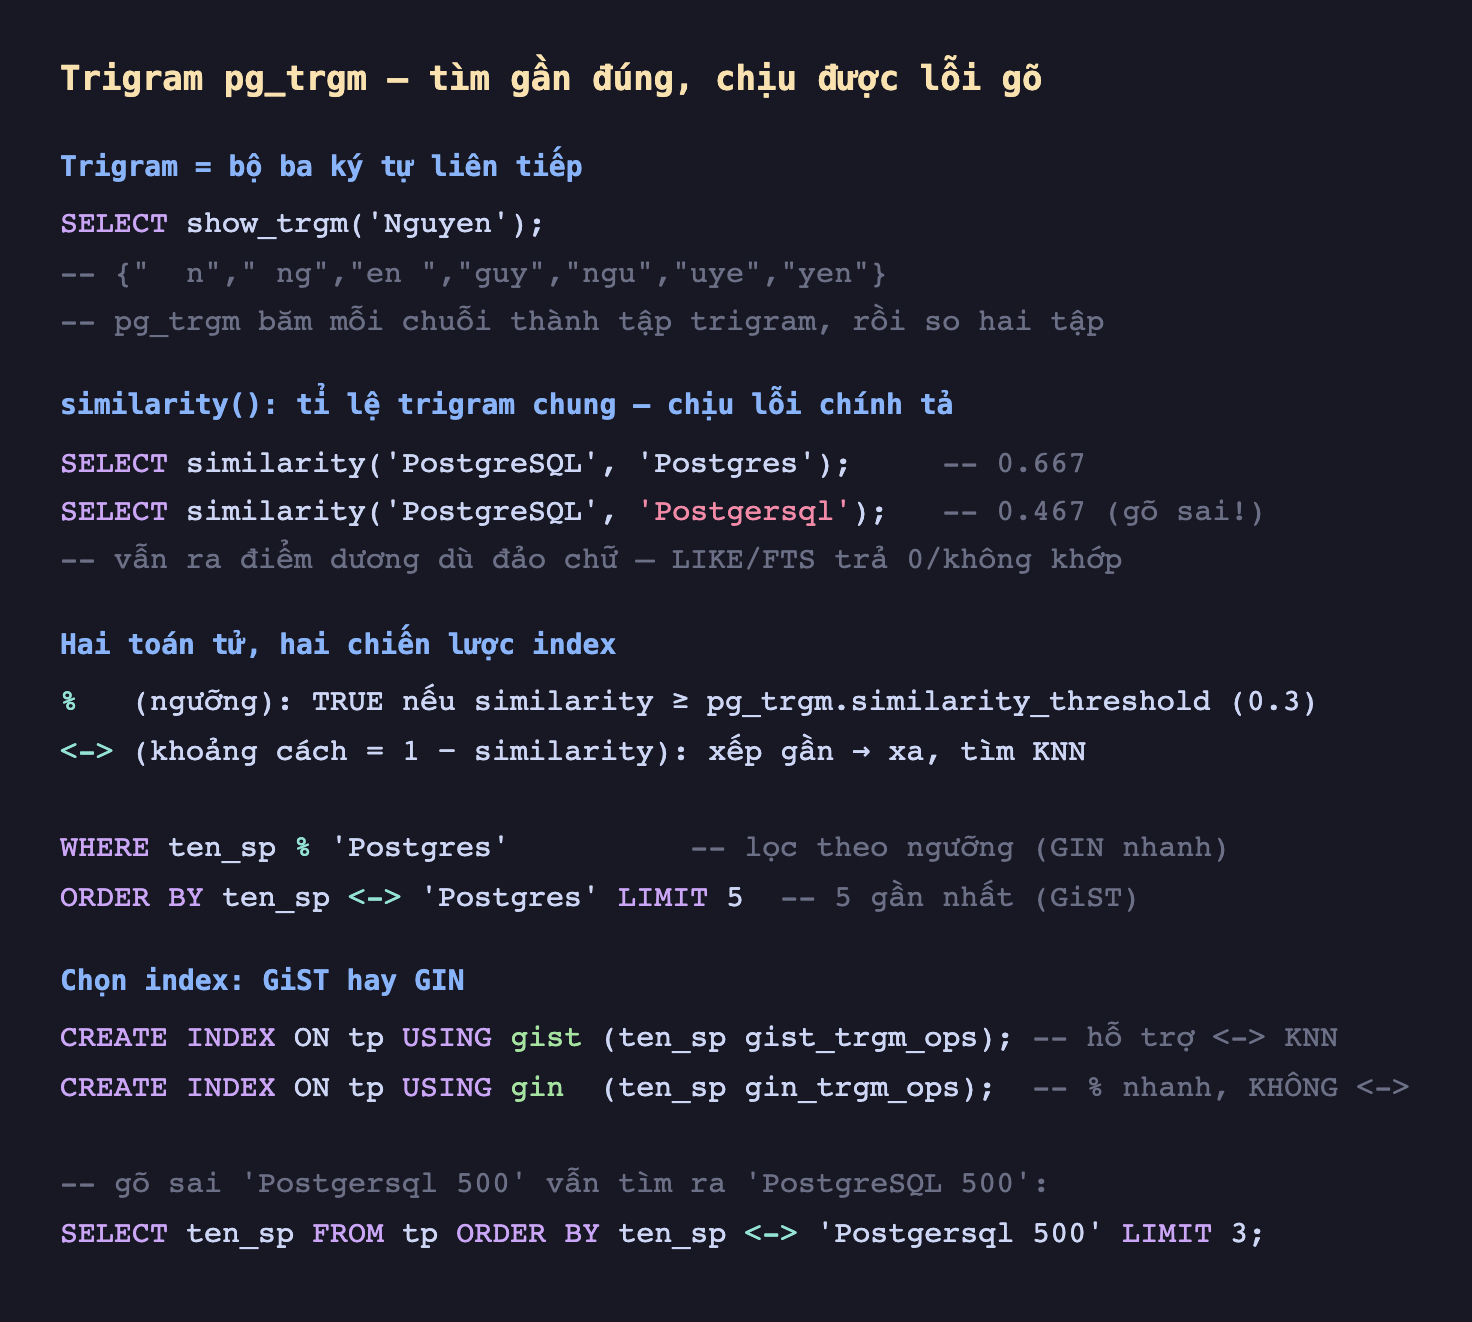
Hình 1: pg_trgm băm chuỗi thành tập trigram và đo tỉ lệ chung. similarity cho điểm dương cả khi gõ sai. Hai toán tử % (ngưỡng) và <-> (khoảng cách KNN) đi với hai loại index khác nhau.
Hai toán tử, hai chiến lược index
pg_trgm cho hai cách tìm gần đúng, và đây là phần quan trọng nhất về hiệu năng:
%(toán tử ngưỡng): trả TRUE nếusimilarity ≥ pg_trgm.similarity_threshold(mặc định 0.3). Dùng để lọc ra các dòng "đủ giống".<->(toán tử khoảng cách =1 - similarity): xếp từ gần đến xa. Dùng vớiORDER BY ... LIMITđể tìm K láng giềng gần nhất (KNN) — "N kết quả giống nhất".
WHERE ten_sp % 'Postgres'                        -- lọc theo ngưỡng
ORDER BY ten_sp <-> 'Postgres' LIMIT 5;          -- 5 kết quả gần nhất
Đo thật: chọn GiST hay GIN
Trên bảng 2 triệu dòng, đo cả bốn tổ hợp toán tử × index:
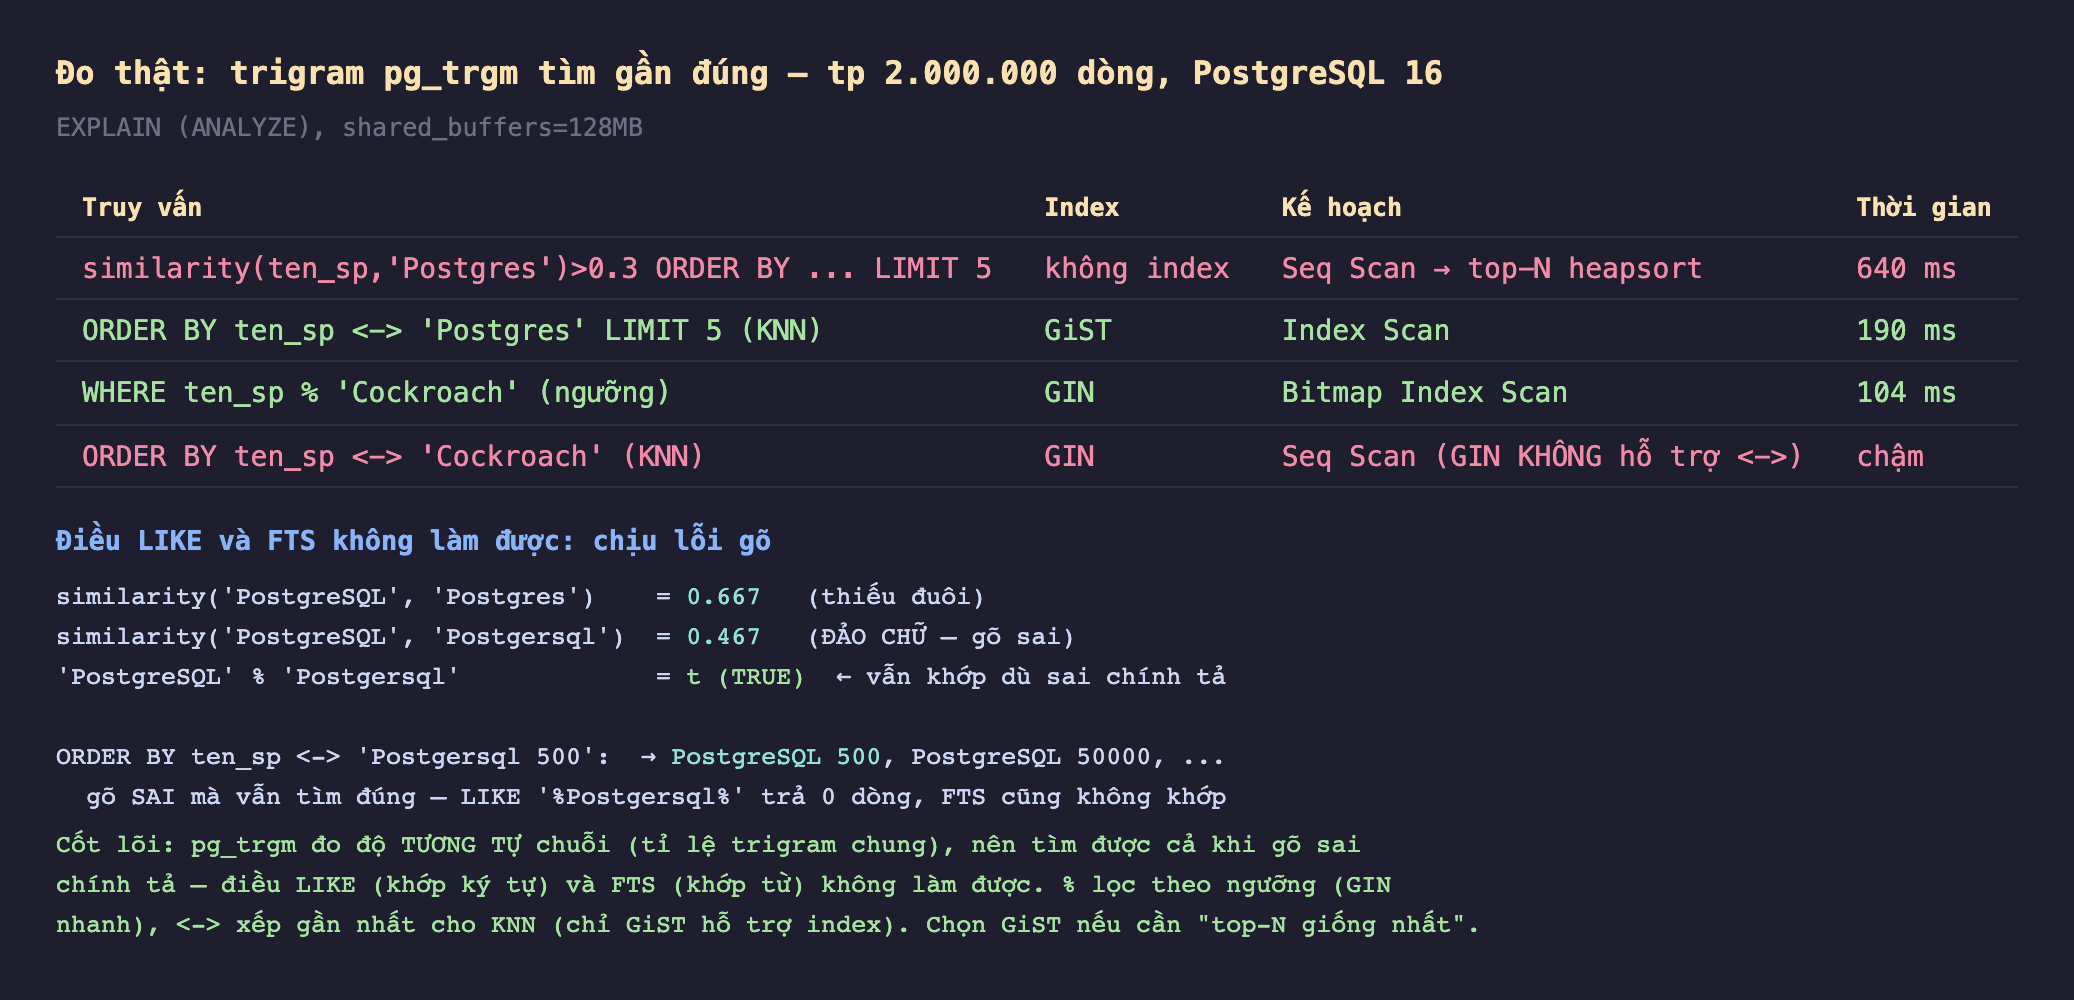
Hình 2: similarity() không index seq scan 640 ms; KNN <-> với GiST 190 ms; ngưỡng % với GIN 104 ms. GIN không hỗ trợ <-> nên KNN rơi về seq scan. Gõ sai Postgersql 500 vẫn tìm đúng PostgreSQL 500.
similarity() > 0.3không index:Seq Scan → top-N heapsort, 640 ms.- KNN
<->với GiST:Index Scan, 190 ms — GiST hỗ trợ sắp theo khoảng cách. - Ngưỡng
%với GIN:Bitmap Index Scan, 104 ms — GIN nhanh nhất cho lọc ngưỡng. - KNN
<->với GIN: rơi vềSeq Scan— GIN không hỗ trợ<->.
Đây là quyết định kiến trúc then chốt: GiST hỗ trợ toán tử KNN <-> (tìm "top-N giống nhất" bằng index), còn GIN nhanh hơn cho toán tử ngưỡng % nhưng không làm được KNN. Nếu tính năng của bạn là "gợi ý N kết quả giống nhất" (như thanh tìm kiếm tự động), GiST là lựa chọn. Nếu chỉ cần lọc "các dòng đủ giống", GIN nhanh hơn.
Điều LIKE và FTS không làm được
Sức mạnh thật của trigram là chịu lỗi gõ. Đo thật: tìm với chuỗi gõ sai 'Postgersql 500' (đảo chữ), ORDER BY ten_sp <-> 'Postgersql 500' LIMIT 3 trả về PostgreSQL 500, PostgreSQL 50000... — đúng cái người dùng muốn, dù họ gõ sai. Cùng chuỗi đó, LIKE '%Postgersql%' trả về 0 dòng, và FTS cũng không khớp vì Postgersql không phải một từ hợp lệ để stem.
Đây là nền tảng của các tính năng "ý bạn là...?", tự động sửa lỗi, và tìm kiếm khoan dung với người dùng gõ vội trên điện thoại.
Đánh đổi cần cân nhắc
Trigram không hiểu ngữ nghĩa, chỉ hiểu hình dạng chuỗi. Nó thấy Postgersql giống PostgreSQL vì chung nhiều trigram, nhưng không biết database và CSDL là cùng nghĩa. Cho tìm theo nghĩa/từ đồng nghĩa, FTS (với từ điển đồng nghĩa) mới đúng. Trigram và FTS bổ sung nhau: FTS cho khớp từ chính xác + xếp hạng, trigram cho khoan dung lỗi gõ.
Ngưỡng similarity cần chỉnh theo dữ liệu. Mặc định pg_trgm.similarity_threshold = 0.3 có thể quá lỏng (nhiều kết quả rác) hoặc quá chặt tùy độ dài chuỗi và ngôn ngữ. Chuỗi ngắn chia sẻ ít trigram nên điểm thấp hơn; cân chỉnh ngưỡng bằng SET pg_trgm.similarity_threshold và đo trên dữ liệu thật.
GiST nhỏ hơn nhưng tra chậm hơn GIN cho %. Không có index "tốt nhất tuyệt đối": GiST linh hoạt (hỗ trợ <->) nhưng chậm hơn cho lọc thuần; GIN nhanh cho % nhưng không KNN và lớn hơn. Nếu cần cả hai kiểu truy vấn, có thể phải cân nhắc hai index hoặc chọn theo truy vấn phổ biến nhất.
Ba ý mang về
- pg_trgm đo độ tương tự chuỗi bằng tỉ lệ trigram chung, nên tìm được cả khi gõ sai chính tả: đo thật
similarity('PostgreSQL','Postgersql')= 0.467 dù đảo chữ, và%vẫn khớp — điềuLIKE(khớp ký tự) và FTS (khớp từ) không làm được. - Hai toán tử đi với hai index:
%(ngưỡng, GIN nhanh nhất — đo 104 ms) để lọc "đủ giống", và<->(khoảng cách KNN, chỉ GiST hỗ trợ index — đo 190 ms) để tìm "top-N giống nhất"; GIN không làm được<->. - Trigram bổ sung chứ không thay FTS: nó khoan dung lỗi gõ nhưng không hiểu ngữ nghĩa/từ đồng nghĩa; dùng trigram cho tìm gần đúng và tự động hoàn thành, FTS cho khớp từ và xếp hạng theo nghĩa.
Phần sau ta rời chủ đề tìm kiếm, quay về nền tảng thiết kế ảnh hưởng mọi thứ: Phần sau đo việc chọn kiểu số cho đúng — int2/int4/int8, numeric so với float, và cái giá thật của việc chọn sai kiểu cho cột.
