Tìm kiếm chuỗi bằng LIKE và ILIKE là thứ gần như dự án nào cũng có, và cũng là nơi hiệu năng dễ sụp nhất khi dữ liệu lớn lên. Câu trả lời "index nào dùng được" phụ thuộc vào vị trí dấu % — và một chi tiết ít ai để ý: locale của database. Bài này đo thật bốn tình huống trên bảng 3 triệu dòng, chỉ ra vì sao một btree bình thường có thể không phục vụ nổi LIKE 'abc%', và khi nào bắt buộc phải dùng trigram.
Ba dạng mẫu, ba số phận
Vị trí dấu % quyết định index nào dùng được:
'Nguyen%'(neo đầu): về nguyên tắc btree dùng được — nhưng có điều kiện locale.'%Van%'(bao hai đầu) và'%Van A'(neo cuối): không btree nào giúp được, phải dùng trigram.
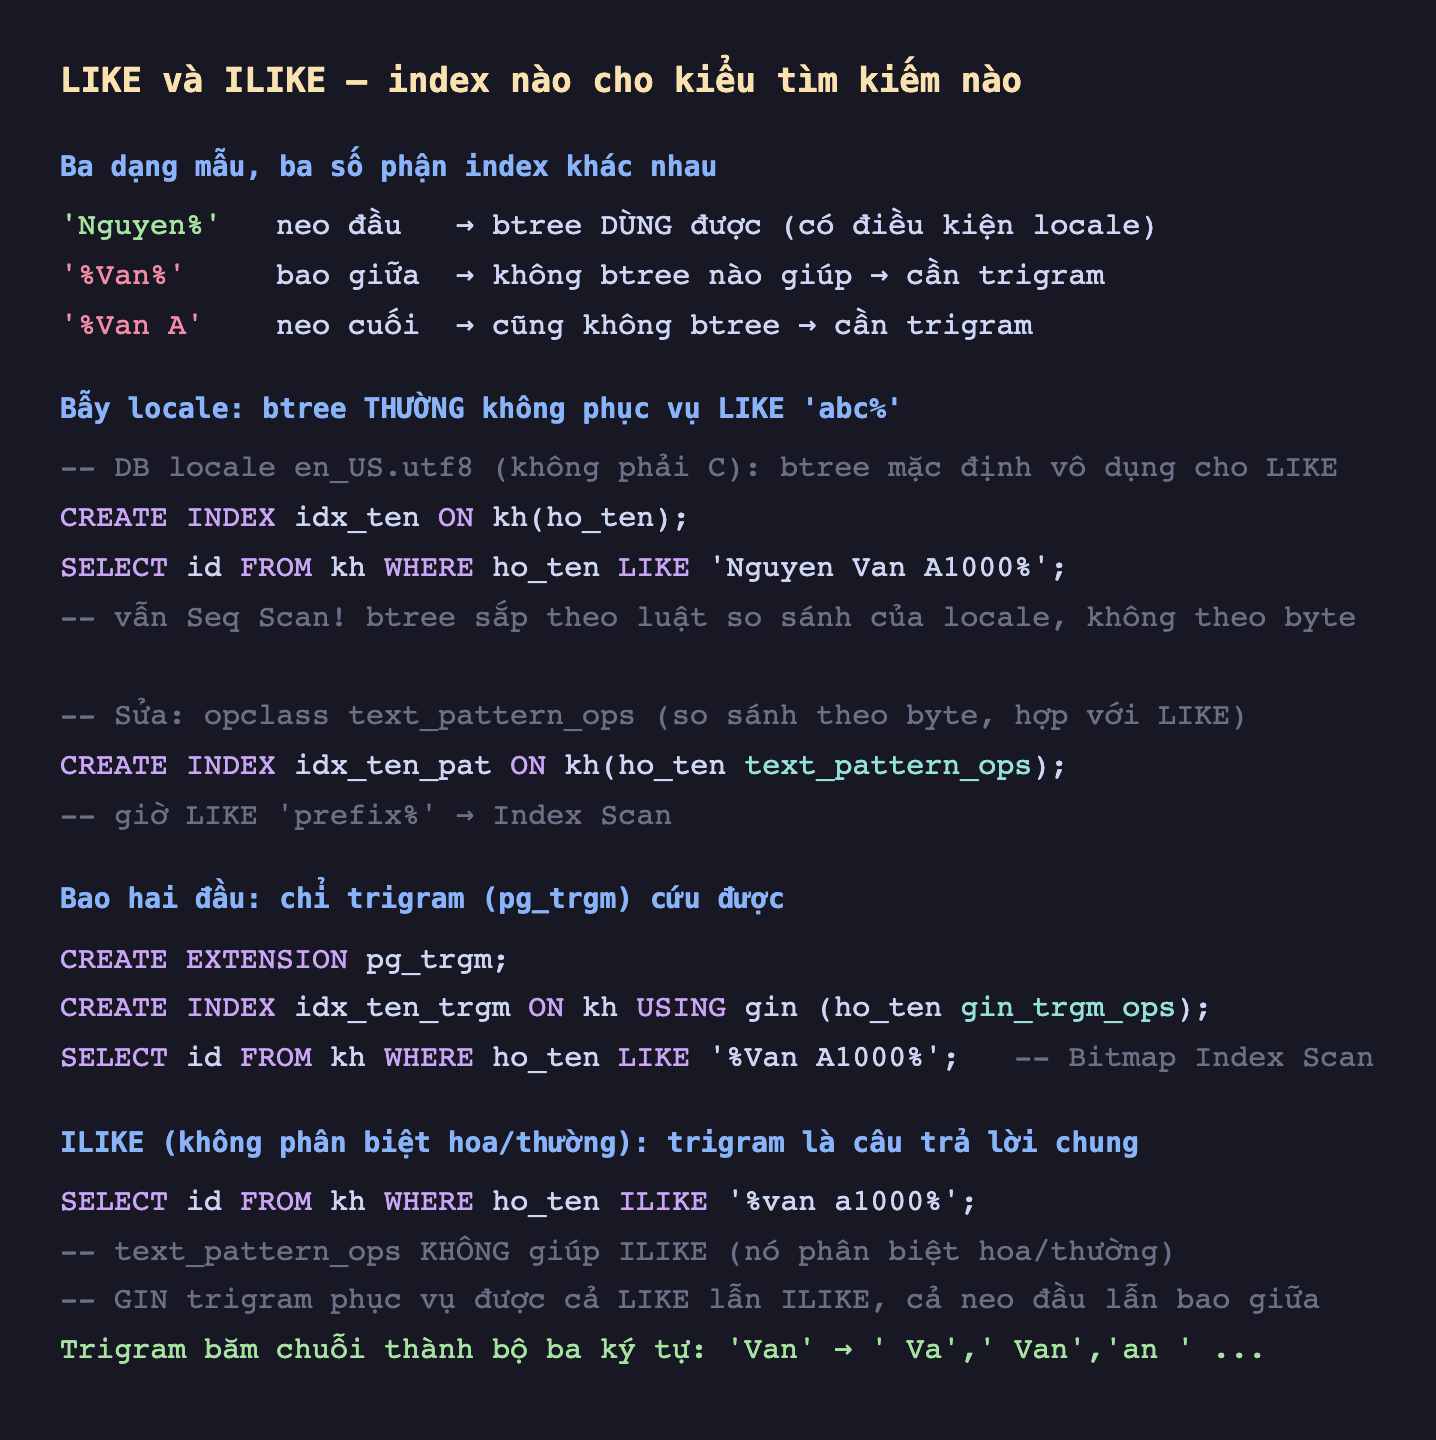
Hình 1: Vị trí dấu % quyết định index. Neo đầu dùng btree (cần text_pattern_ops khi locale khác C); bao giữa/neo cuối cần trigram; ILIKE luôn cần trigram.
Bẫy locale: btree thường không phục vụ LIKE 'abc%'
Đây là điều bất ngờ nhất. Bảng kh 3 triệu dòng, database chạy locale en_US.utf8 (mặc định phổ biến, không phải C). Ta có index btree bình thường trên ho_ten và tìm neo đầu:
CREATE INDEX idx_kh_ten ON kh(ho_ten);
SELECT id FROM kh WHERE ho_ten LIKE 'Nguyen Van A1000%';
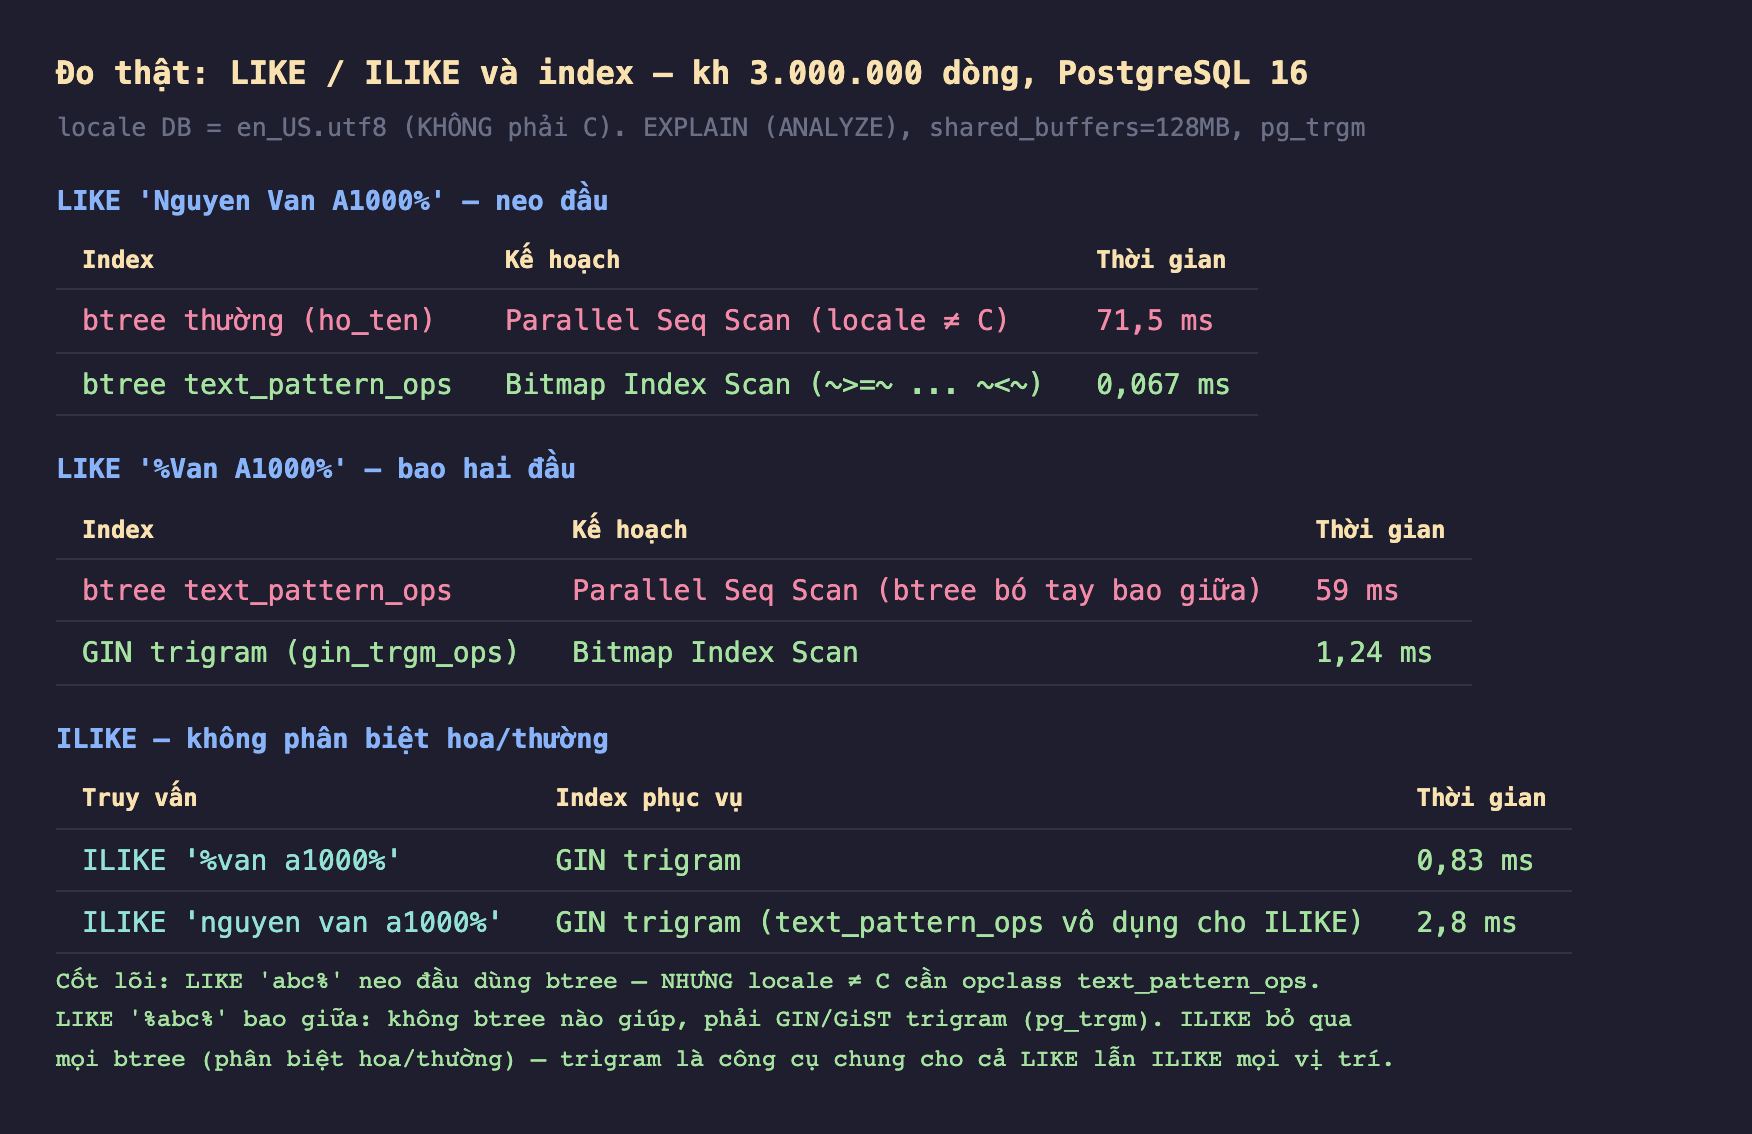
Hình 2: Neo đầu với btree thường vẫn Seq Scan 71,5 ms vì locale khác C; text_pattern_ops đưa về Bitmap Index Scan 0,067 ms. Bao giữa cần trigram (1,24 ms); ILIKE chỉ trigram phục vụ (0,83–2,8 ms).
Kết quả gây bất ngờ: Parallel Seq Scan toàn bảng, 71,5 ms — dù có index và mẫu neo đầu. Lý do: btree được sắp theo luật so sánh của locale (en_US.utf8), không phải theo byte thô. LIKE so khớp theo byte, nên thứ tự trong index không khớp với thứ tự mà LIKE cần để giới hạn phạm vi. Chỉ khi database dùng locale C thì btree mặc định mới phục vụ LIKE 'abc%'.
Cách sửa là chỉ định operator class text_pattern_ops — nó bảo btree sắp theo byte, đúng cái LIKE cần:
CREATE INDEX idx_kh_ten_pat ON kh(ho_ten text_pattern_ops);
Sau đó cùng truy vấn chạy Bitmap Index Scan với điều kiện (ho_ten ~>=~ 'Nguyen Van A1000' AND ho_ten ~<~ 'Nguyen Van A1001') — 0,067 ms, nhanh hơn ~1.000 lần. text_pattern_ops là mảnh ghép thường bị bỏ quên khi tìm kiếm neo đầu chậm bất thường.
Bao hai đầu: chỉ trigram cứu được
Với mẫu '%Van A1000%' (dấu % ở đầu), không btree nào giúp được — kể cả text_pattern_ops. Btree chỉ giới hạn được phạm vi khi biết phần đầu chuỗi; mẫu mở đầu bằng % không cho nó điểm bắt đầu. Đo thật: với text_pattern_ops, mẫu bao giữa vẫn Seq Scan 59 ms.
Công cụ đúng là trigram qua extension pg_trgm. Nó băm mỗi chuỗi thành các bộ ba ký tự ('Van' → ' Va', ' Van', 'an '...) và đánh index các bộ ba đó bằng GIN, nên tìm được chuỗi con ở bất kỳ vị trí:
CREATE EXTENSION pg_trgm;
CREATE INDEX idx_kh_ten_trgm ON kh USING gin (ho_ten gin_trgm_ops);
SELECT id FROM kh WHERE ho_ten LIKE '%Van A1000%';   -- Bitmap Index Scan, 1,24 ms
Từ 59 ms xuống 1,24 ms. Trigram GIN là cách chuẩn để index tìm kiếm chuỗi con trong PostgreSQL.
ILIKE: trigram là câu trả lời chung
ILIKE (không phân biệt hoa thường) khắt khe hơn nữa: không btree nào phục vụ nó, kể cả text_pattern_ops (vốn phân biệt hoa thường). May thay, GIN trigram phục vụ được cả LIKE lẫn ILIKE, cả neo đầu lẫn bao giữa:
ILIKE '%van a1000%': GIN trigram — 0,83 ms.ILIKE 'nguyen van a1000%': cũng dùng GIN trigram (không phảitext_pattern_ops) — 2,8 ms.
Nếu ứng dụng cần tìm kiếm không phân biệt hoa thường trên cột lớn, một index GIN trigram là giải pháp gần như duy nhất dùng được index.
Đánh đổi cần cân nhắc
Trigram GIN lớn và chậm ghi hơn btree. Nó lưu nhiều bộ ba cho mỗi dòng nên index to hơn hẳn, và mỗi INSERT/UPDATE cập nhật tốn hơn. Nếu tìm kiếm của bạn luôn neo đầu ('abc%'), một btree text_pattern_ops nhỏ gọn và nhanh hơn nhiều — đừng dùng trigram khi không cần bao giữa.
Mẫu quá ngắn làm trigram kém hiệu quả. Trigram cần ít nhất ba ký tự để tạo một bộ ba đầy đủ. Tìm LIKE '%ab%' (dưới 3 ký tự) khiến trigram phải recheck nhiều, gần như quét lại. Với tìm kiếm cực ngắn hoặc gõ dần từng phím, cân nhắc full-text search hoặc giới hạn độ dài tối thiểu.
Cân nhắc GiST nếu cần cập nhật nhiều. pg_trgm hỗ trợ cả GIN và GiST. GIN tra nhanh hơn nhưng ghi chậm; GiST ghi nhanh hơn nhưng tra chậm hơn. Bảng ghi nhiều mà tra ít có thể hợp với GiST — đo cả hai với dữ liệu thật.
Ba ý mang về
- Vị trí dấu
%quyết định index:LIKE 'abc%'neo đầu dùng được btree, nhưngLIKE '%abc%'bao giữa thì không btree nào giúp — phải dùng trigram GIN (pg_trgm), đo thật đưa từ 59 ms xuống 1,24 ms. - Bẫy locale: btree thường không phục vụ
LIKE 'abc%'khi locale khácC— đo thật vẫn Seq Scan 71,5 ms; phải chỉ định opclasstext_pattern_opsđể btree sắp theo byte (đưa về 0,067 ms). ILIKEbỏ qua mọi btree (kể cảtext_pattern_opsvì nó phân biệt hoa thường) — trigram là công cụ chung phục vụ cảLIKElẫnILIKEở mọi vị trí, nhưng nó lớn và ghi chậm hơn nên chỉ dùng khi thật sự cần bao giữa hoặc không phân biệt hoa thường.
Phần sau ta đi tới công cụ tìm kiếm văn bản mạnh nhất của PostgreSQL: Phần sau mổ xẻ full-text search với tsvector và tsquery — tìm theo từ và gốc từ thay vì khớp chuỗi thô, và index GIN cho nó.
