Mọi thứ ta đã học về nén đều ngầm giả định một điều: dữ liệu đủ lớn. LZ77 cần một cửa sổ dữ liệu để tìm lặp, Huffman cần đủ ký tự để bảng tần suất có nghĩa. Nhưng trong thực tế, rất nhiều dữ liệu là nhiều mẩu nhỏ phải nén riêng lẻ: mỗi entry trong cache Redis, mỗi message trong hàng đợi, mỗi bản ghi trong một cột database, mỗi dòng log JSON — thường chỉ vài trăm byte, và phải nén/giải nén độc lập để truy cập ngẫu nhiên. Nén từng mẩu nhỏ như vậy cho kết quả tệ hại — đôi khi gần như vô dụng. zstd có một vũ khí riêng cho đúng tình huống này: từ điển (dictionary). Bài này (phần 8 loạt Nén) đo thật để thấy từ điển biến một tỉ lệ nén thảm hại thành tốt như thế nào.
Vấn đề: bản ghi nhỏ nén riêng thì tệ
Khi bạn nén một bản ghi 200 byte một mình, hai thứ chống lại bạn:
- Mỗi lần nén bắt đầu từ số 0: LZ77 (phần 4) tìm lặp trong cửa sổ đã thấy — nhưng với 200 byte, nó chưa kịp thấy gì để tìm lặp. Không có lịch sử để tham chiếu.
- Overhead cố định nuốt hết lợi: mỗi luồng nén phải lưu bảng Huffman/header. Với dữ liệu lớn, overhead đó không đáng kể; với 200 byte, nó có thể lớn hơn phần tiết kiệm được.
Nghịch lý là: các bản ghi thường rất giống nhau — cùng tên khóa JSON, cùng cấu trúc, cùng các giá trị lặp. Nhưng phần lặp đó nằm giữa các bản ghi, không nằm trong một bản ghi. Nén riêng từng cái thì không cách nào thấy được sự lặp chung đó.
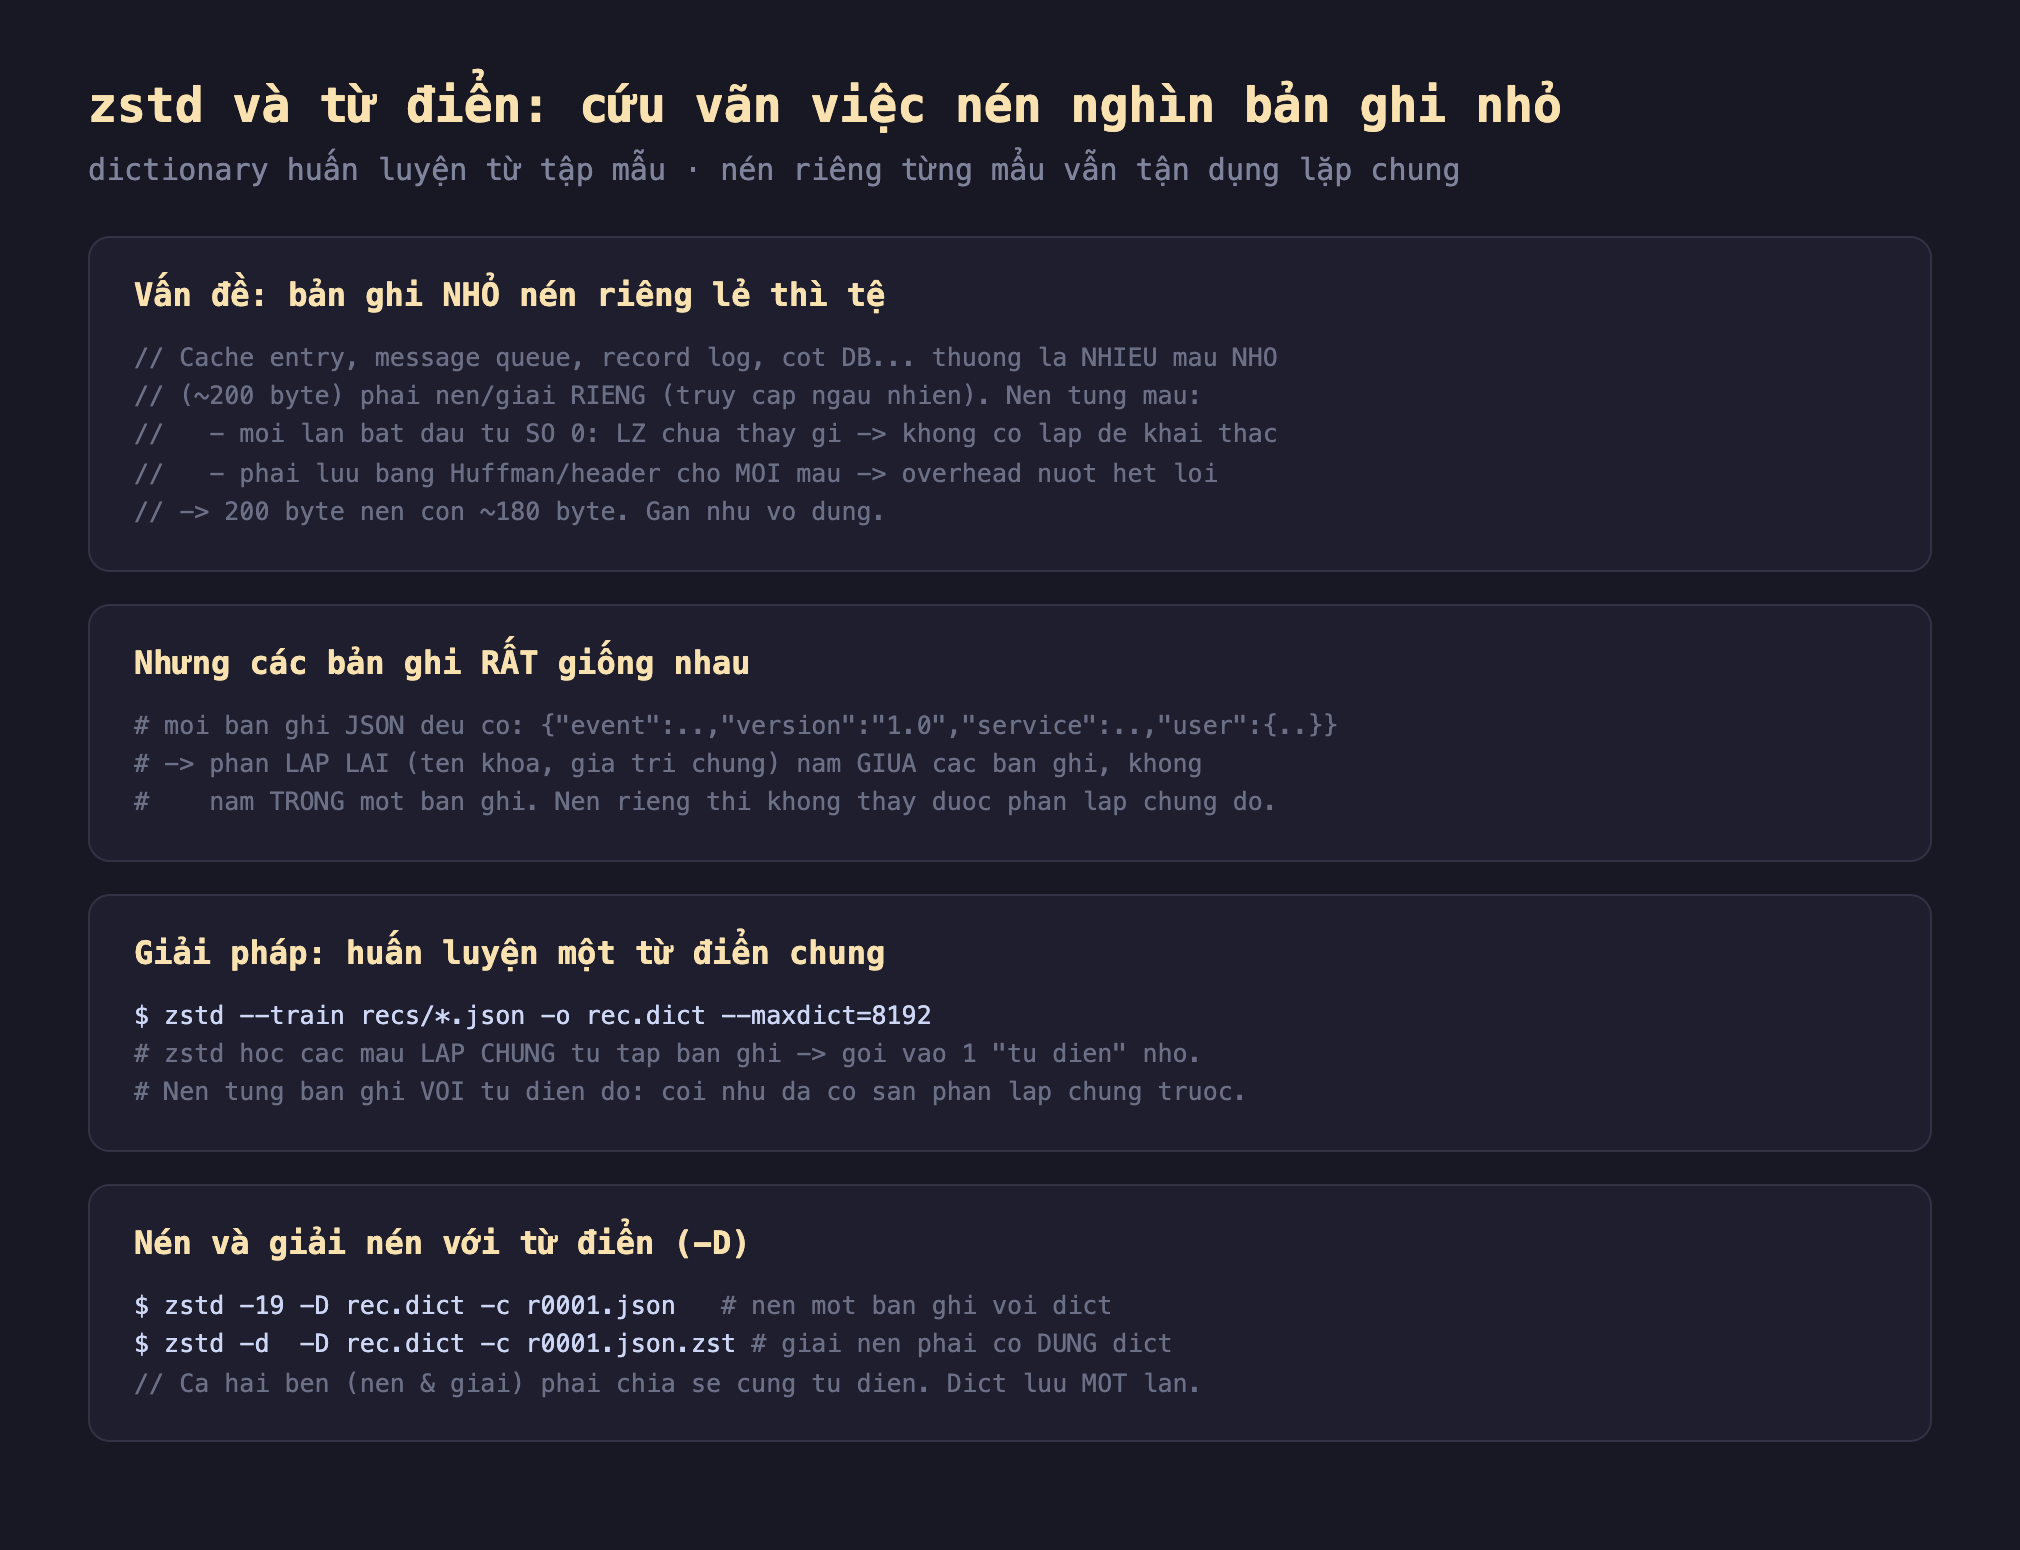
Hình 1: Bản ghi nhỏ nén riêng thì tệ (mỗi lần bắt đầu từ số 0, overhead nuốt lợi); nhưng các bản ghi rất giống nhau — phần lặp nằm giữa chúng; giải pháp là huấn luyện một từ điển chung bằng zstd --train rồi nén từng bản ghi với -D, cả hai bên chia sẻ cùng từ điển.
Giải pháp: huấn luyện một từ điển chung
Ý tưởng của dictionary: quét một tập mẫu các bản ghi, học các đoạn lặp chung (tên khóa, giá trị hay gặp, cấu trúc), gói chúng vào một "từ điển" nhỏ. Sau đó, nén từng bản ghi với từ điển đó — coi như bộ nén đã có sẵn lịch sử chứa các đoạn lặp chung trước khi bắt đầu, nên nó tham chiếu ngược vào từ điển được ngay từ byte đầu tiên.
# Huấn luyện: học đoạn lặp chung từ tập bản ghi
$ zstd --train recs/*.json -o rec.dict --maxdict=8192
# Nén từng bản ghi VỚI từ điển (mỗi bản ghi vẫn nén/giải độc lập)
$ zstd -19 -D rec.dict -c r0001.json
# Giải nén PHẢI có đúng từ điển đó
$ zstd -d -D rec.dict -c r0001.json.zst
Điểm mấu chốt: cả bên nén và bên giải nén phải chia sẻ cùng từ điển, và từ điển chỉ cần lưu/gửi một lần cho cả tập.
Đo thật: 1.3x thành 4.4x
Mình tạo 3000 bản ghi JSON nhỏ (trung bình 223 byte, cùng cấu trúc, khác giá trị), nén riêng từng cái — không từ điển và có từ điển:
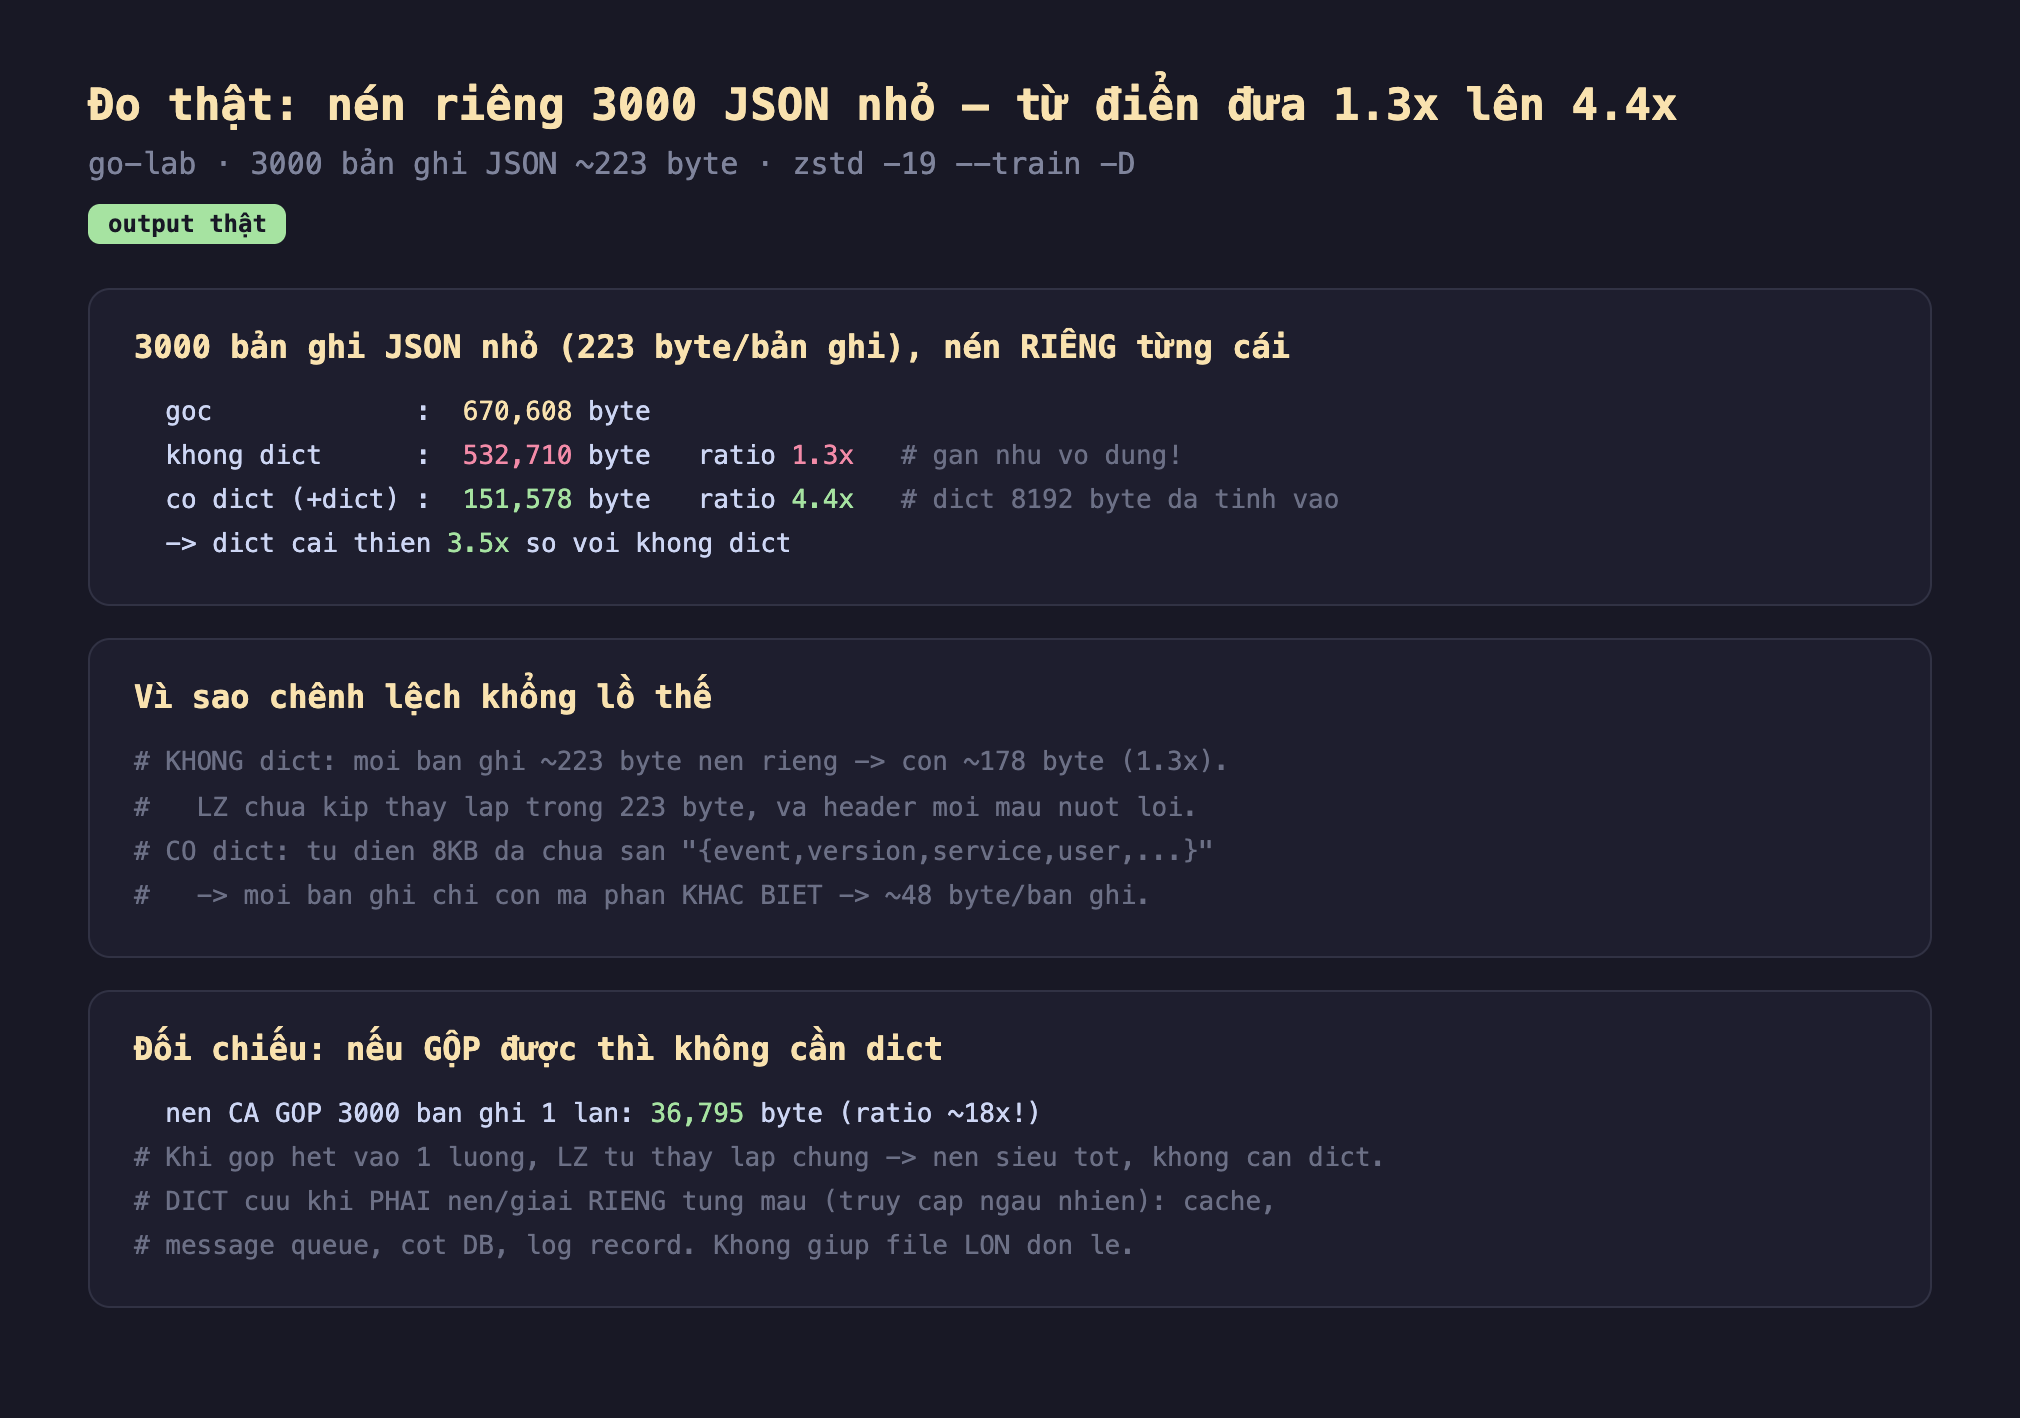
Hình 2: Chạy thật — 3000 JSON (223 byte/bản ghi, tổng 670.608 byte): nén riêng KHÔNG từ điển chỉ 532.710 byte (1.3x); CÓ từ điển 8KB đạt 151.578 byte (4.4x) — cải thiện 3.5x; đối chiếu nén gộp cả 3000 bản ghi một lần chỉ 36.795 byte (~18x).
- Không từ điển: 1.3x — gần như vô dụng: 3000 bản ghi tổng 670KB nén riêng chỉ còn 533KB. Mỗi bản ghi 223 byte co lại còn ~178 byte — tiết kiệm chưa tới 20%. Đúng như dự đoán: LZ chưa kịp thấy lặp trong 223 byte, và overhead header mỗi mẩu ăn hết phần tiết kiệm.
- Có từ điển: 4.4x — cải thiện 3.5 lần: huấn luyện một từ điển 8KB rồi nén từng bản ghi với nó, tổng còn 151KB (đã tính cả 8KB từ điển). Mỗi bản ghi giờ chỉ còn ~48 byte, vì từ điển đã chứa sẵn
{"event":...,"version":"1.0","service":...}— bản ghi chỉ cần mã hóa phần khác biệt. Cùng dữ liệu, cùng công cụ, chỉ thêm một từ điển 8KB dùng chung: tỉ lệ nén nhảy 3.5 lần. - Đối chiếu: gộp được thì không cần từ điển: nếu nén cả 3000 bản ghi trong một luồng, kết quả chỉ 37KB — tỉ lệ ~18x, tốt hơn cả có từ điển. Vì khi gộp, LZ tự thấy các đoạn lặp chung giữa các bản ghi. Đây là điểm quan trọng: từ điển không phải để nén tốt hơn nói chung — nó để cứu trường hợp bạn buộc phải nén/giải nén riêng từng mẩu (truy cập ngẫu nhiên). Khi có thể gộp (nén cả file, cả batch), cứ gộp — không cần từ điển.
Đánh đổi cần cân nhắc
Từ điển chỉ lợi cho nhiều mẩu nhỏ tương tự nhau — không giúp file lớn đơn lẻ. Nếu bạn nén một file 10MB, dữ liệu đã đủ lớn để LZ tự tìm lặp; từ điển không thêm gì. Từ điển chỉ tỏa sáng khi (1) có nhiều mẩu, (2) mỗi mẩu nhỏ, (3) các mẩu giống nhau về cấu trúc, và (4) phải nén/giải độc lập. Ứng dụng điển hình: giá trị trong cache (Redis), payload message queue, bản ghi trong cột database, log JSON theo dòng, response API nhỏ lặp lại.
Từ điển phải được quản lý và đồng bộ giữa nén và giải nén. Vì cả hai bên cần đúng từ điển, bạn phải lưu trữ và phiên bản hóa nó cẩn thận. Đổi từ điển là dữ liệu nén bằng từ điển cũ không giải được nếu bên giải chỉ có từ điển mới — nên thường gắn phiên bản/ID từ điển vào dữ liệu nén. Đây là chi phí vận hành thật, cân nhắc trước khi triển khai. (zstd hỗ trợ từ điển có ID nhúng để giúp việc này.)
Chất lượng từ điển phụ thuộc tập huấn luyện đại diện. zstd --train học từ mẫu bạn đưa vào, nên nếu mẫu không đại diện cho dữ liệu thật (ví dụ huấn luyện trên bản ghi cũ, dữ liệu thật đã đổi cấu trúc), từ điển kém hiệu quả. Cần huấn luyện lại định kỳ khi dữ liệu tiến hóa, và cần đủ mẫu (zstd khuyến nghị hàng nghìn mẫu). Từ điển tồi có thể chẳng giúp gì — nên đo hiệu quả thật trước khi tin.
Ba ý mang về
- Bản ghi nhỏ nén riêng thì tệ: đo thật 3000 JSON ~223 byte nén riêng không từ điển chỉ được 1.3x — vì mỗi lần nén bắt đầu từ số 0 (LZ chưa thấy lặp) và overhead header mỗi mẩu nuốt hết lợi.
- Từ điển đưa 1.3x lên 4.4x: đo thật huấn luyện từ điển 8KB bằng
zstd --trainrồi nén từng bản ghi với-D— cải thiện 3.5 lần, vì từ điển chứa sẵn phần lặp chung nên mỗi bản ghi chỉ còn mã phần khác biệt (~48 byte). - Từ điển cứu trường hợp buộc nén riêng, không phải để nén tốt hơn nói chung: đo thật nén gộp cả 3000 bản ghi một lần cho ~18x (tốt hơn từ điển); chỉ dùng từ điển khi có nhiều mẩu nhỏ tương tự phải nén/giải độc lập (cache, message queue, cột DB), và phải quản lý đồng bộ từ điển giữa hai bên.
Nguồn
- Facebook — zstd Dictionary Compression: https://github.com/facebook/zstd#dictionary-compression-how-to
- RFC 8878 — Zstandard Compression (dictionaries): https://www.rfc-editor.org/rfc/rfc8878
- zstd manual — --train: https://facebook.github.io/zstd/zstd_manual.html
Phần sau ta lùi lại nhìn bức tranh lớn: nén phụ thuộc dữ liệu thế nào — vì sao cùng một thuật toán nén text 10x mà nén dữ liệu ngẫu nhiên/đã nén 1x, và cách nhận biết dữ liệu nào còn nén được.
