Có một câu hỏi tôi thường nghe: "gzip nén được bao nhiêu lần?" — và nó không có câu trả lời. Không phải vì gzip khó đoán, mà vì câu hỏi đặt sai chỗ: tỉ lệ nén không phải thuộc tính của thuật toán, mà của dữ liệu. Cùng một gzip, cùng một mức nén, có thể cho tỉ lệ từ 1x (vô dụng) tới hàng trăm lần, tùy bạn đưa vào cái gì. Đây là hệ quả trực tiếp của entropy (phần 1): dữ liệu có nhiều dư thừa thì nén được nhiều, dữ liệu gần ngẫu nhiên thì bó tay. Bài này (phần 9 loạt Nén) đo thật cùng gzip trên nhiều loại dữ liệu để bạn thấy khoảng cách khổng lồ, và rút ra một quy tắc thực dụng quan trọng: đừng phí công nén thứ đã nén.
Tỉ lệ nén là thuộc tính của dữ liệu
Nhớ lại phần 1: entropy đo lượng "bất ngờ" trung bình mỗi byte, và không thuật toán nào nén xuống dưới entropy được. Điều đó nghĩa là: đưa cùng một gzip vào các dữ liệu có entropy khác nhau, bạn nhận tỉ lệ khác nhau hoàn toàn — thuật toán không đổi, chỉ dữ liệu đổi. Dữ liệu càng có cấu trúc (lặp lại, thiên lệch tần suất), entropy càng thấp, càng nén tốt. Dữ liệu càng ngẫu nhiên, entropy càng gần 8 bit/byte, càng không nén được.
Để thấy rõ, mình nén cùng gzip trên sáu loại dữ liệu, mỗi loại ~4MB:
a = text tiếng Việt/Anh    # từ lặp lại vừa phải
b = mã nguồn (snippet lặp) # cấu trúc lặp RẤT nhiều
c = JSON có cấu trúc       # tên khóa lặp
d = os.urandom(N)          # ngẫu nhiên: entropy tối đa
e = gzip.compress(a)       # ĐÃ NÉN rồi -> trông như ngẫu nhiên
f = base64(ngẫu nhiên)     # text-hóa nhưng ruột ngẫu nhiên
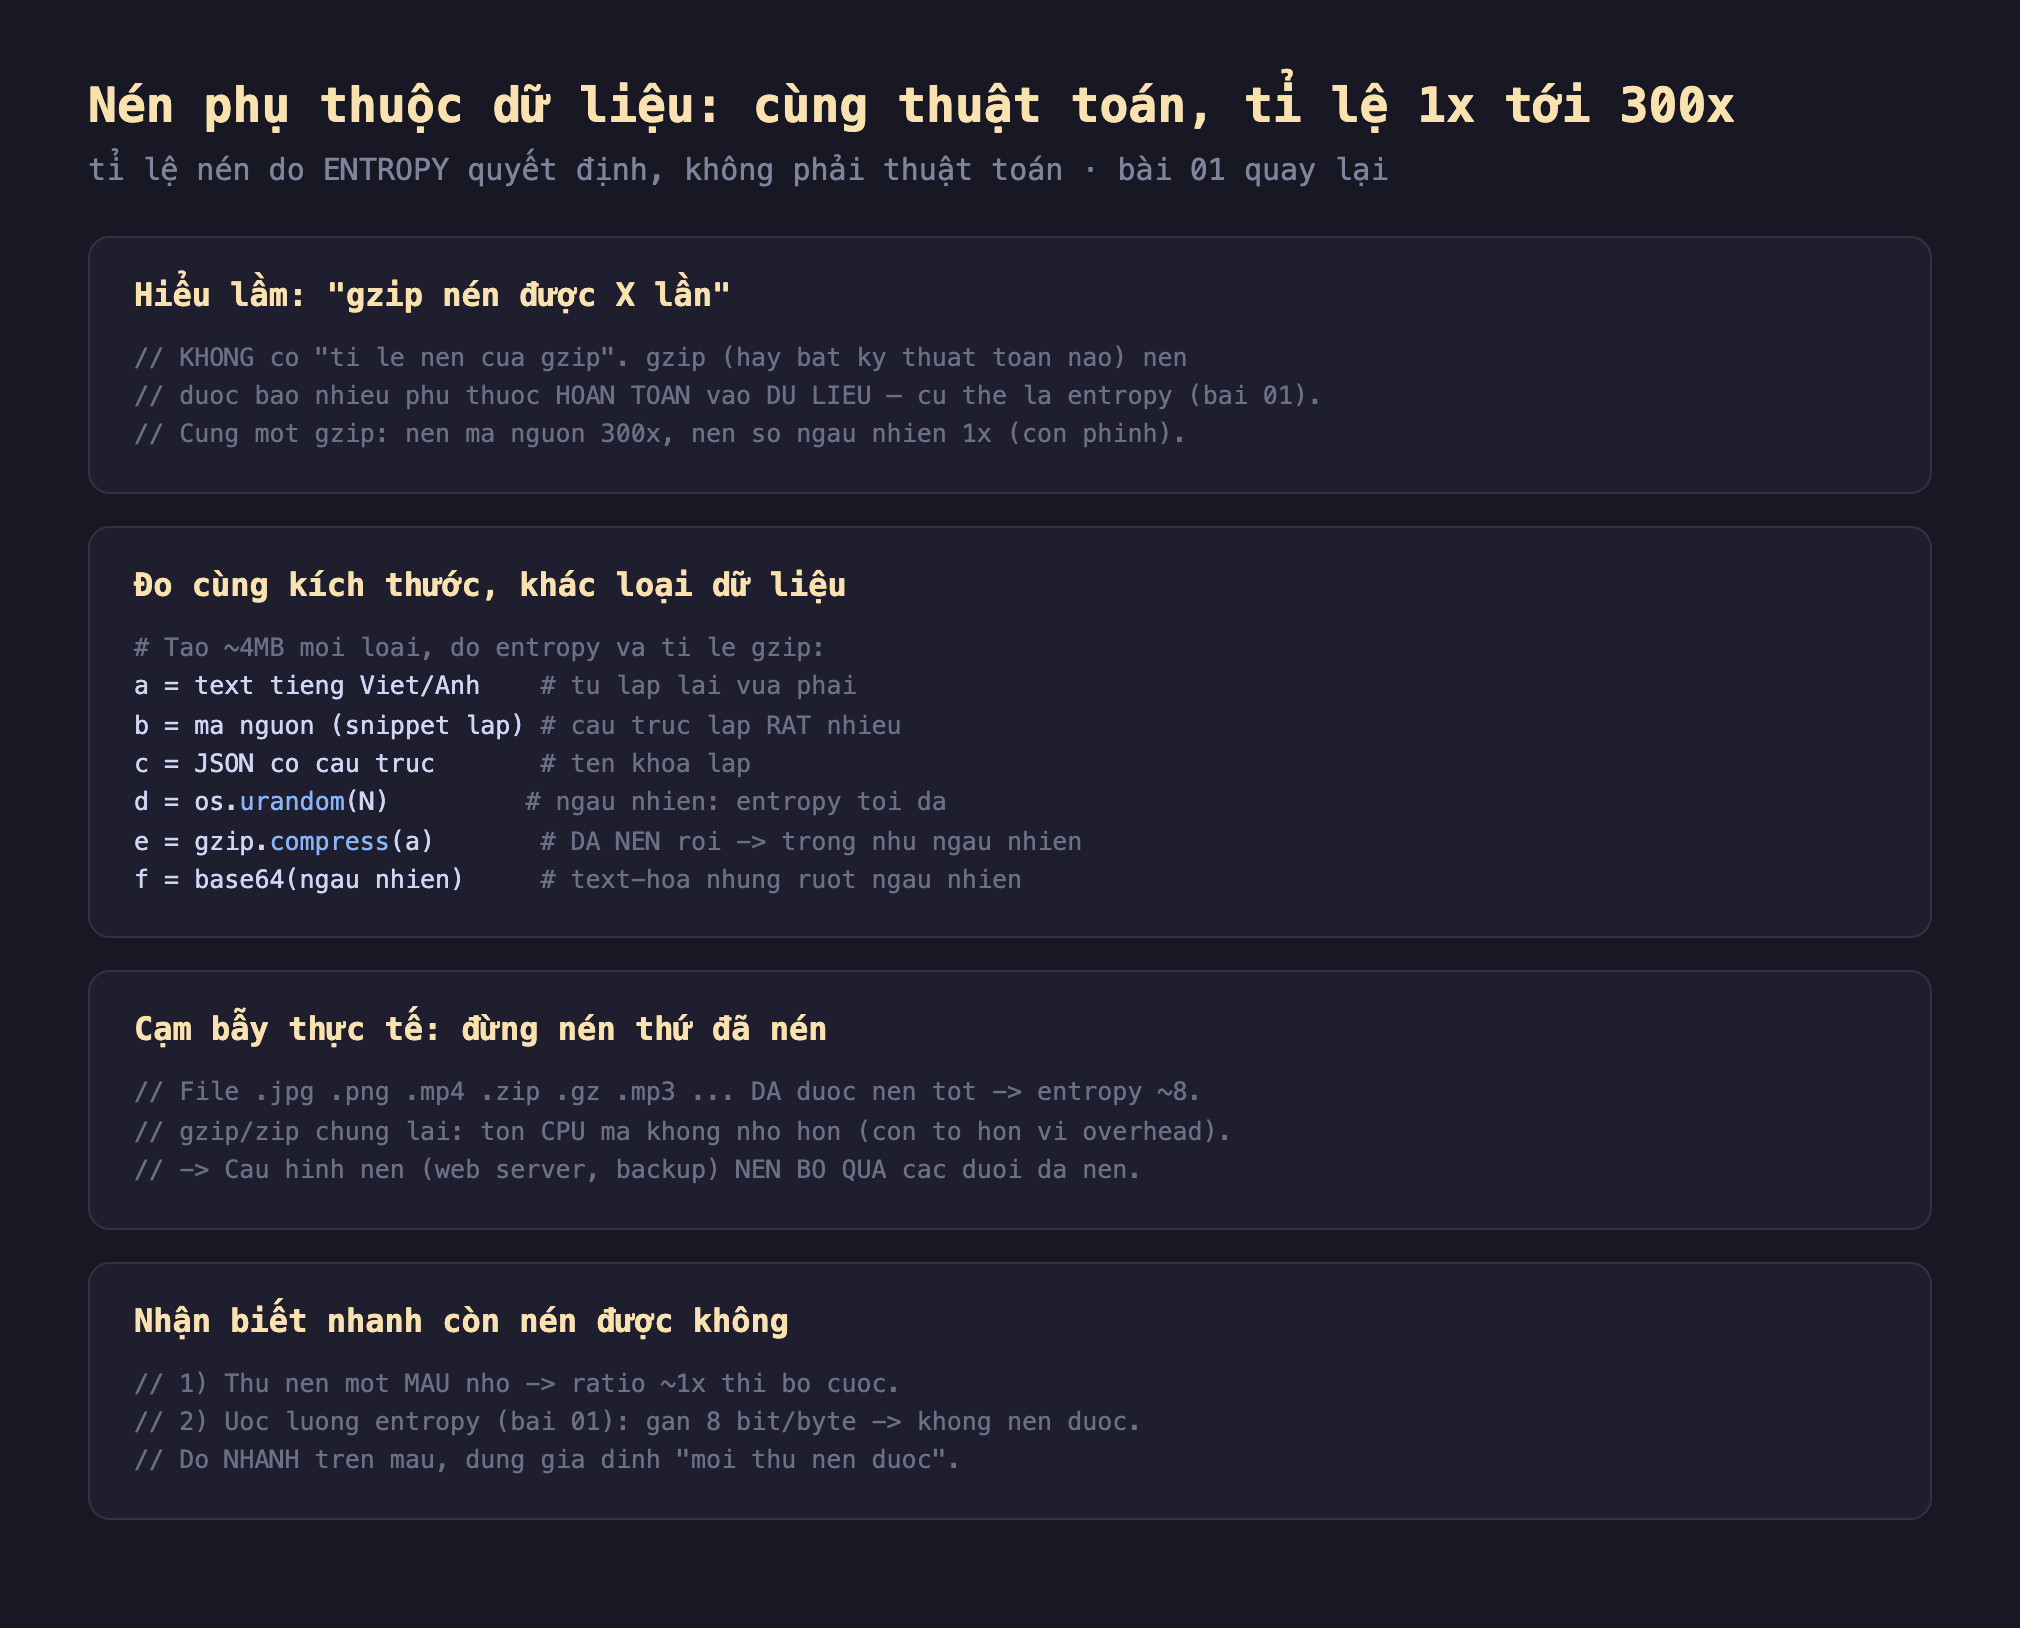
Hình 1: Tỉ lệ nén là thuộc tính của dữ liệu (entropy — phần 1), không phải của thuật toán; cùng gzip nén mã nguồn 300x nhưng nén số ngẫu nhiên 1x; cạm bẫy thực tế là đừng nén thứ đã nén (.jpg/.zip/.mp4), và nhận biết nhanh bằng cách thử nén một mẫu.
Đo thật: từ 292x tới 1x
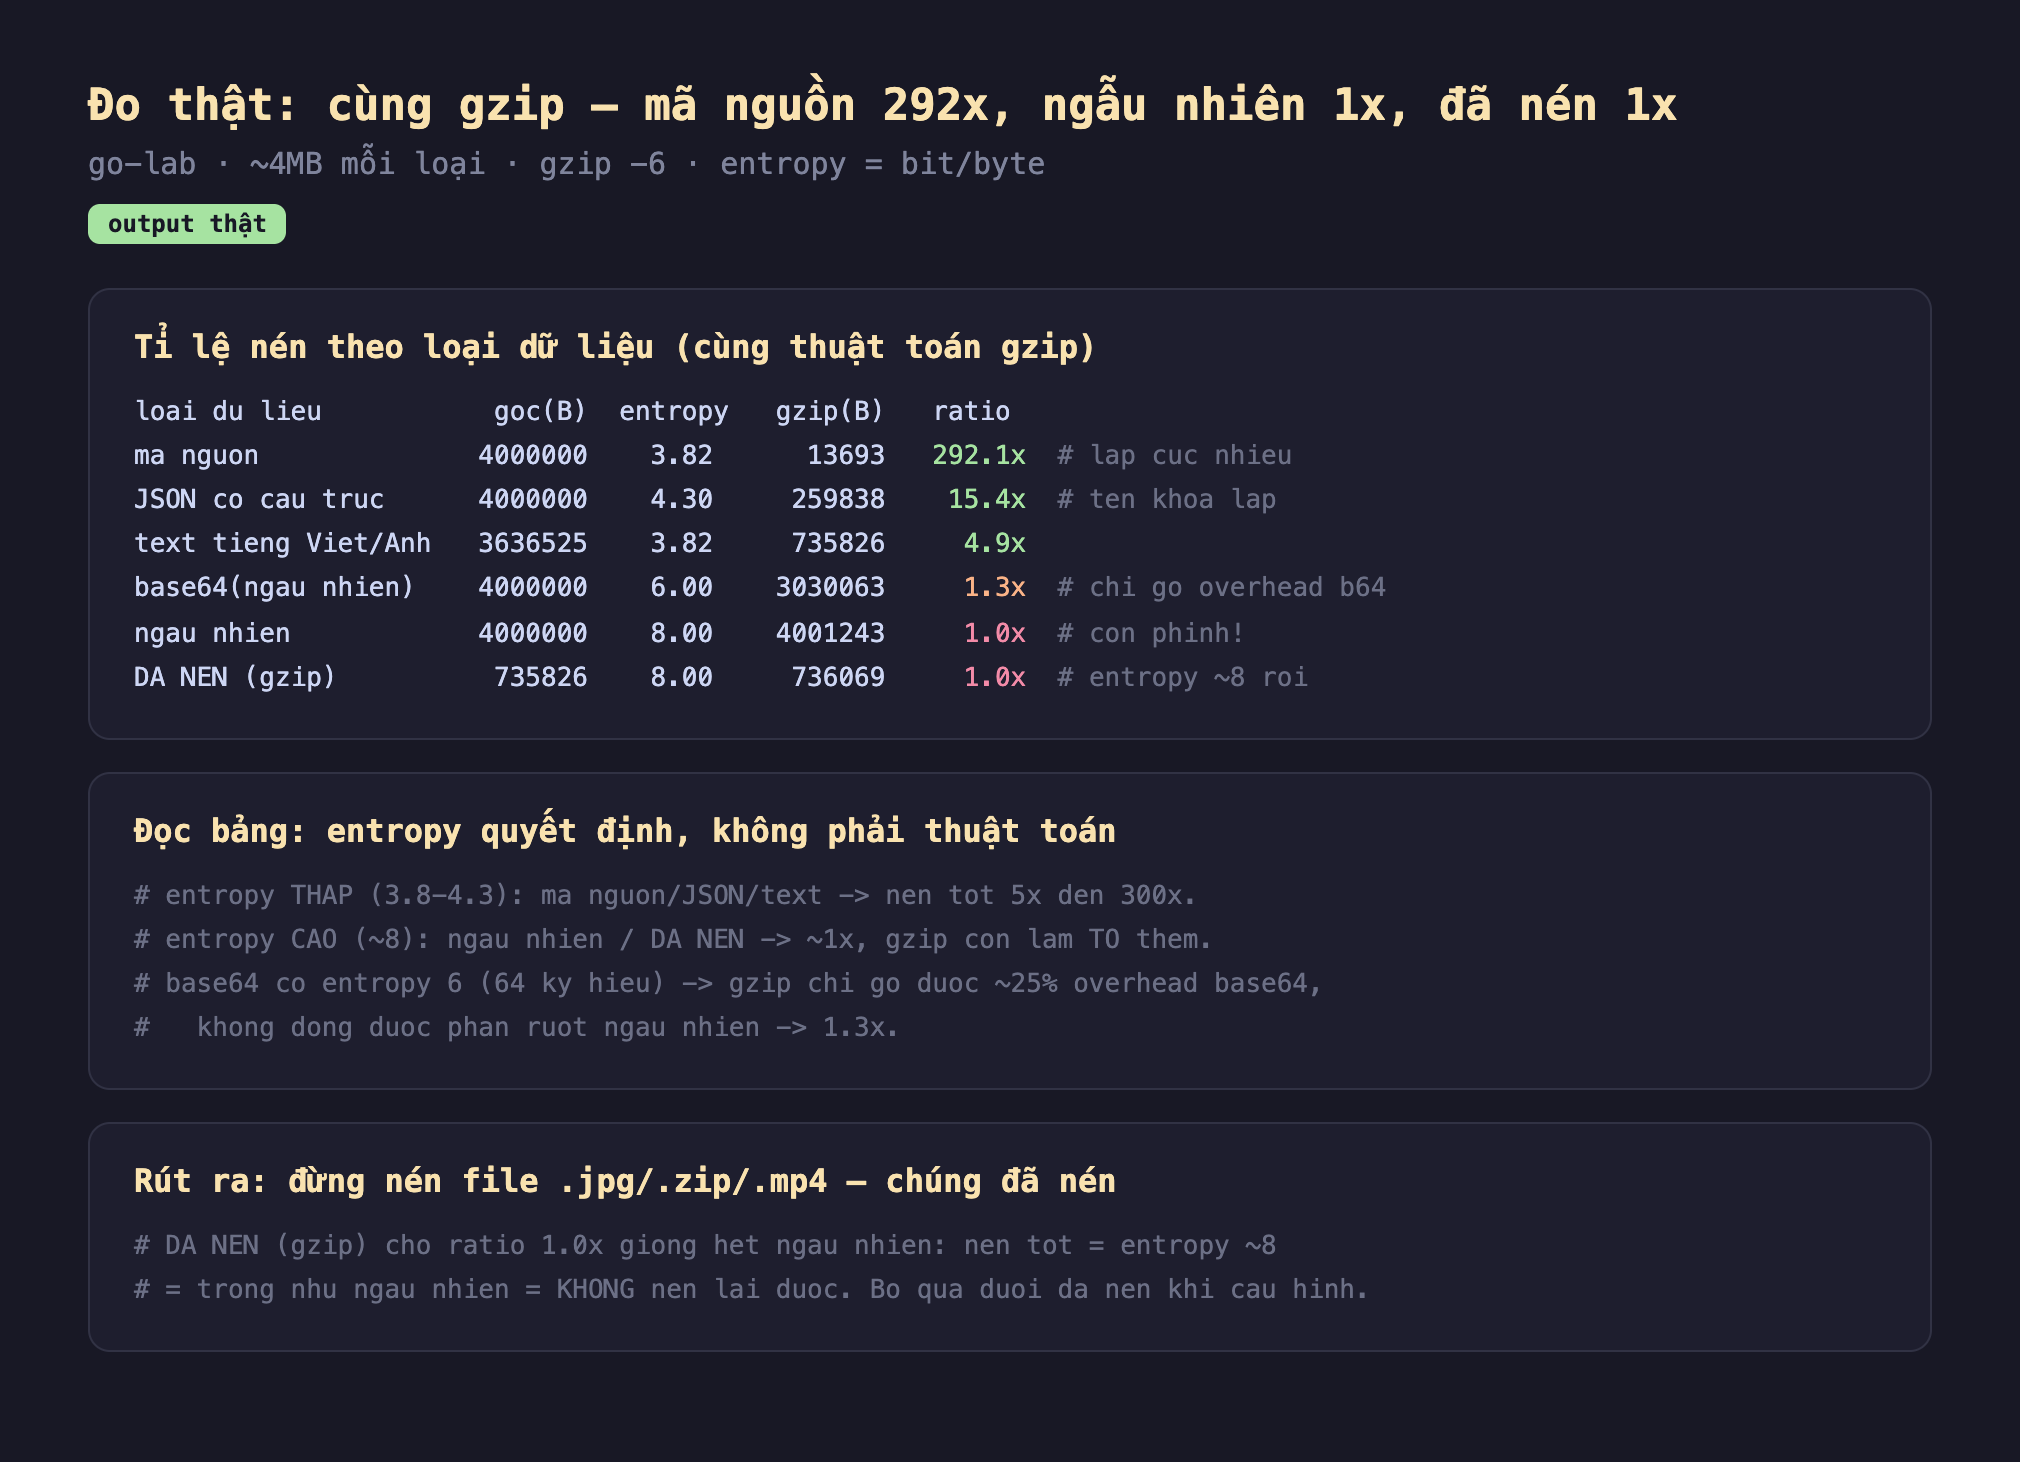
Hình 2: Chạy thật với gzip -6 trên ~4MB mỗi loại — mã nguồn (entropy 3.82) 292.1x, JSON (4.30) 15.4x, text (3.82) 4.9x, base64 ngẫu nhiên (6.00) 1.3x, ngẫu nhiên (8.00) 1.0x, đã nén (8.00) 1.0x; entropy càng thấp nén càng tốt, entropy ~8 thì bó tay.
- Entropy thấp = nén khủng: mã nguồn (một snippet lặp đi lặp lại, entropy 3.82) nén 292 lần — LZ77 tìm thấy cấu trúc lặp khắp nơi. JSON có cấu trúc (tên khóa lặp, entropy 4.30) nén 15.4x. Text (entropy 3.82) nén 4.9x. Đây là những dữ liệu bạn muốn nén.
- Entropy cao = không nén được: số ngẫu nhiên (
os.urandom, entropy 8.00) cho tỉ lệ 1.0x — gzip thậm chí làm nó to hơn một chút (4000000 → 4001243). Không có dư thừa nào để loại. Đây là bức tường entropy của phần 1, hiện ra bằng số. - Dữ liệu ĐÃ NÉN = giống hệt ngẫu nhiên: đây là bài học thực tế quan trọng nhất. Dữ liệu đã nén tốt (
gzip.compress(a)) có entropy 8.00 — trông y như ngẫu nhiên với thuật toán — nên nén lại cho 1.0x. Nén tốt = đẩy dữ liệu tới gần entropy tối đa = trông như ngẫu nhiên = không còn gì để nén. - base64 chỉ gỡ được phần overhead của nó: base64 của dữ liệu ngẫu nhiên có entropy 6.00 (64 ký hiệu, mỗi ký hiệu 6 bit nhồi trong 8 bit). gzip nén được 1.3x — vừa đúng gỡ ~25% "phí" của cách mã hóa base64, nhưng không đóng được phần ruột ngẫu nhiên. Đây là lý do gửi dữ liệu nhị phân qua base64 rồi gzip không lấy lại được kích thước gốc.
Đánh đổi cần cân nhắc
Đừng nén thứ đã nén — cấu hình bỏ qua các đuôi đã nén. File .jpg, .png, .gif, .mp4, .mp3, .zip, .gz, .docx (thực chất là zip)... đều đã được nén rồi, entropy ~8. gzip/zip chúng lại chỉ tốn CPU mà không nhỏ hơn (thường to hơn vài byte overhead). Web server (nginx gzip_types), hệ thống backup, và bất kỳ đường ống nén nào nên bỏ qua các loại này. Nén hai lần là một trong những lãng phí CPU âm thầm phổ biến nhất trong hệ thống thực.
Dữ liệu mã hóa cũng không nén được — nén trước, mã hóa sau. Mã hóa tốt tạo ra output trông ngẫu nhiên (nếu không thì nó yếu). Nên dữ liệu đã mã hóa có entropy ~8 và không nén được — đúng như dữ liệu đã nén. Hệ quả trong pipeline: luôn nén trước, mã hóa sau. Đảo thứ tự là bạn mất toàn bộ khả năng nén, như đã cảnh báo ở phần 1.
Nhận biết nhanh bằng cách thử một mẫu — đừng giả định. Trước khi thiết kế một hệ thống dựa trên "dữ liệu này sẽ nén X lần", hãy đo trên mẫu thật: nén một mẩu nhỏ, xem tỉ lệ. Nếu ~1x, dữ liệu không nén được — đừng thêm tầng nén (nó chỉ tốn CPU). Hoặc ước lượng entropy (phần 1): gần 8 bit/byte thì bó tay. Vài giây đo tiết kiệm cả một tầng vô ích trong kiến trúc.
Ba ý mang về
- Tỉ lệ nén là thuộc tính của dữ liệu, không phải thuật toán: đo thật cùng gzip cho mã nguồn
292x, JSON15.4x, text4.9x(entropy thấp 3.8-4.3), nhưng ngẫu nhiên1.0x(entropy 8) — dữ liệu quyết định, gzip chỉ là công cụ. - Entropy cao thì bó tay: đo thật số ngẫu nhiên và dữ liệu ĐÃ NÉN đều cho
1.0x(entropy ~8, gzip còn làm to thêm); nén tốt = đẩy tới entropy tối đa = trông như ngẫu nhiên = không nén lại được. - Đừng nén thứ đã nén/mã hóa: đo thật dữ liệu đã gzip nén lại chỉ
1.0x— cấu hình web server/backup nên bỏ qua.jpg/.zip/.mp4; nén trước mã hóa sau; và luôn thử nén một mẫu để biết dữ liệu có nén được không.
Nguồn
- Claude Shannon — A Mathematical Theory of Communication: https://people.math.harvard.edu/~ctm/home/text/others/shannon/entropy/entropy.pdf
- nginx docs — ngx_http_gzip_module (
gzip_types): https://nginx.org/en/docs/http/ngx_http_gzip_module.html - Python docs — gzip: https://docs.python.org/3/library/gzip.html
Phần sau ta mang nén vào nơi mọi lập trình viên web gặp nó hằng ngày: HTTP — Content-Encoding: gzip/br, cách trình duyệt và server thương lượng nén, và đo thật một response nhỏ đi bao nhiêu.
