Phần 6 cho thấy chỉnh mức nén trong một thuật toán tuân theo lợi ích giảm dần. Nhưng còn một lựa chọn lớn hơn: chọn thuật toán nào? gzip, bzip2, xz, zstd — bốn công cụ có mặt trên gần như mọi máy Linux, và chúng khác nhau về bản chất, không chỉ về tốc độ. Chọn sai không chỉ tốn thời gian mà còn tốn dung lượng hoặc làm nghẽn đường ống. Câu trả lời hay bị nói một câu ("xz nén tốt nhất, zstd nhanh nhất") — nhưng thực tế tinh tế hơn, và phụ thuộc dữ liệu. Bài này (phần 7 loạt Nén) nén cùng một file 25MB bằng cả bốn công cụ và đo đủ bốn số — kích thước, tỉ lệ, thời gian nén và thời gian giải nén — để bạn thấy bức tranh thật.
Bốn triết lý nén
Cả bốn đều là nén không-mất-mát, nhưng dùng lõi thuật toán khác nhau:
- gzip = DEFLATE = LZ77 + Huffman (phần 5). Cũ, đơn giản, tương thích rộng nhất — mọi nơi đọc được
.gz. - bzip2 = BWT + MTF + Huffman. Dùng Burrows-Wheeler Transform sắp xếp lại dữ liệu để gom các ký tự giống nhau lại gần (tạo run), rồi Move-To-Front + Huffman. Rất hợp dữ liệu lặp nhiều.
- xz = LZMA = LZ với cửa sổ rất lớn + range coding (một dạng arithmetic coding). Nén chặt nhất cho phần lớn dữ liệu, nhưng nén rất chậm.
- zstd = LZ + FSE/ANS (+ dictionary tùy chọn). Thiết kế hiện đại (Facebook, 2016): nén nhanh, và đặc biệt giải nén cực nhanh bất kể mức nén.
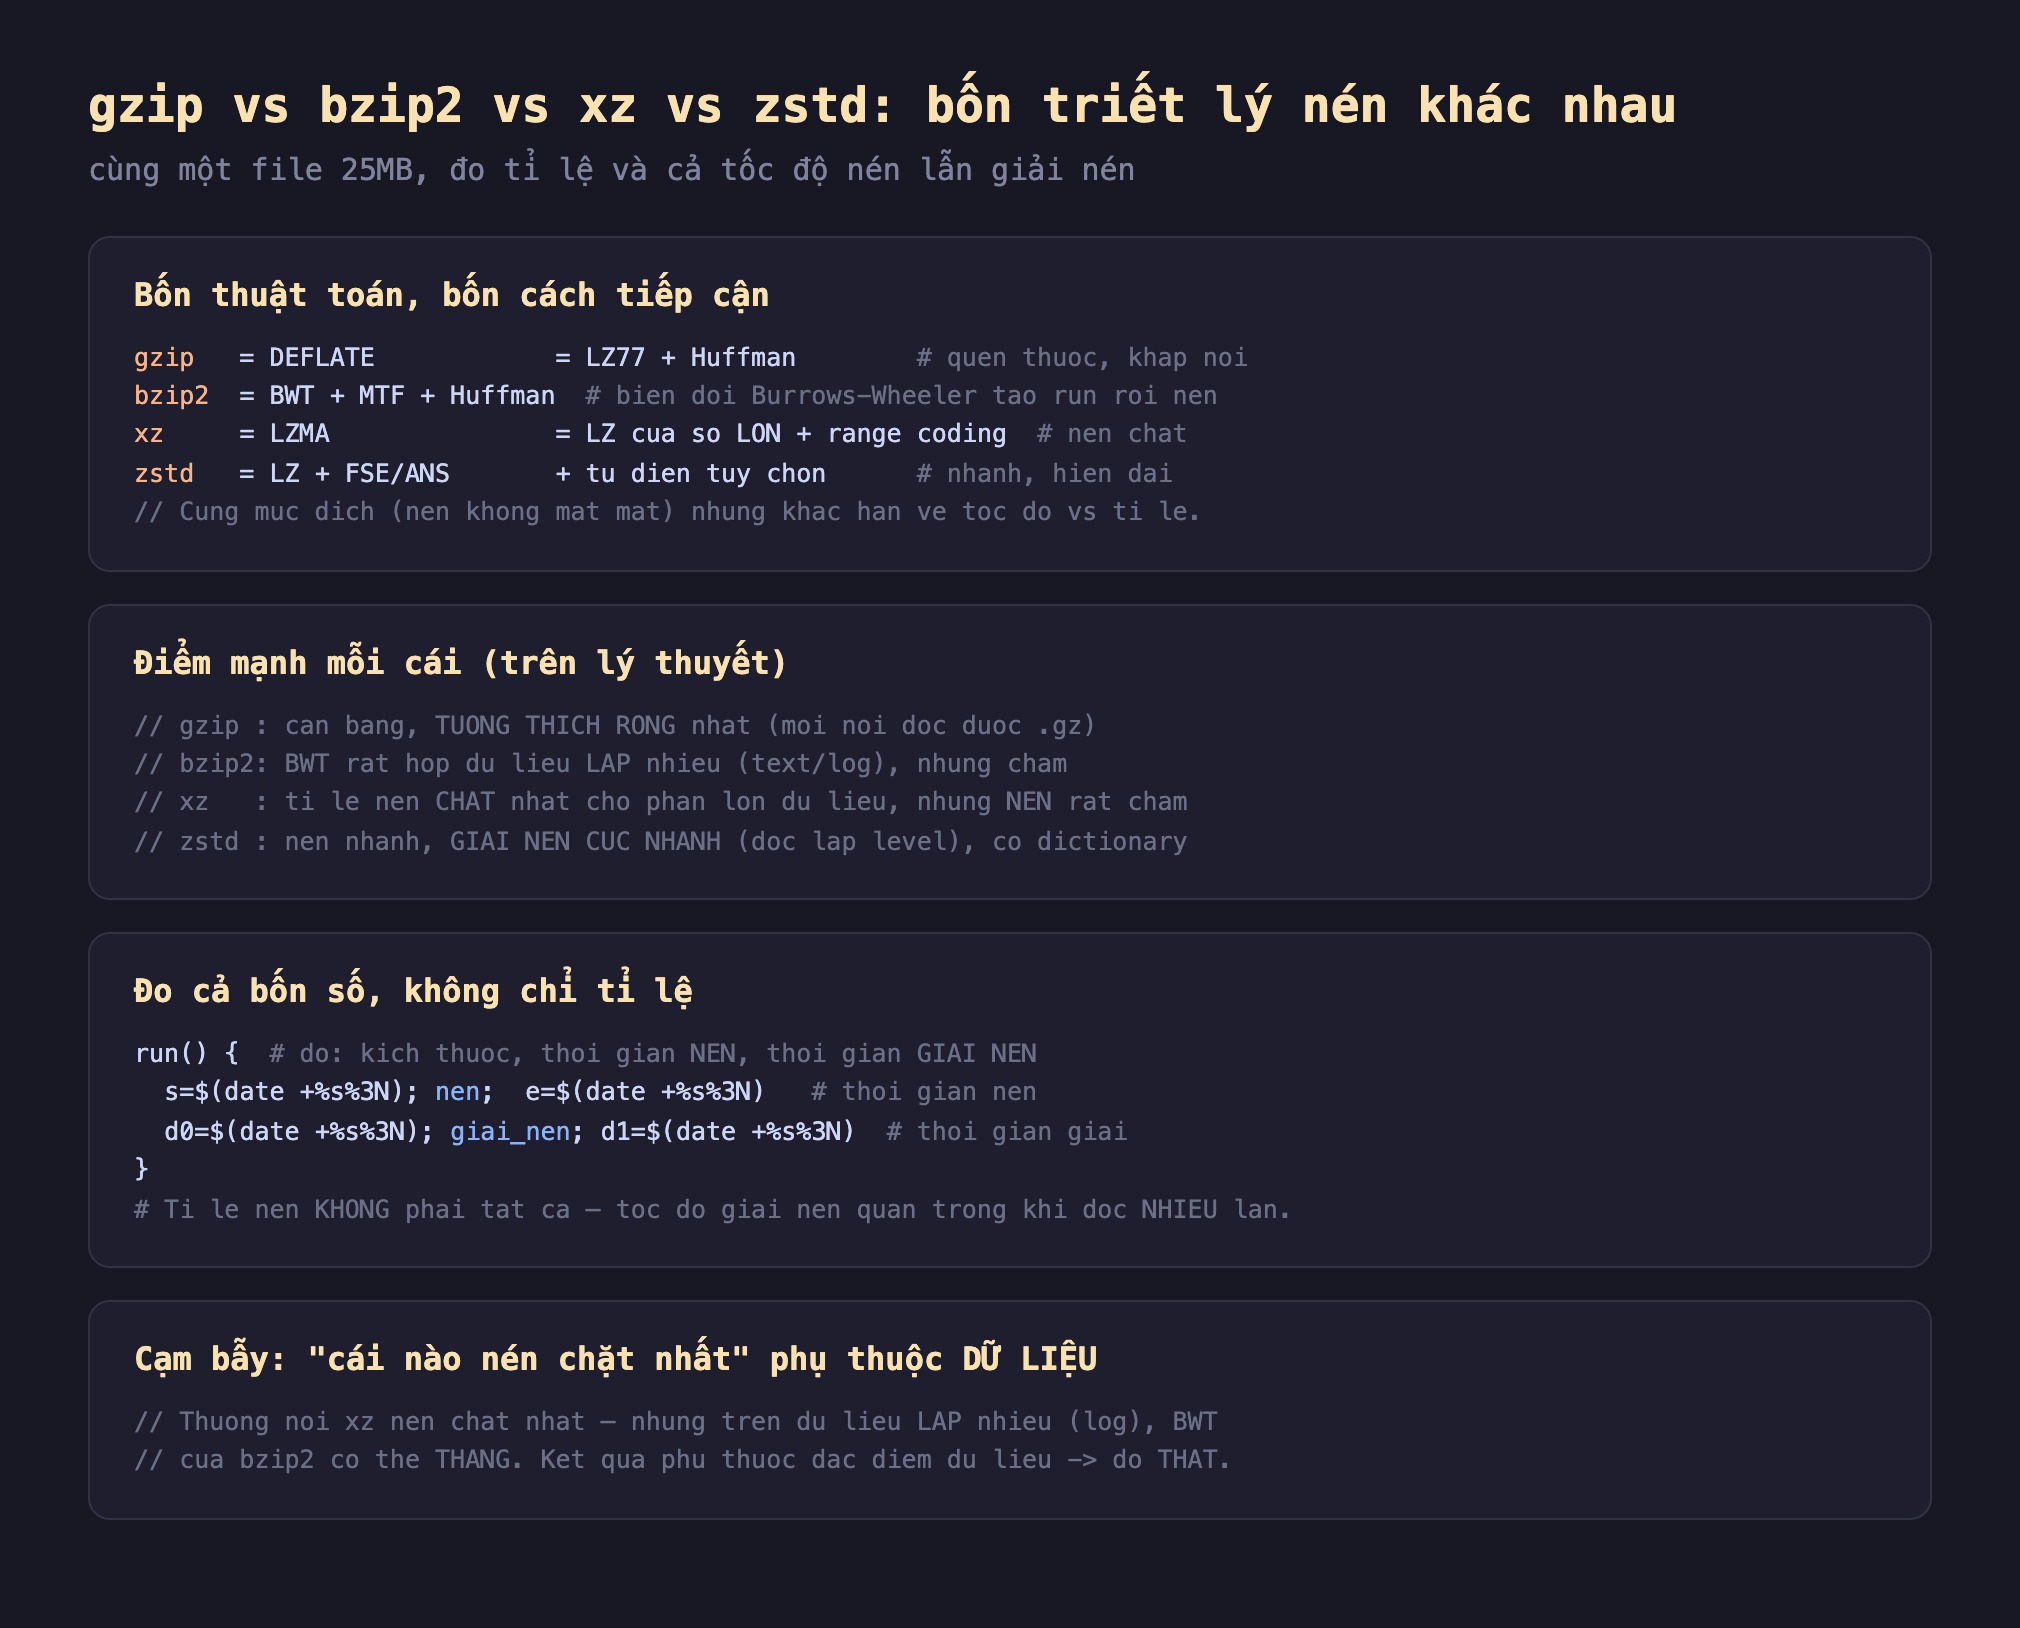
Hình 1: Bốn thuật toán, bốn lõi — gzip (DEFLATE = LZ77+Huffman), bzip2 (BWT+MTF+Huffman), xz (LZMA = LZ cửa sổ lớn + range coding), zstd (LZ + FSE/ANS + dictionary); phải đo cả bốn số (size, ratio, thời gian nén, thời gian giải nén) chứ không chỉ tỉ lệ.
Đo thật: cùng file 25MB, bốn công cụ
Mình tạo một file log 25MB (có cấu trúc như log thật), nén bằng cả bốn công cụ ở mức mặc định và mức cao, đo cả bốn số:
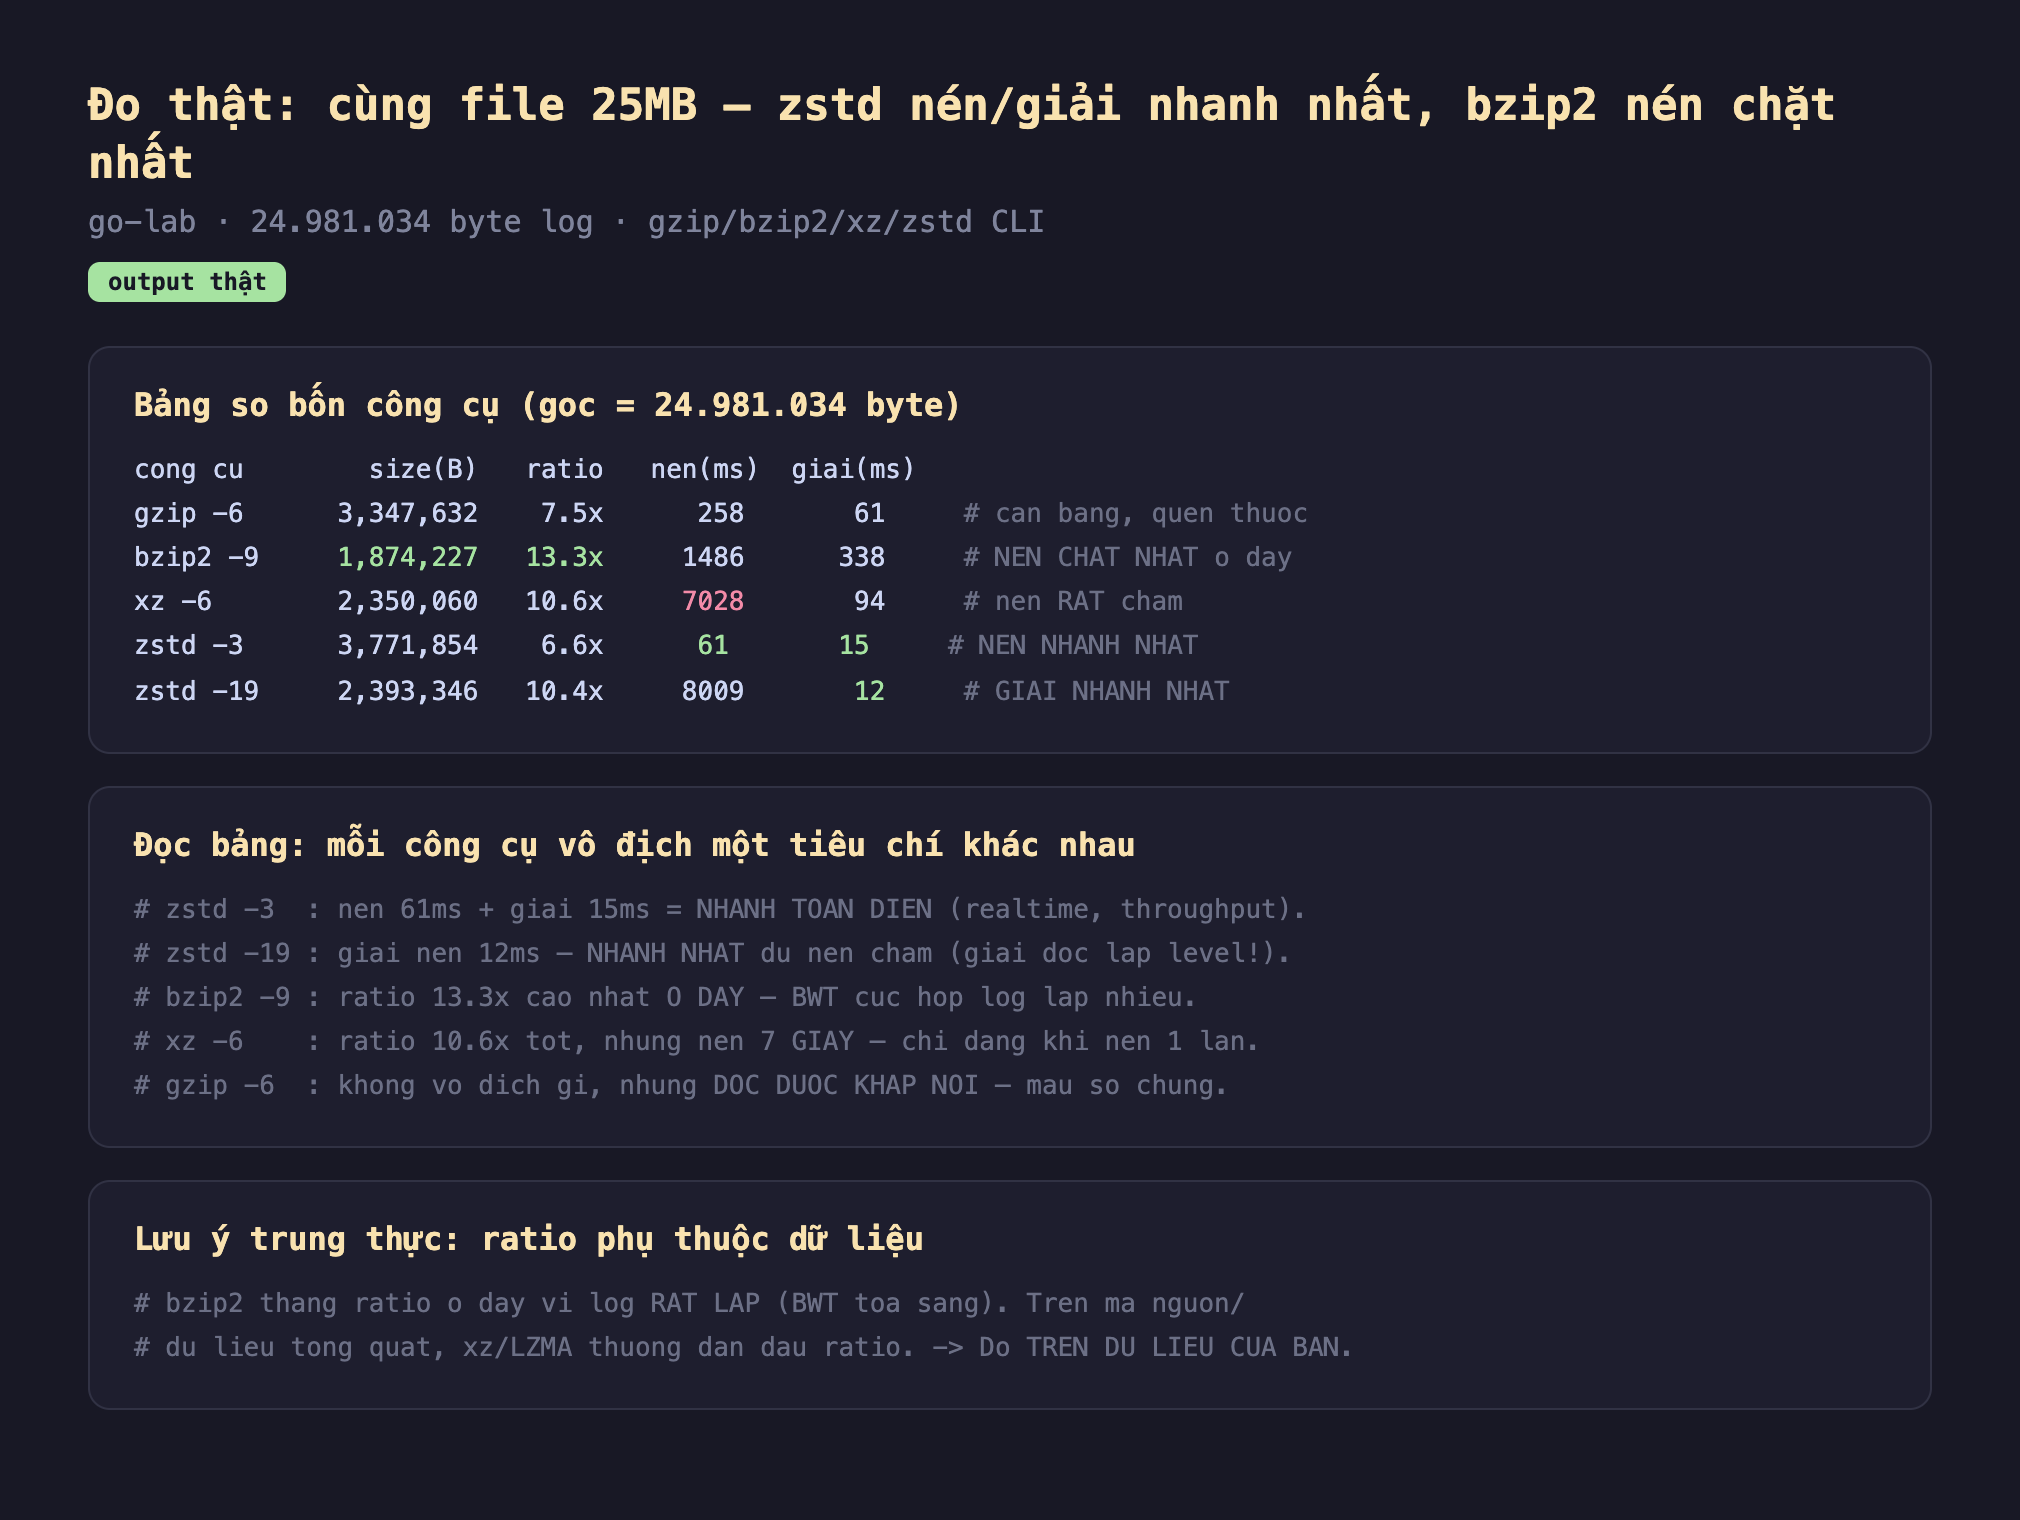
Hình 2: Chạy thật trên 24.981.034 byte log — gzip -6: 3347KB/7.5x, nén 258ms, giải 61ms; bzip2 -9: 1874KB/13.3x (chặt nhất), nén 1486ms, giải 338ms; xz -6: 2350KB/10.6x, nén 7028ms, giải 94ms; zstd -3: 3771KB/6.6x, nén 61ms, giải 15ms; zstd -19: 2393KB/10.4x, nén 8009ms, giải 12ms.
- zstd nhanh toàn diện: zstd -3 nén 25MB trong 61ms và giải nén trong 15ms — nhanh nhất cả hai chiều. Với hệ thống throughput cao (nén log đang chảy, dữ liệu qua mạng), đây là lựa chọn hiển nhiên: nó gần như "miễn phí" về CPU.
- zstd giải nén cực nhanh bất kể mức nén: điểm đặc biệt nhất của zstd. zstd -19 nén chậm (8009ms) nhưng giải nén chỉ 12ms — thậm chí nhanh hơn cả zstd -3. Tốc độ giải nén của zstd gần như độc lập với mức nén. Đây là tính chất vàng cho "nén một lần, đọc nhiều lần": dùng -19 để nén asset một lần, mọi lượt tải sau giải nén siêu nhanh.
- bzip2 nén chặt nhất — nhưng trên dữ liệu này: bzip2 -9 cho tỉ lệ 13.3x — cao nhất trong bốn công cụ ở đây. Lý do: BWT cực kỳ hợp dữ liệu lặp nhiều như log (nó sắp xếp lại để gom run). Đây là một bài học trung thực: câu "xz nén chặt nhất" không phải luôn đúng — trên log lặp nhiều, BWT của bzip2 thắng. Trên mã nguồn hay dữ liệu tổng quát, xz/LZMA thường dẫn đầu. Kết quả phụ thuộc đặc điểm dữ liệu — phải đo thật.
- xz: chặt nhưng nén chậm khủng khiếp: xz -6 cho 10.6x nhưng mất 7028ms để nén (chậm gấp ~115 lần zstd -3). Tuy nhiên nó giải nén khá nhanh (94ms). xz chỉ đáng khi bạn nén một lần và dung lượng quan trọng hơn thời gian nén (bản phát hành phần mềm, gói cài đặt — đó là lý do nhiều distro Linux dùng
.tar.xz). - gzip: không vô địch gì, nhưng là mẫu số chung: gzip không thắng tiêu chí nào, nhưng nó đọc được ở khắp mọi nơi — mọi ngôn ngữ, mọi công cụ, mọi trình duyệt hiểu gzip. Khi tính tương thích quan trọng hơn hiệu năng (HTTP
Content-Encoding, trao đổi dữ liệu công khai), gzip vẫn là lựa chọn an toàn.
Đánh đổi cần cân nhắc
Không có "cái tốt nhất" — chỉ có "tốt nhất cho ràng buộc của bạn". Bốn số (tỉ lệ, thời gian nén, thời gian giải nén, tính tương thích) tạo một không gian đánh đổi, và mỗi tình huống ưu tiên khác nhau. Quy tắc thực dụng: throughput/realtime → zstd (mức thấp); nén một lần đọc nhiều lần, cần nhỏ → zstd -19 (giải nhanh) hoặc xz (nếu cần nhỏ tối đa và có công cụ); dữ liệu lặp cực nhiều → thử bzip2; cần ai cũng đọc được → gzip.
zstd đang thay thế cả ba trong nhiều hệ thống — vì đường cong đánh đổi tốt hơn. Điều mà bảng trên gợi ý: zstd cho cả tốc độ tốt và tỉ lệ cạnh tranh — nó "đẩy lùi biên Pareto". zstd -19 đạt tỉ lệ gần xz mà giải nén nhanh hơn nhiều. Đó là lý do Linux kernel, Facebook, nhiều database và filesystem (btrfs, ZFS) chuyển sang zstd. Nếu bạn được tự do chọn và không cần tương thích gzip, zstd thường là mặc định tốt nhất năm nay.
Đo trên dữ liệu của bạn — bài này đã chứng minh vì sao. Kết quả "bzip2 thắng ratio" ở đây trái với trực giác thông thường, chỉ vì log rất lặp. Dữ liệu của bạn (JSON, ảnh đã nén, nhị phân, text tiếng Việt) sẽ cho bảng khác. Đừng chép kết luận của người khác — chạy time bốn công cụ trên mẫu thật (vài phút) rồi quyết. Đây là cùng nguyên tắc "đo trước khi tối ưu" xuyên suốt.
Ba ý mang về
- Bốn thuật toán, bốn triết lý: đo thật trên 25MB log — gzip (DEFLATE, tương thích rộng), bzip2 (BWT, chặt nhất ở đây 13.3x nhờ dữ liệu lặp), xz (LZMA, nén chậm 7 giây), zstd (LZ+ANS, nhanh toàn diện).
- zstd giải nén cực nhanh bất kể mức nén: đo thật zstd -19 nén chậm (8s) nhưng giải nén chỉ 12ms — nhanh hơn cả zstd -3; tính chất vàng cho "nén một lần đọc nhiều lần", lý do zstd đang thay thế cả ba trong nhiều hệ thống.
- "Cái nào tốt nhất" phụ thuộc ràng buộc VÀ dữ liệu: đo thật bzip2 thắng ratio trên log lặp (trái trực giác "xz chặt nhất"); chọn theo throughput/kích thước/tương thích, và luôn đo bốn số trên dữ liệu thật của bạn.
Nguồn
- Facebook — zstd benchmarks: https://github.com/facebook/zstd#benchmarks
- Wikipedia — bzip2 (BWT): https://en.wikipedia.org/wiki/Bzip2
- xz / LZMA — The .xz File Format: https://tukaani.org/xz/
Phần sau ta khai thác một tính năng riêng của zstd cứu vãn trường hợp khó nhất: nén dữ liệu nhỏ bằng từ điển (dictionary) — vì sao nén nghìn bản ghi JSON nhỏ riêng lẻ lại tệ, và dictionary sửa nó thế nào, đo thật.
