Gần như mọi ứng dụng backend dùng Kafka đều gặp bài toán này: khi tạo một đơn hàng, bạn cần vừa ghi đơn vào database vừa gửi một sự kiện order_created lên Kafka để các dịch vụ khác (gửi email, tính kho, phân tích) phản ứng. Phản xạ đầu tiên là làm hai việc liên tiếp: INSERT vào DB, rồi gọi kafka.send(). Nhưng đây là một trong những cái bẫy phổ biến nhất của kiến trúc event-driven — vì DB và Kafka là hai hệ thống khác nhau, không có transaction chung. Giữa hai lời gọi luôn có một khe hở, và khi crash rơi đúng vào đó, hệ thống lệch nhau: DB có đơn mà Kafka không có sự kiện, hoặc ngược lại. Outbox pattern giải quyết triệt để. Bài này (phần 11/12) đo thật nó trong pg-lab.
Dual-write: vì sao ghi thẳng cả hai luôn có khe hở
"Dual write" là cách ngây thơ: ghi vào hai hệ thống trong hai thao tác tách rời.
tx.begin(); INSERT order; tx.commit();   // 1) ghi DB thành công
kafka.send(order_event);                 // 2) CRASH ở đây -> DB có order, Kafka KHÔNG có event
Vấn đề cốt lõi: không có transaction nào bao được cả hai. DB có transaction của nó, Kafka có cơ chế của nó, nhưng không có "distributed transaction" chung (và nếu có — two-phase commit — thì chậm và giòn). Nên luôn tồn tại một thời điểm mà một hệ thống đã ghi còn hệ thống kia chưa. Crash, mất mạng, hay restart rơi vào đúng khe đó là dữ liệu lệch — một sự kiện bị mất (consumer không bao giờ biết đơn được tạo) hoặc thừa (gửi sự kiện rồi DB rollback).
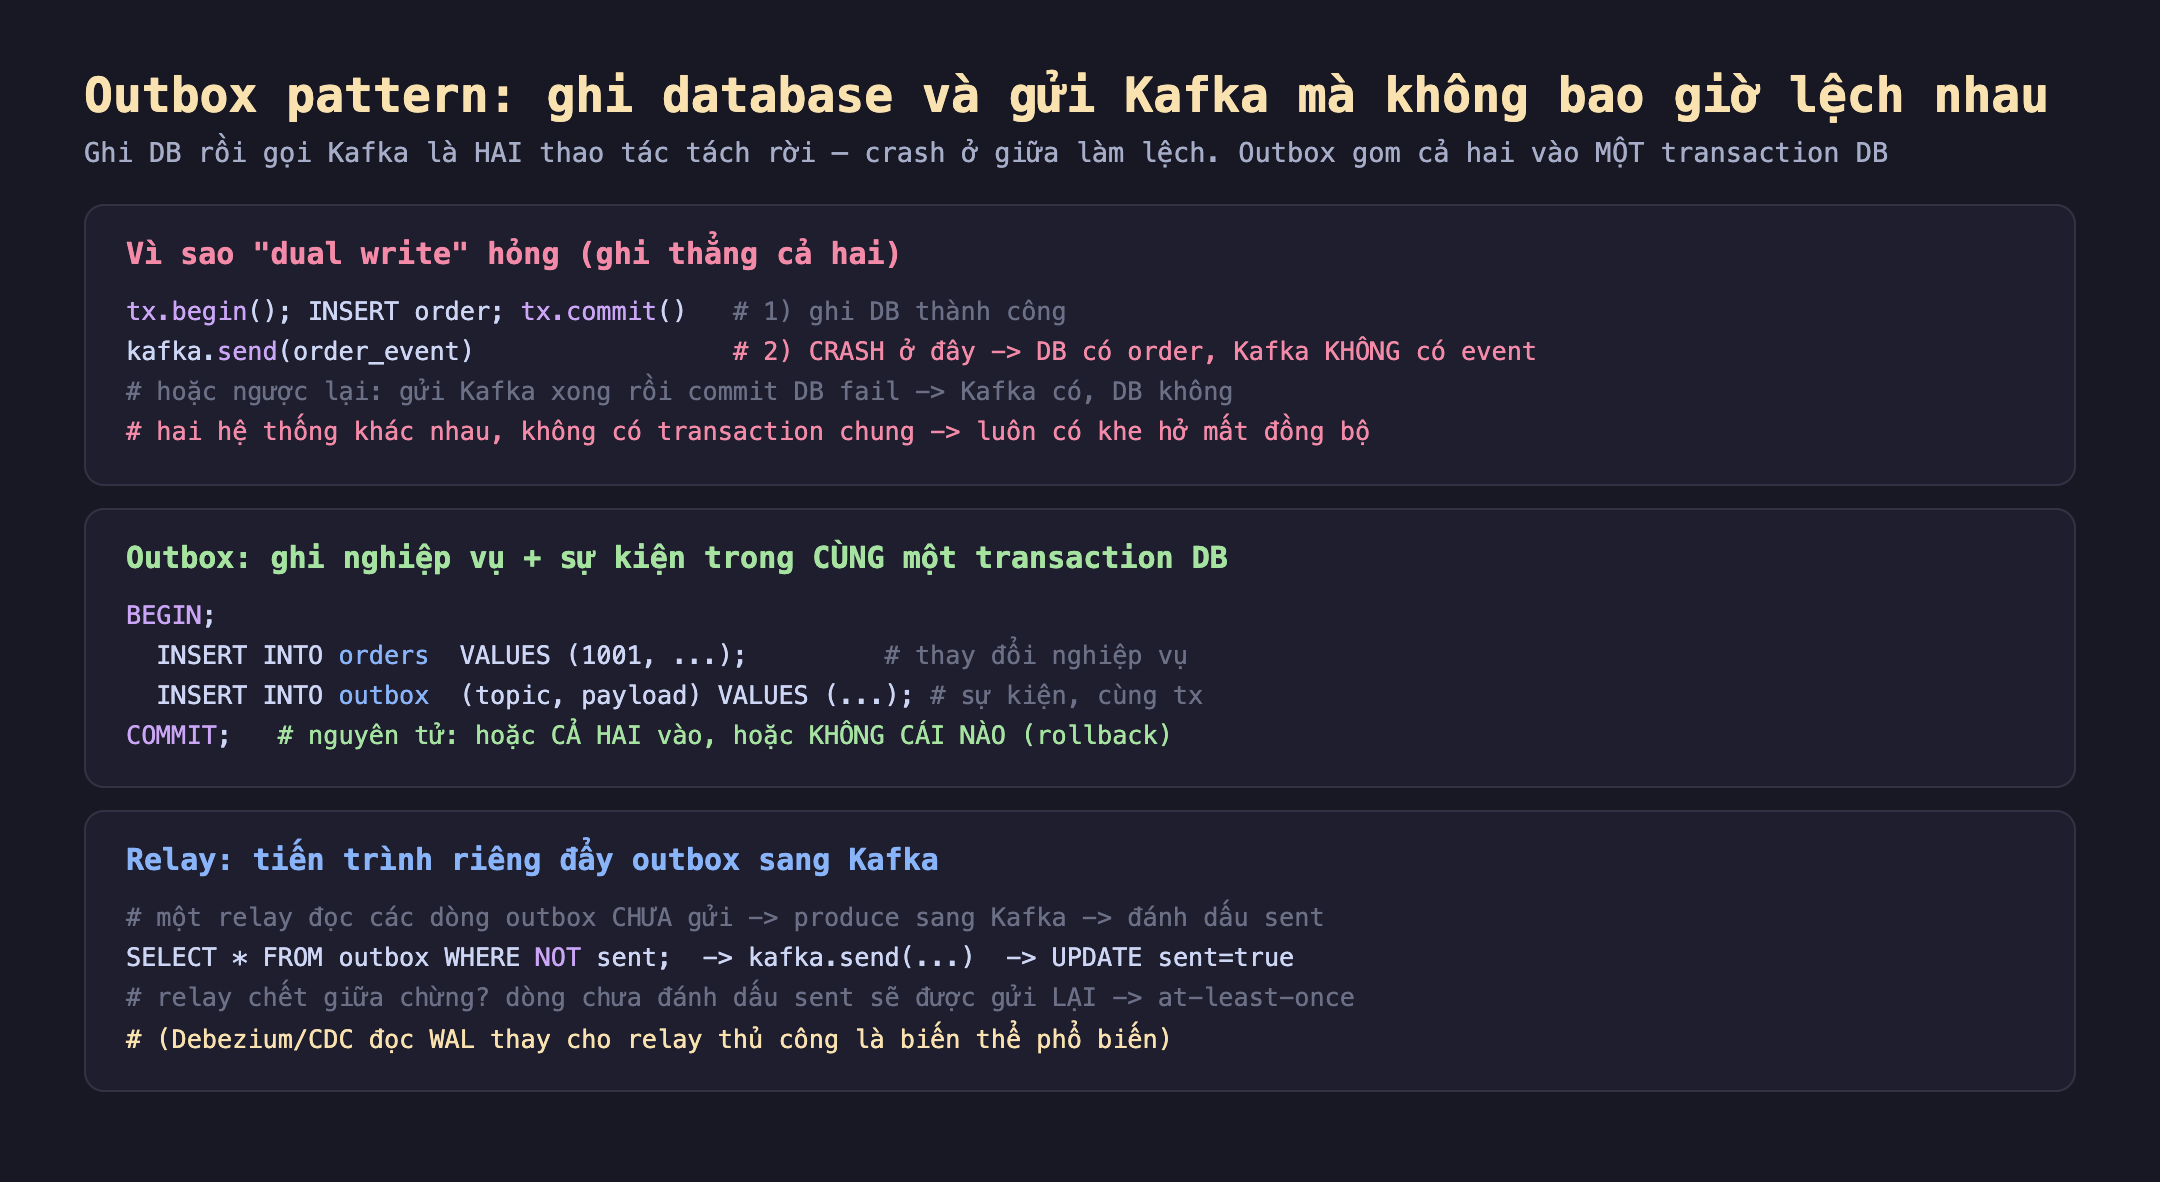
Hình 1: Dual-write ghi DB và Kafka tách rời — crash ở giữa làm hai hệ thống lệch nhau. Outbox gom thay đổi nghiệp vụ và sự kiện vào một transaction DB (nguyên tử), rồi một relay riêng đọc outbox đẩy sang Kafka.
Outbox: một transaction cho cả hai
Ý tưởng của outbox đơn giản mà tinh tế: đừng gọi Kafka trong luồng xử lý. Thay vào đó, ghi sự kiện vào một bảng outbox trong chính database, trong cùng transaction với thay đổi nghiệp vụ. Vì cả hai INSERT nằm trong một transaction DB, chúng nguyên tử: hoặc cả hai được commit, hoặc cả hai bị rollback. Không còn khe hở.
Rồi một tiến trình relay riêng đọc các dòng outbox chưa gửi, đẩy chúng sang Kafka, và đánh dấu đã gửi. Tôi dựng demo trong pg-lab với bảng orders (nghiệp vụ) và outbox (sự kiện):
BEGIN;
  INSERT INTO orders VALUES (1001, 'nguyen-van-a', 250000);        -- thay đổi nghiệp vụ
  INSERT INTO outbox (topic, payload) VALUES ('order-events', ...); -- sự kiện, cùng tx
COMMIT;   -- nguyên tử: cả hai vào, hoặc rollback thì không cái nào
Đo thật: tính nguyên tử và relay
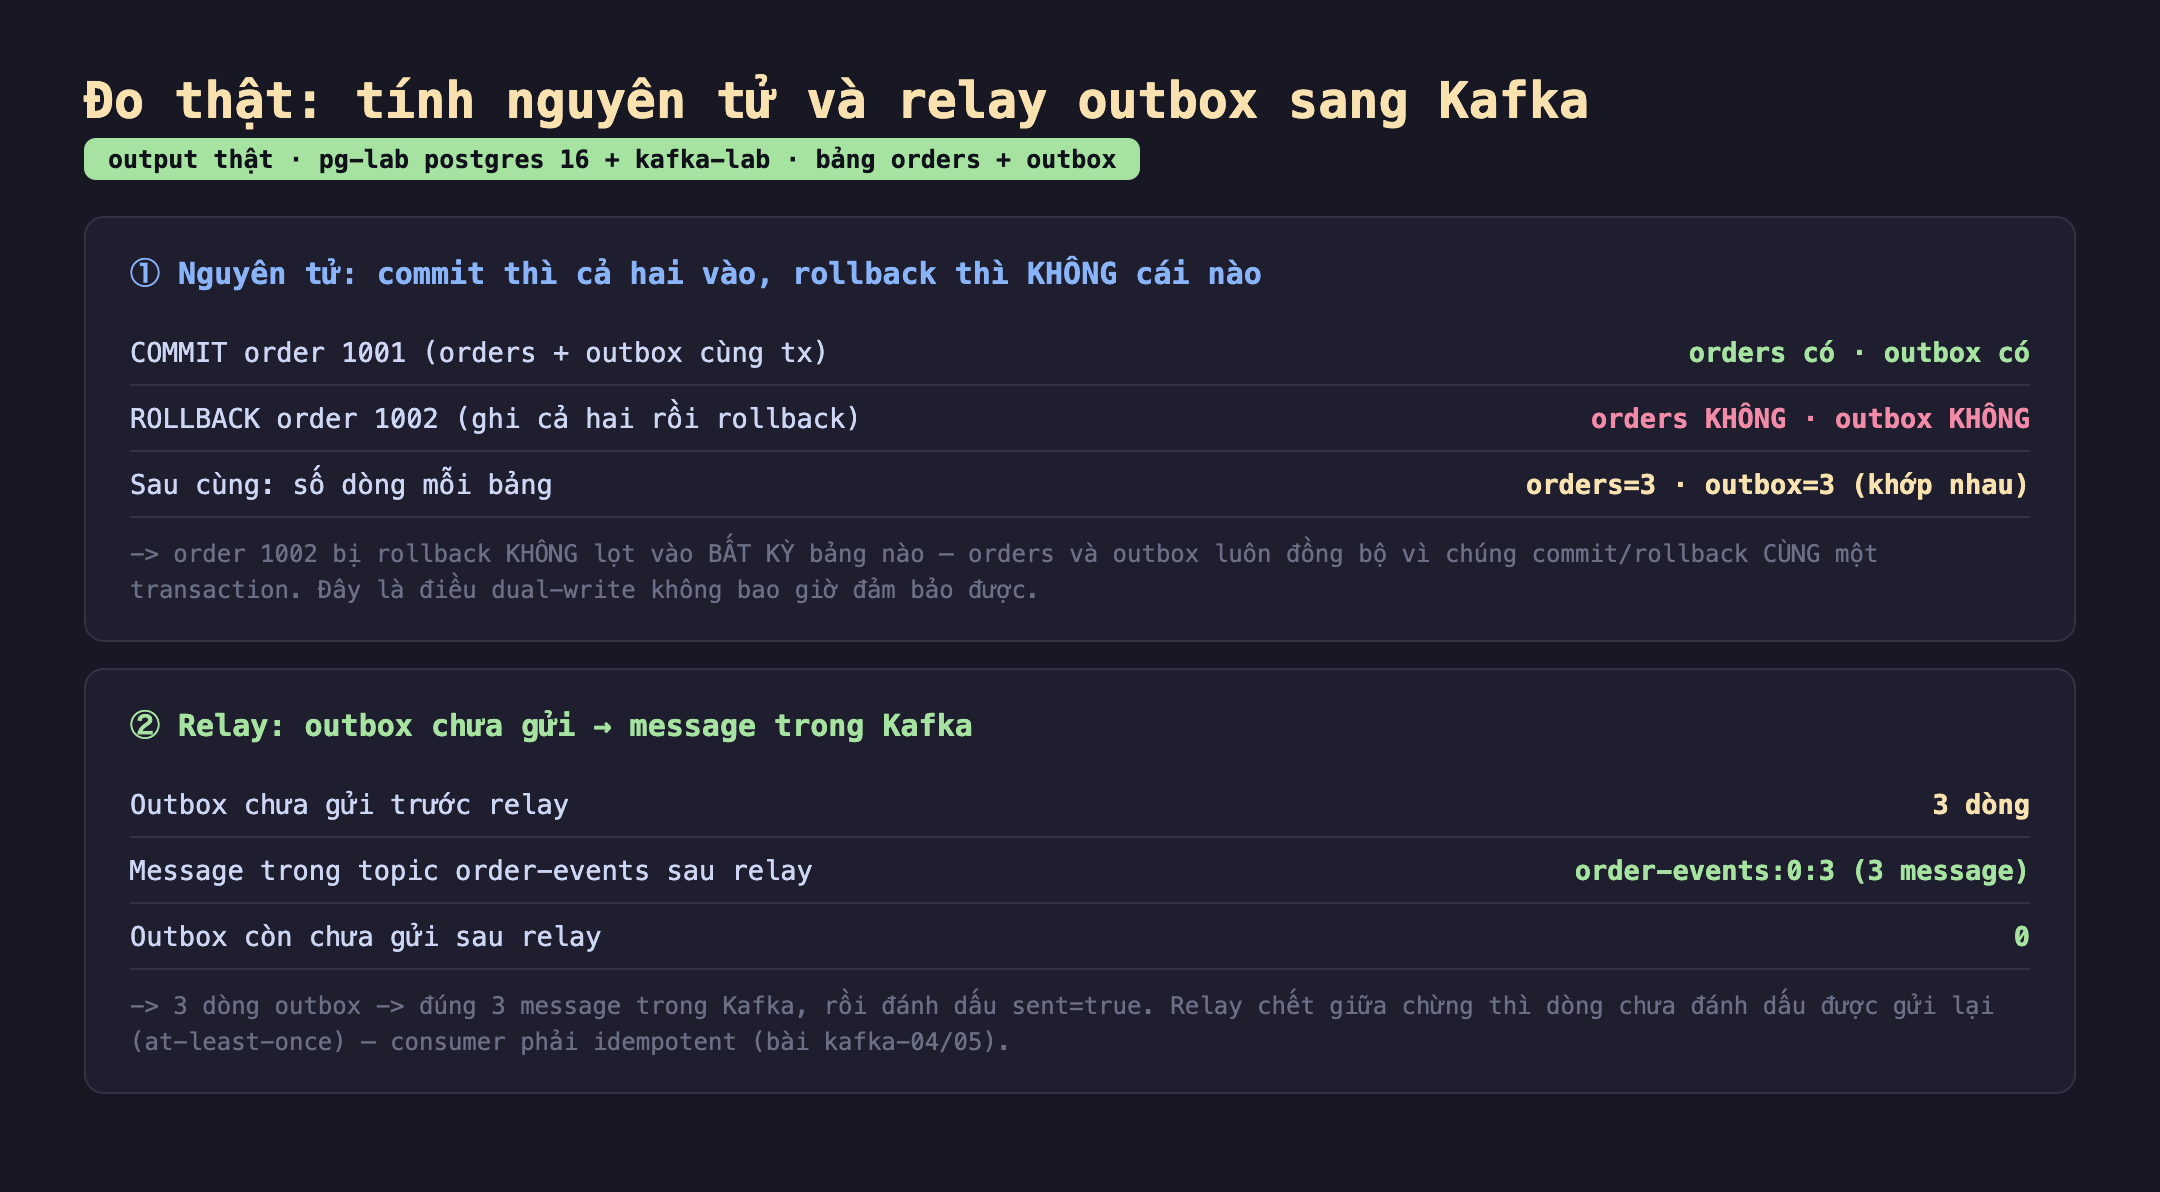
Hình 2: Đo thật. Trên — commit order 1001: cả orders lẫn outbox đều có; rollback order 1002: không bảng nào có; cuối cùng orders=3, outbox=3 (khớp). Dưới — relay đẩy 3 dòng outbox chưa gửi thành đúng 3 message trong Kafka, outbox còn 0 chưa gửi.
Kết quả thật chứng minh từng tính chất:
- Nguyên tử khi commit:
COMMITorder 1001 → cảordersvàoutboxđều có dòng tương ứng. - Nguyên tử khi rollback: ghi order 1002 vào cả hai bảng rồi
ROLLBACK→ không bảng nào có order 1002. Đây là điểm mấu chốt: order 1002 không lọt vào bất kỳ bảng nào, nên không bao giờ có chuyện "DB có đơn mà sự kiện lệch". Cuối cùngorders=3, outbox=3— luôn khớp. - Relay chuyển đúng số lượng: 3 dòng outbox chưa gửi → relay produce → đúng 3 message trong topic
order-events(order-events:0:3), rồiUPDATE sent=true→ outbox còn 0 chưa gửi.
So với dual-write: outbox đảm bảo orders và outbox đồng bộ (chúng commit/rollback cùng một transaction DB), còn việc đẩy sang Kafka tách thành một bước riêng có thể thử lại được. Nếu relay chết giữa chừng, dòng chưa kịp sent=true sẽ được gửi lại ở lần chạy sau — at-least-once (nối thẳng bài kafka-04/05), nên consumer phải idempotent. Nhưng không bao giờ mất sự kiện, vì nó đã nằm an toàn trong DB cùng với dữ liệu nghiệp vụ.
Đánh đổi cần cân nhắc
Relay thủ công vs CDC (Debezium). Demo này dùng relay kiểu polling — một tiến trình SELECT ... WHERE NOT sent định kỳ. Đơn giản nhưng có độ trễ (bằng chu kỳ poll) và tải truy vấn lên DB. Biến thể production phổ biến là Change Data Capture: Debezium đọc thẳng WAL (write-ahead log) của PostgreSQL, phát hiện dòng outbox mới gần như tức thời, đẩy sang Kafka — không poll, độ trễ thấp. Đổi lại phức tạp hơn (thêm Debezium connector, Kafka Connect). Chọn polling cho hệ nhỏ, CDC cho quy mô lớn.
Outbox tăng tải ghi và cần dọn. Mỗi thao tác nghiệp vụ giờ ghi thêm một dòng outbox — tăng tải ghi DB, và bảng outbox phình nếu không dọn. Cần một job xoá các dòng đã sent cũ (hoặc dùng DELETE ... RETURNING trong relay). Với throughput rất cao, bảng outbox tự nó thành điểm nghẽn — lúc đó CDC trực tiếp trên bảng nghiệp vụ (không cần bảng outbox) có thể hợp hơn.
Outbox cho at-least-once, không exactly-once. Outbox đảm bảo không mất sự kiện và DB-sự kiện đồng bộ, nhưng relay vẫn có thể gửi trùng (gửi xong, chết trước khi kịp đánh dấu sent). Đây là at-least-once — đúng như kỳ vọng trong hệ phân tán. Exactly-once end-to-end cần thêm consumer idempotent hoặc transaction Kafka. Outbox giải bài toán đồng bộ hai hệ thống, không xoá bỏ nhu cầu xử lý trùng ở phía consumer.
Ba ý mang về
- Dual-write luôn có khe hở mất đồng bộ. Ghi DB rồi gọi Kafka là hai thao tác trên hai hệ thống không có transaction chung — crash ở giữa làm DB và Kafka lệch nhau. Không có cách sắp xếp thứ tự nào xoá được khe hở này.
- Outbox gom nghiệp vụ + sự kiện vào một transaction DB. Đo thật: commit thì cả
orderslẫnoutboxđều có; rollback order 1002 thì không bảng nào có; cuối cùng orders=3 khớp outbox=3. Hai bảng luôn đồng bộ vì cùng commit/rollback. - Relay đẩy outbox sang Kafka là bước riêng, thử lại được. Đo thật: 3 dòng outbox → đúng 3 message Kafka, rồi đánh dấu sent. Relay chết thì gửi lại (at-least-once → consumer idempotent). Production thường dùng Debezium/CDC thay polling để giảm độ trễ.
Nguồn
- Chris Richardson — Pattern: Transactional outbox: https://microservices.io/patterns/data/transactional-outbox.html
- Debezium — Reliable Microservices Data Exchange With the Outbox Pattern: https://debezium.io/blog/2019/02/19/reliable-microservices-data-exchange-with-the-outbox-pattern/
- Confluent — Kafka Connect & Change Data Capture: https://developer.confluent.io/courses/kafka-connect/change-data-capture/
Phần sau là bài tổng kết sê-ri: khi nào nên dùng Kafka và khi nào không, so sánh với RabbitMQ và hàng đợi trên database, cùng một checklist vận hành đúc kết từ 11 bài đã đo.
