Kafka không quan tâm nội dung message — với nó, mỗi message chỉ là một mảng byte. Nghĩa là bạn chọn cách mã hoá (serialize) dữ liệu, và lựa chọn đó ảnh hưởng ba thứ lớn: băng thông mạng, dung lượng đĩa, và — quan trọng nhất về lâu dài — khả năng nâng cấp hệ thống mà không làm vỡ các consumer đang chạy. Đa số bắt đầu với JSON vì tiện, rồi trả giá khi dữ liệu lớn và khi một thay đổi tưởng vô hại ở producer làm sập consumer của team khác. Bài này (phần 10/12) đo thật kích thước các định dạng và chứng minh schema evolution — cách thêm/sửa trường an toàn.
JSON tiện nhưng cồng kềnh; Avro gọn nhờ tách schema
JSON tự mô tả: mỗi message chứa cả tên trường lẫn giá trị. Tiện khi debug (đọc được bằng mắt), nhưng tốn kém — "id", "customer", "amount"... lặp lại trong từng bản ghi. Một triệu message là một triệu lần lặp tên trường.
Avro đi hướng khác: schema (mô tả cấu trúc) được lưu riêng (một lần, hoặc trong Schema Registry), còn message chỉ mã hoá giá trị theo thứ tự trường. Không lặp tên → gọn hơn nhiều, đổi lại không đọc được bằng mắt nếu không có schema.
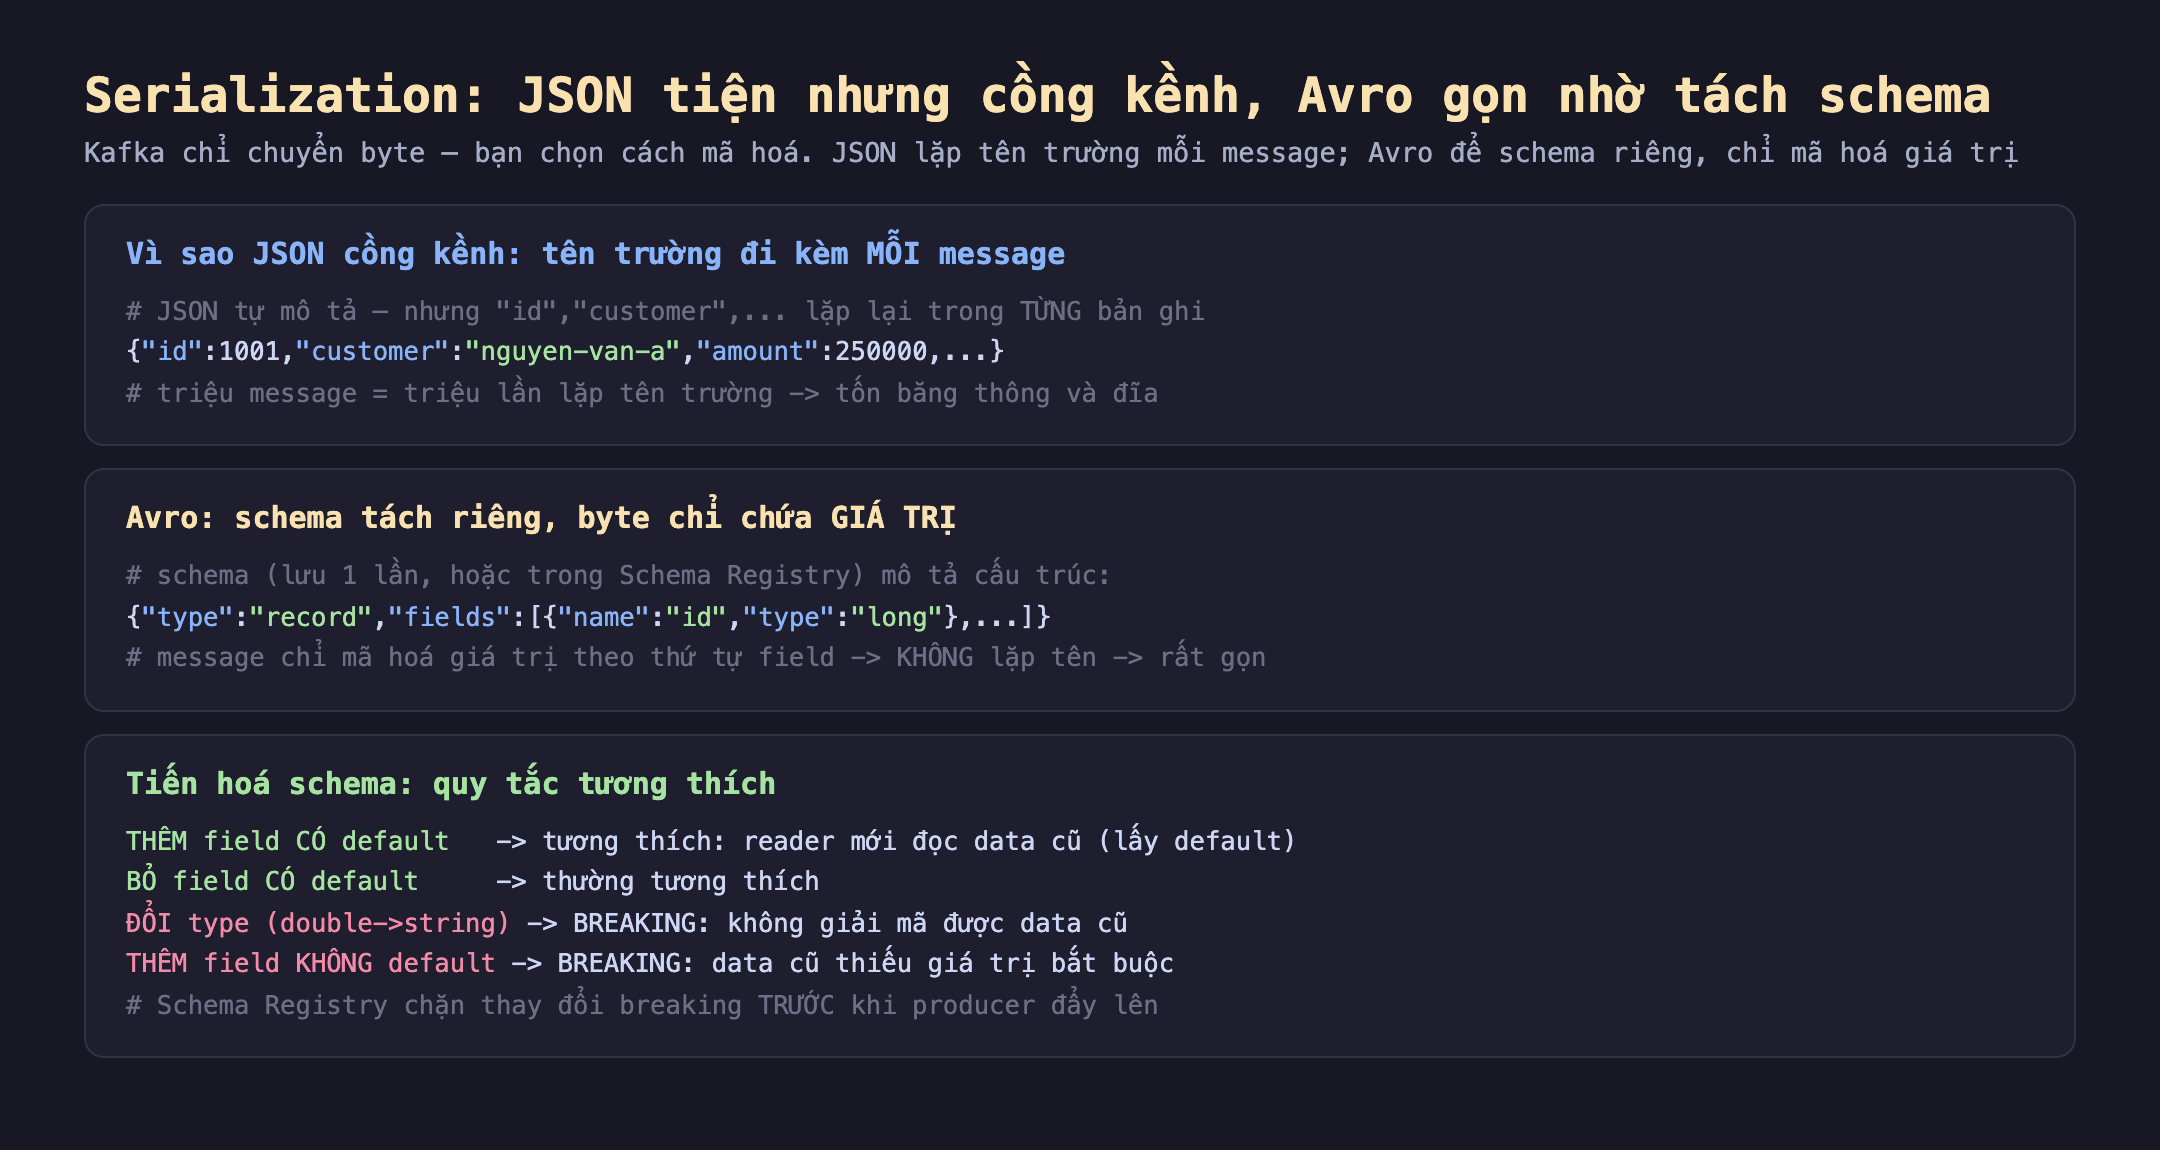
Hình 1: JSON lặp tên trường trong mỗi message (tự mô tả nhưng cồng kềnh); Avro để schema riêng, message chỉ chứa giá trị (gọn). Quy tắc tiến hoá: thêm field có default là tương thích, đổi kiểu là breaking.
Đo thật: kích thước mã hoá
Mình serialize cùng một struct Order (5 trường) ra ba định dạng trong go-lab và đếm byte:
o := Order{ID: 1001, Customer: "nguyen-van-a", Amount: 250000, Status: "PENDING", Region: "ASIA"}
js, _  := json.Marshal(o)              // JSON
gob.NewEncoder(&buf).Encode(o)         // gob (binary stdlib Go)
av, _  := avro.Marshal(schema, o)      // Avro (hamba/avro)
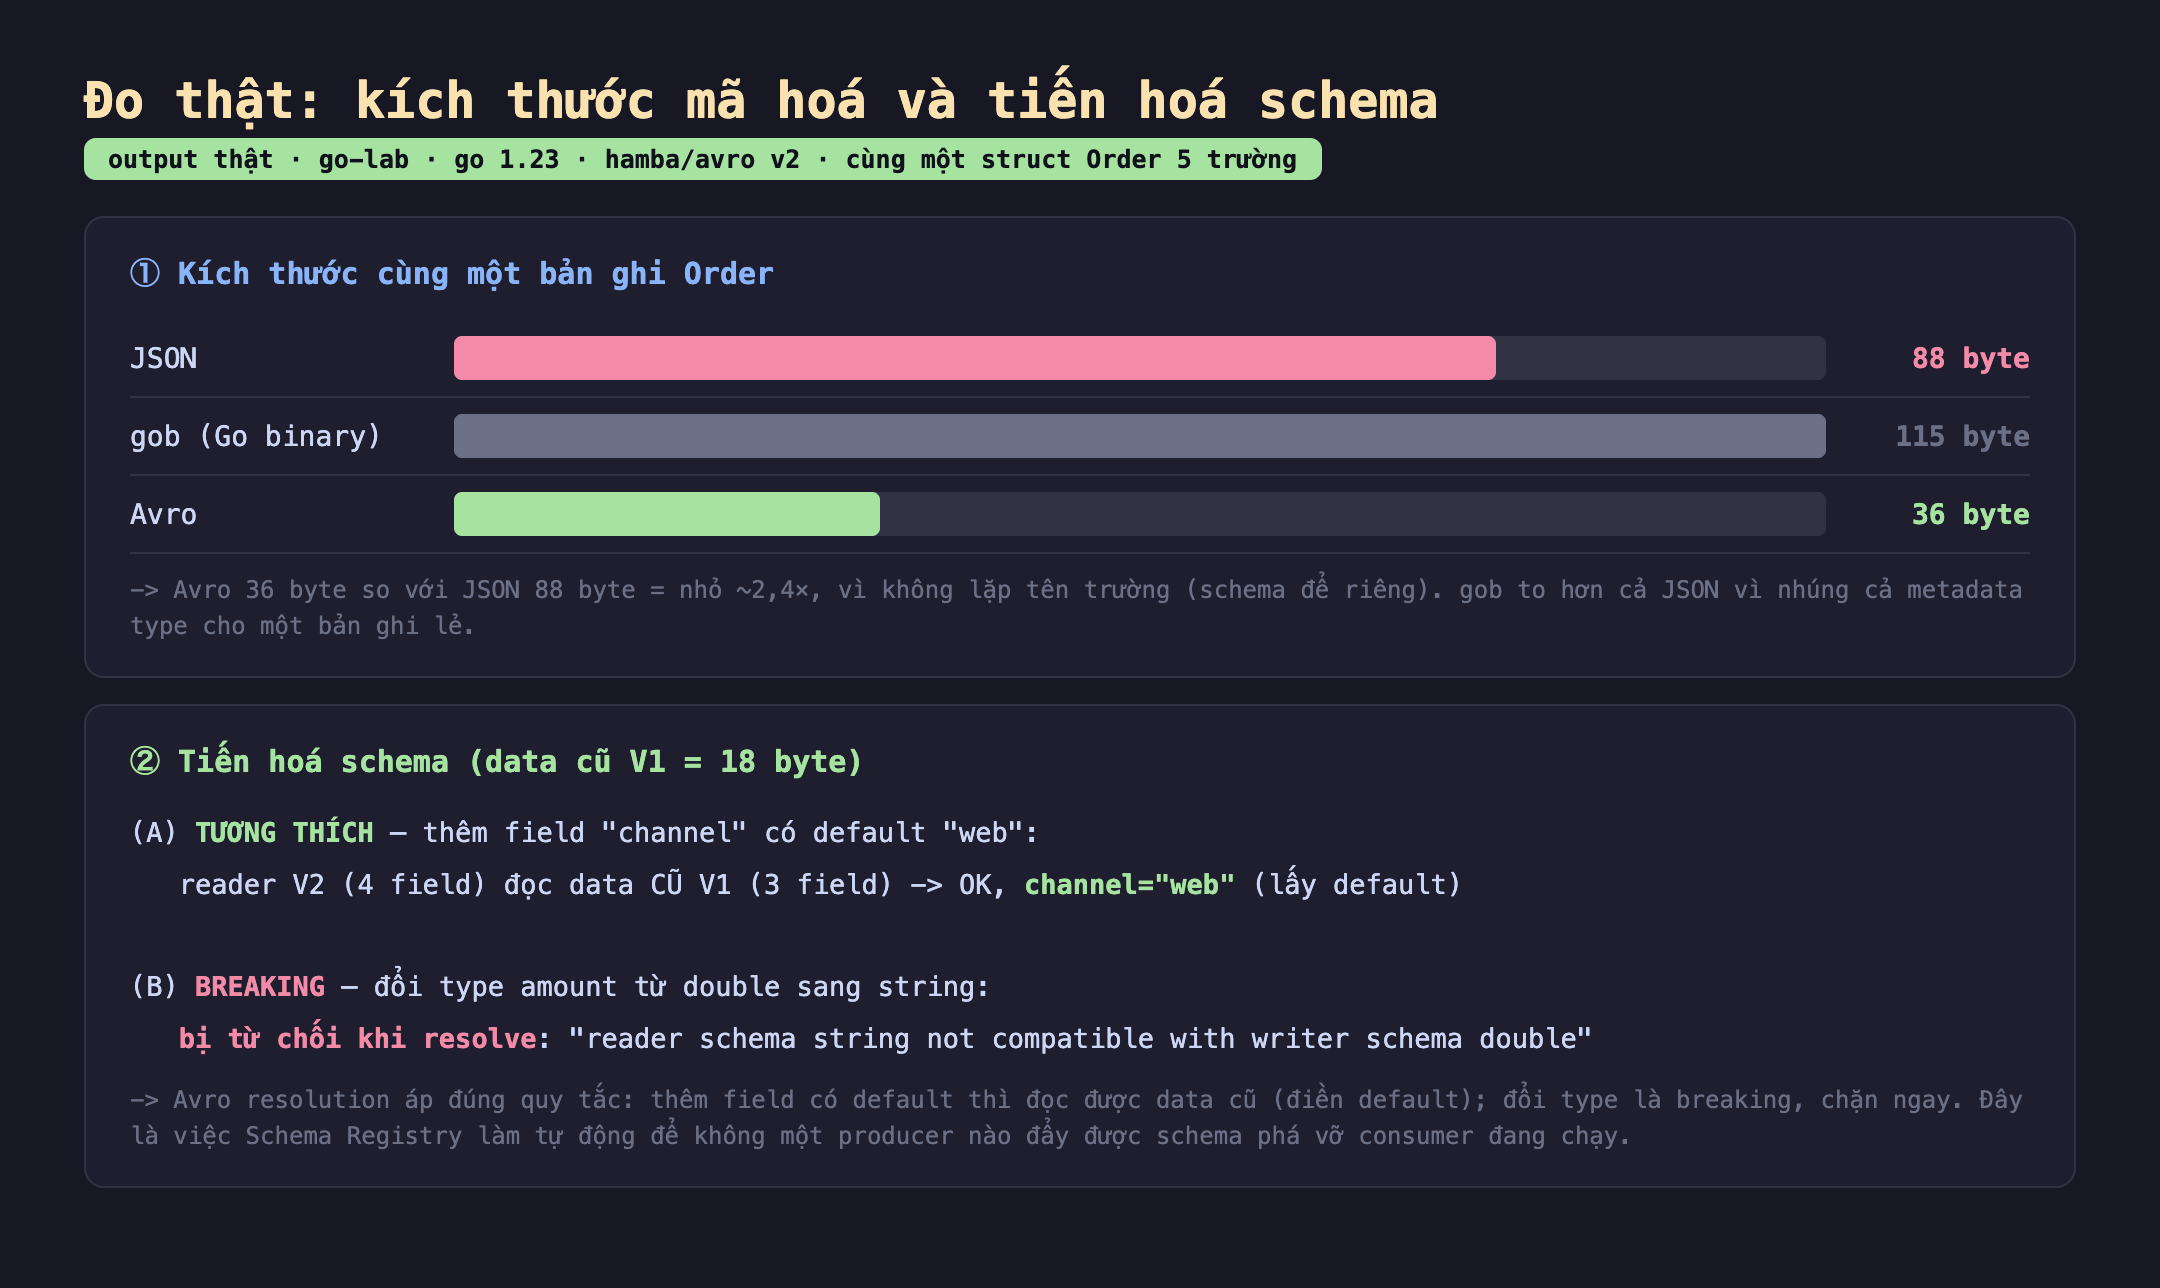
Hình 2: Đo thật trong go-lab. Cùng bản ghi Order: JSON 88 byte, gob 115 byte, Avro chỉ 36 byte (~2,4× nhỏ hơn JSON). Tiến hoá: thêm field "channel" có default đọc được data cũ (channel="web"); đổi kiểu double→string bị từ chối với lỗi không tương thích.
Kết quả thật:
- JSON: 88 byte — chứa cả tên trường (
{"id":1001,"customer":"nguyen-van-a",...}). - gob: 115 byte — binary của Go nhưng to hơn cả JSON ở đây, vì gob nhúng cả metadata kiểu cho một bản ghi lẻ (gob tối ưu cho luồng nhiều bản ghi cùng kiểu, không cho một bản đơn).
- Avro: 36 byte — nhỏ hơn JSON ~2,4 lần, vì không lặp tên trường, chỉ mã hoá giá trị theo schema tách riêng.
Trên một topic chạy hàng tỉ message, chênh lệch 2,4× này là tiền thật: băng thông, đĩa (nhân với replication factor ở bài kafka-09), và cả throughput. Đây là lý do các hệ thống lớn thường dùng Avro/Protobuf thay JSON cho dữ liệu khối lượng cao.
Đo thật: schema evolution — nâng cấp không làm vỡ consumer
Đây mới là lý do thật để dùng Avro, hơn cả kích thước. Trong hệ thống nhiều team, producer và consumer không nâng cấp cùng lúc. Một producer thêm trường mới trong khi consumer cũ vẫn chạy — hoặc ngược lại. Avro có schema resolution: đọc dữ liệu viết bằng schema này bằng một schema khác, theo quy tắc tương thích rõ ràng. Mình kiểm chứng với dữ liệu cũ V1 (3 trường, 18 byte):
- (A) Tương thích — thêm field có default. Thêm trường
channelvớidefault:"web"vào schema reader (V2, 4 trường). Đọc dữ liệu cũ V1 (3 trường) bằng reader V2: thành công,channel="web"(lấy giá trị default). Consumer mới nâng cấp trước vẫn đọc được dữ liệu producer cũ chưa gửi trường mới. - (B) Breaking — đổi kiểu. Đổi
amounttừdoublesangstring. Avro từ chối ngay khi resolve schema:reader schema string not compatible with writer schema double. Thay đổi này sẽ làm vỡ việc giải mã dữ liệu cũ, nên bị chặn.
Avro áp đúng quy tắc tương thích một cách tự động và kiểm được. Đây chính là việc Schema Registry làm trong production: trước khi một producer được phép đẩy schema mới lên, registry kiểm tra tương thích với schema đang dùng — một thay đổi breaking bị từ chối ngay tại chỗ, trước khi nó kịp làm sập consumer của team khác. JSON thuần không có cơ chế này: một trường đổi kiểu âm thầm lọt qua, consumer cũ nổ lúc runtime.
Đánh đổi cần cân nhắc
JSON vẫn đúng cho nhiều trường hợp. Nếu khối lượng nhỏ, cần debug bằng mắt, hoặc consumer là các công cụ ad-hoc đa dạng, JSON tiện hơn nhiều: không cần schema registry, đọc được ngay, mọi ngôn ngữ hỗ trợ sẵn. Avro/Protobuf đáng công sức khi khối lượng lớn hoặc nhiều team dùng chung topic lâu dài — khi tiết kiệm byte và kỷ luật schema thật sự quan trọng. Đừng dựng Schema Registry cho một topic nội bộ nhỏ.
Avro cần schema đi kèm — mất schema là mất dữ liệu đọc được. Vì byte Avro không tự mô tả, bạn bắt buộc phải có schema để giải mã. Thực tế dùng Confluent Schema Registry: mỗi message mang một schema ID nhỏ ở đầu, consumer tra registry lấy schema. Mất registry hoặc mất schema cũ là mất khả năng đọc dữ liệu lịch sử — nên registry phải được sao lưu nghiêm túc như chính dữ liệu.
Tương thích có nhiều chiều — chọn đúng loại. "Backward compatible" (reader mới đọc data cũ) khác "forward compatible" (reader cũ đọc data mới) khác "full". Thêm field có default là backward-compatible; nếu bạn cần consumer cũ đọc được data mới (forward), quy tắc lại khác. Schema Registry cho đặt chế độ tương thích per-topic; chọn sai chế độ là hoặc chặn nhầm thay đổi an toàn, hoặc cho lọt thay đổi gây lỗi.
Ba ý mang về
- Avro gọn hơn JSON nhờ tách schema khỏi dữ liệu. Đo thật cùng một bản ghi: JSON 88 byte, gob 115 byte, Avro chỉ 36 byte (~2,4× nhỏ hơn JSON) vì không lặp tên trường. Trên khối lượng lớn, chênh lệch này là băng thông và đĩa thật.
- Schema evolution là lý do thật để dùng Avro. Đo thật: thêm field có default (
channel) đọc được dữ liệu cũ (lấy "web"); đổi kiểu double→string bị từ chối ngay với lỗi không tương thích. Quy tắc tương thích rõ ràng và kiểm được tự động. - Schema Registry chặn breaking change trước khi nó gây hại. Nó kiểm tương thích trước khi producer đẩy schema mới, nên không một thay đổi nào làm vỡ consumer đang chạy. Đổi lại: Avro cần schema để đọc (mất schema = mất dữ liệu đọc được), và JSON vẫn đúng cho khối lượng nhỏ cần debug bằng mắt.
Nguồn
- Apache Avro — Specification: Schema Resolution: https://avro.apache.org/docs/current/specification/#schema-resolution
- Confluent — Schema Registry & Schema Evolution: https://docs.confluent.io/platform/current/schema-registry/fundamentals/schema-evolution.html
- hamba/avro — Go Avro library: https://github.com/hamba/avro
Phần sau ta giải một bài toán tích hợp kinh điển: làm sao ghi vào database và gửi message lên Kafka mà không mất đồng bộ — outbox pattern, và vì sao "dual write" (ghi thẳng cả hai) là một cái bẫy.
