Ở bài kafka-04 ta để lại một câu hỏi treo: acks=all thực sự có nghĩa gì, khi trên single-node nó gần như acks=1? Câu trả lời nằm ở replication — cơ chế Kafka sao chép mỗi partition sang nhiều broker để không mất dữ liệu khi một máy chết. Đây là nền tảng độ bền của Kafka, và cũng là phần không thể demo đầy đủ trên một node. Bài này (phần 9/12) đo thật những gì single-node cho phép, dùng chính các giới hạn và lỗi làm bằng chứng về cơ chế — kèm một phát hiện trung thực đáng chú ý về min.insync.replicas.
Replication, leader, follower và ISR
Mỗi partition có một replication factor (RF) — số bản sao của nó. Với RF=3, partition tồn tại trên 3 broker khác nhau: một leader và hai follower. Producer và consumer chỉ nói chuyện với leader; follower âm thầm sao chép dữ liệu từ leader để luôn có bản dự phòng.
Khái niệm then chốt là ISR (in-sync replicas) — tập các bản sao đang theo kịp leader (chênh lệch trong ngưỡng cho phép). Khi leader chết, Kafka bầu một bản sao trong ISR làm leader mới — vì nó có đủ dữ liệu, không mất gì. Một follower tụt quá xa sẽ bị loại khỏi ISR và không được bầu làm leader (nếu không sẽ mất dữ liệu nó chưa kịp sao chép).
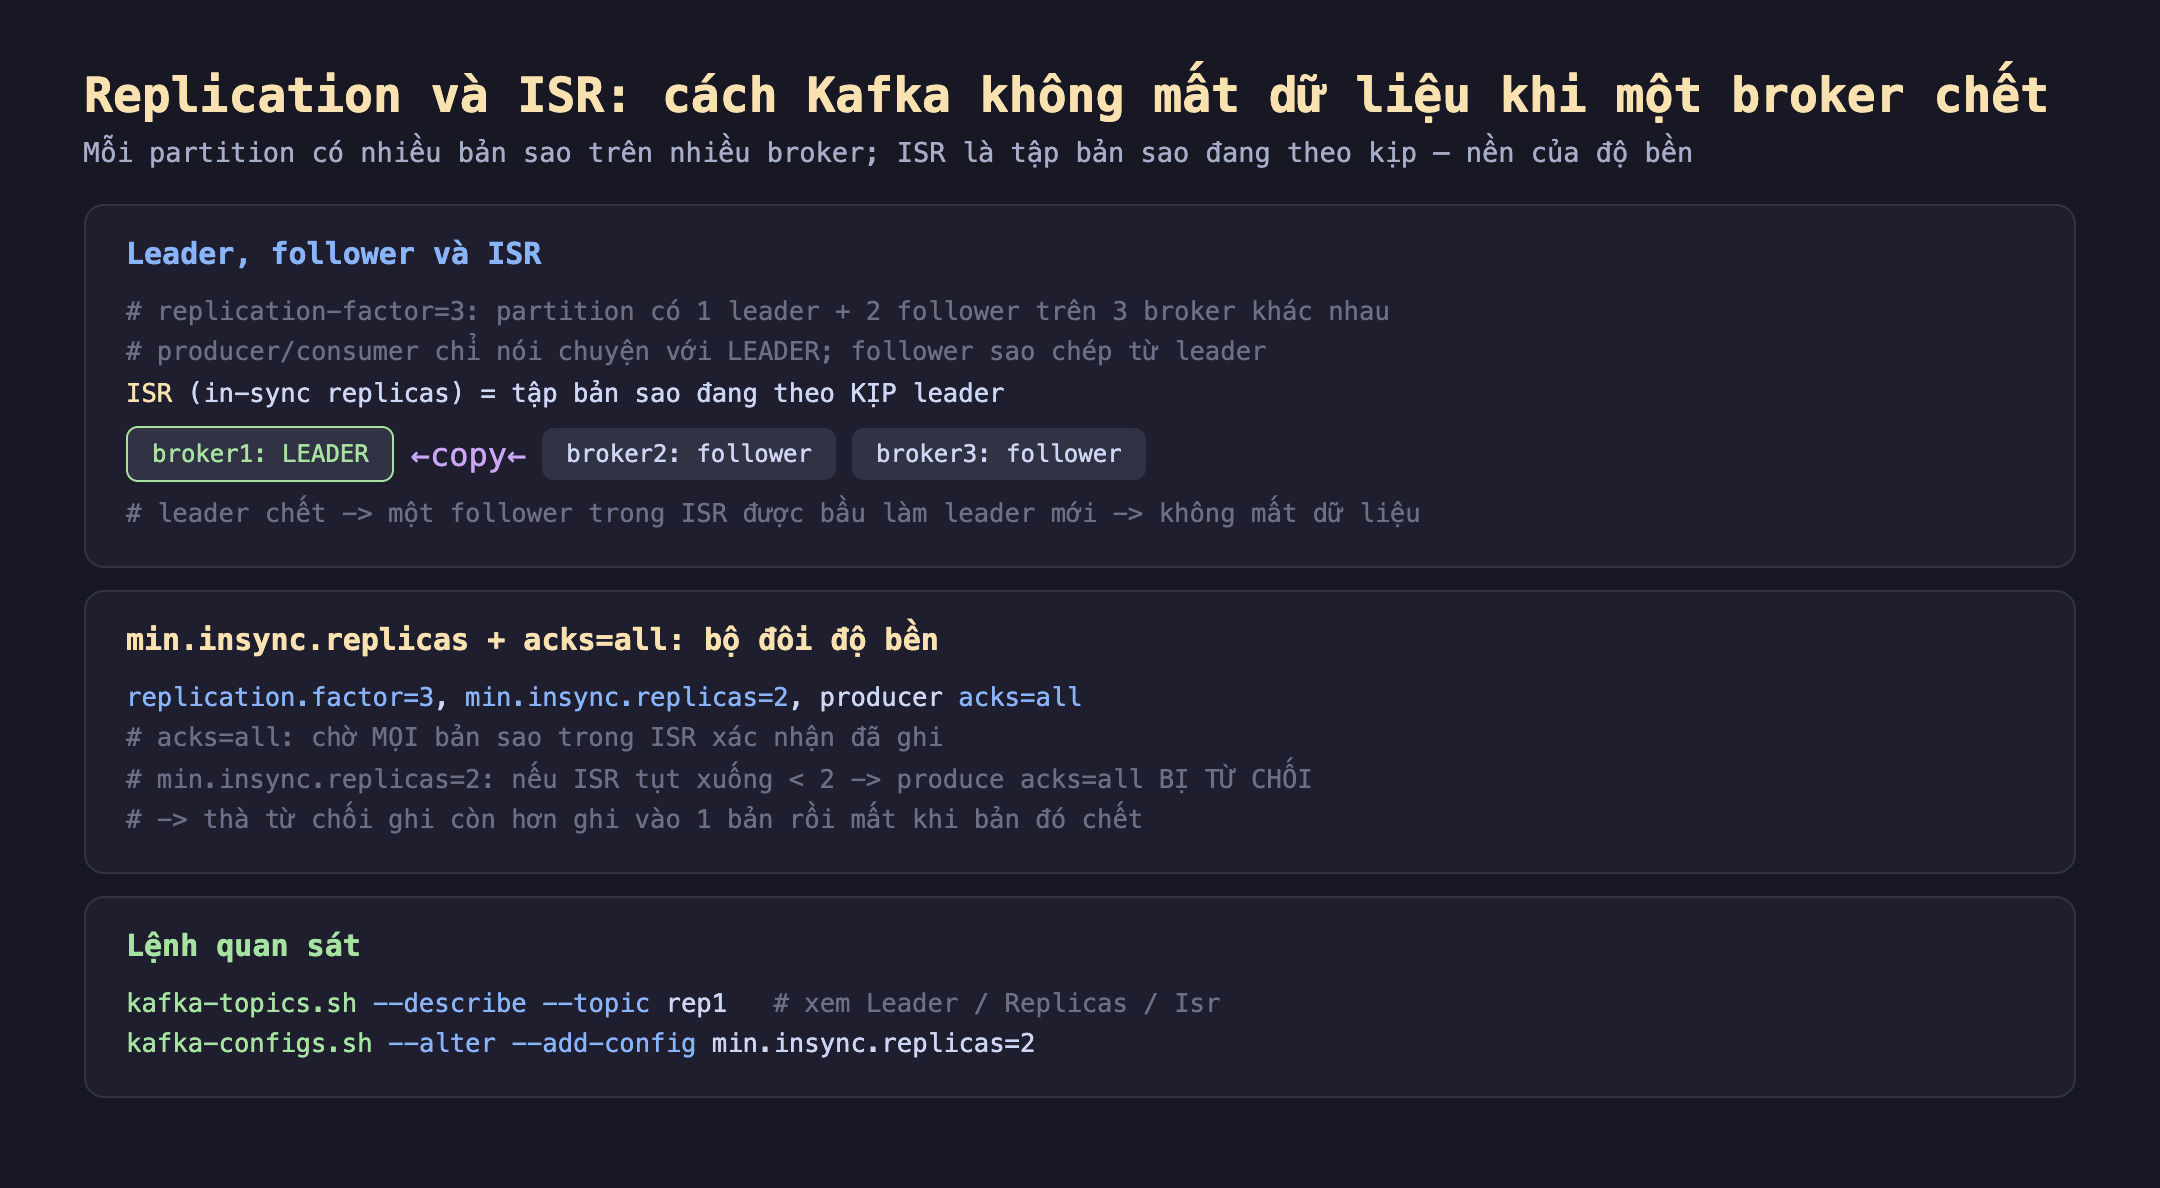
Hình 1: Mỗi partition có một leader và các follower trên những broker khác nhau; ISR là tập bản sao theo kịp leader. Khi leader chết, một bản sao trong ISR lên thay. min.insync.replicas + acks=all là bộ đôi đảm bảo độ bền.
min.insync.replicas + acks=all là bộ đôi tạo nên độ bền thật:
acks=all: producer chờ mọi bản sao trong ISR xác nhận đã ghi.min.insync.replicas=2: nếu ISR tụt xuống dưới 2, produce vớiacks=allbị từ chối. Triết lý: thà từ chối ghi còn hơn ghi vào đúng một bản sao rồi mất trắng khi bản đó chết. Công thức kinh điển: RF=3,min.insync.replicas=2,acks=all— chịu được một broker chết mà vẫn ghi được và không mất dữ liệu.
Đo thật: single-node và các giới hạn làm bằng chứng
Lab chỉ có một broker, nên không tạo được RF>1. Nhưng chính các giới hạn đó là bằng chứng rõ ràng về cơ chế:
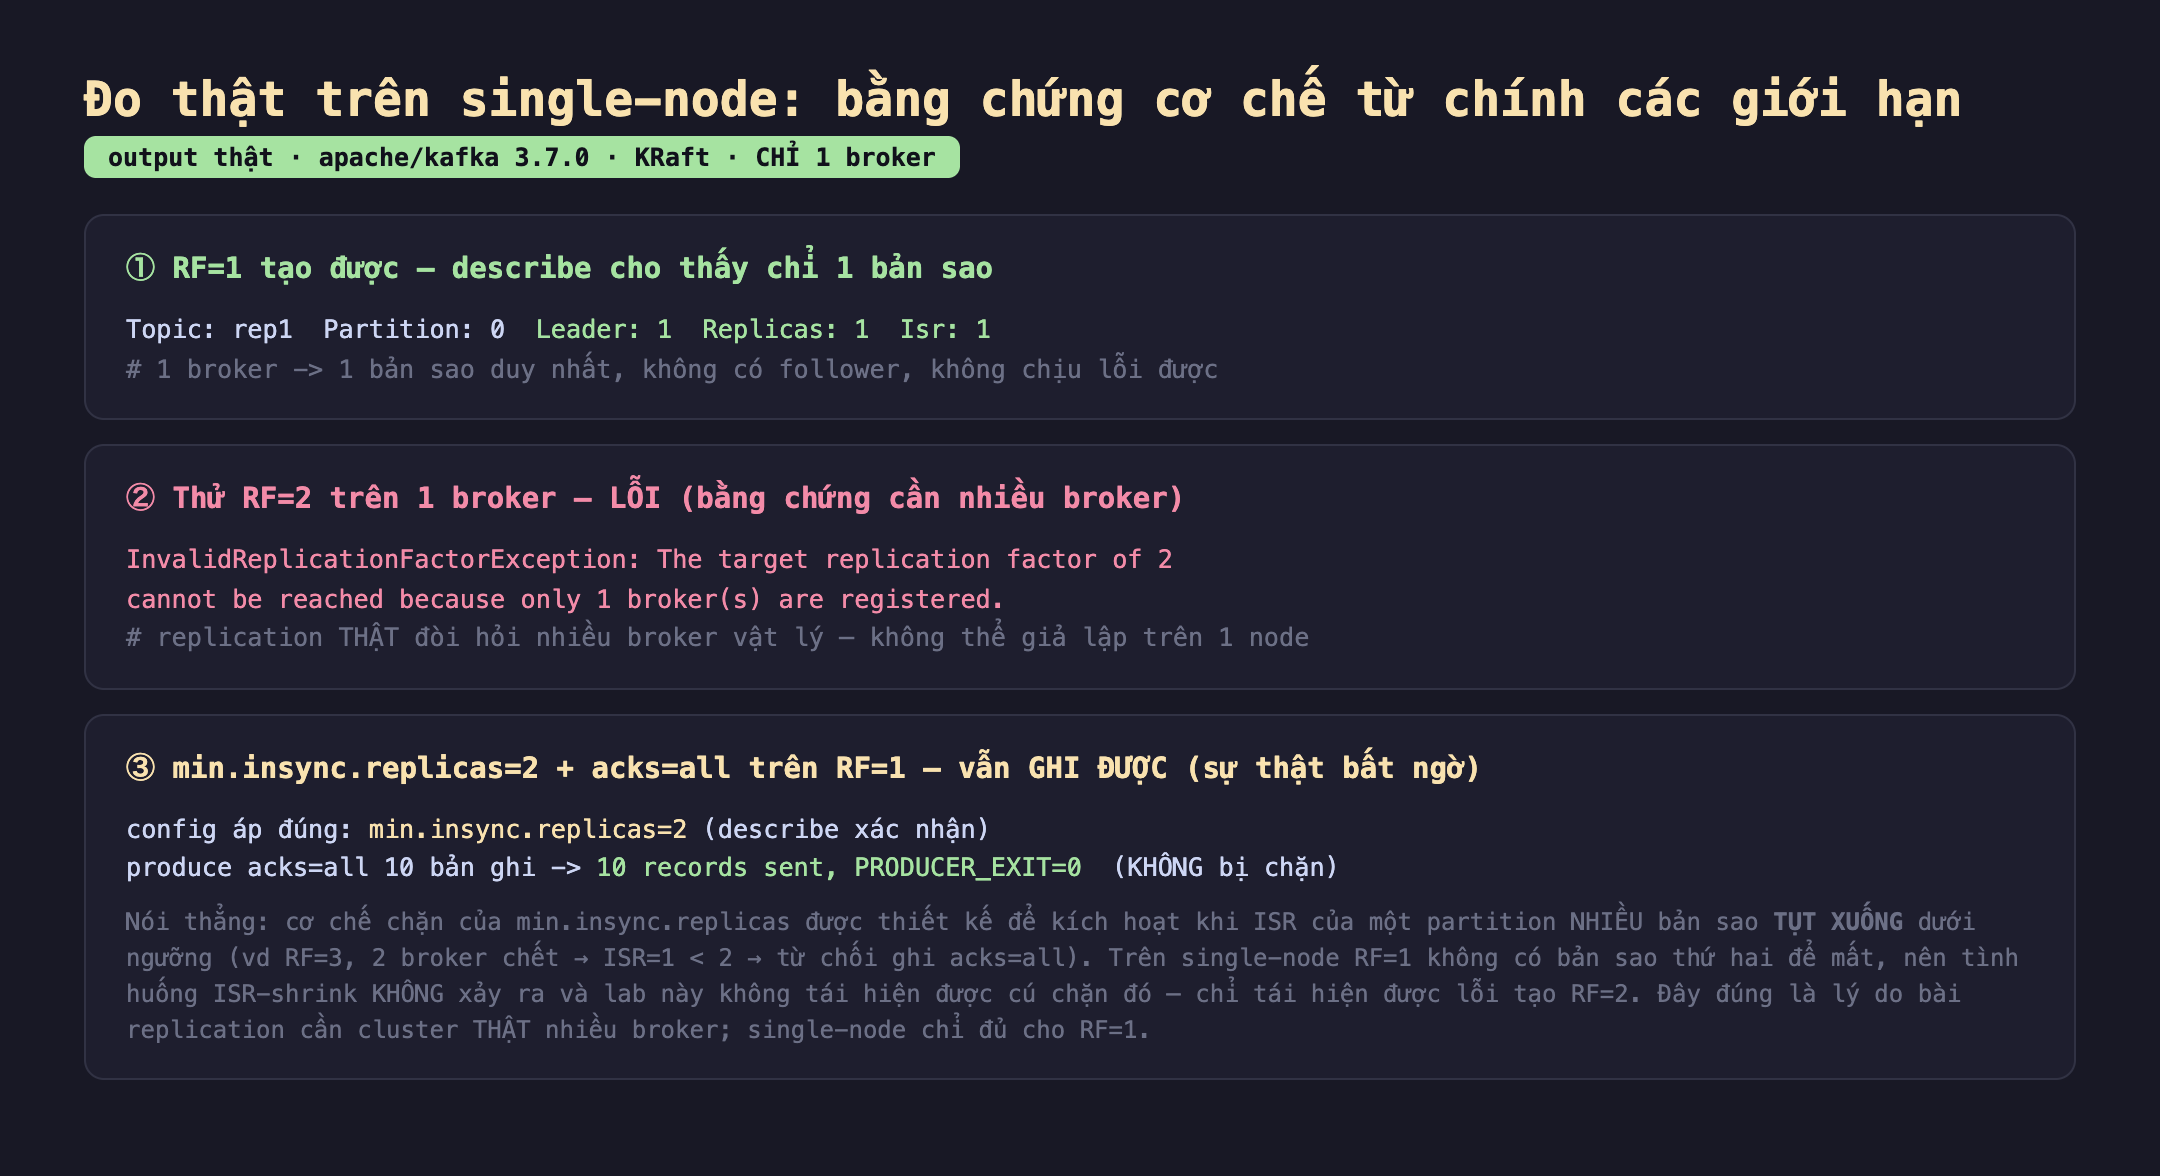
Hình 2: Đo thật trên single-node. (1) RF=1: describe cho Leader=1, Replicas=1, Isr=1 — chỉ một bản sao. (2) Thử RF=2: lỗi InvalidReplicationFactorException vì chỉ một broker — bằng chứng replication cần nhiều máy. (3) min.insync.replicas=2 + acks=all trên RF=1 vẫn ghi được (10 records sent) — phát hiện trung thực, giải thích bên dưới.
(1) RF=1 — chỉ một bản sao. describe cho Leader: 1, Replicas: 1, Isr: 1. Một broker nghĩa là một bản sao duy nhất: không follower, không chịu lỗi. Broker này chết là mất partition.
(2) Thử RF=2 — lỗi, và lỗi này là bằng chứng. Tạo topic RF=2 báo:
InvalidReplicationFactorException: The target replication factor of 2
cannot be reached because only 1 broker(s) are registered.
Kafka không đặt hai bản sao của cùng một partition trên cùng một broker (vô nghĩa — máy chết là mất cả hai). Lỗi này chứng minh thẳng: replication thật đòi hỏi nhiều broker vật lý, không giả lập trên một node được.
(3) min.insync.replicas=2 + acks=all trên RF=1 — vẫn ghi được (phát hiện trung thực). Mình đặt min.insync.replicas=2 lên topic (describe xác nhận đã áp), rồi produce acks=all 10 bản ghi — tất cả ghi thành công, không bị chặn. Điều này ngược với kỳ vọng phổ biến "ISR=1 < min.insync=2 thì acks=all phải bị từ chối". Nói thẳng: cú chặn của min.insync.replicas được thiết kế để kích hoạt khi ISR của một partition nhiều bản sao tụt xuống dưới ngưỡng — ví dụ RF=3, hai broker chết, ISR co còn 1 < 2 → từ chối ghi. Trên single-node RF=1, không có bản sao thứ hai để mất, nên tình huống ISR-shrink không bao giờ xảy ra, và lab này không tái hiện được cú chặn đó — chỉ tái hiện được lỗi tạo RF=2. Đây chính xác là lý do một bài về replication cần cluster thật nhiều broker; single-node chỉ đủ cho RF=1. Mình báo đúng những gì đo được, không dựng lên một kết quả không quan sát thấy.
Trên cluster thật thì sao
Để trọn vẹn, đây là điều sẽ xảy ra trên một cluster 3 broker (ngoài phạm vi lab này) với RF=3, min.insync.replicas=2, acks=all:
- Bình thường (3 broker sống, ISR=3): produce
acks=allghi vào cả 3, chờ cả 3 xác nhận. - Một broker chết (ISR co còn 2): vẫn ghi được, vì 2 ≥
min.insync.replicas. Hệ thống chịu lỗi mà không gián đoạn. - Hai broker chết (ISR còn 1 < 2): produce
acks=allbị từ chối vớiNotEnoughReplicasException. Kafka chọn dừng ghi thay vì ghi vào một bản sao mong manh — ưu tiên không mất dữ liệu hơn là sẵn sàng ghi. Đây là đánh đổi CAP (nhất quán/độ bền hơn khả dụng) mà bạn tự chọn qua cấu hình.
Đánh đổi cần cân nhắc
RF cao hơn = bền hơn nhưng tốn hơn. RF=3 nghĩa là mỗi byte được lưu ba lần và được sao chép qua mạng giữa các broker. Nó tăng độ bền và cho phép bảo trì luân phiên (rolling restart) nhưng tốn gấp ba đĩa, băng thông và một phần throughput ghi (đây là cái giá thật của acks=all mà single-node giấu đi ở bài kafka-04). Chọn RF theo mức độ quan trọng của dữ liệu: RF=3 cho dữ liệu không được mất, RF=1 chỉ cho dữ liệu bỏ được.
min.insync.replicas là đánh đổi giữa độ bền và khả dụng. Đặt min.insync.replicas = RF (ví dụ cả hai = 3) cho độ bền tối đa nhưng mất khả dụng ngay khi một broker chết (ISR co còn 2 < 3 → chặn ghi). Giá trị khuyến nghị là RF−1 (RF=3, min.insync=2): chịu được một broker chết mà vẫn ghi. Đặt quá cao làm hệ thống giòn, đặt quá thấp (=1) làm acks=all mất ý nghĩa.
acks=all không bảo vệ nếu min.insync.replicas=1. Hai tham số phải đi cùng nhau. acks=all với min.insync.replicas=1 chỉ chờ leader — nếu leader chết sau khi ghi mà follower chưa kịp sao chép, dữ liệu mất. Độ bền thật = acks=all và min.insync.replicas≥2 và RF đủ lớn. Thiếu một mắt xích là có lỗ hổng mất dữ liệu.
Ba ý mang về
- Replication = nhiều bản sao trên nhiều broker, ISR là tập theo kịp. Đo thật: RF=1 cho Leader/Replicas/Isr đều = 1 (một bản sao, không chịu lỗi); thử RF=2 trên một broker báo lỗi rõ ràng "only 1 broker registered" — bằng chứng replication cần nhiều máy vật lý.
- min.insync.replicas chặn khi ISR tụt xuống, cần multi-broker để demo. Phát hiện trung thực: trên single-node RF=1,
min.insync.replicas=2 + acks=allvẫn ghi được vì không có ISR-shrink. Cú chặn thật xảy ra khi partition nhiều bản sao mất đủ broker để ISR < ngưỡng. - Độ bền là bộ ba: RF đủ lớn + acks=all + min.insync.replicas≥2. Thiếu một là có lỗ hổng. Giá trị kinh điển RF=3/min.insync=2/acks=all chịu được một broker chết mà không mất dữ liệu; đổi lại tốn gấp ba lưu trữ và một phần throughput — cái giá thật mà single-node giấu đi.
Nguồn
- Apache Kafka — Replication & ISR: https://kafka.apache.org/documentation/#replication
- Apache Kafka — Topic Configs (min.insync.replicas) và Producer acks: https://kafka.apache.org/documentation/#topicconfigs
- Confluent — Hands-free Kafka Replication & durability guarantees: https://www.confluent.io/blog/hands-free-kafka-replication-a-lesson-in-operational-simplicity/
Phần sau ta chuyển sang dữ liệu đi trên dây: serialization — JSON so với Avro, vì sao schema quan trọng, và cách tiến hoá schema (thêm/bớt trường) mà không làm vỡ consumer cũ.
