Nếu Kafka giữ mọi message mãi mãi (bài kafka-01), đĩa sẽ đầy trong vài ngày. Nên Kafka dọn log — nhưng dọn thế nào thì có hai triết lý hoàn toàn khác nhau, chọn qua cleanup.policy. Một là xoá theo tuổi/dung lượng (delete): quá hạn thì vứt cả đoạn log cũ, hợp với dòng sự kiện (event stream) nơi dữ liệu cũ hết giá trị. Hai là log compaction (compact): không xoá theo tuổi mà chỉ giữ value mới nhất cho mỗi key, biến topic thành một bảng key-value có thể phát lại. Hiểu hai chính sách này quyết định bạn dùng Kafka đúng cách cho từng loại dữ liệu. Bài này (phần 8/12) đo thật compaction và nói trung thực về retention.
Hai chính sách dọn log
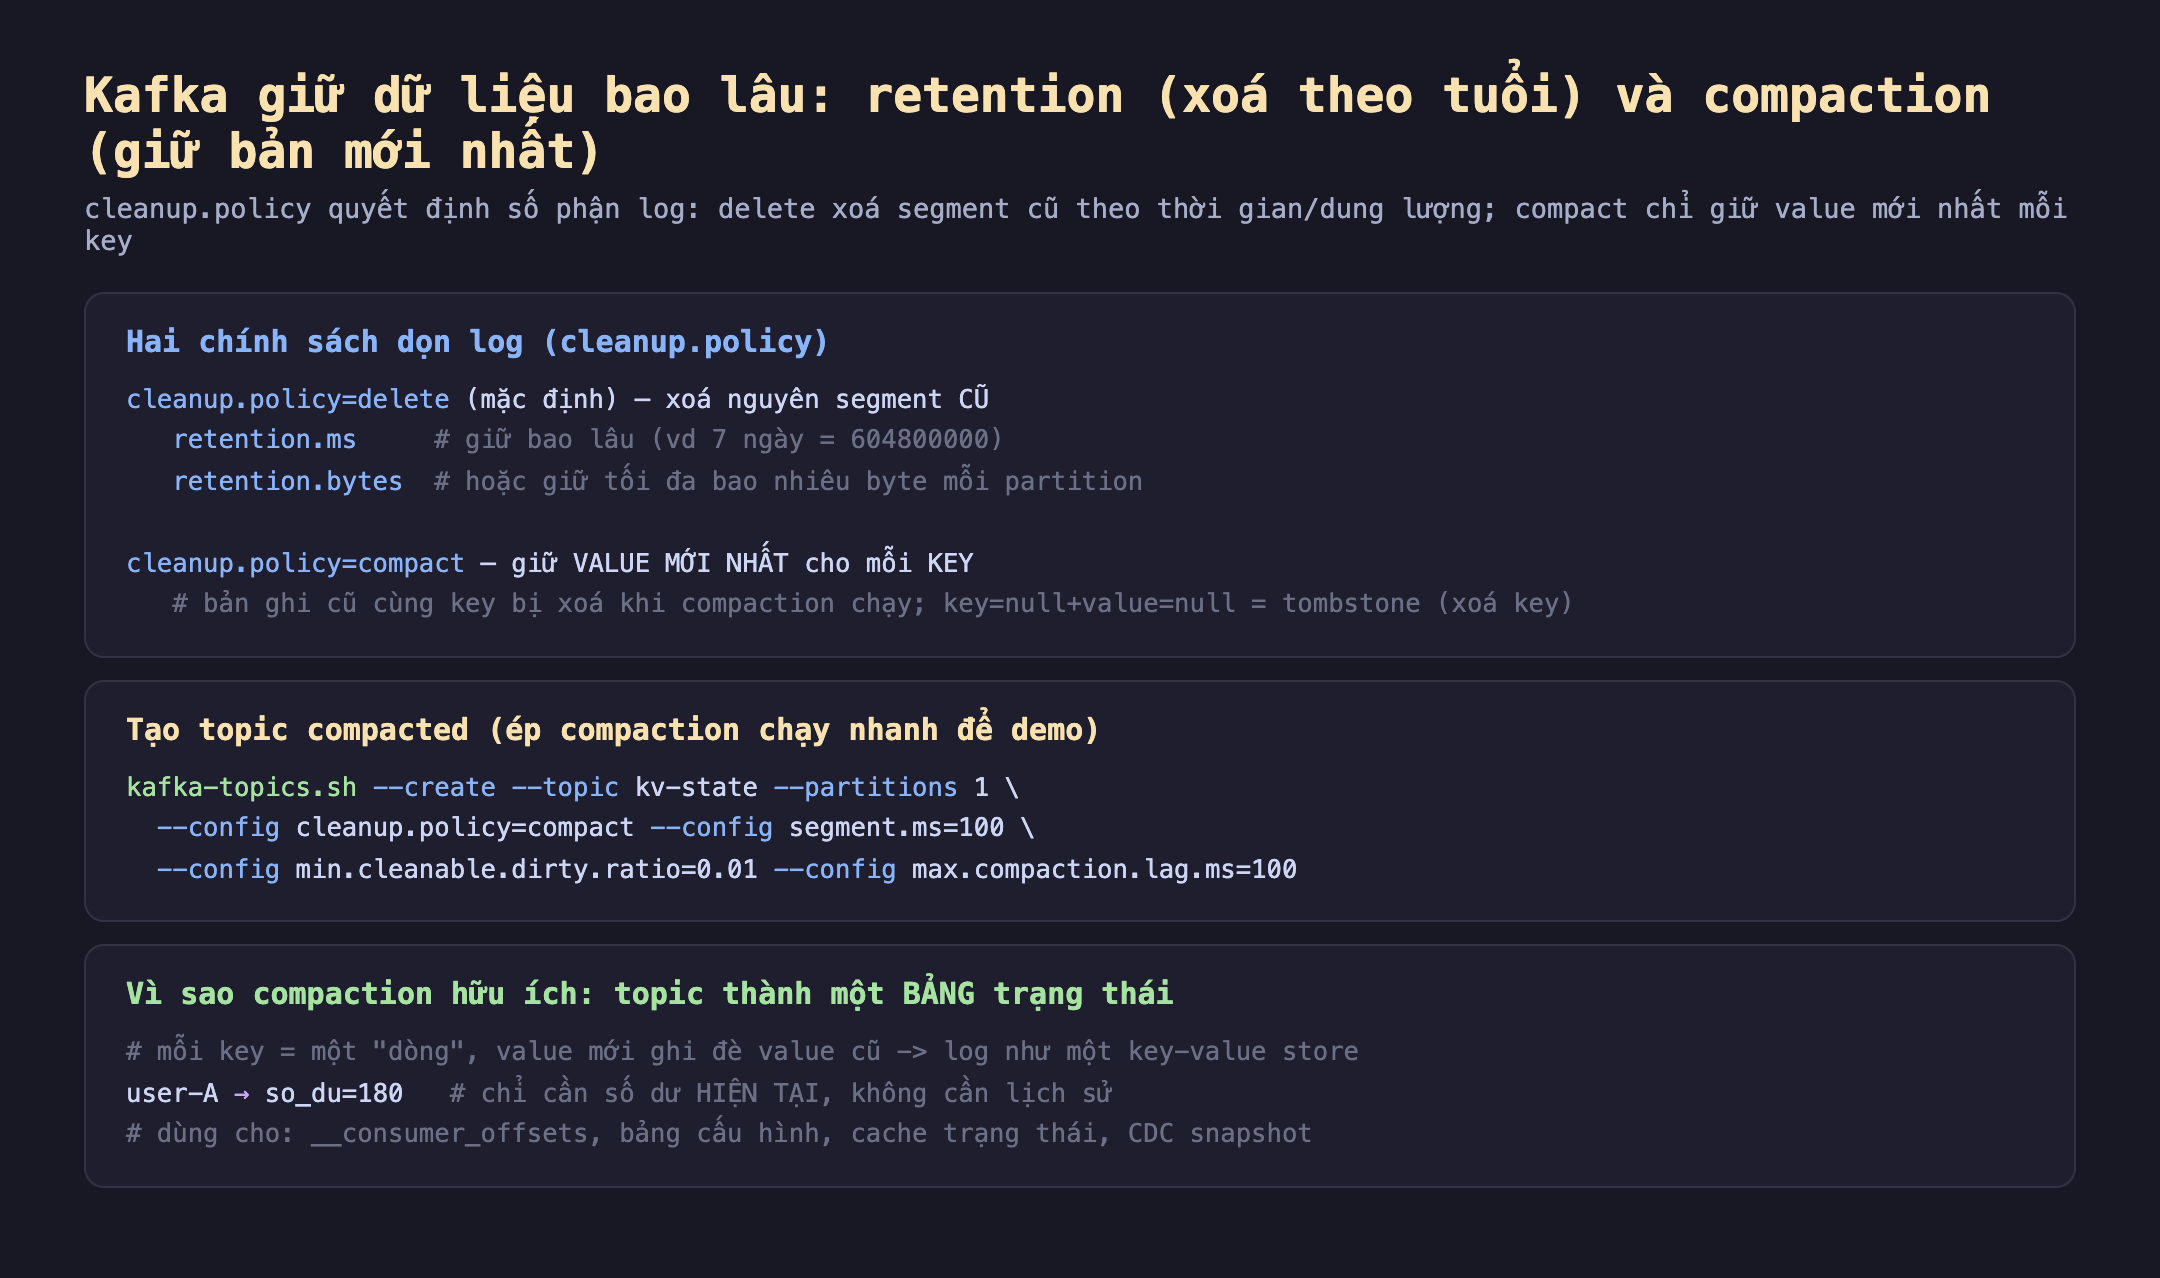
Hình 1: cleanup.policy=delete (mặc định) xoá nguyên segment cũ theo retention.ms/retention.bytes; cleanup.policy=compact giữ value mới nhất cho mỗi key. Compaction biến topic thành một bảng trạng thái key-value.
cleanup.policy=delete(mặc định): xoá nguyên segment khi dữ liệu trong đó quáretention.ms(vd 7 ngày = 604800000) hoặc khi tổng dung lượng vượtretention.bytes. Hợp với event stream — log, metric, click — nơi dữ liệu cũ hết giá trị.cleanup.policy=compact: không xoá theo tuổi. Thay vào đó, với mỗi key, chỉ giữ lại value mới nhất; các bản cũ cùng key bị dọn khi compaction chạy. Một bản ghi key có valuenulllà tombstone — báo "xoá key này". Hợp với trạng thái: số dư tài khoản, cấu hình, snapshot.
Đo thật: compaction giữ bản mới nhất mỗi key
Compaction mặc định chạy lười (chỉ khi log "bẩn" đủ nhiều). Để thấy nó trong lab, mình tạo topic với cấu hình ép compaction chạy nhanh:
kafka-topics.sh --bootstrap-server localhost:9092 --create --topic kv-state --partitions 1 \
  --config cleanup.policy=compact --config segment.ms=100 \
  --config min.cleanable.dirty.ratio=0.01 --config max.compaction.lag.ms=100
Rồi gửi 8 message cho 3 key (user-A 4 lần, user-B 2 lần, user-C 2 lần), mỗi lần một so_du khác:
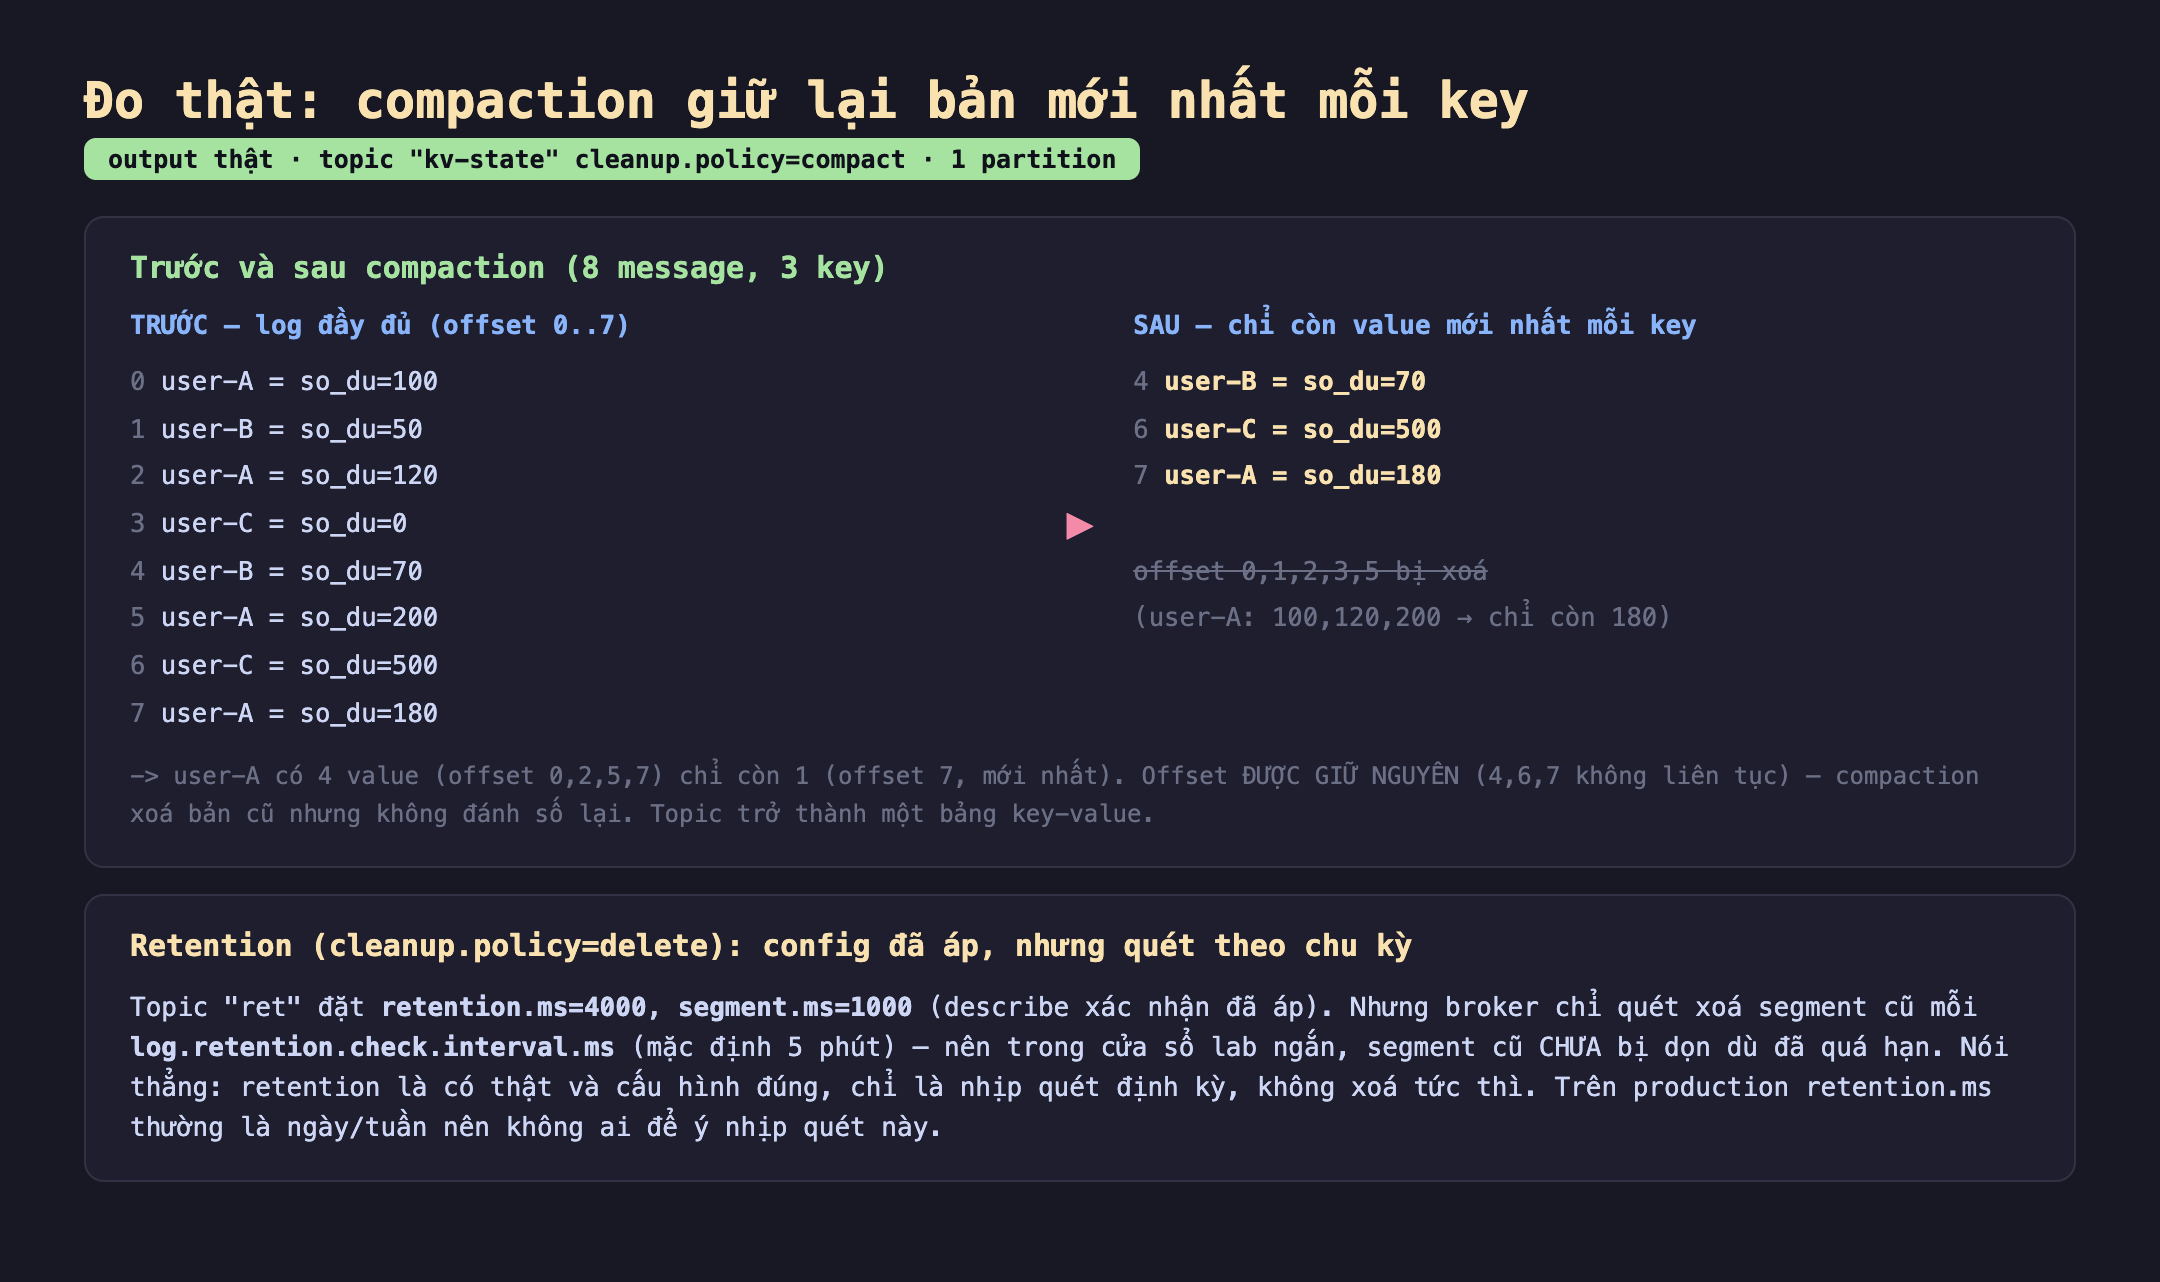
Hình 2: Đo thật. Trước: 8 message ở offset 0..7. Sau compaction: chỉ còn value mới nhất mỗi key — user-B=70 (offset 4), user-C=500 (offset 6), user-A=180 (offset 7). user-A từ 4 value (100,120,200,180) còn đúng 1. Offset được giữ nguyên (4,6,7 không liên tục).
Kết quả thật rất rõ: user-A được ghi 4 lần (offset 0, 2, 5, 7 với so_du 100 → 120 → 200 → 180), sau compaction chỉ còn offset 7 (so_du=180) — ba bản cũ bị xoá. Tương tự user-B còn so_du=70, user-C còn so_du=500. Hai điểm tinh tế đáng nhớ:
- Offset được giữ nguyên, không đánh số lại. Các bản sống sót giữ offset gốc (4, 6, 7 — không liên tục). Compaction xoá bản cũ nhưng không dịch offset — vì nhiều consumer có thể đang trỏ tới offset cụ thể. Consumer đọc một topic compacted sẽ thấy offset nhảy cóc, đó là bình thường.
- Topic trở thành một bảng key-value có thể phát lại. Đọc từ đầu một topic compacted = đọc trạng thái hiện tại của mọi key. Đây chính là cách Kafka tự lưu
__consumer_offsets(bài kafka-05), và là nền cho các bảng trạng thái, cache, snapshot CDC.
Retention: có thật, nhưng quét định kỳ
Mình cũng tạo một topic delete với retention.ms=4000 (4 giây) rất ngắn, nạp 50.000 message, rồi chờ. Nhưng segment cũ chưa bị xoá trong cửa sổ lab — và đây là chỗ cần nói thẳng: broker không xoá ngay khi message quá hạn. Nó chạy một tác vụ quét theo chu kỳ log.retention.check.interval.ms (mặc định 5 phút). describe xác nhận retention.ms=4000 đã áp đúng, nhưng tới nhịp quét kế tiếp mới dọn. Trong lab ngắn hạn, tôi không quan sát được việc xoá, nên không bịa ra con số — retention là có thật và cấu hình đúng, chỉ là nó dọn theo nhịp định kỳ chứ không tức thời. Trên production, retention.ms thường là ngày/tuần nên nhịp quét 5 phút chẳng ai để ý; chỉ trong demo ép thời gian cực ngắn mới lộ ra khoảng cách này.
Đánh đổi cần cân nhắc
Compaction không đảm bảo bạn không bao giờ thấy bản trùng. Compaction chạy lười trên các segment đã đóng; segment đang hoạt động (head của log) chưa bị nén. Nên một consumer đọc realtime vẫn có thể thấy nhiều value cho cùng key (các bản chưa compaction kịp). Compaction đảm bảo cuối cùng chỉ còn bản mới nhất, không đảm bảo tức thời. Logic đọc topic compacted phải chịu được việc thấy bản cũ trước bản mới.
Compaction cần key — message không key là vấn đề. Compaction gom theo key; message có key=null không thể compaction (không biết "mới nhất của cái gì"). Nếu định dùng compact, mọi message phải có key có nghĩa. Và nhớ: tombstone (value null) để xoá key cũng chỉ được giữ trong delete.retention.ms rồi mới biến mất — đủ lâu để mọi consumer kịp thấy lệnh xoá.
Retention quá ngắn so với consumer lag = mất dữ liệu. Nối với bài kafka-06: nếu consumer tụt lại xa hơn retention.ms, message cũ nhất chưa đọc đã bị delete xoá trước khi consumer tới. Consumer sẽ nhảy tới offset còn tồn tại và bỏ qua phần mất, thường chỉ cảnh báo nhẹ. Đặt retention phải tính tới cả độ trễ xấu nhất của consumer, không chỉ dung lượng đĩa.
Ba ý mang về
- cleanup.policy chọn giữa xoá theo tuổi và giữ bản mới nhất.
delete(mặc định) vứt segment cũ theoretention.ms/retention.bytes— hợp event stream.compactgiữ value mới nhất mỗi key — hợp dữ liệu trạng thái. - Compaction biến topic thành bảng key-value. Đo thật: user-A từ 4 value (100,120,200,180) còn đúng 1 (180, mới nhất) sau compaction; offset giữ nguyên không đánh số lại (4,6,7 không liên tục). Đọc từ đầu = đọc trạng thái hiện tại mọi key — nền cho
__consumer_offsets, cache, CDC. - Dọn log là cuối cùng, không tức thời — và phải tính với consumer lag. Retention quét theo
log.retention.check.interval.ms(mặc định 5 phút), compaction chạy lười trên segment đã đóng. Đặt retention quá ngắn so với độ trễ consumer sẽ gây mất dữ liệu âm thầm.
Nguồn
- Apache Kafka — Log Compaction: https://kafka.apache.org/documentation/#compaction
- Apache Kafka — Topic-Level Configs (cleanup.policy, retention.ms, retention.bytes): https://kafka.apache.org/documentation/#topicconfigs
- Confluent — Kafka log compaction explained: https://developer.confluent.io/courses/architecture/compaction/
Phần sau ta tìm hiểu độ bền dữ liệu: replication và ISR (in-sync replicas) — cách Kafka sao chép partition sang nhiều broker để chịu lỗi, min.insync.replicas, và vì sao acks=all chỉ thực sự có nghĩa trên cluster nhiều broker.
