Ở bài kafka-01 ta thấy một node đã ghi được nửa triệu message/giây với cấu hình mặc định. Nhưng khi hệ thống thật đụng trần — producer không đẩy kịp dữ liệu, hoặc hoá đơn băng thông và đĩa phình to — thì phải chỉnh. May thay, phần lớn hiệu quả nằm ở đúng ba núm phía producer: batch.size, linger.ms và compression.type. Hiểu ba cái này là biết tăng gấp đôi throughput, giảm độ trễ, và cắt dung lượng đĩa cùng lúc. Bài này (phần 7/12) đo thật từng núm — với vài con số đẹp đến bất ngờ, và một cái bẫy "càng to càng tốt".
Ba núm chỉnh và cơ chế
batch.size + linger.ms đi đôi với nhau, cùng điều khiển việc gom message. Producer không gửi từng message một — nó gom chúng thành batch theo partition rồi gửi một lần (ít request hơn = hiệu quả hơn):
batch.size: kích thước tối đa (byte) của một batch cho mỗi partition.linger.ms: chờ tối đa bấy nhiêu mili-giây để gom thêm message trước khi gửi. Mặc địnhlinger.ms=0nghĩa là "gửi ngay khi có thể" — batch thường nhỏ. Đặtlinger.ms=10cho producer chờ một nhịp ngắn để gom batch to hơn.
compression.type nén cả batch trước khi gửi (nén theo batch, không từng message — nên batch càng to nén càng lợi). Các lựa chọn: none, lz4, snappy, gzip, zstd. Nén giảm cả băng thông mạng lẫn dung lượng đĩa trên broker.
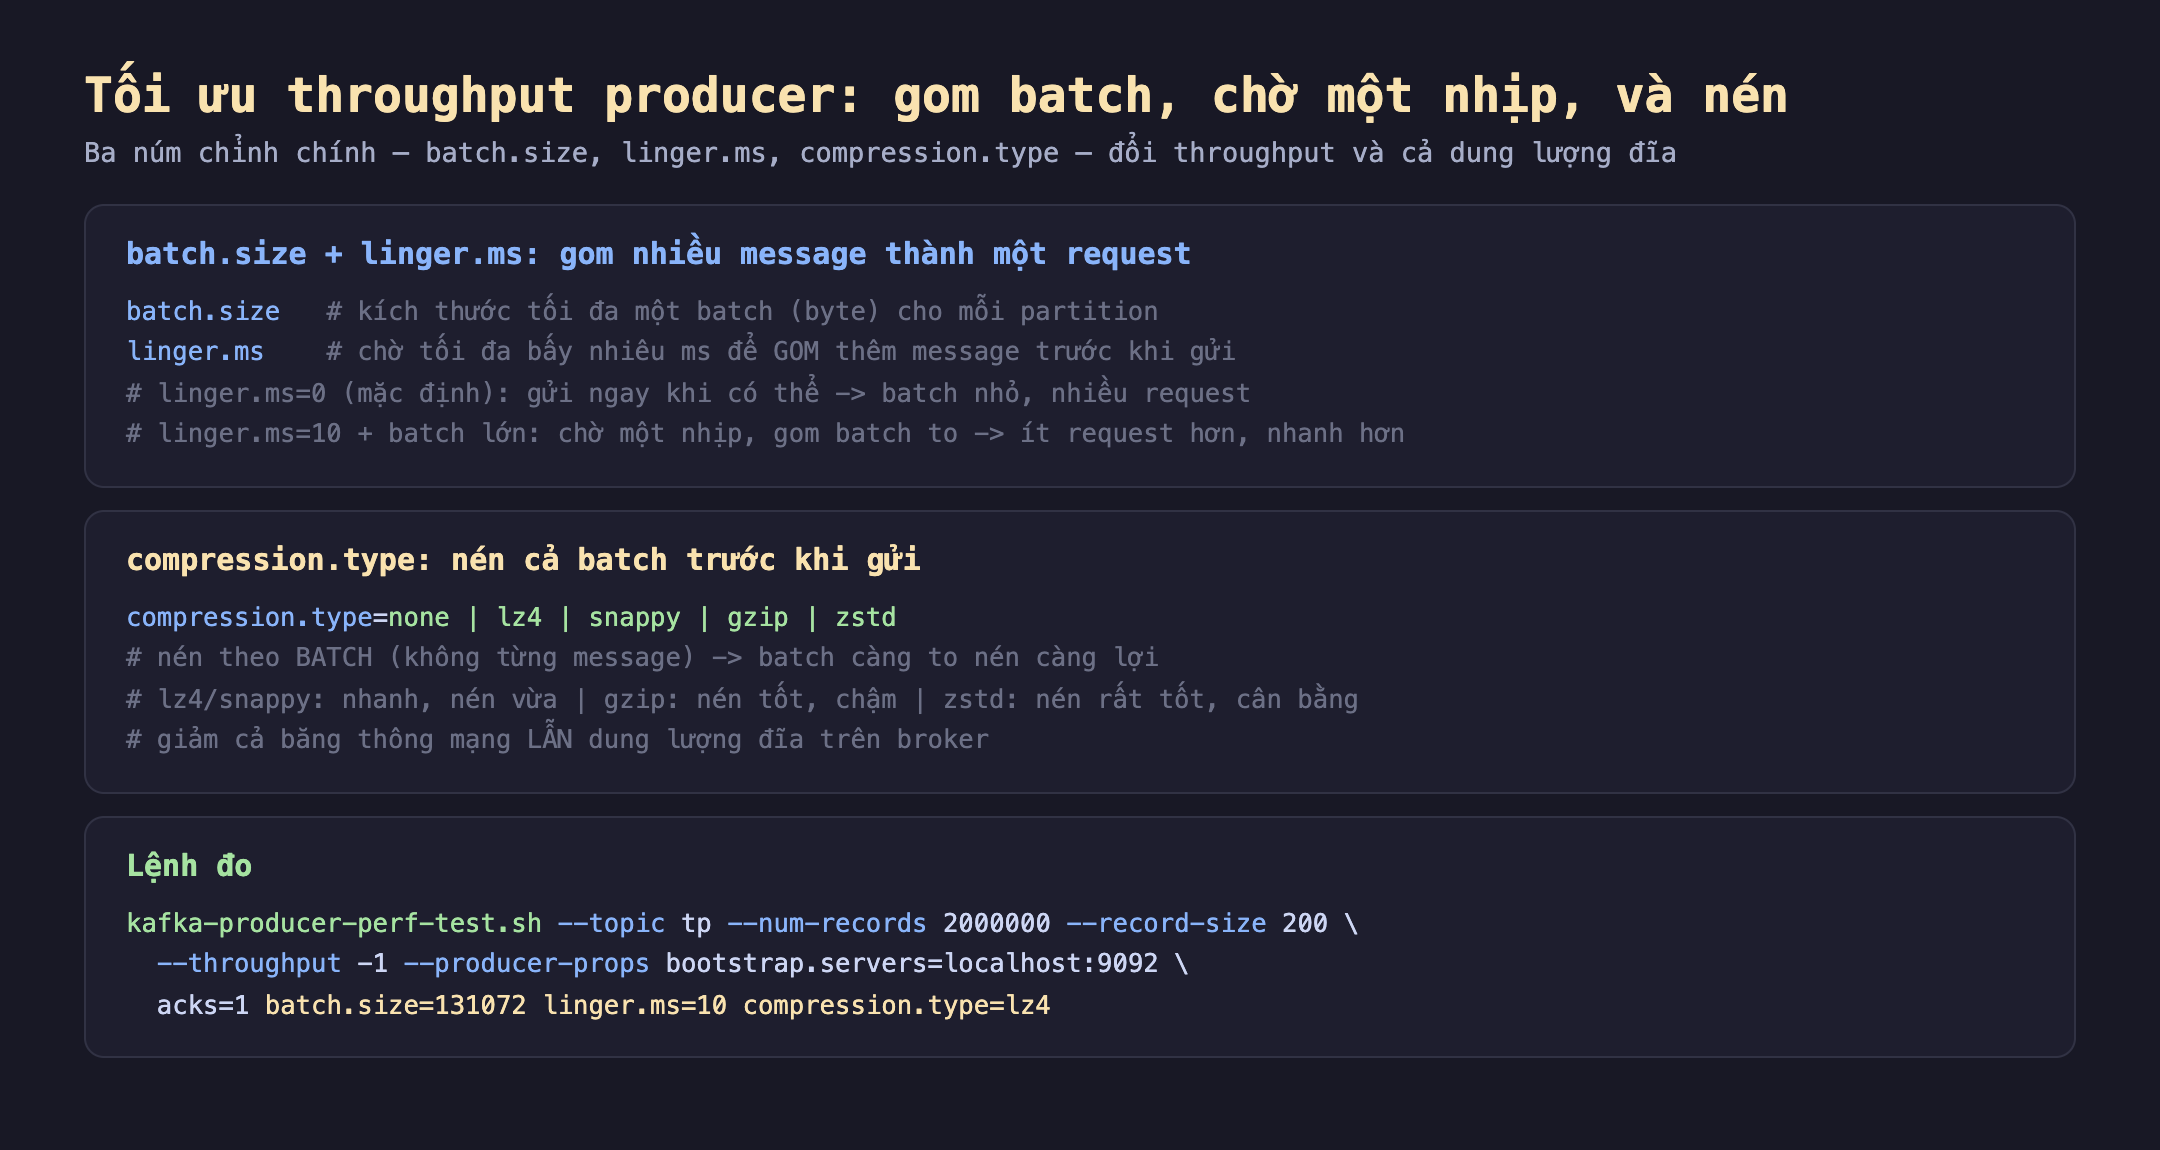
Hình 1: batch.size + linger.ms gom message thành batch (ít request hơn, nhanh hơn); compression.type nén cả batch (giảm băng thông + đĩa). lz4/snappy nhanh nén vừa, gzip nén tốt nhưng chậm, zstd cân bằng tốt.
Đo thật: batch.size và linger.ms
Chạy 2 triệu bản ghi 200 byte với ba mức gom batch:
- baseline (batch 16KB mặc định, linger 0): 618.811/giây (118,0 MB/giây), độ trễ 8,05 ms.
- tuned (batch 128KB, linger 10ms): 1.394.700/giây (266,0 MB/giây), độ trễ 1,86 ms.
- aggressive (batch 1MB, linger 100ms): 1.348.617/giây (257,2 MB/giây), độ trễ 9,09 ms.
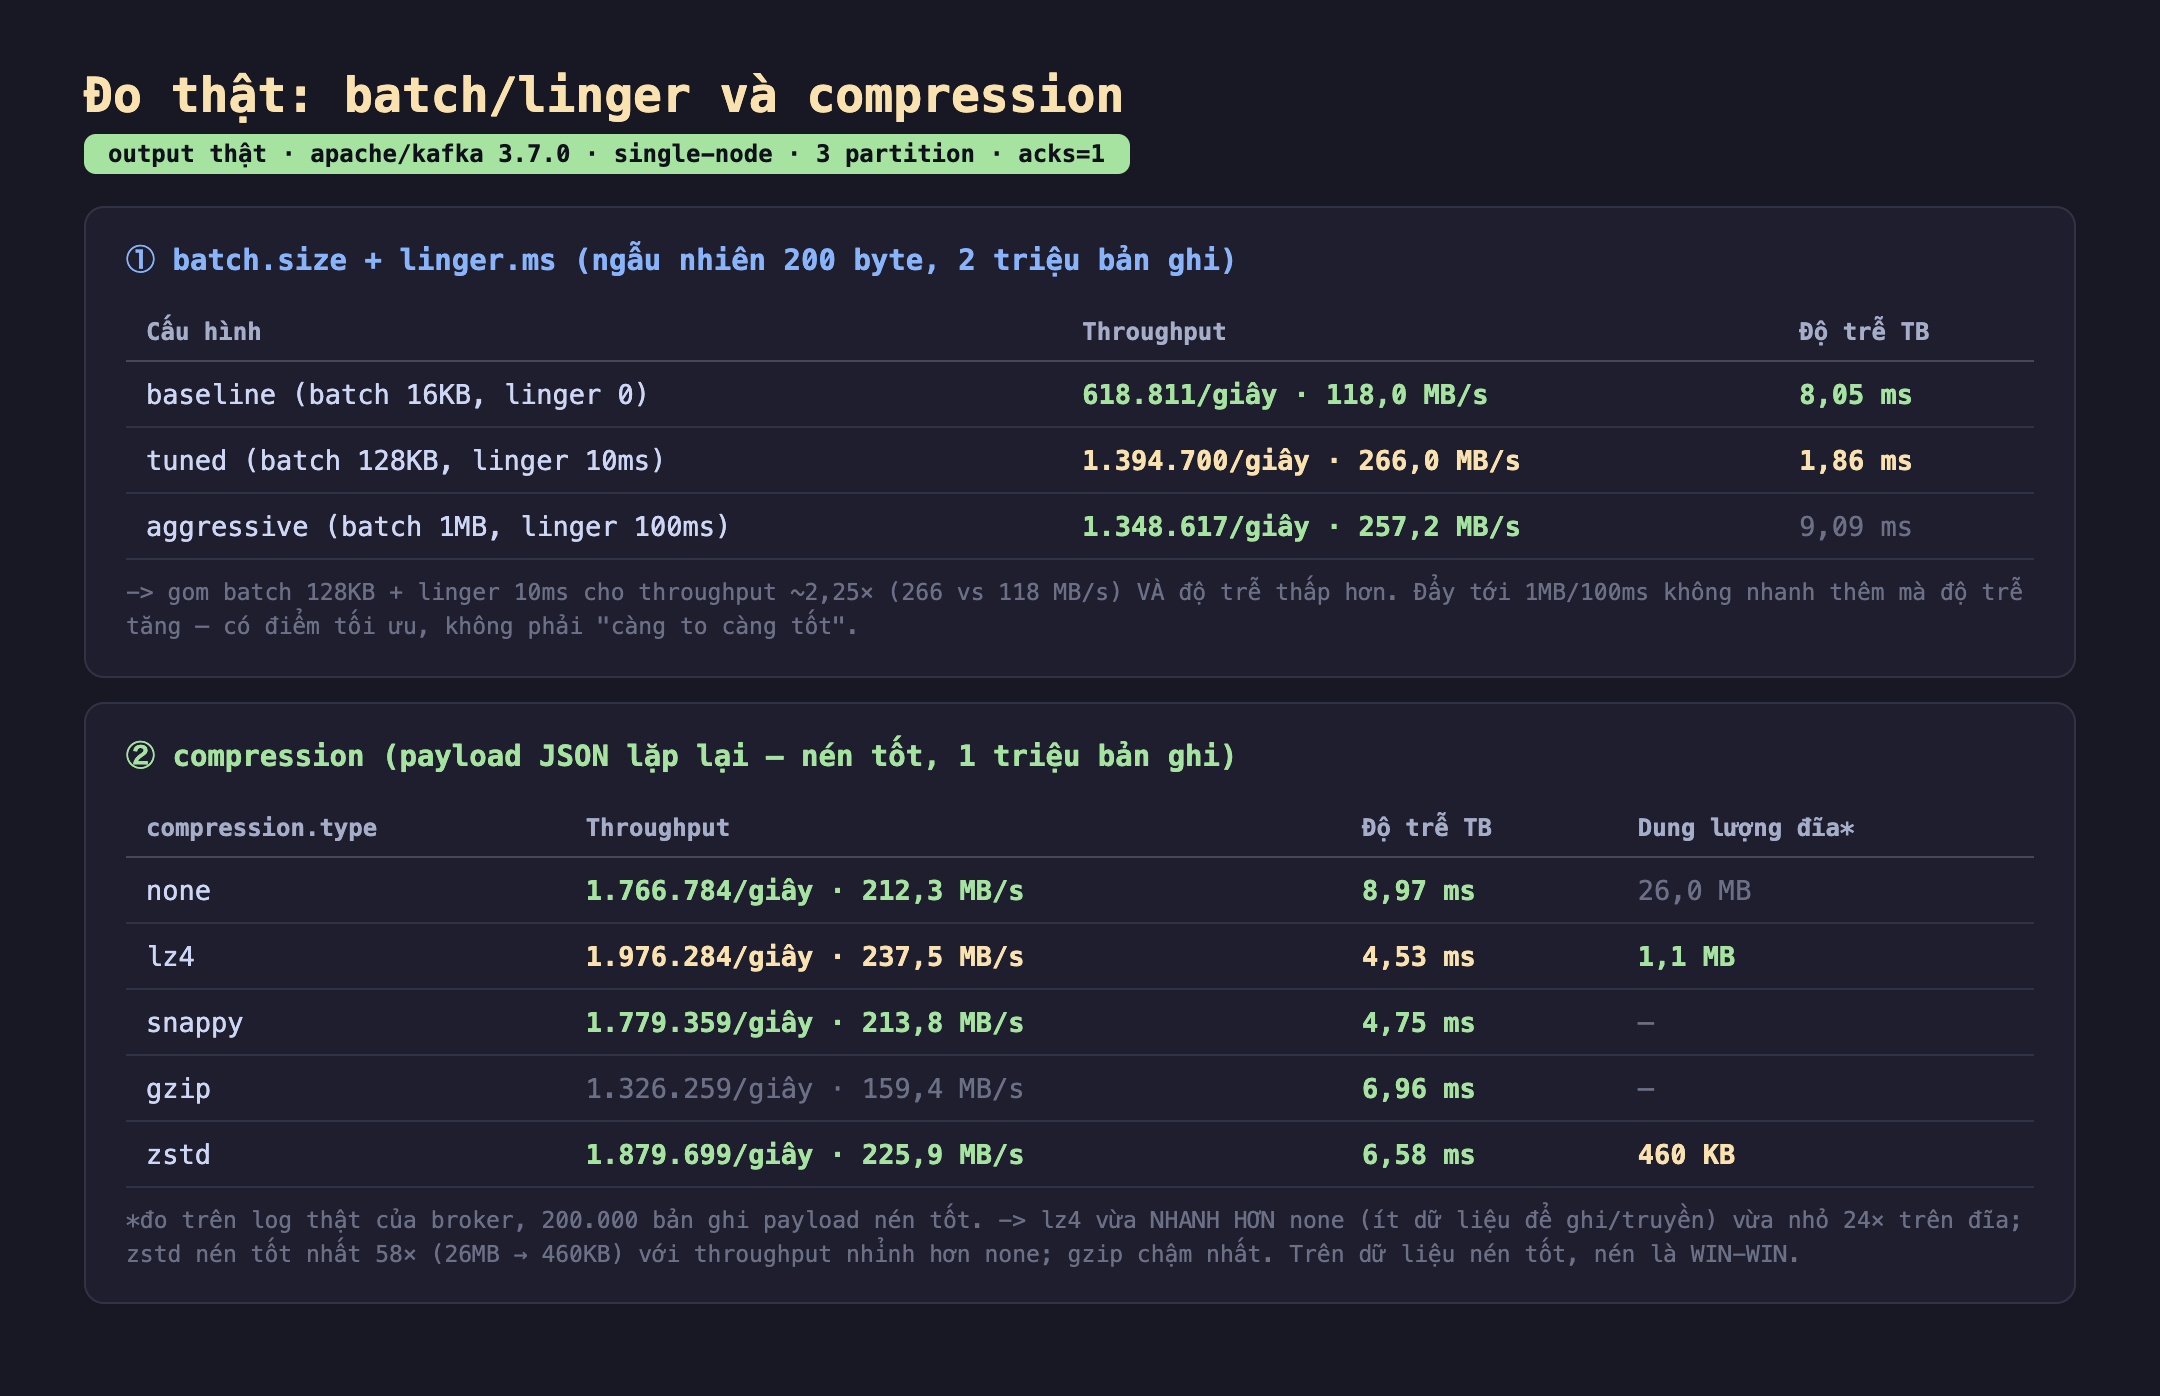
Hình 2: Đo thật. Trên — gom batch 128KB + linger 10ms cho throughput 2,25× (266 vs 118 MB/giây) VÀ độ trễ thấp hơn; đẩy lên 1MB/100ms không nhanh thêm mà độ trễ tăng. Dưới — compression trên payload JSON nén tốt: lz4 nhanh hơn none và nhỏ 24× trên đĩa; zstd nén 58× (26MB → 460KB).
Hai điều từ bảng trên:
Gom batch cho throughput 2,25× và độ trễ thấp hơn. Nghe nghịch lý — linger.ms=10 thêm một khoảng chờ, sao độ trễ lại giảm? Vì ở baseline, batch nhỏ khiến producer gửi quá nhiều request, broker và mạng quá tải, hàng đợi chờ xử lý mỗi request dài ra. Gom batch to giảm số request, giảm tắc nghẽn, nên độ trễ trung bình thực tế lại thấp hơn (1,86 ms so với 8,05 ms). Đây là trường hợp hiếm mà tối ưu throughput không phải đánh đổi với độ trễ.
Nhưng "càng to càng tốt" là sai. Đẩy lên batch 1MB + linger 100ms không cho throughput cao hơn tuned (thậm chí nhỉnh thấp hơn) mà độ trễ vọt lên 9,09 ms — vì giờ producer phải chờ đủ 100ms hoặc đầy 1MB mới gửi, thêm độ trễ mà không thêm throughput (đã bão hoà). Có một điểm tối ưu; vượt qua nó chỉ hại.
Đo thật: compression — win-win trên dữ liệu nén được
Nén chỉ có ý nghĩa trên dữ liệu nén được. Mình dùng payload JSON lặp lại (như event thật — nhiều trường trùng), chạy 1 triệu bản ghi:
- none: 212,3 MB/giây, đĩa 26,0 MB.
- lz4: 237,5 MB/giây (nhanh hơn none!), đĩa 1,1 MB (nhỏ 24×).
- snappy: 213,8 MB/giây.
- gzip: 159,4 MB/giây (chậm nhất).
- zstd: 225,9 MB/giây, đĩa 460 KB (nhỏ 58×!).
Kết quả bất ngờ nhất: lz4 vừa nhanh hơn không nén vừa nhỏ 24× trên đĩa. Nghe phản trực giác — nén tốn CPU mà? Nhưng vì dữ liệu nén được tốt, lượng byte phải ghi xuống đĩa và truyền qua mạng giảm mạnh, và cái lợi đó lớn hơn chi phí CPU nén (lz4 nén cực nhanh). Trên dữ liệu nén tốt, nén là win-win: nhanh hơn, rẻ hơn, nhỏ hơn. zstd nén khủng khiếp (26MB → 460KB, 58×) với throughput vẫn nhỉnh hơn none. Chỉ gzip là chậm thật (nén tốt nhưng tốn CPU nhiều).
Đánh đổi cần cân nhắc
Lợi ích nén phụ thuộc hoàn toàn vào dữ liệu. Con số 24×, 58× ở đây đến từ payload rất lặp lại. Dữ liệu đã nén sẵn (ảnh, video, chuỗi ngẫu nhiên, dữ liệu đã mã hoá) gần như không nén thêm được — bật nén lúc đó chỉ tốn CPU vô ích. Đo trên dữ liệu thật của bạn trước khi kết luận; đừng áp con số của bài này.
batch/linger là đánh đổi giữa throughput và độ trễ đuôi. Dù độ trễ trung bình giảm khi gom batch vừa phải, linger.ms cao luôn thêm vào độ trễ của message đến ngay sau một lần flush (nó phải chờ nhịp linger kế). Với ứng dụng cần độ trễ p99/p999 cực thấp cho từng message, giữ linger.ms nhỏ. Với pipeline throughput-first (ETL, log), linger cao hơn là đúng.
Tối ưu producer không cứu được consumer chậm. Tăng throughput ghi mà consumer không theo kịp chỉ làm lag phình nhanh hơn (bài kafka-06). Throughput là bài toán cả hệ thống: producer, broker, consumer, partition phải cân đối. Chỉnh một đầu mà bỏ đầu kia là dời nút thắt, không gỡ.
Ba ý mang về
- Gom batch đúng mức cho throughput 2,25× mà độ trễ còn thấp hơn. Đo thật: batch 128KB + linger 10ms cho 266 MB/giây (so 118 MB/giây baseline) và độ trễ 1,86 ms (so 8,05 ms) — ít request hơn, bớt tắc nghẽn. Nhưng có điểm tối ưu: đẩy lên 1MB/100ms chỉ thêm độ trễ, không thêm tốc độ.
- Trên dữ liệu nén được, nén là win-win. Đo thật: lz4 nhanh hơn không nén (237 vs 212 MB/giây) và nhỏ 24× trên đĩa; zstd nén 58× (26MB → 460KB). Vì ít byte phải ghi/truyền, lợi lớn hơn chi phí CPU — trừ gzip (chậm).
- Mọi con số phụ thuộc dữ liệu và cả hệ thống. Lợi ích nén chỉ có trên dữ liệu lặp lại (dữ liệu ngẫu nhiên/đã nén thì vô ích); batch cao đổi độ trễ đuôi; và tối ưu producer vô nghĩa nếu consumer là nút thắt. Luôn đo trên dữ liệu và tải thật của bạn.
Nguồn
- Apache Kafka — Producer Configs (batch.size, linger.ms, compression.type): https://kafka.apache.org/documentation/#producerconfigs
- Confluent — Optimizing Kafka producers for throughput and latency: https://developer.confluent.io/learn/kafka-performance/
- Cloudflare — Squeezing the firehose: compression in Kafka: https://blog.cloudflare.com/squeezing-the-firehose/
Phần sau ta tìm hiểu Kafka giữ dữ liệu bao lâu: retention theo thời gian và dung lượng, và log compaction — cơ chế chỉ giữ lại bản ghi mới nhất cho mỗi key, biến topic thành một bảng trạng thái.
