Có một câu hỏi mà mọi đội vận hành Kafka đều phải trả lời được bất cứ lúc nào: "consumer của chúng ta có đang theo kịp không?". Vì Kafka tách rời producer khỏi consumer (bài kafka-01), producer có thể ghi nhanh hơn consumer xử lý trong một khoảng — và dữ liệu dồn lại trong log. Nếu khoảng cách đó cứ nới rộng mãi, cuối cùng consumer tụt lại quá xa: dữ liệu xử lý trễ hàng giờ, hoặc tệ hơn, message cũ bị retention xoá trước khi kịp đọc (bài kafka-08). Thước đo cho khoảng cách đó là consumer lag — và nếu chỉ được chọn một chỉ số để cảnh báo, hãy chọn nó. Bài này (phần 6/12) đo thật cách lag phình lên và co lại.
Lag là khoảng cách tới cuối log
Công thức rất gọn, dựa thẳng trên offset ở bài trước:
LAG = LOG-END-OFFSET − CURRENT-OFFSET
- LOG-END-OFFSET: producer đã ghi tới đâu (cuối log).
- CURRENT-OFFSET: consumer group đã xử lý (commit) tới đâu.
- LAG: số message đã nằm trong Kafka nhưng chưa được xử lý.
Lag = 0 nghĩa là consumer đã bắt kịp cuối log. Lag ổn định ở một mức nhỏ là bình thường (luôn có độ trễ xử lý). Lag tăng đều không ngừng mới là báo động: consumer không bao giờ đuổi kịp.
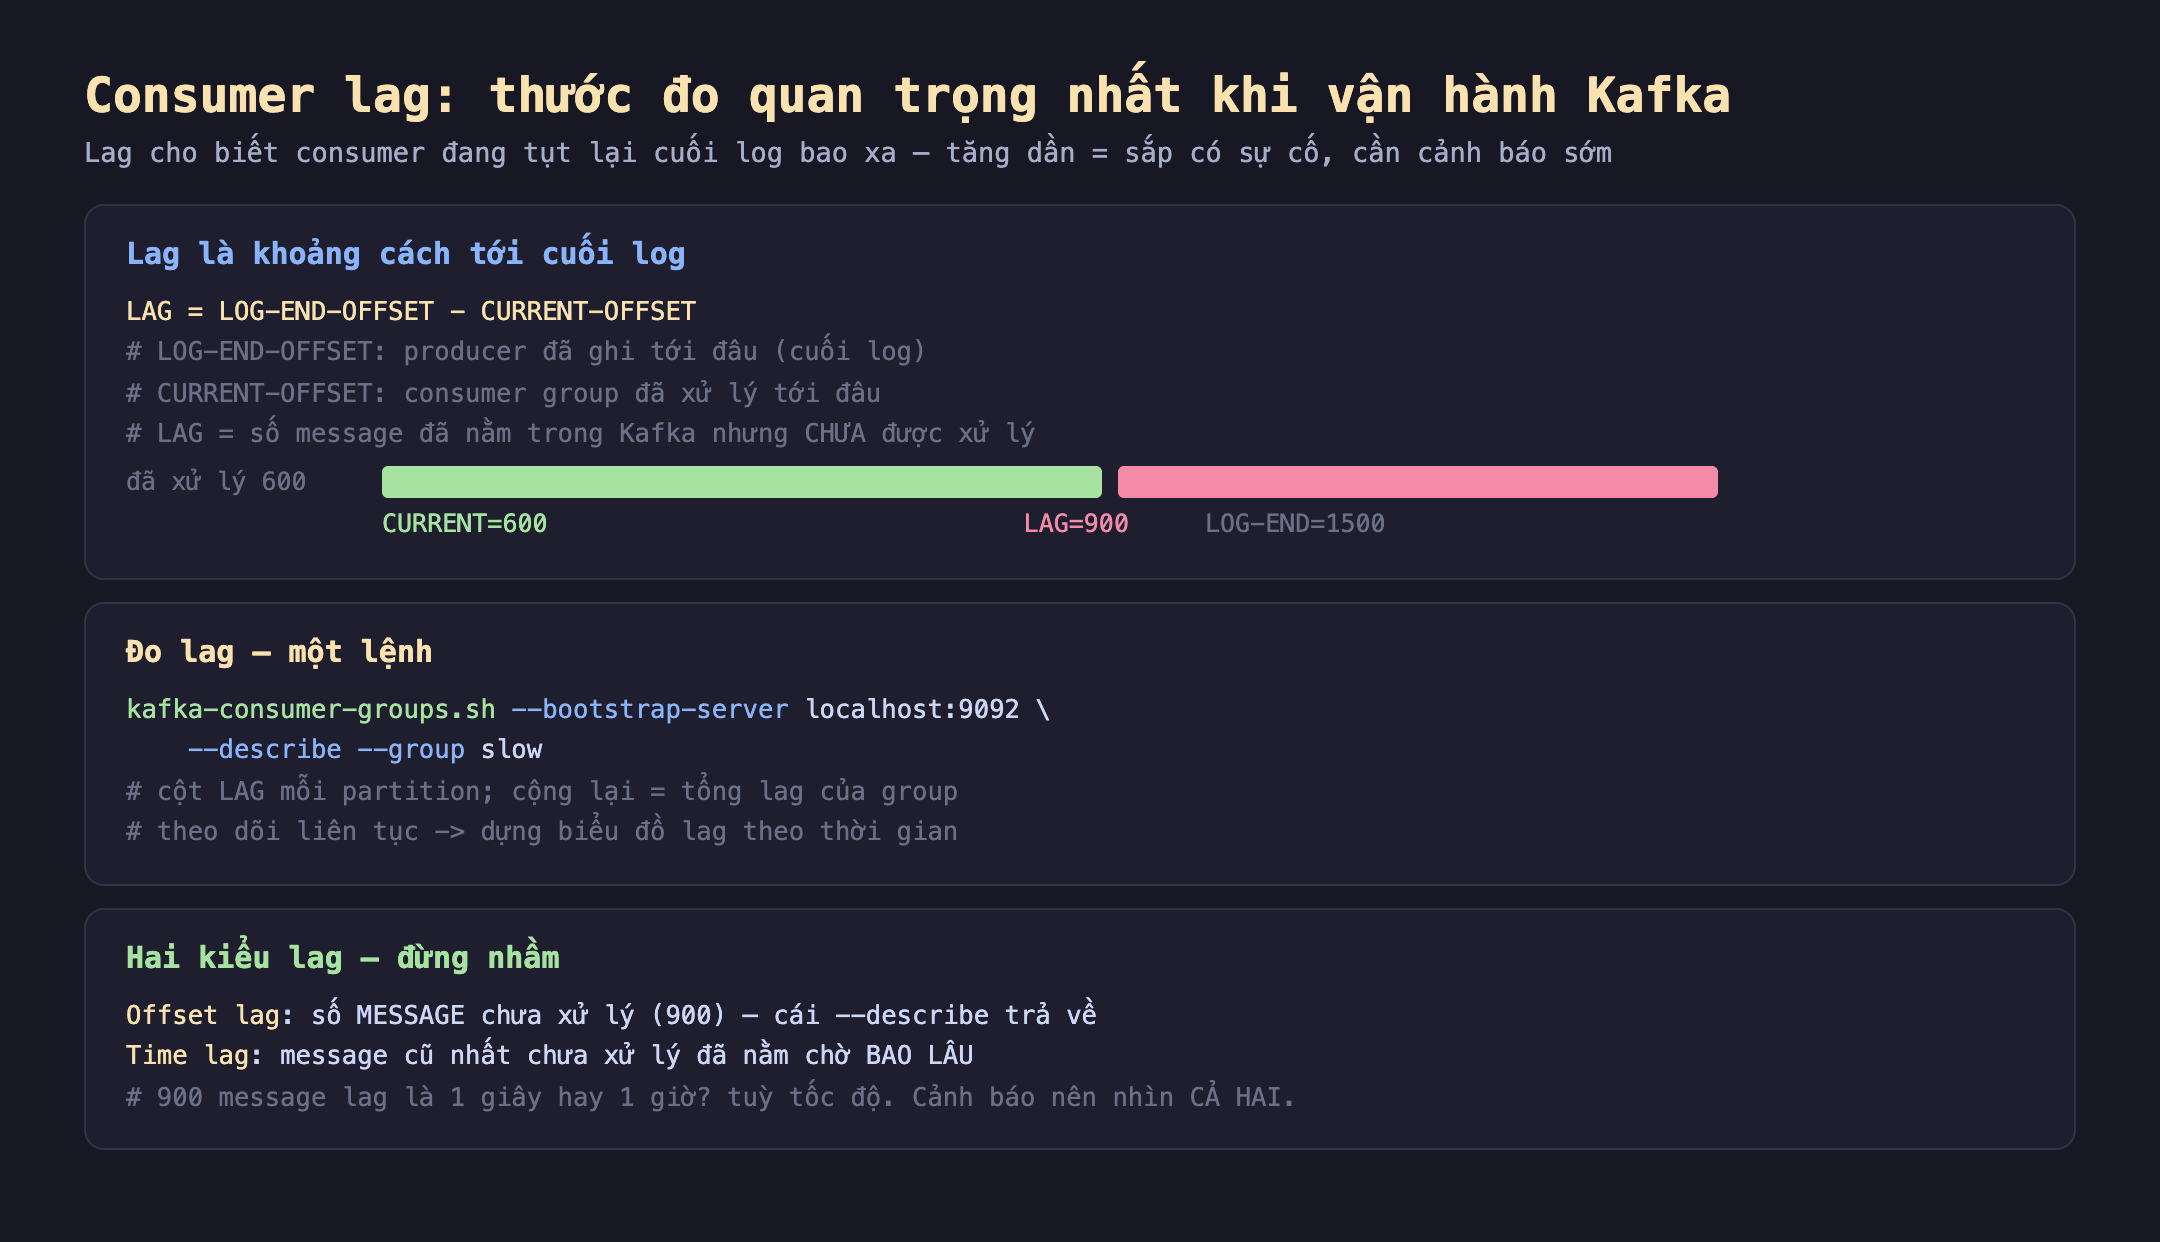
Hình 1: LAG = LOG-END-OFFSET − CURRENT-OFFSET. Đo bằng một lệnh kafka-consumer-groups.sh --describe. Phân biệt offset lag (số message chưa xử lý) với time lag (message cũ nhất chưa xử lý đã chờ bao lâu) — cảnh báo nên nhìn cả hai.
Đo lag chỉ cần một lệnh:
kafka-consumer-groups.sh --bootstrap-server localhost:9092 --describe --group slow
# cột LAG mỗi partition; cộng lại = tổng lag của group
Đo thật: lag phình ra rồi co lại
Mình dựng một kịch bản consumer chậm hơn producer, chụp lag ở từng bước:
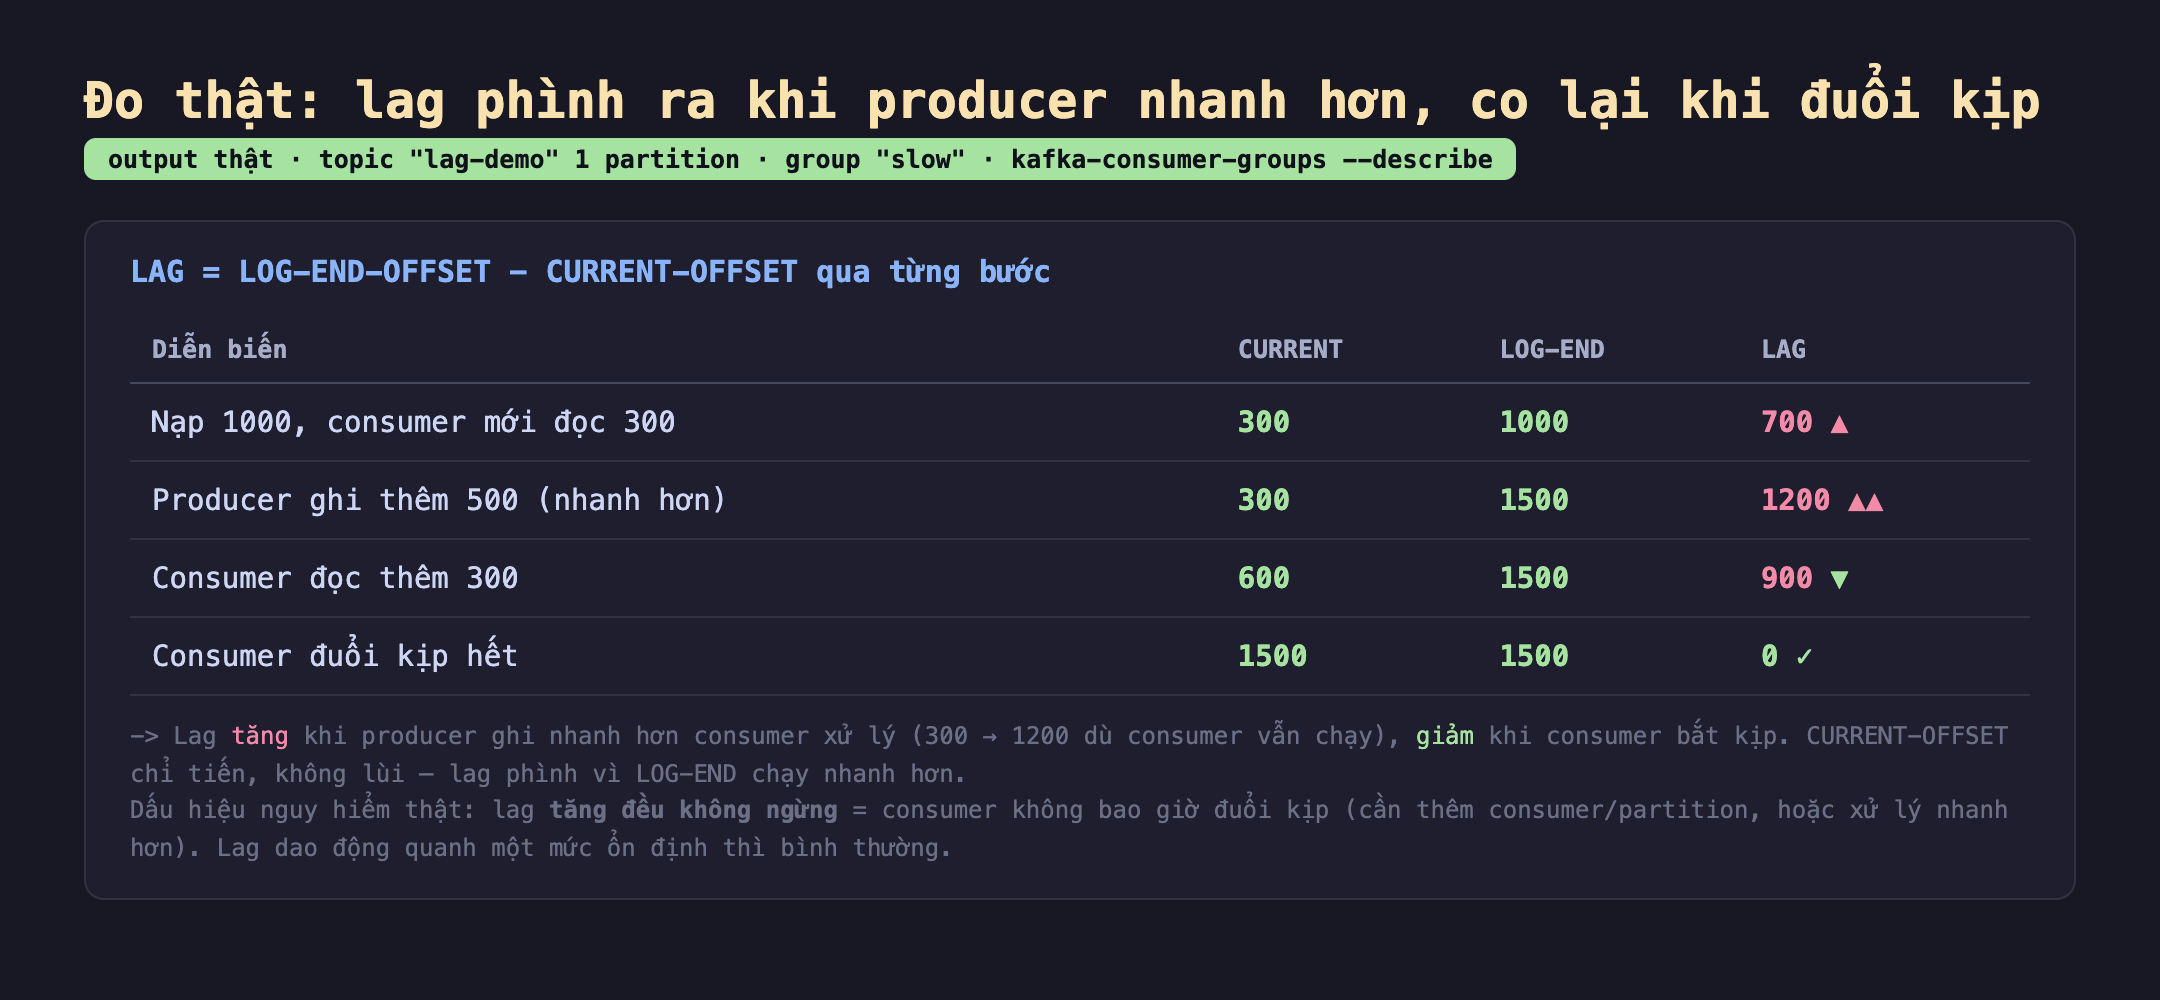
Hình 2: Đo thật. Nạp 1000, consumer đọc 300 → LAG 700. Producer ghi thêm 500 (tổng 1500) → LAG phình lên 1200. Consumer đọc thêm 300 → LAG co về 900. Consumer đuổi kịp hết → LAG 0. CURRENT-OFFSET chỉ tiến, lag phình vì LOG-END chạy nhanh hơn.
Diễn tiến thật, đọc từ --describe:
- Nạp 1000, consumer mới đọc 300: CURRENT=300, LOG-END=1000 → LAG=700. Còn 700 message chưa xử lý.
- Producer ghi thêm 500 (tổng 1500): CURRENT vẫn 300, LOG-END nhảy lên 1500 → LAG=1200. Lag phình to dù consumer không hề lùi — vì producer đẩy LOG-END đi nhanh hơn.
- Consumer đọc thêm 300: CURRENT=600, LOG-END=1500 → LAG=900. Consumer tiến, lag co lại một chút.
- Consumer đuổi kịp hết: CURRENT=1500 = LOG-END → LAG=0. Bắt kịp hoàn toàn.
Điểm cốt lõi: CURRENT-OFFSET chỉ tiến, không lùi — consumer luôn làm việc. Lag phình lên không phải vì consumer đi lùi, mà vì producer ghi nhanh hơn consumer xử lý. Đây chính là tín hiệu chẩn đoán: nếu bạn thấy lag tăng mà consumer vẫn đang chạy, vấn đề là tốc độ — consumer không đủ nhanh so với luồng vào.
Offset lag và time lag — đừng nhầm
--describe cho bạn offset lag: số message chưa xử lý (900). Nhưng con số này một mình gây hiểu nhầm: 900 message lag là nghiêm trọng hay không? Tuỳ tốc độ. Nếu consumer xử lý 10.000 message/giây thì 900 lag chỉ là 0,09 giây — chẳng sao. Nếu nó xử lý 10 message/giây thì 900 lag là 90 giây trễ — đáng lo.
Vì thế có khái niệm thứ hai: time lag — message cũ nhất chưa xử lý đã nằm chờ bao lâu. Đây mới là thứ phản ánh trải nghiệm thật ("dữ liệu của tôi trễ bao lâu?"). Các công cụ giám sát chuyên dụng (như Burrow, hoặc exporter cho Prometheus) tính được time lag; cảnh báo tốt nên nhìn cả hai — offset lag để thấy khối lượng tồn, time lag để thấy độ trễ thực tế.
Đánh đổi cần cân nhắc
Lag cao không phải lúc nào cũng xấu — xu hướng mới quan trọng. Một đợt tải đột biến (batch job ban đêm) làm lag vọt lên rồi tự giảm là bình thường. Cái đáng báo động là lag tăng đơn điệu không ngừng — dấu hiệu consumer vĩnh viễn không đuổi kịp. Cảnh báo nên dựa trên tốc độ tăng của lag hoặc time lag vượt ngưỡng, không phải một con số offset lag tuyệt đối (vốn phụ thuộc quy mô topic).
Lag tăng: tăng consumer chỉ hiệu quả tới số partition. Khi lag tăng vì consumer chậm, phản xạ đúng là thêm consumer vào group để xử lý song song (bài kafka-03). Nhưng nhớ trần: số consumer hữu dụng ≤ số partition. Nếu đã chạm trần mà vẫn lag, phải thêm partition (và chịu cái giá đổi ánh xạ key, bài kafka-02) hoặc làm consumer xử lý mỗi message nhanh hơn.
Lag có thể âm thầm biến thành mất dữ liệu. Nếu lag lớn tới mức consumer chưa kịp đọc message cũ nhất thì nó đã bị retention xoá (bài kafka-08), consumer sẽ nhảy tới offset còn tồn tại và bỏ qua phần đã mất — thường chỉ cảnh báo nhẹ. Đây là lý do giám sát lag so với retention là bắt buộc: lag không chỉ là "trễ", nó có thể thành "mất".
Ba ý mang về
- Lag = LOG-END-OFFSET − CURRENT-OFFSET là thước đo sức khoẻ số một. Đo thật: nó phình từ 700 lên 1200 khi producer ghi thêm nhanh hơn, co về 900 rồi 0 khi consumer đuổi kịp. Một lệnh
kafka-consumer-groups.sh --describecho ngay con số này. - Lag phình vì tốc độ, không vì consumer đi lùi. CURRENT-OFFSET chỉ tiến; lag tăng nghĩa là producer nhanh hơn consumer. Dấu hiệu nguy hiểm thật là lag tăng đều không ngừng — khi đó thêm consumer (tới trần partition), thêm partition, hoặc tối ưu xử lý.
- Nhìn cả offset lag lẫn time lag. 900 message lag là 1 giây hay 1 giờ tuỳ tốc độ xử lý — offset lag cho khối lượng tồn, time lag cho độ trễ thực. Và cảnh giác: lag quá lớn so với retention có thể biến thành mất dữ liệu, không chỉ trễ.
Nguồn
- Apache Kafka — Monitoring Consumer Lag: https://kafka.apache.org/documentation/#monitoring
- LinkedIn — Burrow: Kafka Consumer Lag Checking: https://github.com/linkedin/Burrow
- Confluent — Consumer lag and how to monitor it: https://developer.confluent.io/courses/kafka-consumers/consumer-lag/
Phần sau ta quay lại phía producer để tối ưu throughput: batch.size, linger.ms và compression ảnh hưởng tốc độ ghi thế nào, và đo thật đánh đổi giữa throughput và độ trễ khi gom batch.
