Ở phần 1 ta thấy Kafka giữ log nguyên vẹn, đọc lại được. Nhưng nếu log không bị xoá sau khi đọc, thì làm sao consumer biết đã xử lý tới đâu để không đọc lại từ đầu mỗi lần khởi động? Câu trả lời là offset — và cụ thể hơn là committed offset, cái "bookmark" mà mỗi consumer group lưu lại. Nghe đơn giản, nhưng offset là nơi quyết định một trong những đánh đổi quan trọng nhất của Kafka: chỗ bạn đặt lệnh commit chính là ranh giới giữa "mất dữ liệu khi crash" và "xử lý trùng khi crash". Bài này (phần 5/12) đo thật trạng thái offset và cách tua lại log.
Offset là bookmark của group, lưu trong Kafka
Mỗi cặp (group, partition) có một committed offset: số thứ tự message mà group đã xử lý tới. Điều quan trọng: offset này không nằm trong consumer (consumer có thể chết bất cứ lúc nào) — nó được lưu trong một topic nội bộ của Kafka tên __consumer_offsets. Nhờ vậy khi consumer khởi động lại, nó hỏi Kafka "group tôi đã đọc tới đâu?" và tiếp tục từ đó.
Ba con số bạn sẽ gặp liên tục khi vận hành:
- CURRENT-OFFSET: group đã commit (xử lý) tới đây.
- LOG-END-OFFSET: cuối log hiện tại (producer đã ghi tới đây).
- LAG = LOG-END-OFFSET − CURRENT-OFFSET: còn bao nhiêu message chưa xử lý (bài kafka-06 sẽ đào sâu lag).
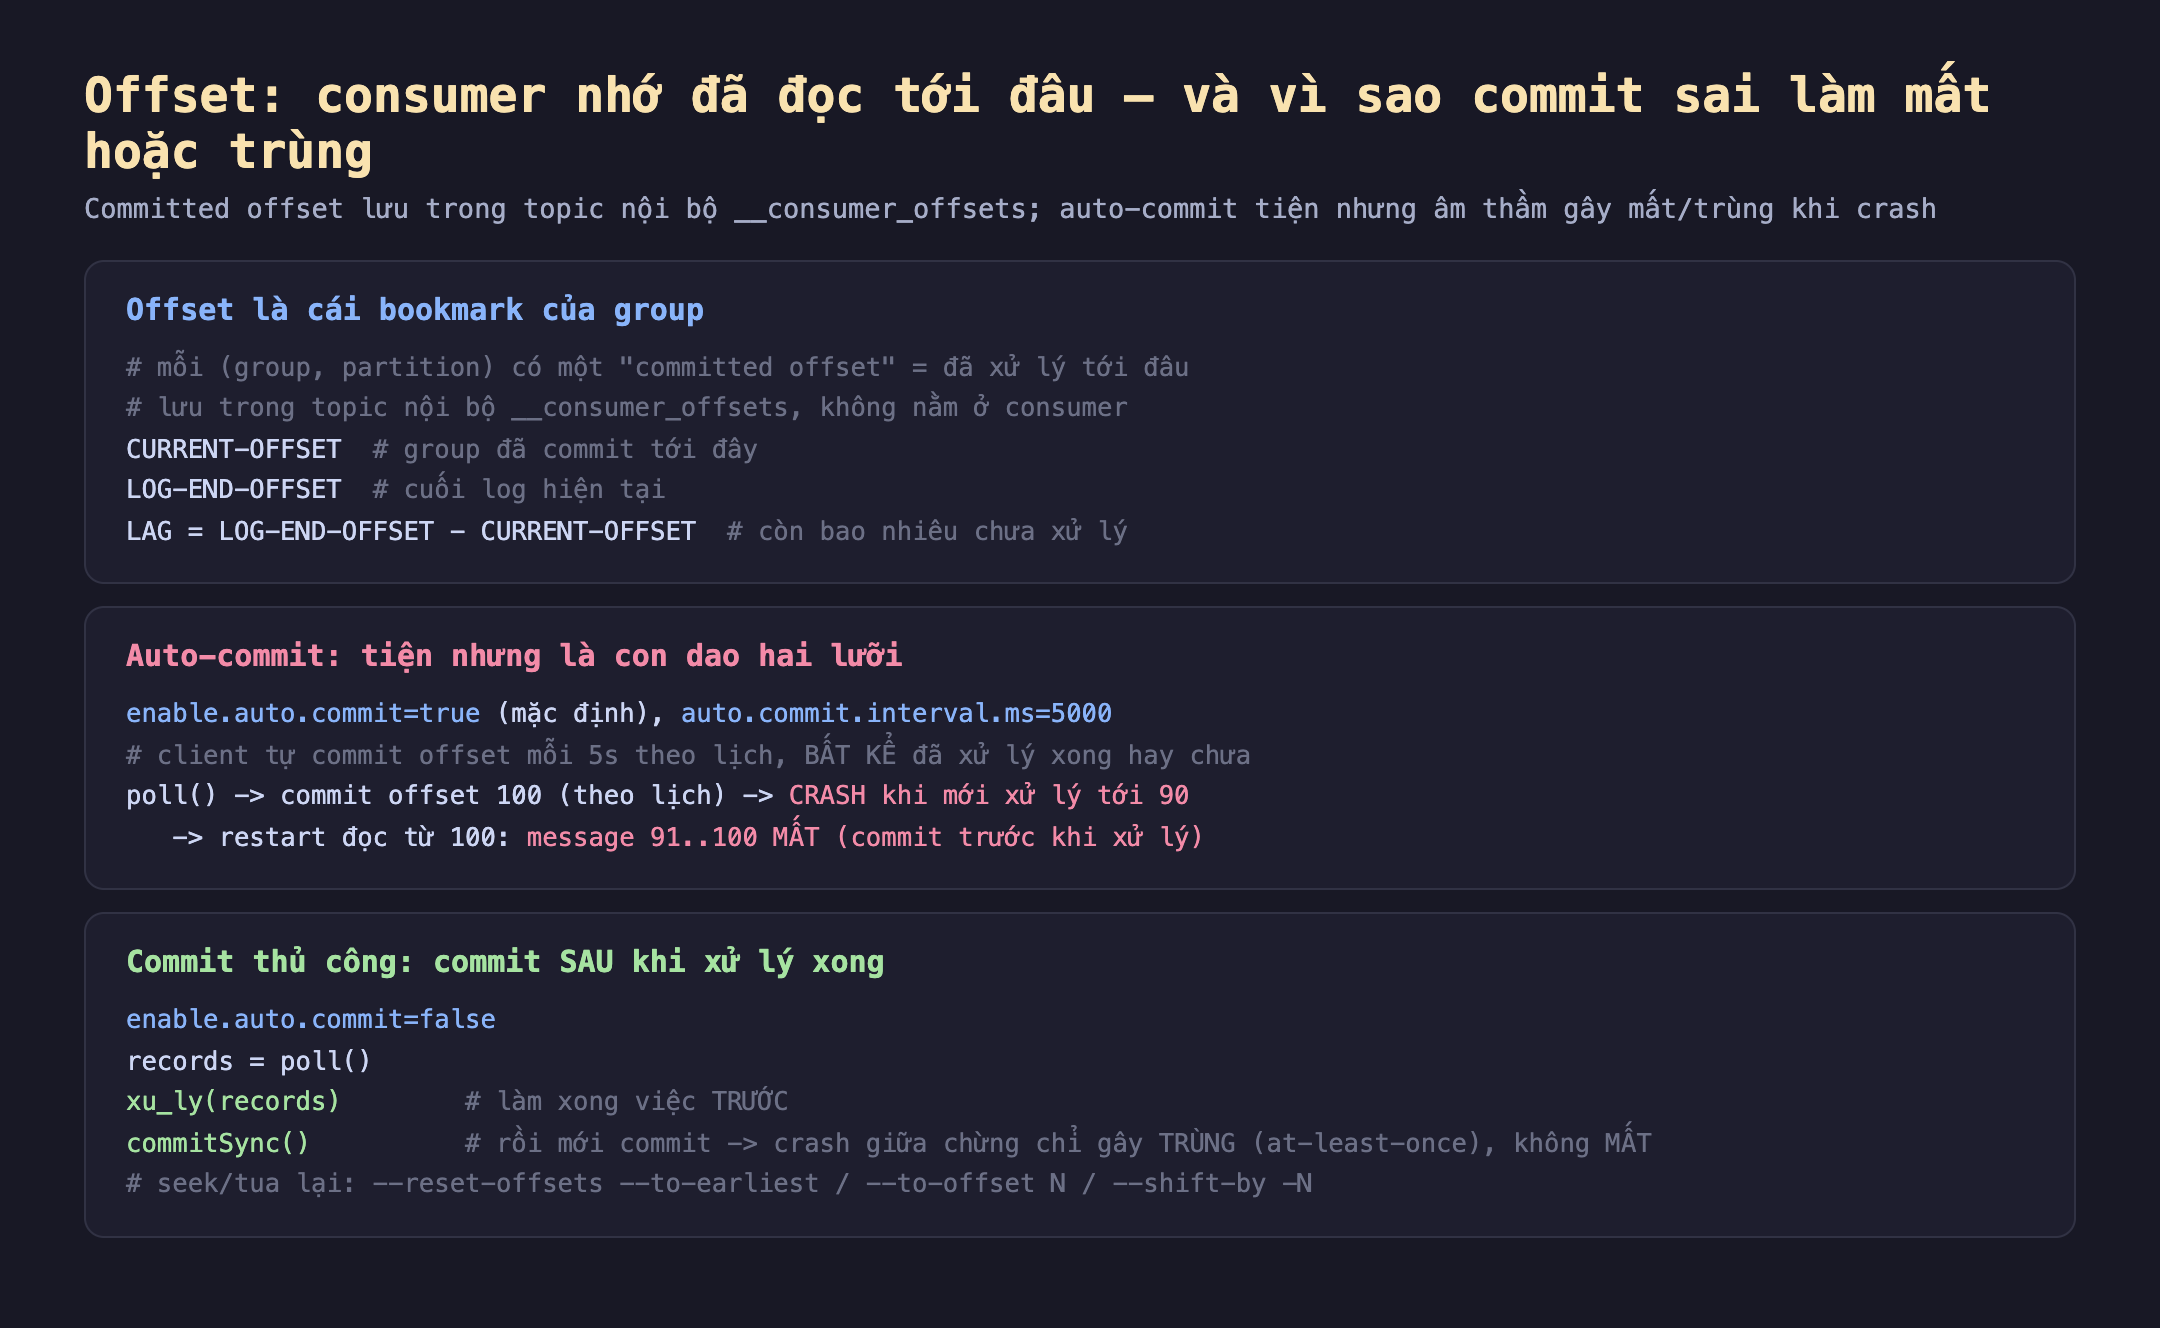
Hình 1: Committed offset lưu trong __consumer_offsets. Auto-commit (mặc định) commit theo lịch mỗi 5 giây, bất kể đã xử lý xong hay chưa — crash sau khi commit nhưng trước khi xử lý xong gây mất message. Commit thủ công sau khi xử lý xong chỉ gây trùng, không mất.
Đo thật: trạng thái offset
Mình nạp 100 message vào topic sk, cho group g1 đọc hết, rồi xem trạng thái:
kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic sk --group g1 --from-beginning
kafka-consumer-groups.sh --bootstrap-server localhost:9092 --describe --group g1
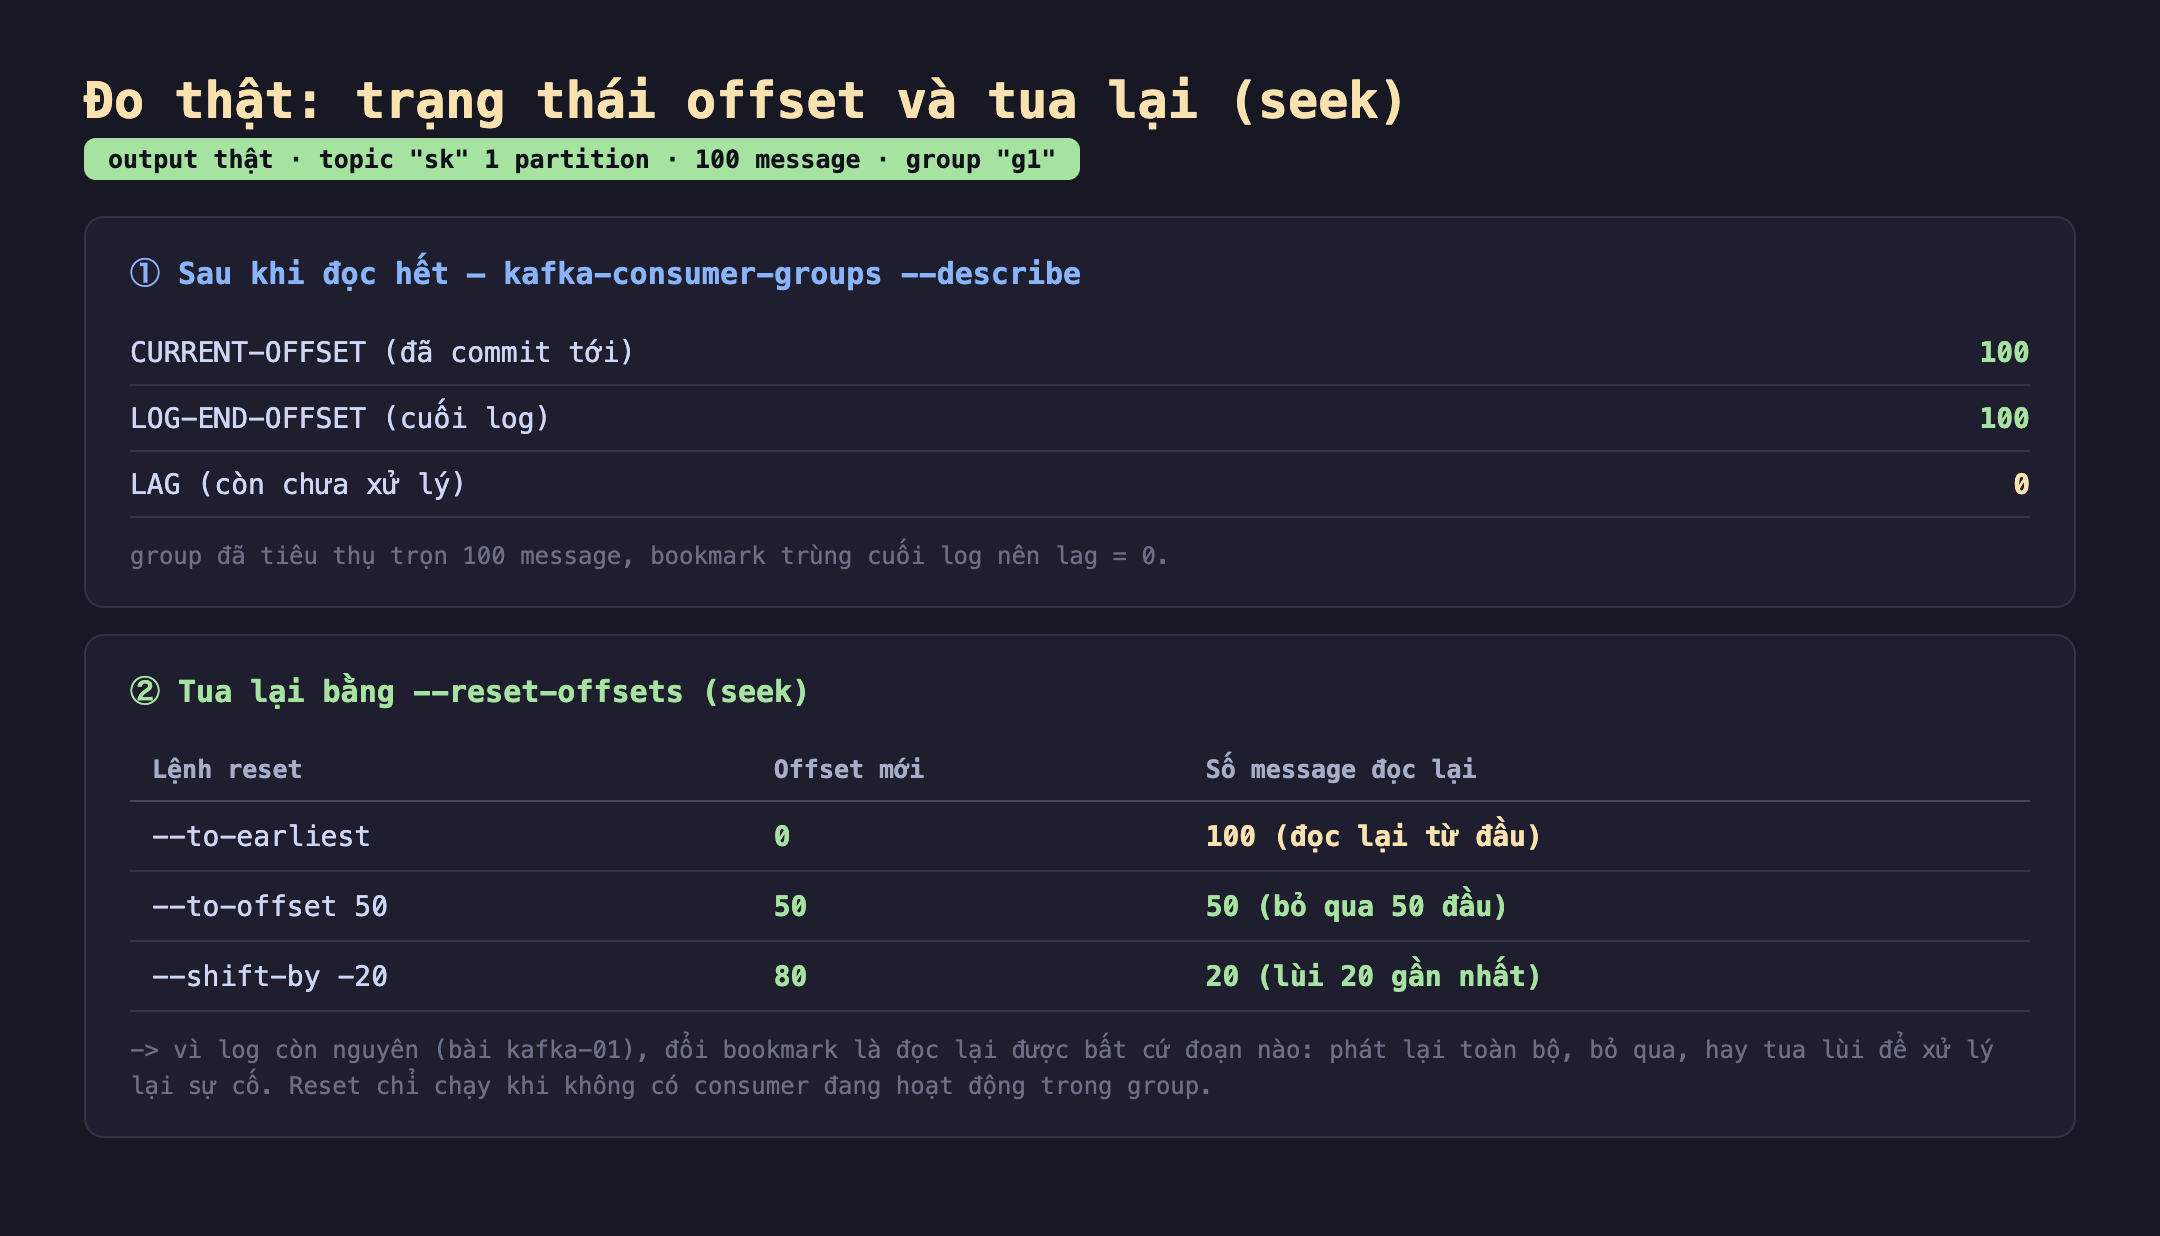
Hình 2: Đo thật. Sau khi đọc hết: CURRENT-OFFSET = LOG-END-OFFSET = 100, LAG = 0. Tua lại bằng --reset-offsets: về đầu (offset 0) đọc lại 100 message; tới offset 50 đọc 50; lùi 20 (offset 80) đọc 20. Log còn nguyên nên tua tới đâu cũng đọc lại được.
Sau khi group tiêu thụ trọn vẹn, CURRENT-OFFSET = LOG-END-OFFSET = 100 và LAG = 0 — bookmark trùng cuối log, không còn gì chưa xử lý.
Đo thật: tua lại log (seek)
Vì log không bị xoá sau khi đọc (bài kafka-01), ta có thể đổi bookmark để đọc lại bất cứ đoạn nào. Công cụ kafka-consumer-groups.sh --reset-offsets cho vài kiểu tua:
# về đầu — phát lại toàn bộ
kafka-consumer-groups.sh --group g1 --topic sk --reset-offsets --to-earliest --execute
# tới một offset cụ thể
kafka-consumer-groups.sh --group g1 --topic sk --reset-offsets --to-offset 50 --execute
# lùi tương đối
kafka-consumer-groups.sh --group g1 --topic sk --reset-offsets --shift-by -20 --execute
Kết quả đo thật khớp chính xác:
--to-earliest→ offset về 0, đọc lại 100 message (phát lại toàn bộ).--to-offset 50→ offset 50, đọc 50 message còn lại (bỏ qua 50 đầu).--shift-by -20→ từ 100 lùi về 80, đọc 20 message gần nhất (tua lùi).
Đây là siêu năng lực của Kafka cho vận hành: một bug xử lý sai dữ liệu ngày hôm qua? Sửa consumer, reset offset về thời điểm đó, phát lại. Một dịch vụ phân tích mới cần toàn bộ lịch sử? Tạo group mới, --to-earliest, đọc từ đầu. Queue truyền thống (đã xoá message) không làm được điều này. Lưu ý thực tế: --reset-offsets chỉ chạy khi không có consumer đang hoạt động trong group (nếu không sẽ xung đột với việc consumer tự quản offset).
Auto-commit: tiện lợi đánh đổi bằng rủi ro
Mặc định Kafka client bật enable.auto.commit=true, commit offset theo lịch mỗi auto.commit.interval.ms (mặc định 5 giây). Tiện — bạn không phải viết code commit. Nhưng nó commit theo đồng hồ, không theo tiến độ xử lý thật, và đó là cái bẫy:
- Mất message: client commit offset 100 theo lịch, rồi crash khi mới xử lý xong tới 90. Khi restart, group đọc từ 100 — message 91..100 không bao giờ được xử lý. Chúng đã bị "đánh dấu đã đọc" dù chưa xử lý.
- Ngược lại cũng có thể trùng: nếu crash xảy ra sau khi xử lý nhưng trước lần auto-commit kế, message đã xử lý sẽ được đọc lại.
Giải pháp cho công việc quan trọng là commit thủ công sau khi xử lý xong: tắt auto-commit (enable.auto.commit=false), poll() → xử lý xong → commitSync(). Khi đó, crash giữa chừng chỉ gây trùng (at-least-once, nối thẳng với bài kafka-04), không bao giờ mất — và trùng thì consumer idempotent xử lý được, còn mất thì không cứu được.
Đánh đổi cần cân nhắc
Commit từng message thì an toàn nhất nhưng chậm nhất. commitSync() sau mỗi message cho ranh giới hẹp nhất (ít trùng nhất khi crash), nhưng mỗi commit là một request tới broker — giết throughput. Thực tế người ta commit theo lô (sau mỗi N message hoặc mỗi vài trăm ms) để cân bằng; hoặc dùng commitAsync() cho nhanh và chấp nhận cửa sổ trùng rộng hơn. Chọn tần suất commit theo mức độ chịu-trùng của nghiệp vụ.
Reset offset trên production là thao tác nguy hiểm. --to-earliest trên một topic lớn khiến consumer đọc lại hàng triệu message — có thể gây quá tải downstream (ghi đè DB, gửi lại email). Luôn --dry-run trước (bỏ --execute) để xem offset sẽ đổi thế nào, và cân nhắc hậu quả phát lại với các side-effect không idempotent.
Offset gắn với group, không với consumer. Nhiều người nhầm rằng mỗi consumer có offset riêng. Không — offset thuộc group. Hai consumer cùng group chia nhau partition và cùng đóng góp vào bookmark của group. Muốn đọc độc lập (ví dụ một job backfill không ảnh hưởng pipeline chính), dùng một group.id khác.
Ba ý mang về
- Offset là bookmark của group, lưu trong Kafka. Đo thật: sau khi đọc 100 message, CURRENT-OFFSET = LOG-END-OFFSET = 100, LAG = 0. Nó sống trong
__consumer_offsetsnên consumer chết rồi sống lại vẫn đọc tiếp đúng chỗ. - Log còn nguyên nên tua lại được bất cứ đoạn nào. Đo thật:
--to-earliestđọc lại 100,--to-offset 50đọc 50,--shift-by -20đọc 20. Đây là siêu năng lực phát lại của Kafka — sửa bug rồi replay, hoặc backfill service mới từ đầu. - Chỗ đặt lệnh commit quyết định mất hay trùng. Auto-commit theo đồng hồ (mặc định) có thể mất message khi crash giữa commit và xử lý; commit thủ công sau khi xử lý xong biến rủi ro thành trùng (at-least-once) — an toàn hơn nhiều vì trùng cứu được, mất thì không.
Nguồn
- Apache Kafka — Consumer Configs (enable.auto.commit, auto.commit.interval.ms): https://kafka.apache.org/documentation/#consumerconfigs
- Apache Kafka — Offset Management & __consumer_offsets: https://kafka.apache.org/documentation/#impl_offsettracking
- Confluent — Kafka Consumer: committing offsets: https://docs.confluent.io/platform/current/clients/consumer.html
Phần sau ta đào sâu một con số sinh ra từ offset: consumer lag — cách đo độ trễ của consumer, vì sao nó tăng, và cách phát hiện sớm trước khi hệ thống tụt lại quá xa.
