Suốt mười một bài, chúng ta mổ xẻ Kafka từ bên trong: nó là một append-only log (không phải queue), partition cho song song, consumer group chia việc, delivery semantics, offset, lag, tuning, retention, replication, serialization, outbox. Mỗi bài kèm một phép đo thật trong lab — từ 527 nghìn message/giây trên một node tới Avro nhỏ hơn JSON 2,4 lần. Nhưng kiến thức rời rạc không giúp bạn ra quyết định. Câu hỏi thực tế mà một kỹ sư backend phải trả lời là: dự án của tôi có nên dùng Kafka không, và nếu có thì cấu hình thế nào cho đúng? Bài cuối này (phần 12/12) gộp mọi thứ thành hai công cụ ra quyết định: một so sánh để chọn công cụ, và một checklist để vận hành.
Khi nào dùng Kafka — và khi nào đừng
Sai lầm phổ biến nhất về Kafka không phải cấu hình sai — mà là dùng khi không cần. Kafka mạnh, nhưng là một hệ phân tán có trạng thái, tốn chi phí vận hành thật (cluster, giám sát, cân partition). Với nhiều bài toán, một hàng đợi đơn giản hơn là lựa chọn đúng.
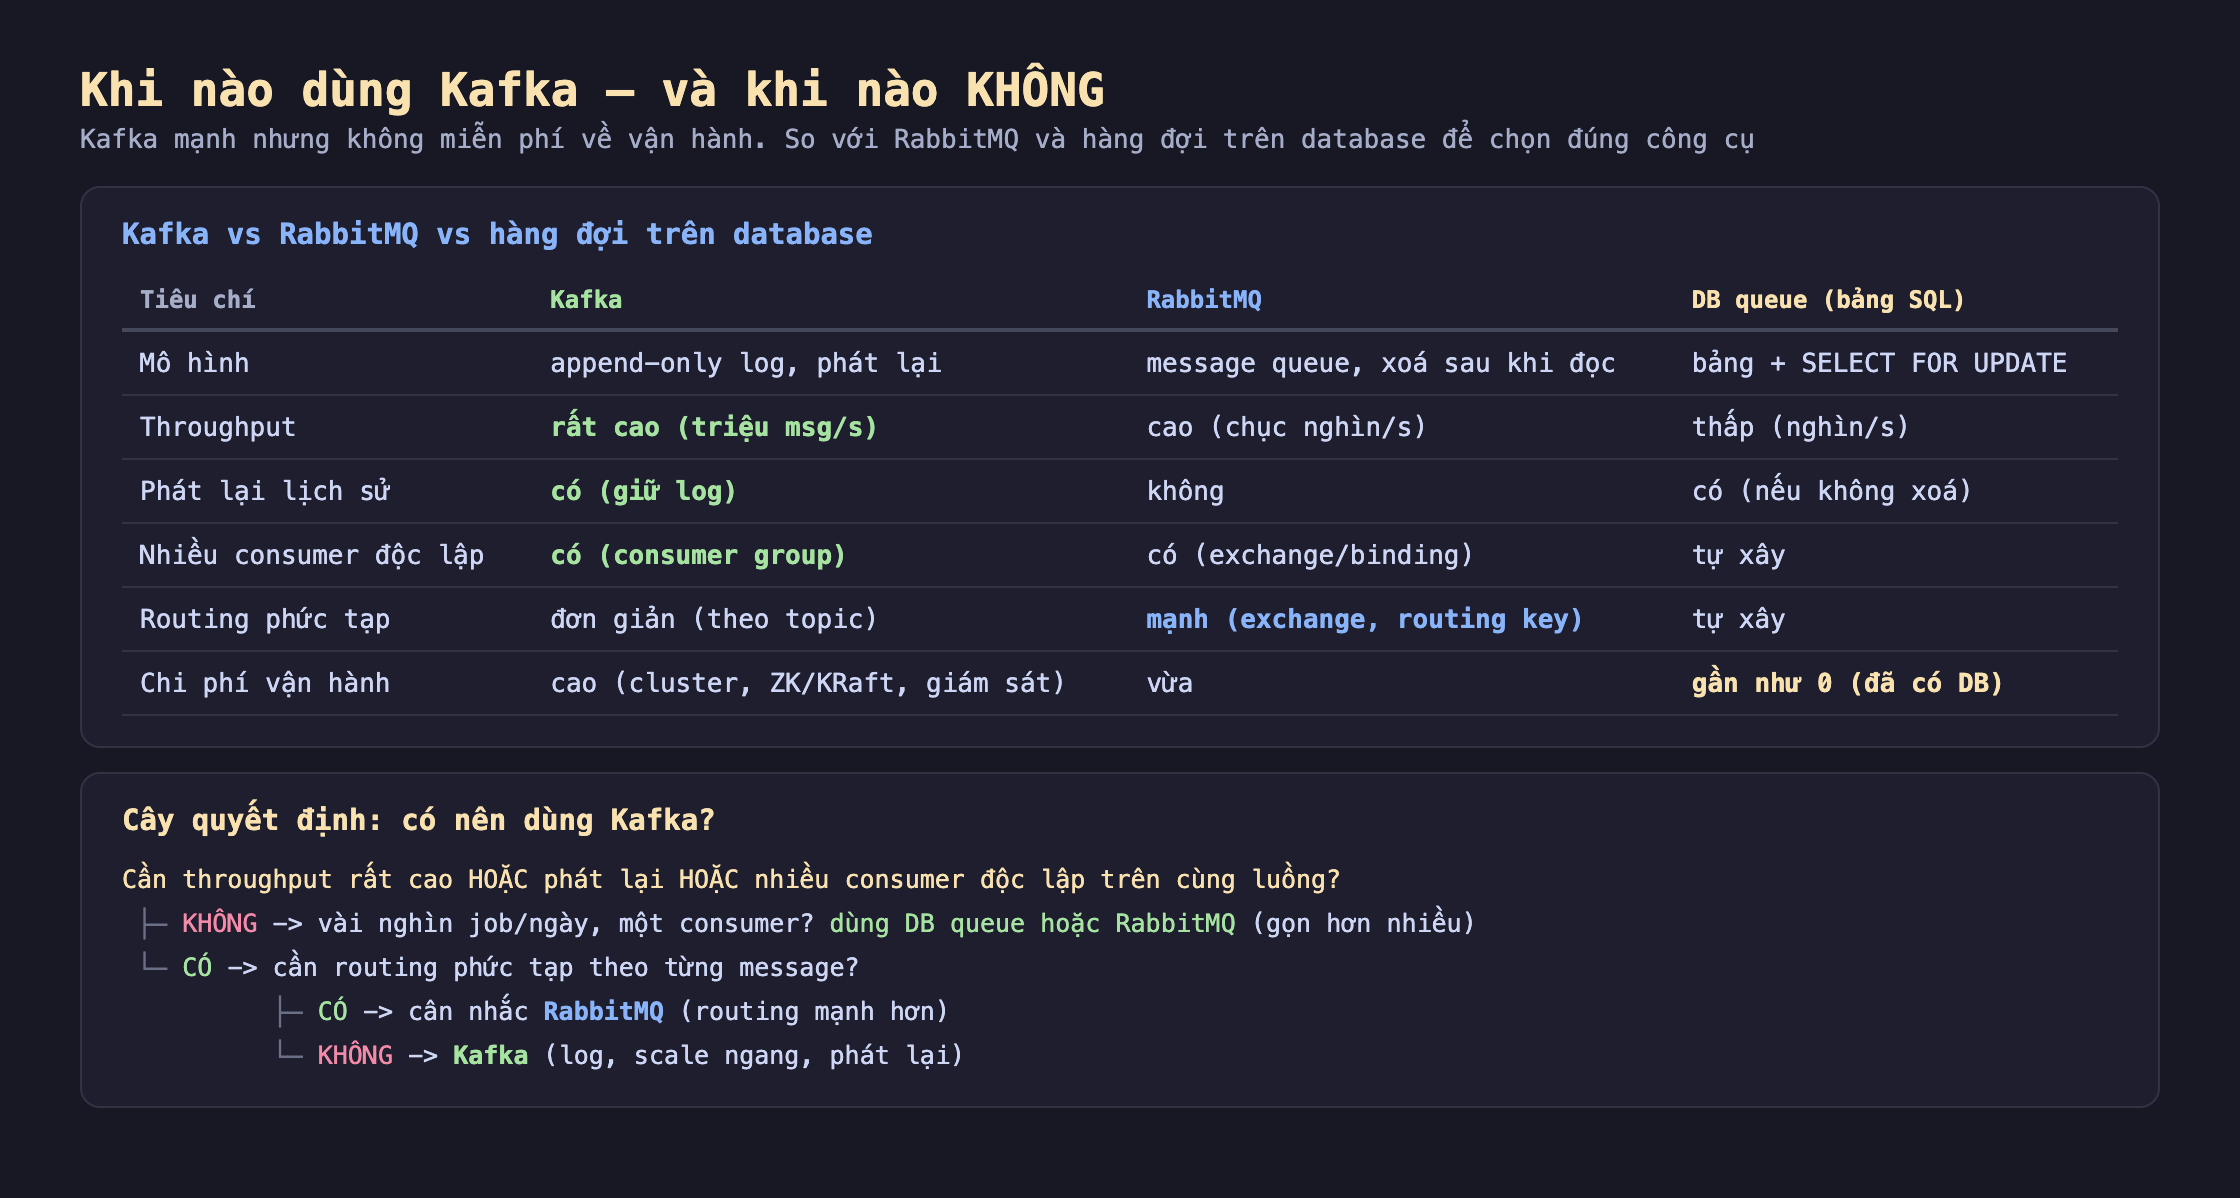
Hình 1: So sánh Kafka với RabbitMQ và hàng đợi trên database. Kafka thắng ở throughput, phát lại và nhiều consumer độc lập; RabbitMQ mạnh về routing phức tạp; hàng đợi DB gọn nhất khi khối lượng nhỏ. Cây quyết định giúp chọn đúng.
Đọc bảng so sánh, ba điểm quyết định:
- Kafka tỏa sáng khi: cần throughput rất cao (hàng trăm nghìn tới triệu message/giây — bài kafka-01/02), cần phát lại lịch sử (log không xoá — bài kafka-05/08), hoặc có nhiều consumer độc lập đọc cùng một luồng sự kiện (consumer group — bài kafka-03). Đây là những việc queue truyền thống làm khó hoặc không làm được.
- RabbitMQ hợp hơn khi: cần routing phức tạp theo từng message (exchange, routing key, priority), khối lượng cao nhưng không cực lớn, và không cần phát lại. RabbitMQ là một message broker đúng nghĩa với mô hình định tuyến mạnh mà Kafka (chỉ có topic) không có.
- Hàng đợi trên database hợp khi: khối lượng nhỏ (vài nghìn job/ngày), một hoặc ít consumer, và bạn đã có database. Một bảng
jobsvớiSELECT ... FOR UPDATE SKIP LOCKEDlà đủ, chi phí vận hành gần như bằng 0 — không cần dựng cả một cluster Kafka cho một hàng đợi gửi email.
Cây quyết định gói gọn: Có cần throughput rất cao HOẶC phát lại HOẶC nhiều consumer độc lập không? Nếu không — dùng DB queue hoặc RabbitMQ, gọn hơn nhiều. Nếu có — cần routing phức tạp theo message không? Có thì cân nhắc RabbitMQ; không thì Kafka là lựa chọn đúng.
Checklist vận hành và số liệu đã đo
Nếu đã quyết định dùng Kafka, đây là checklist đúc kết từ 11 bài — mỗi mục là một quyết định cấu hình đã được giải thích và đo:
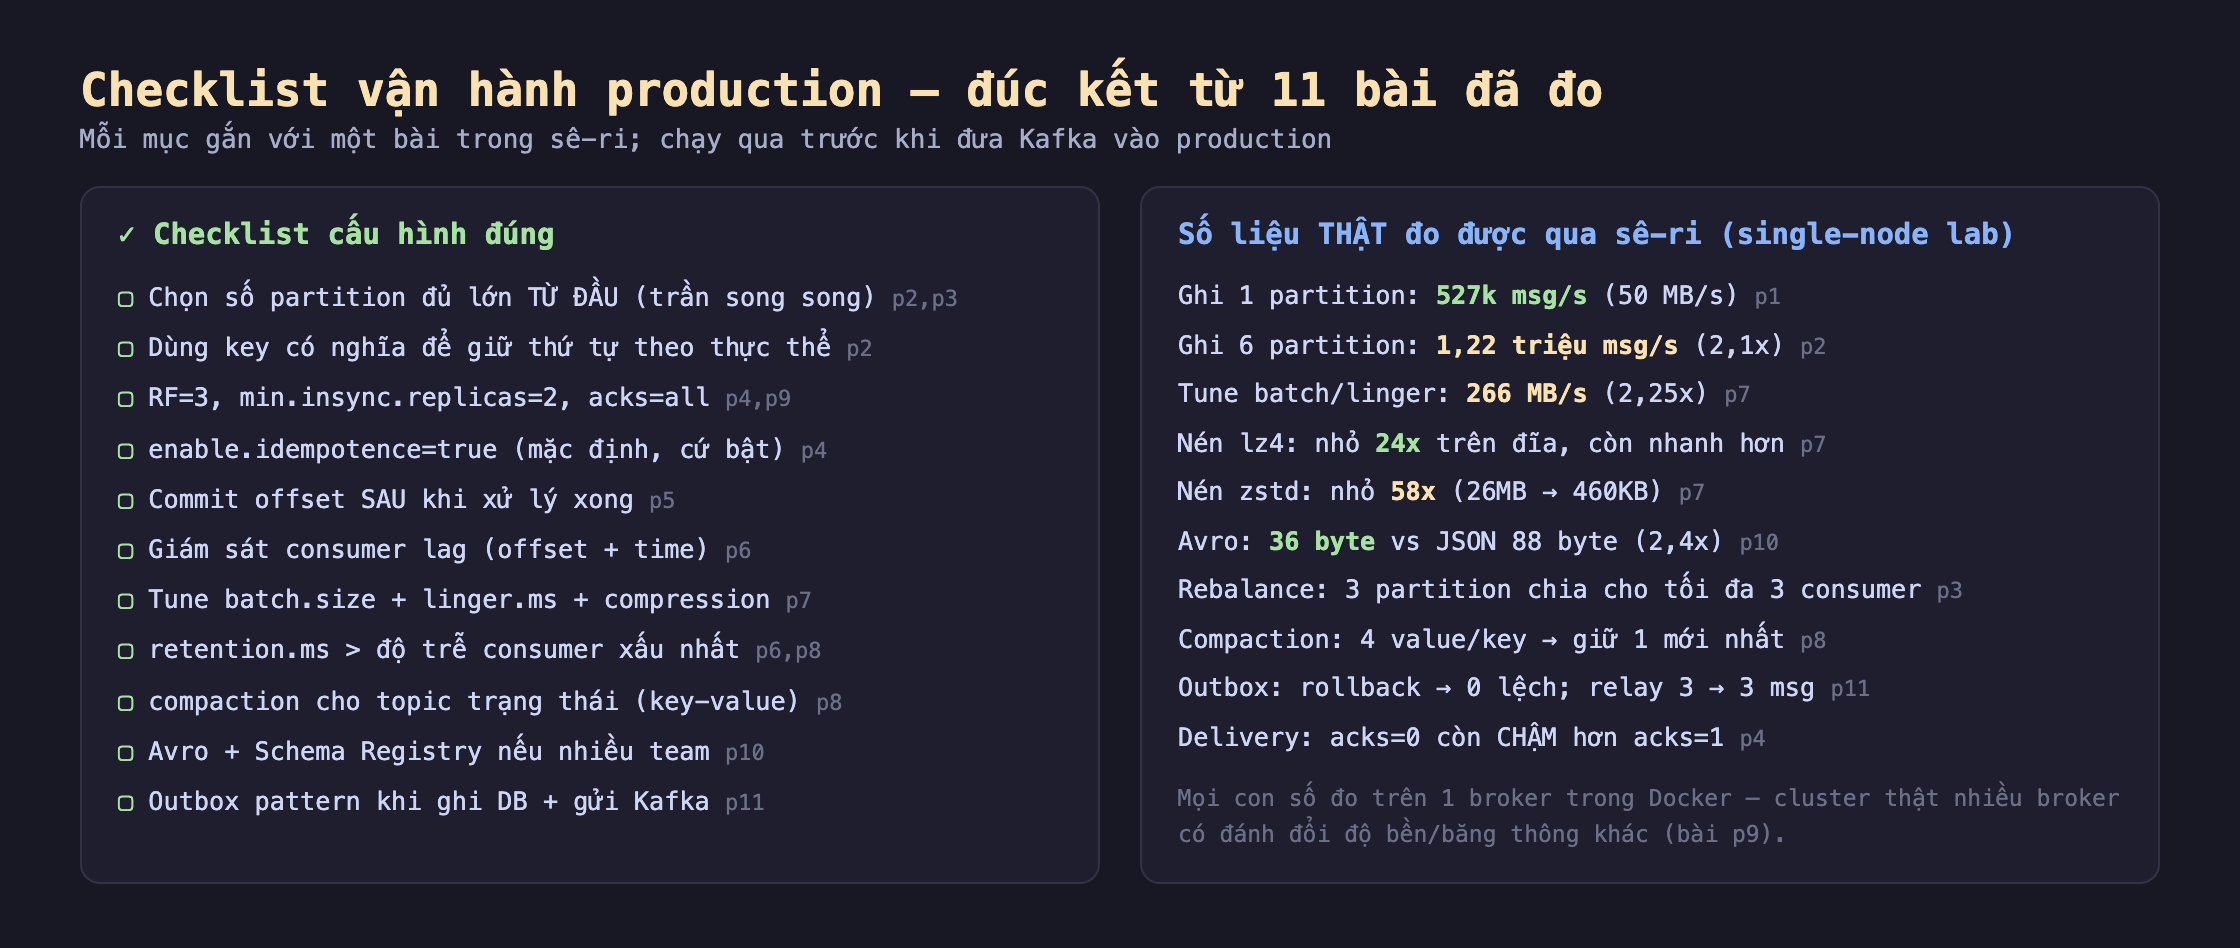
Hình 2: Bên trái — checklist cấu hình production, mỗi mục trỏ về bài tương ứng. Bên phải — tổng hợp số liệu thật đo được qua sê-ri (trên single-node lab): throughput, nén, serialization, rebalance, compaction, outbox.
Vài quyết định quan trọng nhất, nhắc lại ngắn gọn:
- Partition đủ lớn từ đầu (kafka-02/03): partition là trần song song của cả producer lẫn consumer, và đổi số partition sau phá vỡ ánh xạ key. Ước lượng dư một chút ngay từ đầu.
- Độ bền là bộ ba (kafka-04/09): RF=3 +
min.insync.replicas=2+acks=all, cộngenable.idempotence=true. Thiếu một mắt là có lỗ hổng mất dữ liệu. - Commit sau khi xử lý (kafka-05): auto-commit theo đồng hồ có thể mất message; commit thủ công sau xử lý biến rủi ro thành trùng (at-least-once) — cứu được.
- Giám sát lag (kafka-06): thước đo sức khoẻ số một; cảnh báo khi lag tăng đều không ngừng, và đảm bảo
retention.mslớn hơn độ trễ consumer xấu nhất để lag không biến thành mất dữ liệu. - Outbox cho tích hợp DB (kafka-11): đừng dual-write; ghi nghiệp vụ và sự kiện trong một transaction rồi relay.
Và các con số thật nhắc rằng Kafka nhanh: một node ghi 527 nghìn message/giây, 6 partition đạt 1,22 triệu/giây, nén zstd cắt đĩa 58 lần, Avro nhỏ hơn JSON 2,4 lần. Nhưng cũng nhắc phải đo chứ đừng đoán: acks=0 hoá ra còn chậm hơn acks=1, và min.insync.replicas=2 không chặn ghi trên single-node như nhiều người tưởng.
Vài sự thật cần giữ thẳng thắn
Mọi con số trong sê-ri đo trên một broker trong Docker. Chúng cho thấy bản chất cơ chế và trần trên một máy, nhưng cluster production nhiều broker có đánh đổi khác: acks=all thật sự tốn đồng bộ qua mạng (bài kafka-09), replication ngốn băng thông liên-broker, và rebalance trên group lớn đau hơn nhiều. Dùng số của lab để hiểu hướng, benchmark lại trên hạ tầng thật của bạn để lấy con số quyết định dung lượng.
Kafka không phải database, cũng không phải RPC. Một cám dỗ là biến Kafka thành nơi lưu trữ chính (query trực tiếp) hoặc kênh request-response đồng bộ. Cả hai đều lệch mục đích: Kafka là log sự kiện bất đồng bộ. Cần truy vấn linh hoạt thì đọc Kafka đổ vào một store phù hợp; cần request-response thì dùng RPC/HTTP. Dùng đúng vai trò của từng công cụ.
Vận hành Kafka là cam kết dài hạn. Dựng được một cluster Kafka chỉ là khởi đầu; giữ nó khỏe đòi hỏi giám sát lag, cân bằng partition, nâng cấp phiên bản, quản lý retention và dung lượng đĩa, xử lý rebalance. Nếu đội ngũ nhỏ và bài toán không thực sự cần sức mạnh của Kafka, chi phí vận hành này có thể lớn hơn lợi ích — và đó là lý do bảng so sánh ở Hình 1 bắt đầu bằng câu hỏi "bạn có thực sự cần không?".
Ba ý mang về
- Chọn công cụ trước, cấu hình sau. Kafka đúng khi cần throughput rất cao, phát lại, hoặc nhiều consumer độc lập; RabbitMQ cho routing phức tạp; hàng đợi DB cho khối lượng nhỏ. Dùng Kafka khi không cần là tự rước gánh nặng vận hành.
- Độ bền và đúng đắn là bộ cấu hình gắn kết, không phải một nút. Partition đủ lớn từ đầu, RF=3/min.insync=2/acks=all, idempotence, commit sau xử lý, giám sát lag, retention > lag, compaction cho state, Avro+Registry, outbox — mỗi mục đã được đo và giải thích; bỏ một mục thường mở một lỗ hổng.
- Đo chứ đừng đoán, và biết giới hạn của phép đo. Sê-ri này cho số thật (527k/s, 6 partition 2,1×, zstd 58×, Avro 2,4×) nhưng trên single-node Docker — chúng dạy cơ chế, không thay được benchmark trên cluster thật của bạn. Vài trực giác phổ biến (acks=0 nhanh nhất, min.insync chặn mọi lúc) đã bị chính phép đo bác bỏ.
Nguồn
- Apache Kafka — Documentation (toàn bộ): https://kafka.apache.org/documentation/
- Confluent — Kafka vs RabbitMQ & when to use what: https://www.confluent.io/blog/kafka-vs-rabbitmq-differences-use-cases/
- Martin Kleppmann — Designing Data-Intensive Applications (chương Stream Processing): https://dataintensive.net/
