Ở phần 1 ta thấy Kafka là một log có thể phát lại và nhanh một cách đáng kinh ngạc trên một node. Nhưng câu hỏi tiếp theo của mọi backend engineer là: scale thế nào? Và câu trả lời — cùng với nguồn gốc của gần như mọi hiểu lầm về Kafka — nằm ở một khái niệm: partition. Partition là đơn vị song song hoá của Kafka: nó cho phép một topic được ghi và đọc song song trên nhiều luồng, nhiều broker. Nhưng partition cũng áp đặt một ràng buộc tinh tế về thứ tự mà nếu không hiểu, bạn sẽ xây một hệ thống chạy sai một cách khó lần. Bài này (phần 2/12) đo thật cả hai mặt: thứ tự và throughput.
Key quyết định partition
Một topic chia thành N partition. Khi producer gửi một message có key, Kafka quyết định partition bằng một phép băm đơn giản:
partition = murmur2(key) % số-partition
Hệ quả quan trọng nhất: cùng một key luôn rơi vào cùng một partition (miễn số partition không đổi). Điều này cực kỳ hữu ích — nếu bạn dùng user_id làm key, thì mọi sự kiện của một user sẽ nằm trên cùng một partition, theo đúng thứ tự xảy ra. Nếu key là null, Kafka chia vòng (round-robin/sticky) và bạn mất đảm bảo thứ tự theo key.
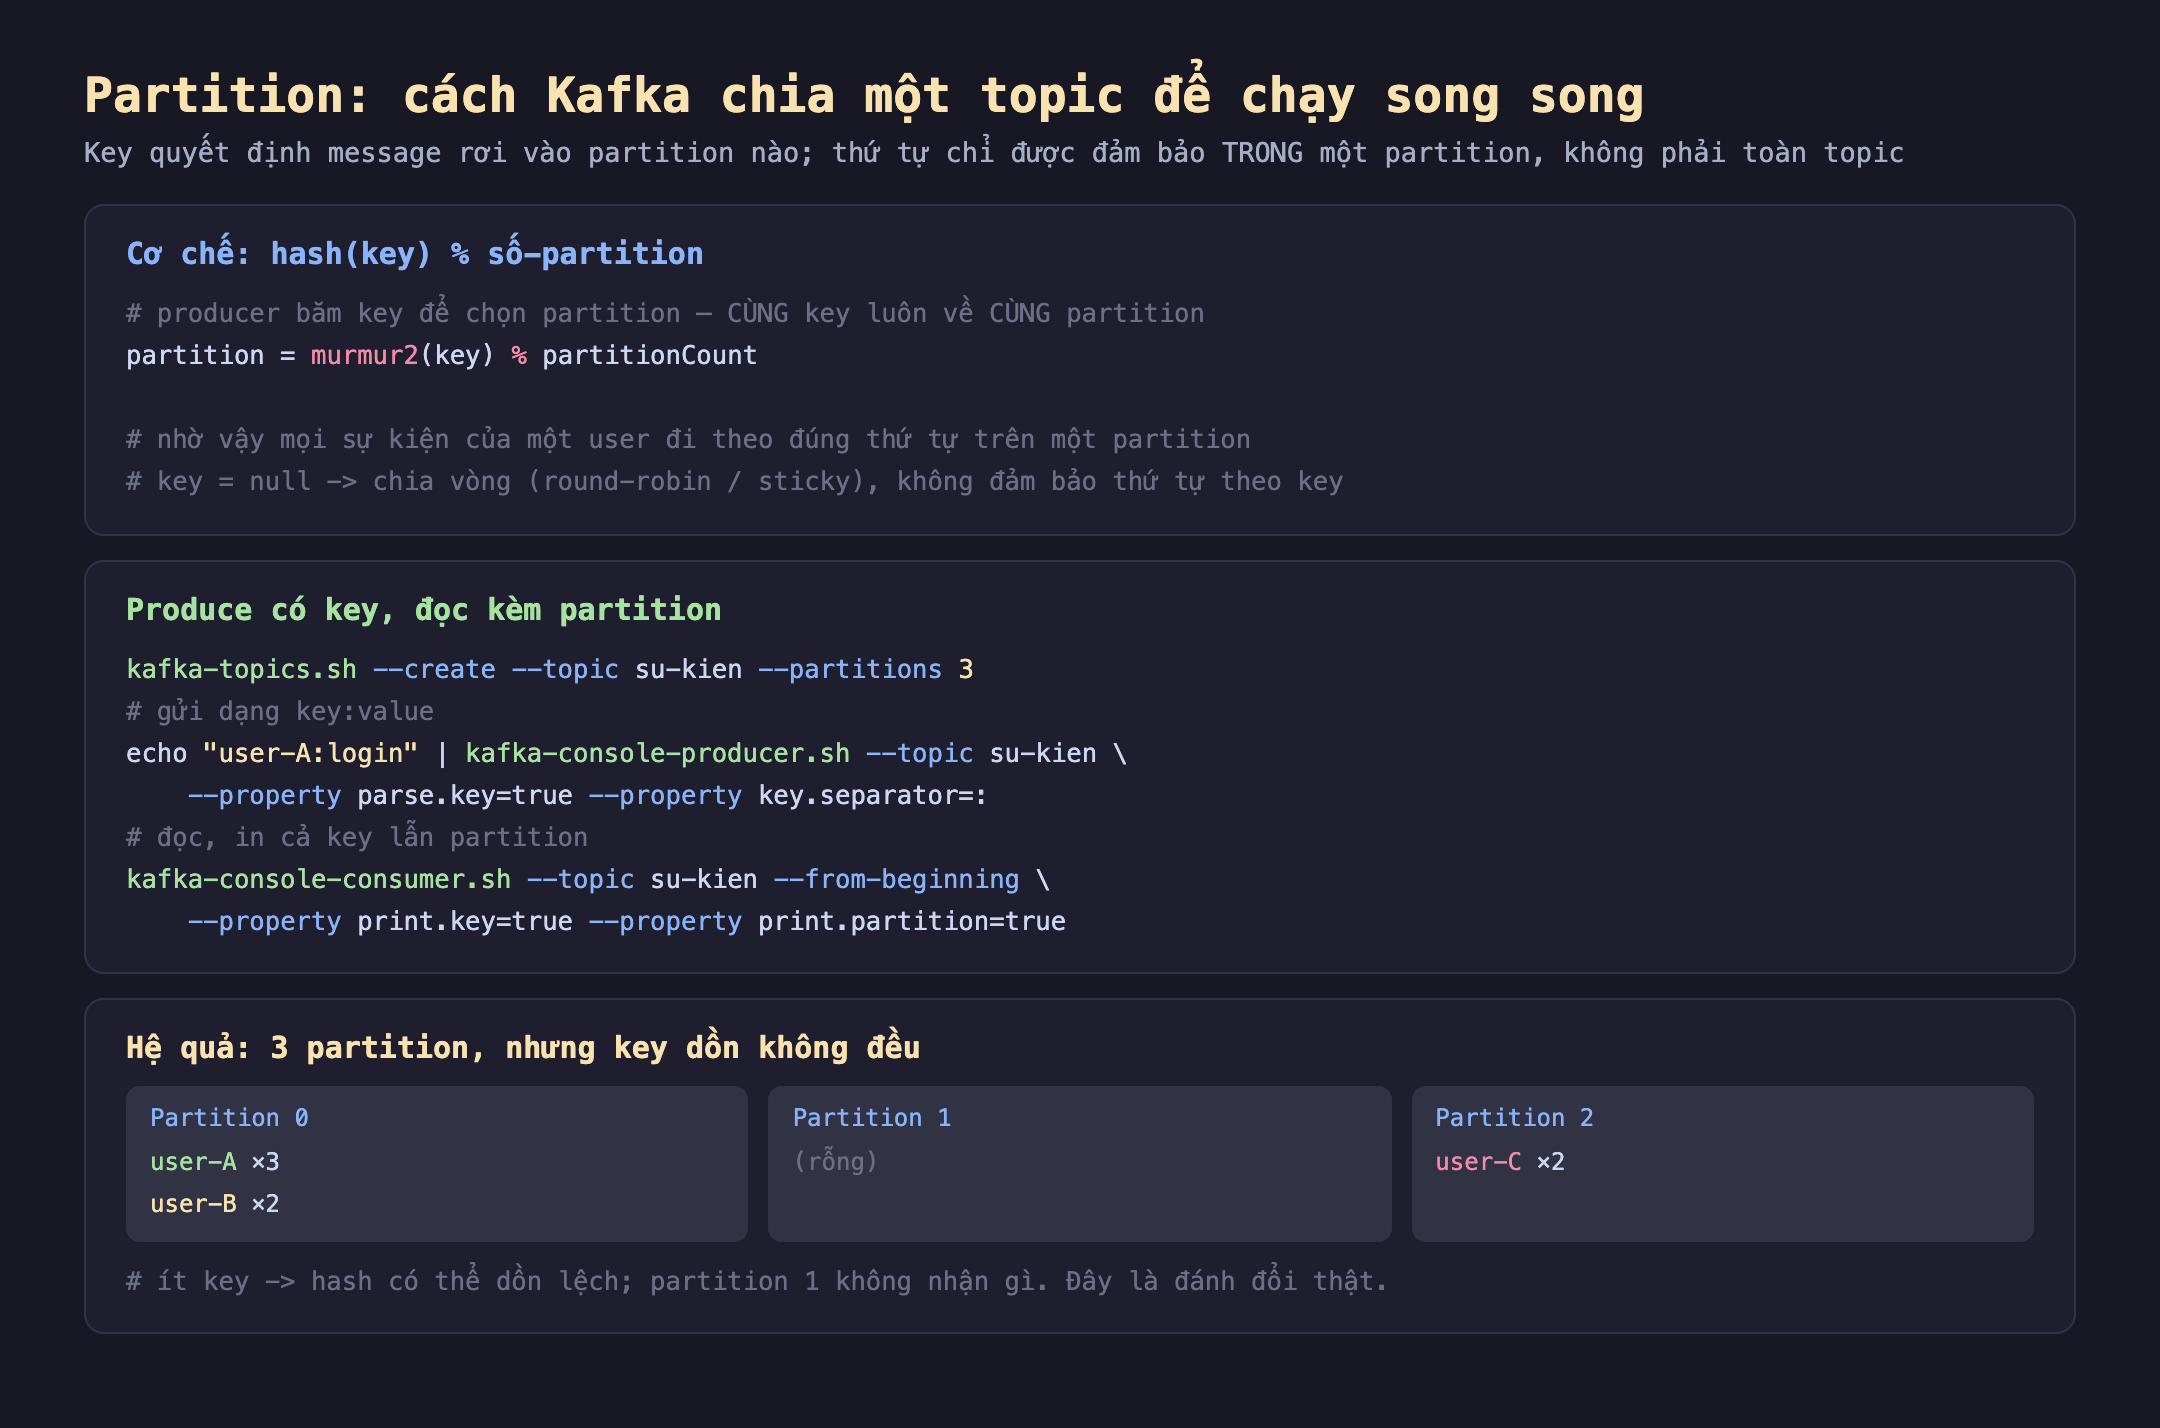
Hình 1: Producer băm key (murmur2) rồi chia lấy dư cho số partition — cùng key về cùng partition. Đo thật với 3 partition và 3 key: user-A và user-B đều rơi vào partition 0, user-C vào partition 2, partition 1 rỗng. Ít key thì phân bố dễ lệch.
Lệnh để quan sát điều này rất gọn — gửi message dạng key:value rồi đọc kèm partition:
kafka-topics.sh --bootstrap-server localhost:9092 --create --topic su-kien --partitions 3

printf "user-A:login\nuser-B:click\nuser-A:logout\nuser-C:buy\n" \
  | kafka-console-producer.sh --bootstrap-server localhost:9092 --topic su-kien \
      --property parse.key=true --property key.separator=:

kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic su-kien --from-beginning \
  --property print.key=true --property print.partition=true
Đo thật: thứ tự chỉ trong một partition
Đây là điểm khiến nhiều người vấp. Kafka chỉ đảm bảo thứ tự bên trong một partition, không phải trên toàn topic. Đọc riêng partition 0 theo offset cho thấy rõ: các sự kiện của user-A (login → logout → search) nằm đúng thứ tự gửi, xen kẽ với user-B nhưng trật tự tương đối của từng key được giữ nguyên.
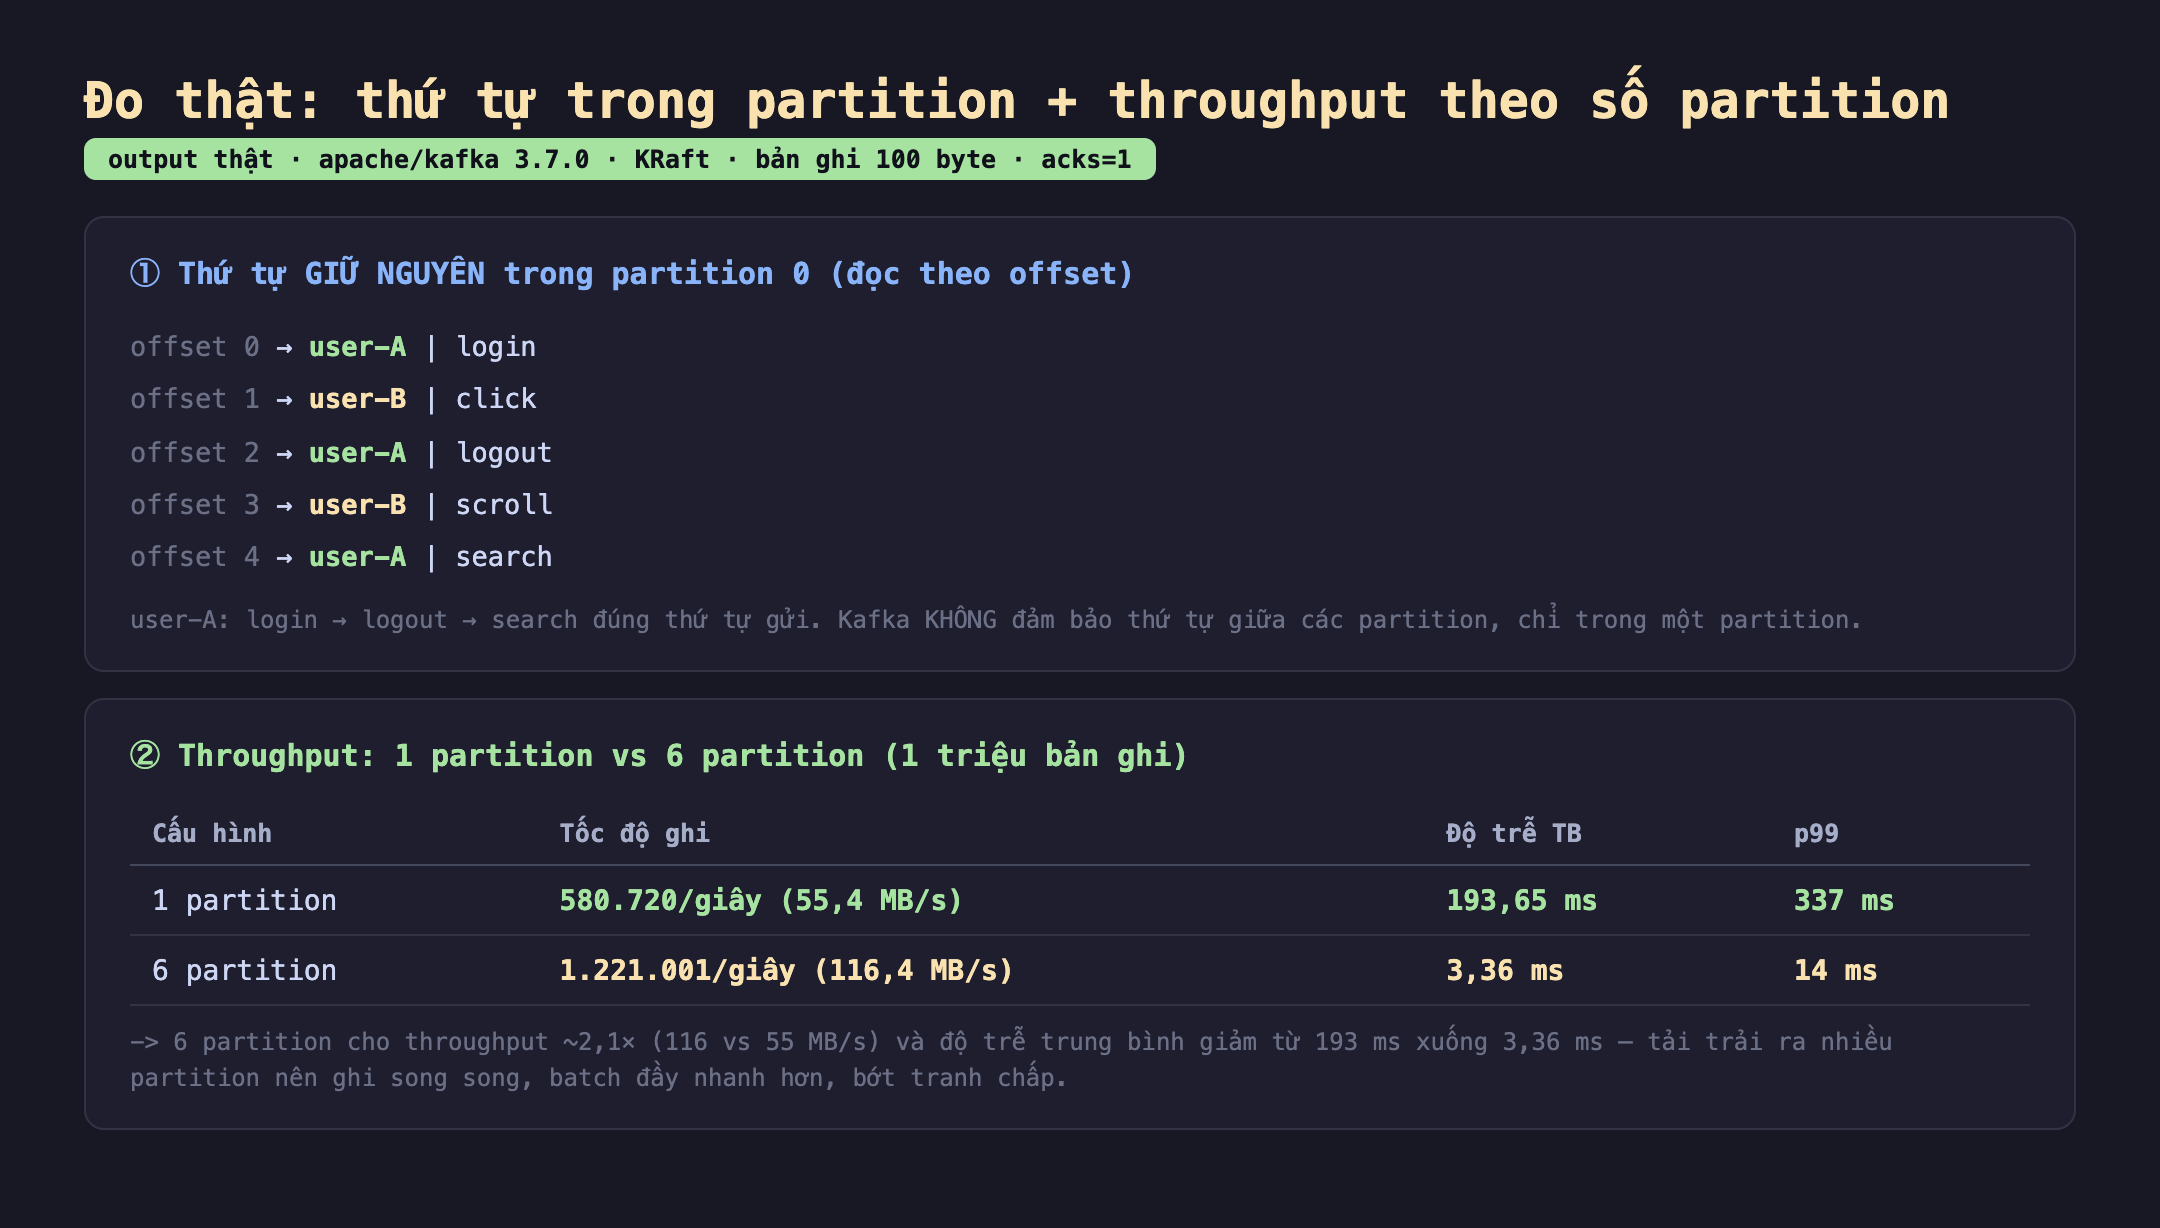
Hình 2: Đo thật. Trên — đọc partition 0 theo offset: user-A giữ đúng login → logout → search dù xen kẽ user-B. Dưới — throughput 1 partition (580.720/giây, 55,4 MB/giây, độ trễ 193 ms) so với 6 partition (1.221.001/giây, 116,4 MB/giây, độ trễ 3,36 ms).
Thực tế đo được trên partition 0 (các offset tăng dần): user-A|login (offset 0), user-B|click (1), user-A|logout (2), user-B|scroll (3), user-A|search (4). Nếu bạn cần xử lý các sự kiện của một user theo đúng trình tự (ví dụ: tạo đơn → thanh toán → giao hàng), phải dùng cùng một key cho chúng, để chúng vào cùng partition. Rải chúng ra nhiều partition là mời gọi xử lý sai thứ tự.
Đo thật: nhiều partition = nhiều throughput
Partition không chỉ để giữ thứ tự — nó là cơ chế scale. Mình chạy cùng một tải (1 triệu bản ghi 100 byte, acks=1) lên hai topic: một có 1 partition, một có 6 partition:
- 1 partition: 580.720 bản ghi/giây (55,4 MB/giây), độ trễ trung bình 193,65 ms, p99 337 ms.
- 6 partition: 1.221.001 bản ghi/giây (116,4 MB/giây), độ trễ trung bình 3,36 ms, p99 14 ms.
Sáu partition cho throughput ~2,1 lần và — bất ngờ hơn — độ trễ trung bình giảm mạnh từ 193 ms xuống 3,36 ms. Lý do: khi tải trải ra 6 partition, producer ghi song song vào nhiều log, mỗi partition nhận ít dữ liệu hơn nên batch đầy và được flush nhanh hơn, giảm thời gian chờ và tranh chấp. Đây là minh chứng cụ thể cho câu "partition là đơn vị song song của Kafka": thêm partition là cách chính để tăng thông lượng (phía consumer cũng vậy — bài kafka-03 sẽ đo khi nhiều consumer chia nhau partition).
Đánh đổi cần cân nhắc
Ít key thì phân bố partition dễ lệch. Trong demo thứ tự, 3 key rơi vào chỉ 2 partition (user-A và user-B cùng vào partition 0), partition 1 không nhận gì. Đây là bản chất của hàm băm trên tập key nhỏ — nó không hứa phân bố đều, chỉ hứa nhất quán (cùng key → cùng partition). Với dữ liệu thật hàng triệu key khác nhau, phân bố sẽ đều hơn; nhưng nếu một key chiếm phần lớn lưu lượng ("hot key" — ví dụ một user khổng lồ), partition của nó thành điểm nghẽn. Chọn key cần cân nhắc cả thứ tự lẫn độ đều.
Thêm partition sau này làm hỏng ánh xạ key → partition. Vì partition = hash(key) % N, đổi N là mọi key có thể nhảy sang partition khác. Message cũ của một key nằm ở partition này, message mới nhảy sang partition kia — thứ tự theo key bị phá vỡ kể từ thời điểm thêm partition. Vì thế hãy ước lượng số partition đủ lớn từ đầu; tăng partition trên topic đang chạy là thao tác cần rất thận trọng.
Nhiều partition không miễn phí. Mỗi partition là file + bộ nhớ + kết nối trên broker, và tốn chi phí khi bầu lại leader lúc có sự cố. Hàng chục nghìn partition trên một cluster làm tăng thời gian phục hồi và tải metadata. Chọn số partition theo throughput cần và số consumer song song dự kiến, không phải "càng nhiều càng tốt".
Ba ý mang về
- Key quyết định partition, và đó là cách bạn kiểm soát thứ tự. Đo thật: cùng key (
user-A) luôn vào cùng partition, giữ đúng thứ tự login → logout → search. Cần thứ tự cho một thực thể thì dùng id của nó làm key; keynullthì mất đảm bảo đó. - Thứ tự chỉ trong một partition, không phải toàn topic. Kafka không sắp xếp giữa các partition. Thiết kế consumer với giả định này — nếu logic cần thứ tự toàn cục, bạn đang chống lại mô hình của Kafka (hoặc phải dùng 1 partition và hy sinh song song).
- Partition là đòn bẩy throughput, nhưng có đánh đổi. Đo thật: 6 partition cho ~2,1× throughput (116 vs 55 MB/giây) và độ trễ giảm mạnh. Đổi lại: ít key dễ lệch tải, đổi số partition phá vỡ ánh xạ key, và quá nhiều partition tốn tài nguyên broker.
Nguồn
- Apache Kafka — Documentation: Topics and Partitions: https://kafka.apache.org/documentation/#intro_concepts_and_terms
- Apache Kafka — Producer: partitioner & ordering guarantees: https://kafka.apache.org/documentation/#producerconfigs
- Confluent — How to choose the number of topics/partitions in a Kafka cluster: https://www.confluent.io/blog/how-choose-number-topics-partitions-kafka-cluster/
Phần sau ta mổ xẻ consumer group: nhiều consumer chia nhau partition của một topic để xử lý song song, điều gì xảy ra khi thêm/bớt consumer, và vì sao "rebalance" vừa là sức mạnh vừa là cơn đau của Kafka.
