Hai phần đầu cho ta một topic chia thành partition, ghi vào cực nhanh. Nhưng một producer ghi 1,2 triệu message/giây thì ai đọc hết chừng đó? Một consumer đơn lẻ sẽ không theo kịp. Đây là lúc consumer group vào cuộc — cơ chế để nhiều consumer chia nhau xử lý một topic, song song và tự phục hồi. Nó là tính năng khiến Kafka scale được ở phía đọc, nhưng cũng mang theo một khái niệm mà mọi kỹ sư vận hành Kafka đều vừa yêu vừa sợ: rebalance. Bài này (phần 3/12) đo thật cách một group chia partition, và điều gì xảy ra mỗi khi số consumer thay đổi.
Quy tắc vàng của consumer group
Một consumer group là một tập consumer dùng chung một group.id, cùng nhau tiêu thụ một topic. Kafka áp một quy tắc đơn giản nhưng quyết định tất cả:
Mỗi partition được gán cho đúng một consumer trong cùng group.
Hệ quả trực tiếp:
- Không bao giờ có hai consumer trong cùng group đọc trùng một partition — mỗi message được xử lý một lần bởi group.
- Số consumer hữu dụng tối đa = số partition. Thêm consumer vượt số partition thì chúng ngồi không.
- Nhiều group khác nhau đọc cùng topic độc lập — mỗi group giữ offset riêng. Group "tính tiền" và group "gửi email" cùng đọc toàn bộ topic mà không ảnh hưởng nhau. Đây chính là mô hình publish-subscribe trên nền log.
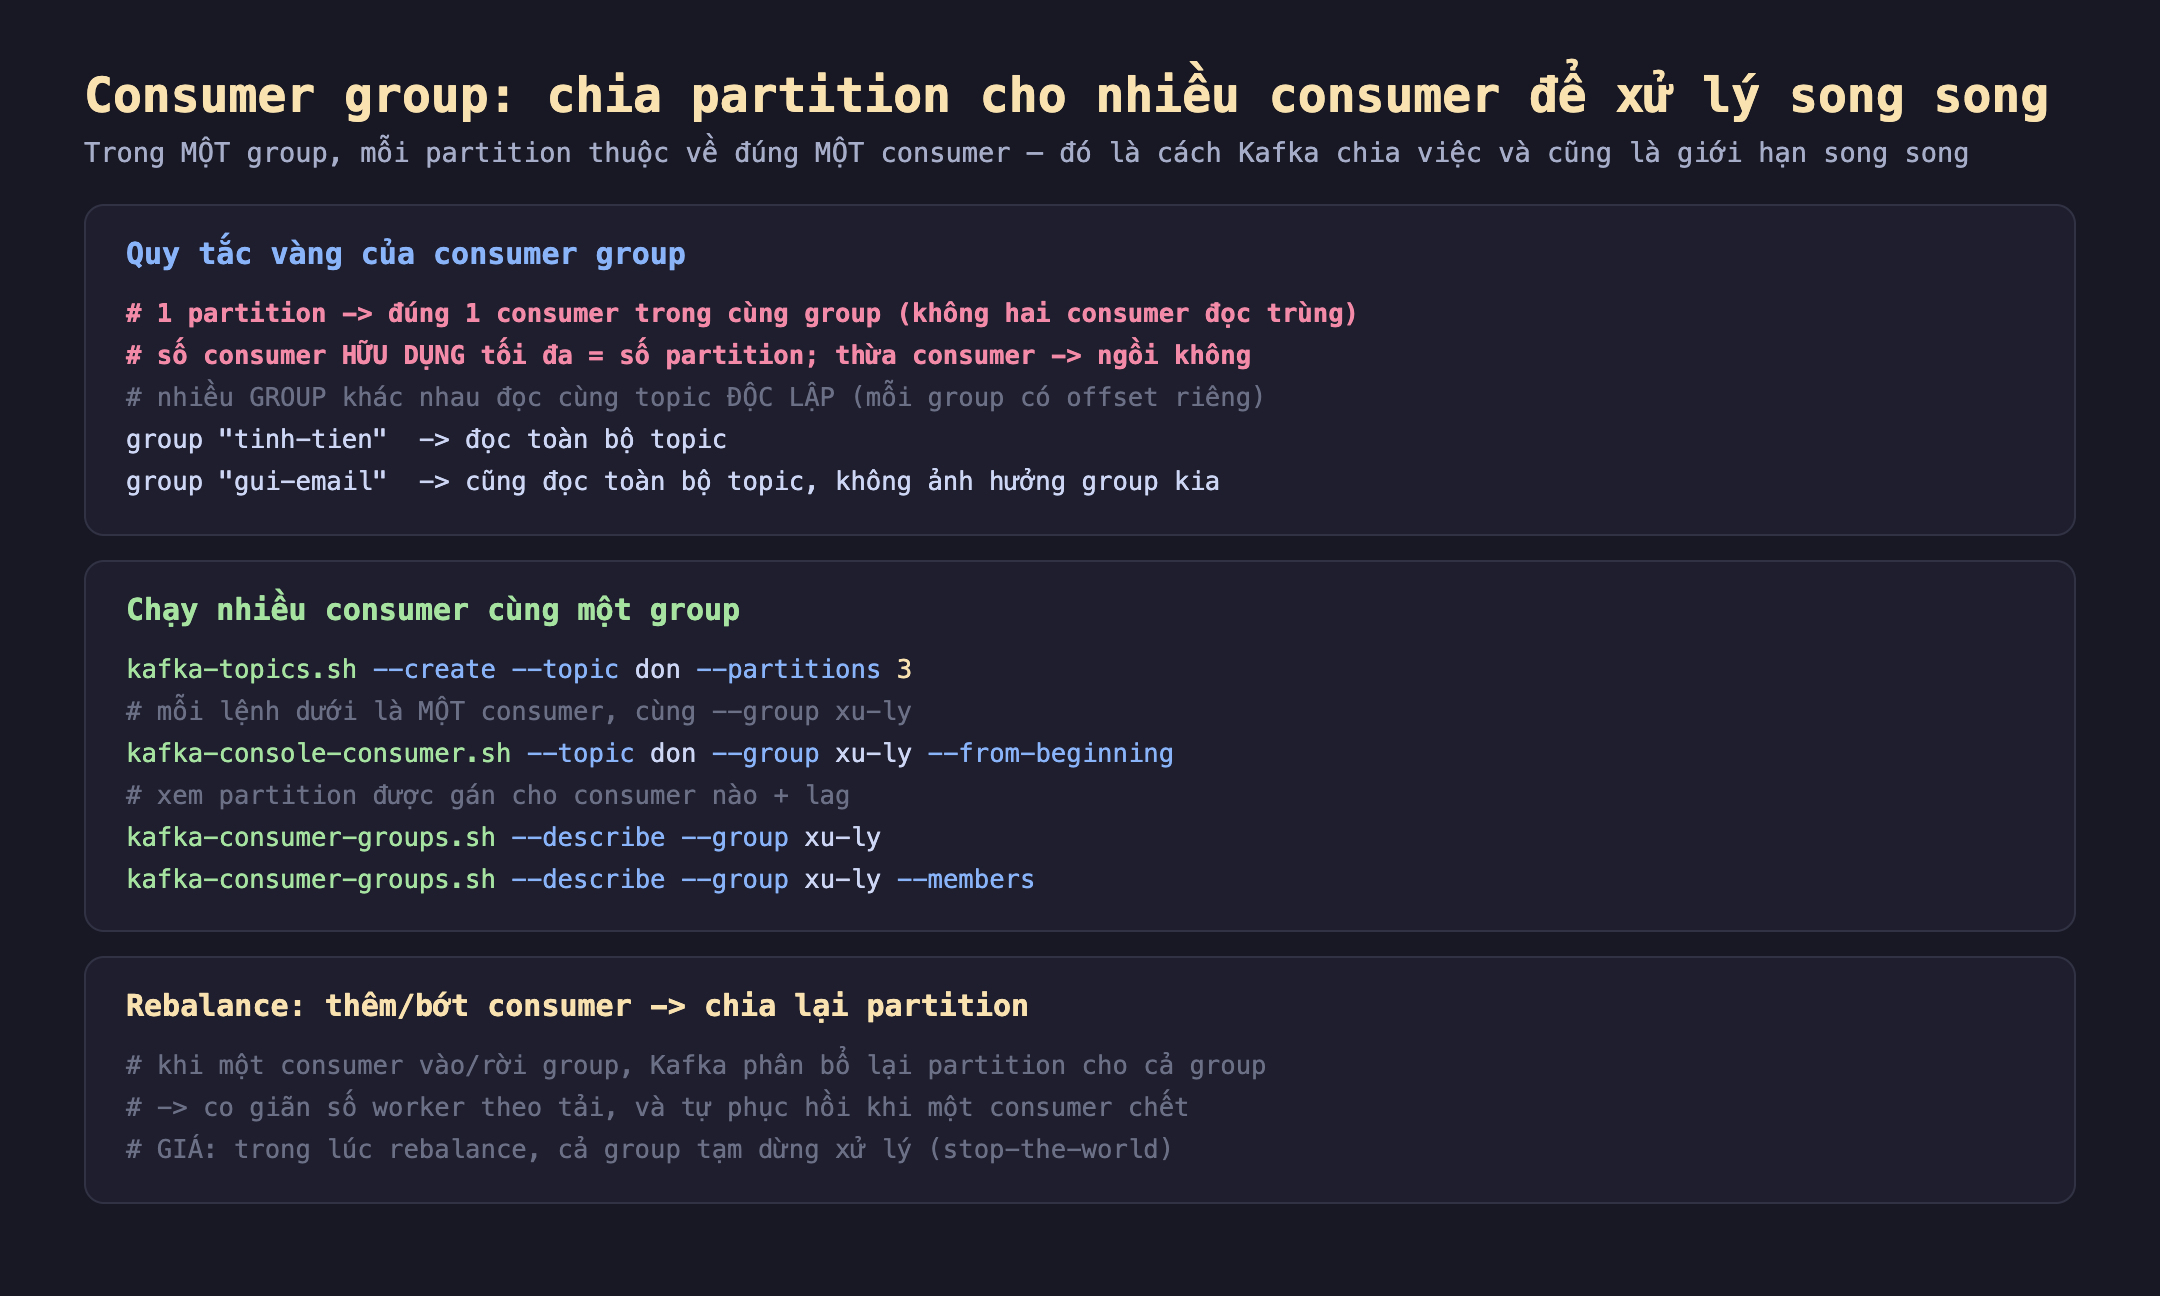
Hình 1: Trong một group, mỗi partition thuộc về đúng một consumer. Nhiều group đọc cùng topic độc lập (offset riêng). Thêm/bớt consumer kích hoạt rebalance — Kafka chia lại partition cho cả group.
Lệnh để quan sát: chạy nhiều kafka-console-consumer.sh với cùng --group, rồi dùng kafka-consumer-groups.sh --describe để xem partition nào đang thuộc consumer nào:
kafka-topics.sh --bootstrap-server localhost:9092 --create --topic don --partitions 3

# mỗi lệnh là MỘT consumer, cùng group "xu-ly"
kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic don --group xu-ly --from-beginning

# xem phân bổ partition + lag + số partition mỗi consumer
kafka-consumer-groups.sh --bootstrap-server localhost:9092 --describe --group xu-ly
kafka-consumer-groups.sh --bootstrap-server localhost:9092 --describe --group xu-ly --members
Đo thật: rebalance khi thêm consumer
Mình tạo topic don 3 partition, nạp 300 message, rồi lần lượt thêm consumer vào group xu-ly, mỗi lần đọc lại bảng phân bổ:
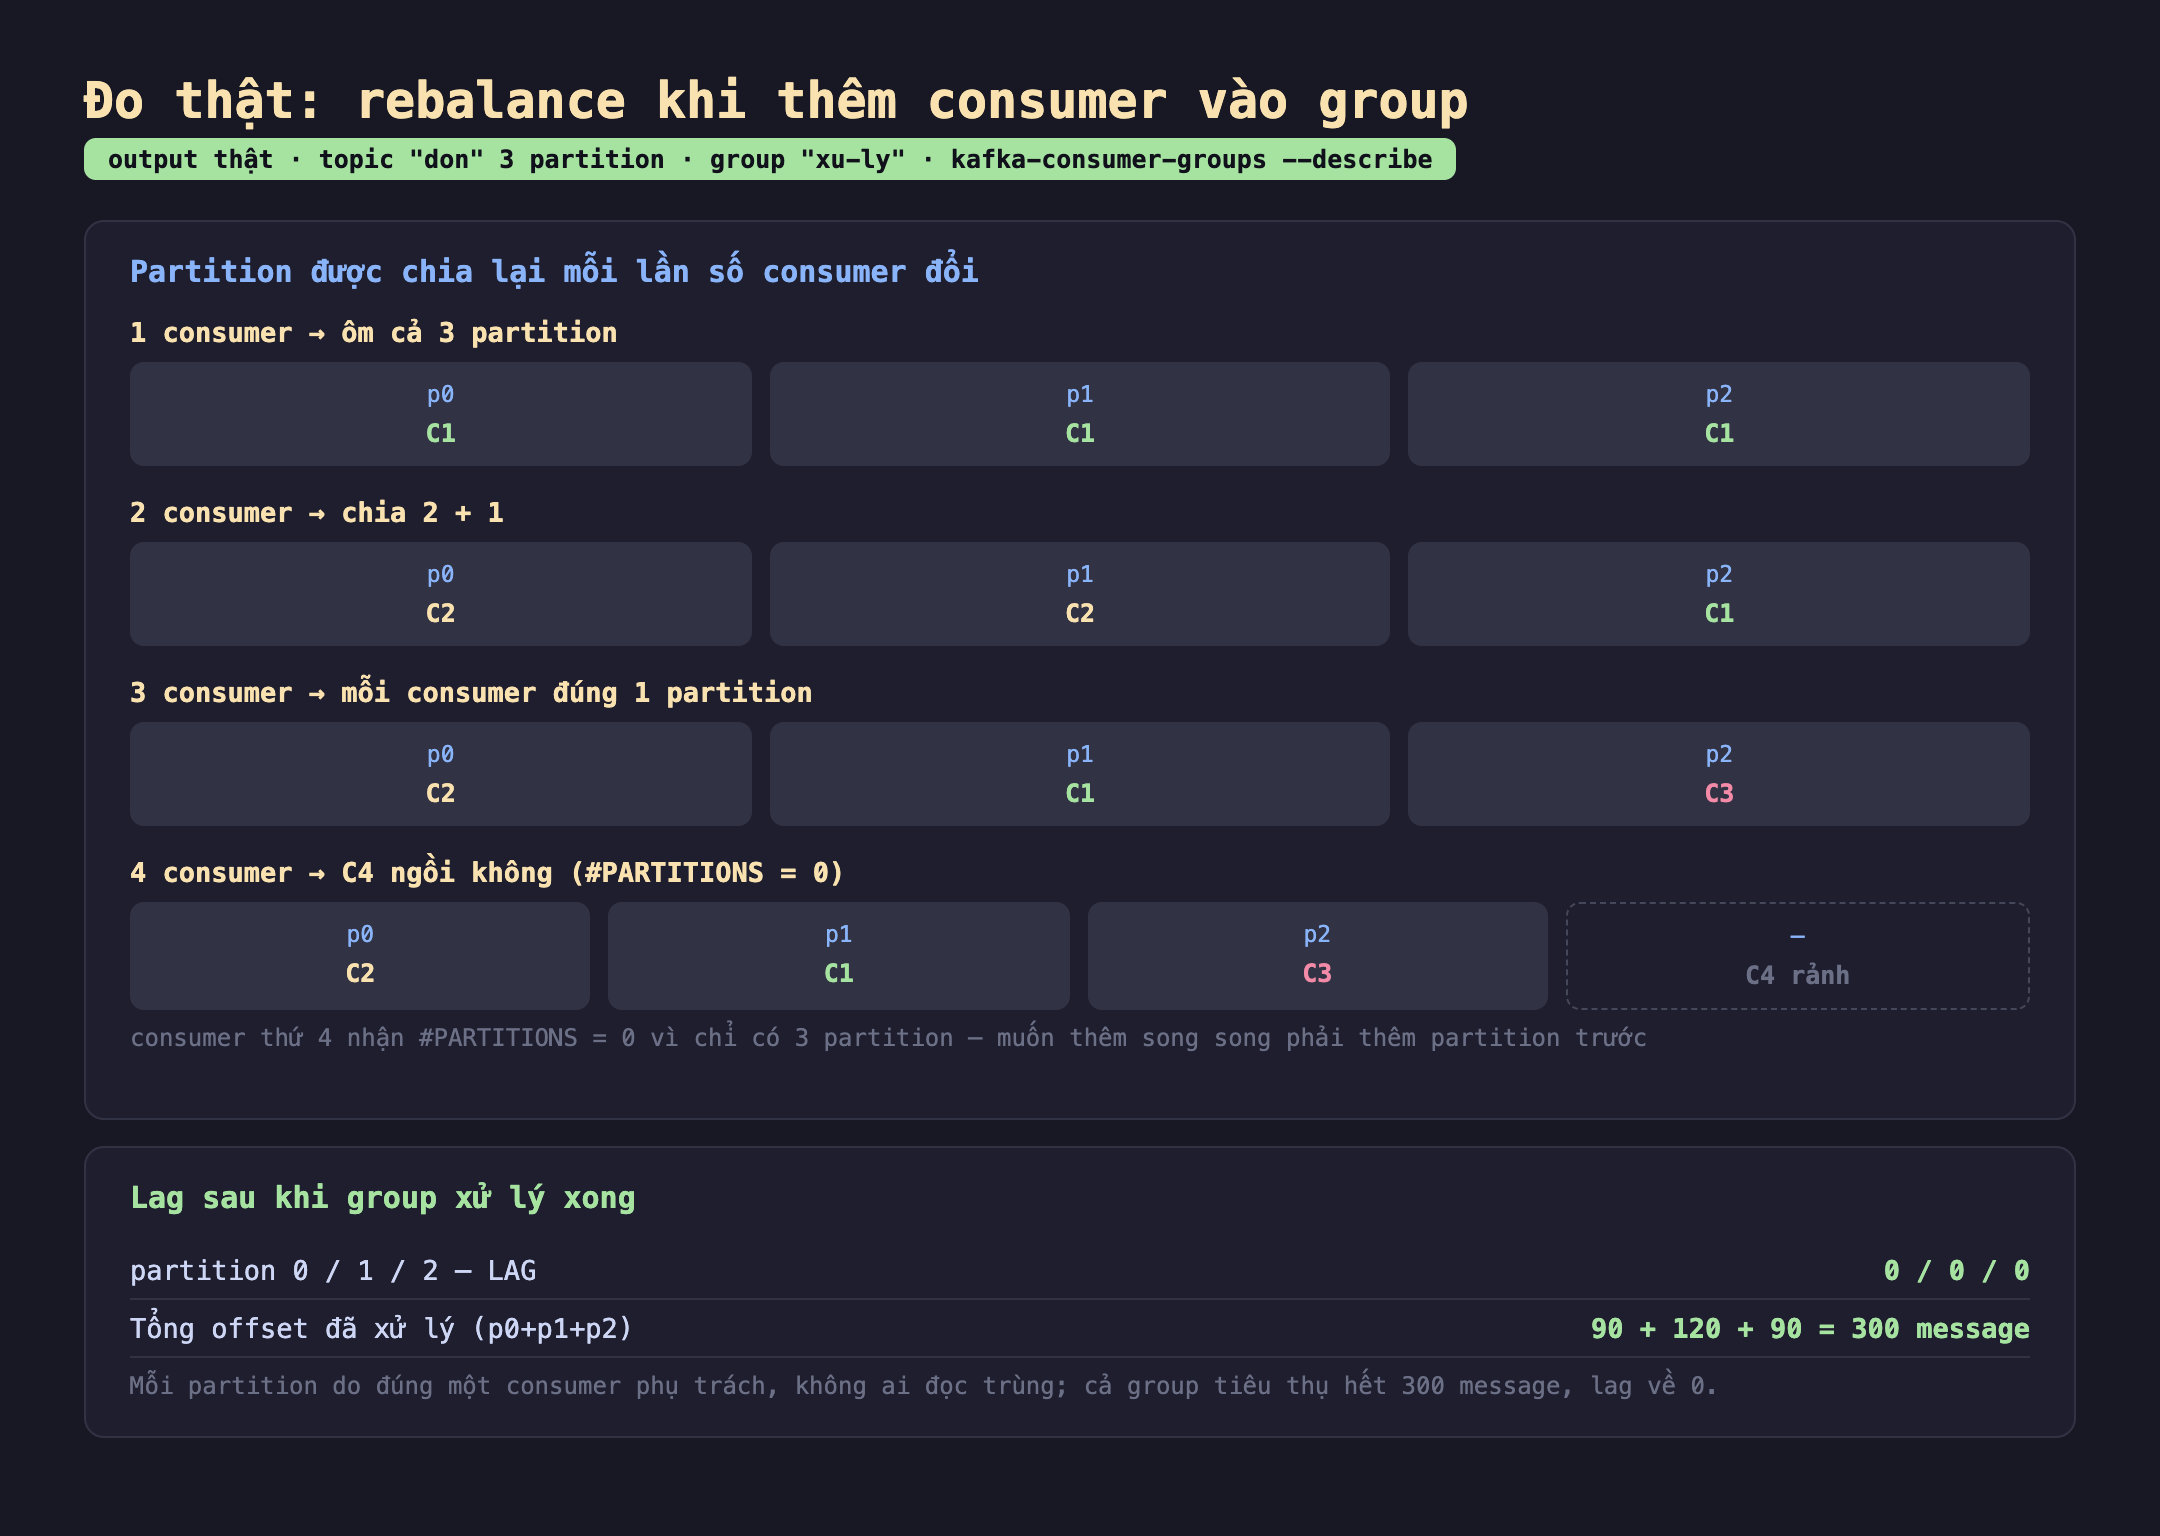
Hình 2: Đo thật. Với 1 consumer, nó ôm cả 3 partition. Thêm consumer thứ hai → chia 2+1. Thứ ba → mỗi consumer đúng một partition. Thứ tư → ngồi không (#PARTITIONS = 0) vì chỉ có 3 partition. Lag về 0, tổng 300 message (90+120+90) được tiêu thụ hết.
Diễn tiến thật, đọc từ kafka-consumer-groups.sh --describe:
- 1 consumer: cả ba partition (p0, p1, p2) có cùng một
CONSUMER-ID— một mình ôm hết. - Thêm consumer thứ 2: Kafka rebalance, chia 3 partition thành 2+1. Một consumer giữ p0+p1, consumer kia giữ p2. Thông lượng xử lý tăng gần gấp đôi vì hai máy chạy song song.
- Thêm consumer thứ 3: rebalance lần nữa, giờ mỗi consumer đúng một partition — mức song song tối đa cho topic 3 partition.
- Thêm consumer thứ 4: nó nhận
#PARTITIONS = 0— ngồi không. Không còn partition để giao. Đây là minh chứng cụ thể cho "số consumer hữu dụng ≤ số partition": muốn thêm worker song song, phải thêm partition trước (và nhớ cái bẫy đổi số partition ở bài kafka-02).
Sau khi group xử lý xong, LAG của cả ba partition về 0, và tổng offset 90+120+90 = 300 đúng bằng số message đã nạp — mỗi partition do đúng một consumer phụ trách, không ai đọc trùng, cả group tiêu thụ trọn vẹn.
Rebalance: sức mạnh và cơn đau
Rebalance là cơ chế đứng sau mọi điều trên: mỗi khi một consumer vào hoặc rời group (kể cả khi nó chết đột ngột), Kafka phân bổ lại partition cho các consumer còn lại. Đây là nguồn gốc hai tính chất quý giá:
- Co giãn (elasticity): thêm consumer khi tải tăng, bớt khi tải giảm — group tự chia lại việc.
- Chịu lỗi (fault tolerance): một consumer chết, partition của nó được giao cho consumer khác trong vài giây, xử lý tiếp từ offset đã commit. Không mất việc.
Nhưng rebalance có cái giá: trong giao thức "eager" cổ điển, khi rebalance xảy ra, toàn bộ group tạm dừng xử lý (stop-the-world) — mọi consumer nhả hết partition rồi nhận lại. Với group lớn hoặc rebalance thường xuyên, đây là nguồn gây giật, tăng lag đột ngột.
Đánh đổi cần cân nhắc
Rebalance thường xuyên là kẻ thù. Nếu consumer của bạn xử lý một message quá lâu (vượt max.poll.interval.ms), Kafka tưởng nó chết và kích hoạt rebalance — rồi consumer "sống lại" gây rebalance tiếp, tạo vòng xoáy. Giữ thời gian xử lý mỗi lô trong giới hạn, hoặc tăng max.poll.interval.ms cho công việc chậm. Mỗi rebalance là một lần cả group khựng lại.
Cooperative rebalance giảm đau, nhưng không miễn phí. Kafka hiện đại có CooperativeStickyAssignor — chỉ di chuyển những partition cần đổi chủ thay vì nhả hết rồi chia lại, giảm thời gian stop-the-world. Nên dùng cho group lớn, nhưng nó cần cấu hình đồng bộ trên mọi consumer và vẫn có chi phí điều phối.
Số partition là trần song song — đặt từ đầu cho đúng. Vì consumer thừa sẽ ngồi không, số partition quyết định bạn scale phía đọc được tới đâu. Nếu dự kiến cần 12 worker song song lúc cao điểm, topic phải có ít nhất 12 partition từ đầu — tăng sau sẽ phá vỡ ánh xạ key → partition và không có tác dụng hồi tố với dữ liệu cũ.
Ba ý mang về
- Consumer group chia partition cho nhiều consumer, mỗi partition đúng một consumer. Đo thật: 1 consumer ôm 3 partition, 2 consumer chia 2+1, 3 consumer mỗi người một partition — song song tăng theo số consumer, tới trần là số partition.
- Consumer vượt số partition sẽ ngồi không. Đo thật: consumer thứ 4 nhận
#PARTITIONS = 0. Số partition là trần của song song phía đọc; muốn thêm worker thì thêm partition trước, nên ước lượng đúng từ đầu. - Rebalance cho co giãn và chịu lỗi, nhưng tốn stop-the-world. Mỗi lần thêm/bớt/chết consumer, Kafka chia lại partition — mạnh cho tự phục hồi nhưng cả group tạm dừng lúc đó. Tránh rebalance thừa (xử lý trong
max.poll.interval.ms), cân nhắc cooperative rebalance cho group lớn.
Nguồn
- Apache Kafka — Consumer Group & Rebalance Protocol: https://kafka.apache.org/documentation/#intro_consumers
- Apache Kafka — Consumer Configs (max.poll.interval.ms, partition.assignment.strategy): https://kafka.apache.org/documentation/#consumerconfigs
- Confluent — Incremental Cooperative Rebalancing in Kafka: https://www.confluent.io/blog/incremental-cooperative-rebalancing-in-kafka/
Phần sau ta mổ xẻ ba mức đảm bảo giao message: at-most-once, at-least-once và exactly-once — đo thật cảnh message bị mất khi acks=0, bị trùng khi retry, và cách idempotent producer khử trùng.
