Khi mới gặp Kafka, phản xạ đầu tiên của hầu hết lập trình viên backend là xếp nó cùng ngăn với RabbitMQ hay ActiveMQ: "à, một cái message queue". Rồi họ dùng nó y như một queue — và bối rối khi thấy message vẫn còn đó sau khi đã xử lý, hoặc khi một dịch vụ khác đọc lại được toàn bộ lịch sử. Hiểu lầm này không phải lỗi nhỏ: nó khiến người ta dùng sai công cụ và bỏ lỡ chính thứ làm Kafka mạnh. Kafka không phải hàng đợi xoá-sau-khi-đọc. Nó là một append-only log (sổ ghi chỉ nối thêm) phân tán, có thể phát lại. Bài mở màn sê-ri này (phần 1/12) dựng một broker thật trong Docker, chạy produce/consume, và đo throughput thật để thấy rõ bản chất đó.
Append-only log: mô hình dữ liệu của Kafka
Hãy quên "queue" đi một lát. Đơn vị cơ bản của Kafka là topic, và mỗi topic chia thành một hay nhiều partition. Mỗi partition là một log — một chuỗi bản ghi được nối vào cuối và đánh số thứ tự tăng dần gọi là offset. Producer luôn ghi vào cuối; consumer đọc tuần tự theo offset và tự nhớ mình đã đọc tới đâu.
Điểm mấu chốt phân biệt với message queue truyền thống: đọc không phá huỷ dữ liệu. Trong RabbitMQ, một message được consume xong là bị gỡ khỏi queue — nó biến mất. Trong Kafka, consume chỉ là đọc ở một offset; bản ghi vẫn nằm nguyên trong log. Hệ quả là nhiều consumer có thể đọc cùng một topic một cách độc lập (mỗi cái giữ offset riêng), và một consumer có thể tua lại về offset 0 để đọc lại toàn bộ lịch sử.
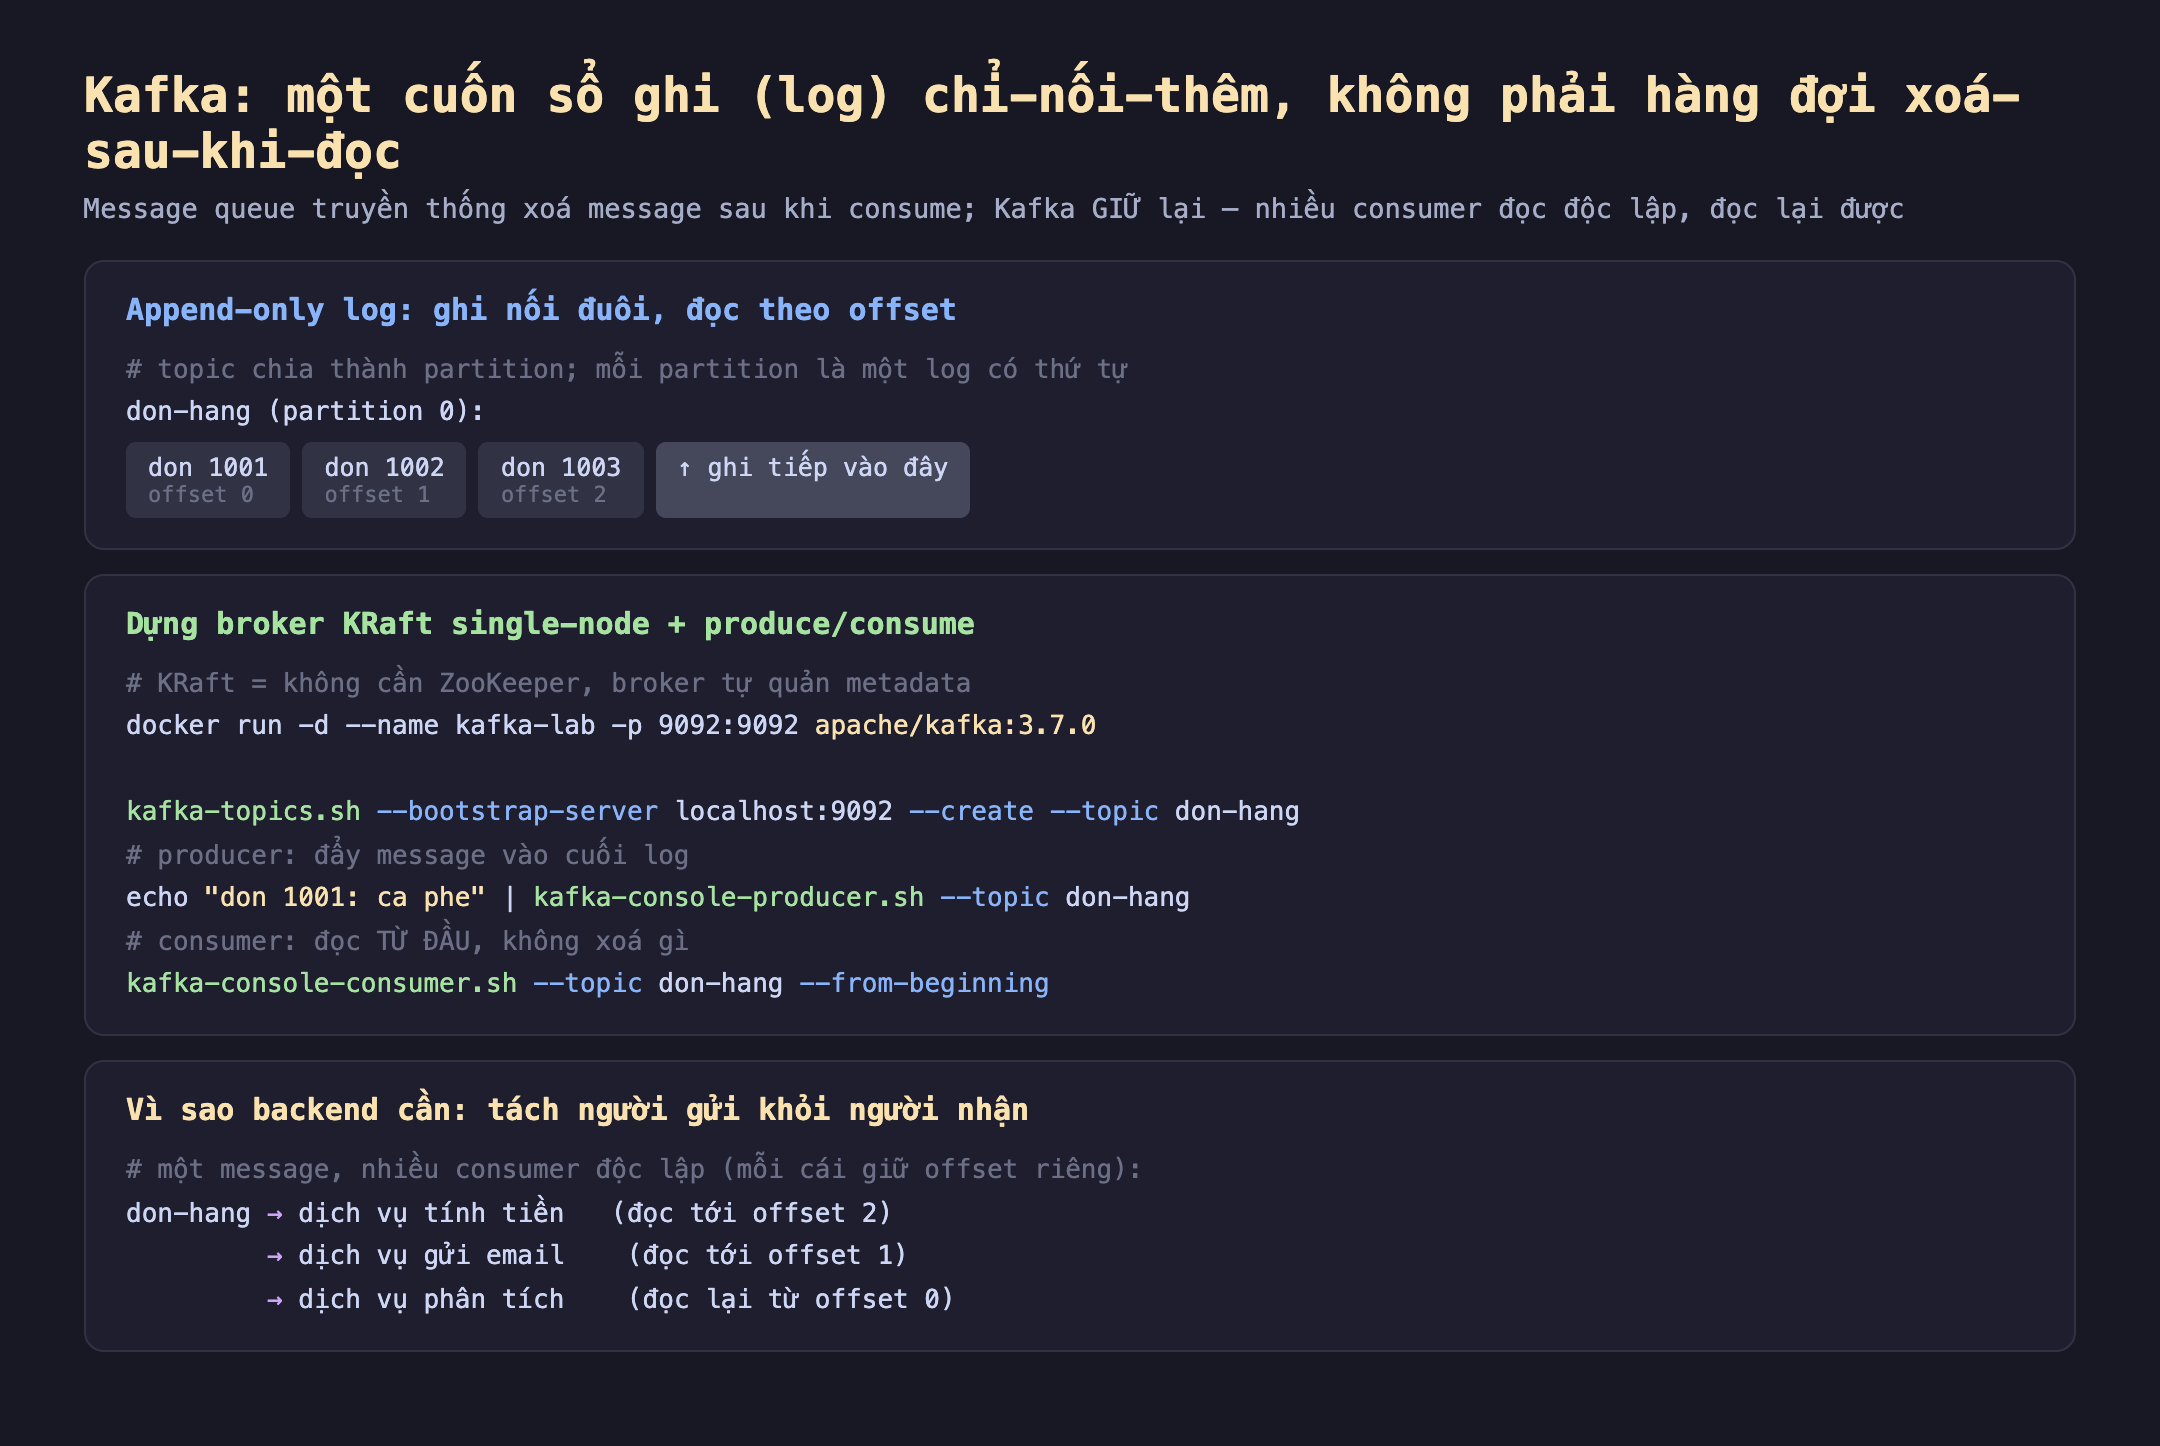
Hình 1: Mỗi partition là một log chỉ-nối-thêm, bản ghi đánh số bằng offset. Producer ghi vào cuối; nhiều consumer đọc độc lập theo offset riêng. Dựng broker KRaft (không cần ZooKeeper) chỉ bằng một lệnh docker run.
Mô hình này giải thích vì sao Kafka hợp với kiến trúc event-driven: một sự kiện "đơn hàng mới" ghi một lần vào log, rồi dịch vụ tính tiền, dịch vụ gửi email, và dịch vụ phân tích mỗi cái đọc độc lập theo nhịp của mình. Người gửi không cần biết có bao nhiêu người nhận — đó là sự tách rời (decoupling) mà backend phân tán luôn tìm kiếm.
Dựng broker thật và chạy thử
Từ Kafka 3.x, ta không cần ZooKeeper nữa: chế độ KRaft cho broker tự quản metadata. Image chính thức apache/kafka chạy KRaft single-node ngay với cấu hình mặc định:
docker run -d --name kafka-lab -p 9092:9092 apache/kafka:3.7.0

# tạo topic, produce 3 message
kafka-topics.sh --bootstrap-server localhost:9092 --create --topic don-hang
printf "don 1001: ca phe\ndon 1002: tra sua\ndon 1003: banh mi\n" \
  | kafka-console-producer.sh --bootstrap-server localhost:9092 --topic don-hang

# consume từ đầu
kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic don-hang --from-beginning
Lần consume đầu trả về đúng ba dòng. Nhưng điều đáng chứng minh là chạy lại lệnh consume lần hai: nó vẫn trả về đúng ba dòng đó. Với một message queue, lần đọc thứ hai sẽ rỗng vì message đã bị xoá. Với Kafka, log còn nguyên — đây chính là sự khác biệt bản chất, và nó không phải lý thuyết suông mà kiểm chứng được ngay trong lab.
Đo thật: throughput trên một node
Mô hình log append-only còn cho Kafka một thế mạnh khác: tốc độ. Vì ghi chỉ là nối tuần tự vào cuối file (ghi tuần tự nhanh hơn ghi ngẫu nhiên rất nhiều), và vì Kafka gom bản ghi thành batch, throughput rất cao kể cả trên một node. Mình đo bằng kafka-producer-perf-test.sh — nửa triệu bản ghi 100 byte:
kafka-producer-perf-test.sh --topic don-hang --num-records 500000 \
  --record-size 100 --throughput -1 \
  --producer-props bootstrap.servers=localhost:9092 acks=1
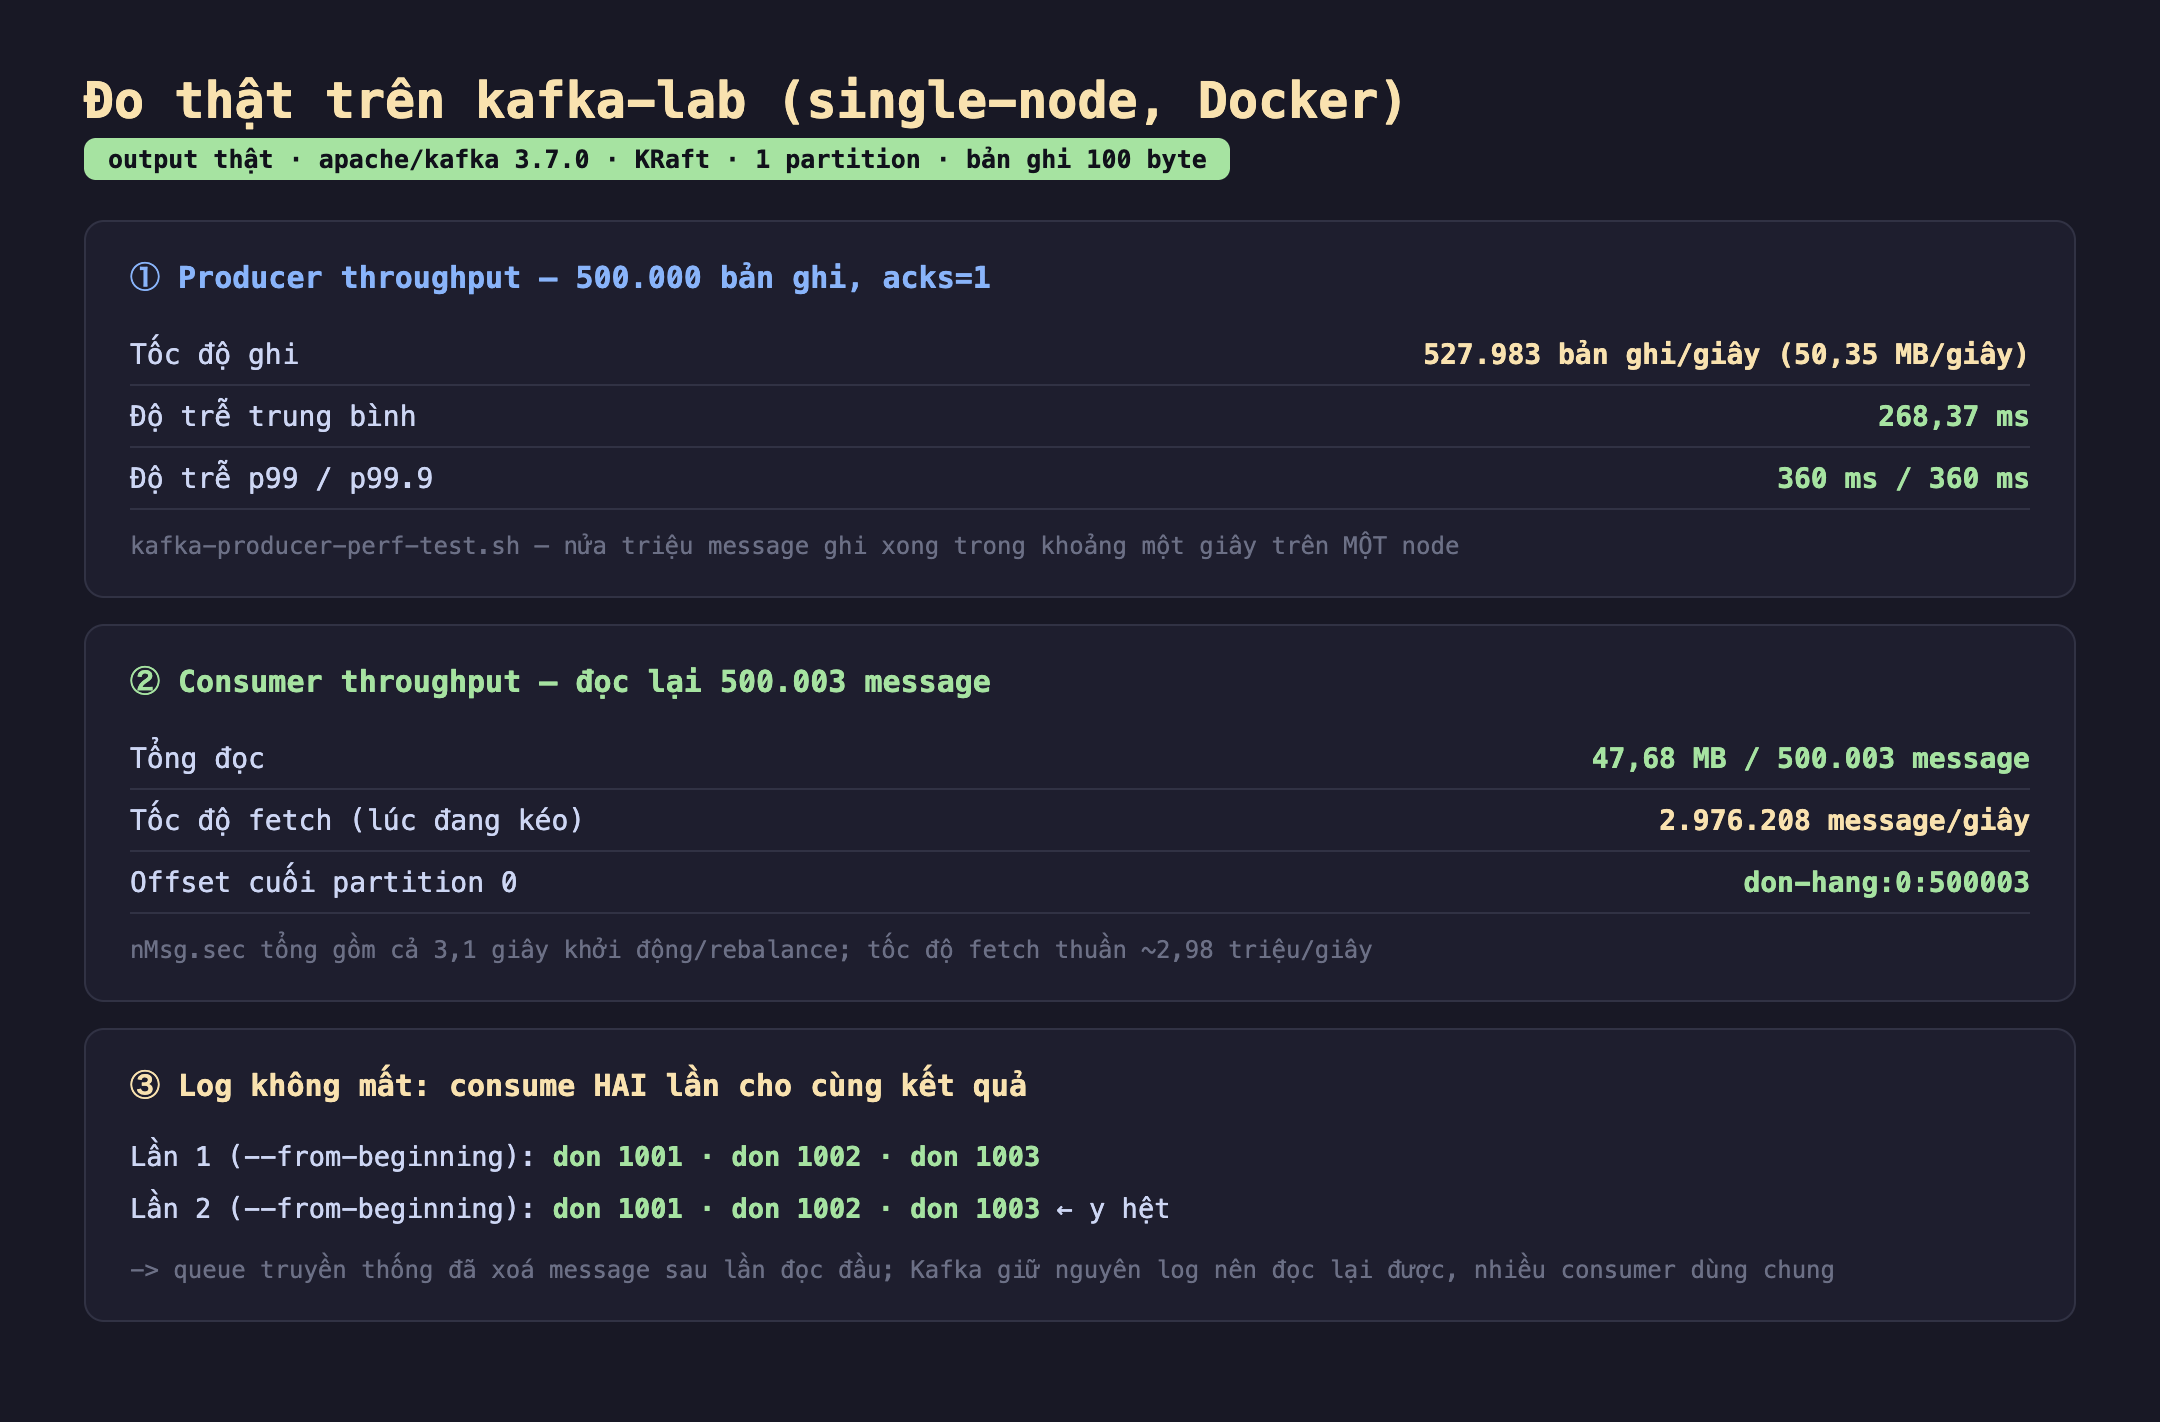
Hình 2: Đo thật trên single-node KRaft trong Docker. Producer ghi 527.983 bản ghi/giây (50,35 MB/giây), độ trễ trung bình 268 ms, p99 360 ms. Consumer đọc lại nửa triệu message; tốc độ fetch thuần ~2,98 triệu message/giây. Offset cuối partition 0 là 500003 (3 đơn ban đầu + 500000 bản ghi test).
Đọc kết quả thật:
- Ghi: 527.983 bản ghi/giây (50,35 MB/giây). Nửa triệu message ghi xong trong khoảng một giây, trên đúng một broker trong Docker. Độ trễ trung bình 268 ms và p99 360 ms — độ trễ này phản ánh việc gom batch và chờ
acks=1(broker xác nhận đã ghi), đổi lại throughput cao. - Đọc: tốc độ fetch ~2,98 triệu message/giây. Con số
nMsg.sectổng (152.254/giây) gồm cả ~3,1 giây khởi động và rebalance của consumer; để trung thực, tốc độ fetch thuần khi đã bắt đầu kéo dữ liệu mới là con số phản ánh đúng khả năng đọc — và nó rất cao vì đọc tuần tự từ log. - Offset cuối = 500003. Đúng bằng 3 đơn hàng ban đầu cộng 500.000 bản ghi test — log tích luỹ tất cả, không ghi đè, không xoá.
Đây là lý do Kafka được chọn cho các hệ thống thông lượng lớn: một node khiêm tốn đã xử lý nửa triệu message/giây, và nó scale ngang bằng cách thêm partition + broker (các bài sau sẽ đo).
Đánh đổi cần cân nhắc
Single-node là để học, không phải để chạy production. Lab này dùng một broker, replication-factor = 1 — nghĩa là không có bản sao. Node chết là mất dữ liệu. Production luôn cần ít nhất 3 broker và replication-factor ≥ 3 để chịu lỗi (bài kafka-09 sẽ nói về replication và ISR). Mọi con số throughput ở đây là trần trên một máy, chưa tính chi phí đồng bộ bản sao.
Kafka không miễn phí về vận hành. Đổi lại sức mạnh, Kafka là một hệ phân tán có trạng thái: cần quản lý partition, retention, consumer group, giám sát lag. Với một hàng đợi tác vụ đơn giản (vài nghìn job/ngày, một consumer), RabbitMQ hay thậm chí một bảng trong database còn gọn hơn. Kafka đáng giá khi bạn cần throughput cao, phát lại, hoặc nhiều consumer độc lập trên cùng luồng sự kiện — bài kafka-12 sẽ bàn kỹ "khi nào KHÔNG nên dùng Kafka".
Độ trễ và throughput là một đánh đổi. Throughput 527k/giây đi kèm độ trễ trung bình 268 ms chính vì producer gom batch trước khi gửi. Nếu ứng dụng cần độ trễ cực thấp cho từng message lẻ, phải chỉnh linger.ms/batch.size theo hướng ngược lại và chấp nhận throughput thấp hơn (bài kafka-07 sẽ đo đánh đổi này).
Ba ý mang về
- Kafka là append-only log, không phải queue xoá-sau-khi-đọc. Đo thật: consume hai lần với
--from-beginningcho cùng kết quả, vì đọc không phá huỷ log. Đây là nền tảng cho phát lại và cho nhiều consumer độc lập trên cùng một luồng sự kiện. - Một node KRaft đã rất nhanh. Đo thật: 527.983 bản ghi/giây (50,35 MB/giây) khi ghi, fetch thuần ~2,98 triệu message/giây khi đọc — nhờ ghi tuần tự vào log và gom batch. KRaft bỏ ZooKeeper nên dựng broker chỉ còn một lệnh
docker run. - Sức mạnh đi kèm cái giá vận hành và các đánh đổi. Single-node + replication-factor 1 chỉ để học; production cần nhiều broker và bản sao. Throughput cao đổi bằng độ trễ batch (268 ms trung bình). Kafka đáng dùng khi cần throughput/phát lại/nhiều consumer — không phải cho mọi hàng đợi.
Nguồn
- Apache Kafka — Documentation: Introduction: https://kafka.apache.org/documentation/#introduction
- Apache Kafka — KRaft (KIP-500) Overview: https://kafka.apache.org/documentation/#kraft
- Jay Kreps — The Log: What every software engineer should know about real-time data's unifying abstraction: https://engineering.linkedin.com/distributed-systems/log-what-every-software-engineer-should-know-about-real-time-datas-unifying
Phần sau ta mổ xẻ partition: vì sao key quyết định message rơi vào partition nào, vì sao Kafka chỉ đảm bảo thứ tự trong một partition chứ không phải toàn topic, và đo thấy nhiều partition tăng throughput như thế nào.
