Bài trước, benchstat giúp benchmark có ý nghĩa thống kê. Nhưng thống kê chính xác trên một phép đo sai vẫn ra kết luận sai. Cạm bẫy nguy hiểm nhất của microbenchmark trong Go không phải nhiễu — mà là trình biên dịch xóa mất chính đoạn code bạn đang cố đo.
Go tối ưu rất mạnh: nếu kết quả một hàm không được dùng, nó có thể loại bỏ (dead-code elimination) cả lời gọi; nếu input là hằng số, nó có thể tính sẵn (constant folding) lúc biên dịch. Kết quả: benchmark đo một vòng lặp gần như rỗng và báo một con số nhỏ đến phi lý — bạn tưởng code nhanh, thực ra nó không chạy. Bài này đo thật hiện tượng đó trên cùng một hàm, và chỉ ra cách viết benchmark để số đo phản ánh chi phí thật.
Vì sao con số có thể là dối trá
// Trình biên dịch Go tối ưu rất mạnh. Nếu KẾT QUẢ hàm không dùng,
// hoặc INPUT là hằng số, nó có thể LOẠI BỎ hoặc TÍNH SẴN code -
// và benchmark đo... cái không còn chạy. Con số nhỏ hơn thực tế.
// Dấu hiệu: benchmark báo dưới 1 ns/op -> gần chắc code bị xóa.
Hàm có chi phí thật để đo
func BamNhe(x uint64) uint64 {
	for i := 0; i < 20; i++ { // 20 vòng trộn bit - chi phí thật
		x ^= x << 13
		x ^= x >> 7
		x ^= x << 17
	}
	return x
}
SAI: kết quả không dùng + input hằng số
func BenchmarkSai_KhongDung(b *testing.B) {
	for i := 0; i < b.N; i++ {
		BamNhe(12345) // vứt kết quả + input HẰNG -> compiler tối ưu mất
	}
}
Hai lỗi cùng lúc: kết quả BamNhe(...) không ai dùng (compiler có thể loại), và input 12345 giống hệt mỗi vòng (compiler có thể tính sẵn một phần, hoặc nâng ra ngoài vòng lặp — loop-invariant hoisting).
ĐÚNG: sink package + input biến thiên
var Sink uint64 // biến package - compiler không loại được

func BenchmarkDung_Sink(b *testing.B) {
	var r uint64
	for i := 0; i < b.N; i++ {
		r = BamNhe(uint64(i)) // input BIẾN THIÊN -> không constant-fold
	}
	Sink = r // gán vào sink -> compiler PHẢI giữ mọi lời gọi
}
Hai sửa chữa: input uint64(i) biến thiên mỗi vòng nên compiler không thể tính sẵn; và kết quả cuối gán vào biến package Sink (một "sink") mà compiler không thể chứng minh là vô dụng, nên nó phải giữ toàn bộ chuỗi tính toán.
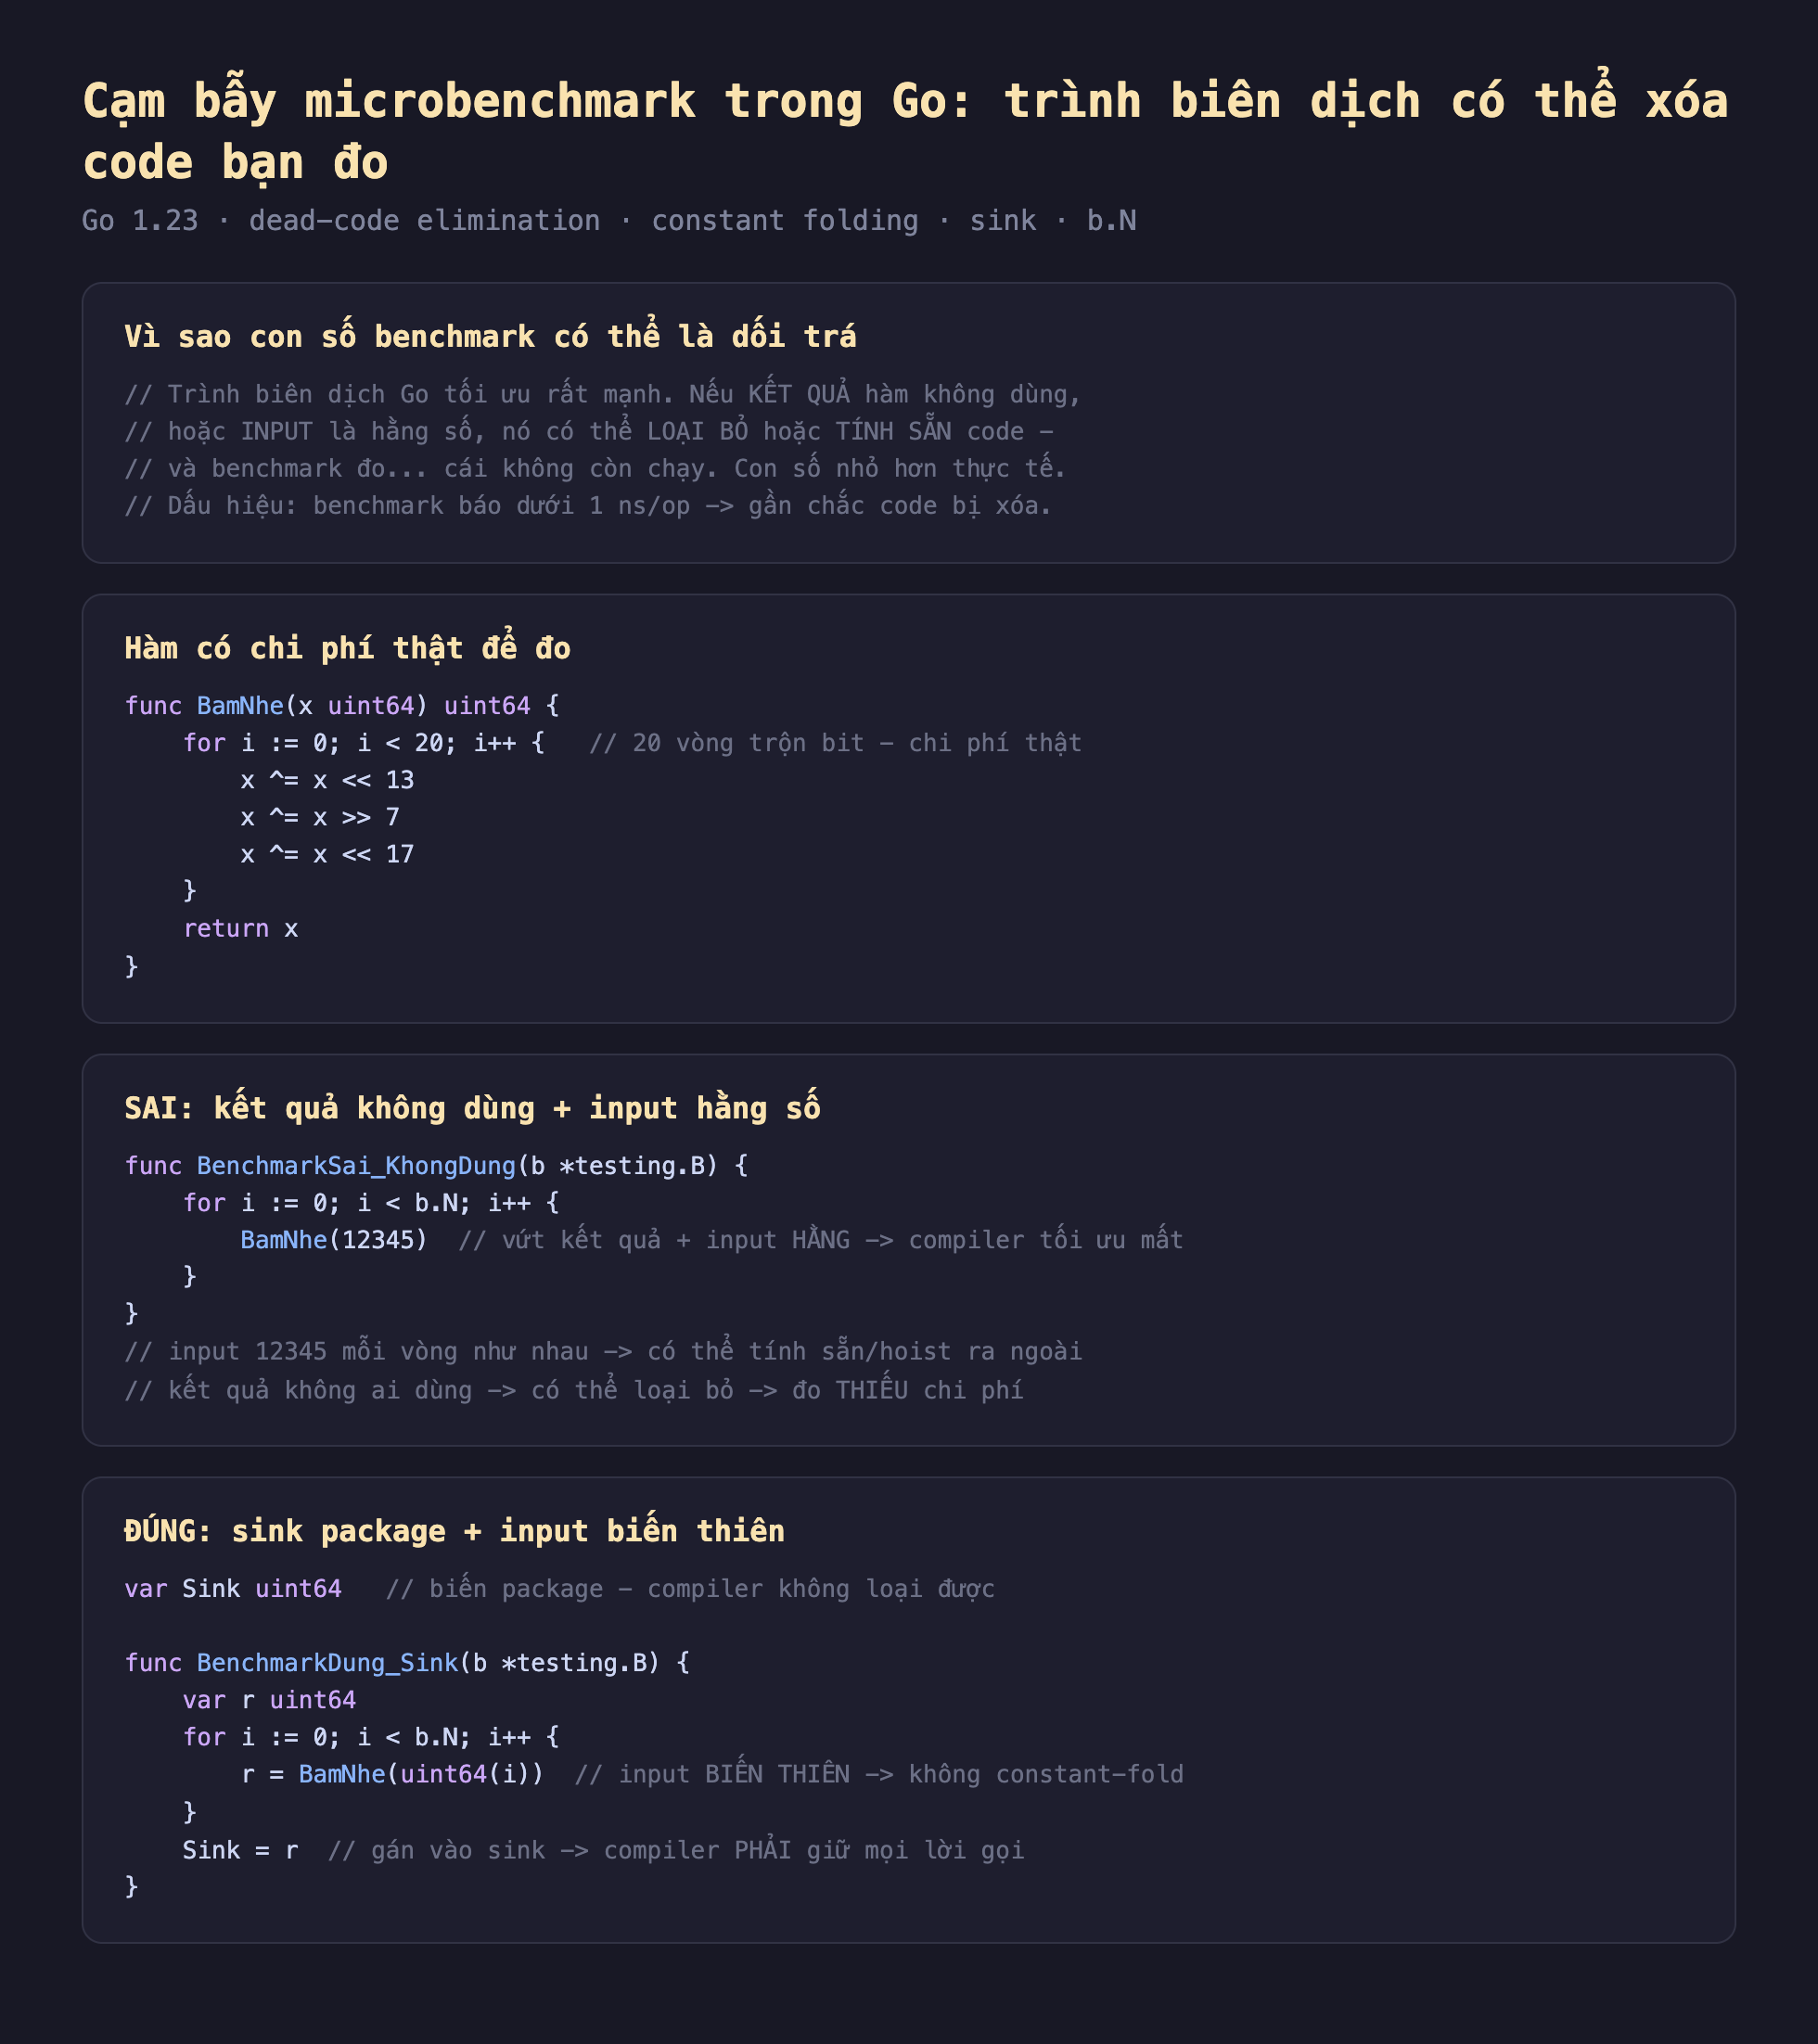
Hình 1: Cạm bẫy microbenchmark — benchmark SAI (kết quả không dùng + input hằng số) để compiler loại/tính sẵn code; benchmark ĐÚNG dùng biến package Sink và input biến thiên để buộc compiler chạy thật mọi lời gọi.
Đo thật: cùng hàm, hai con số khác nhau
Chạy cả hai benchmark trên cùng hàm BamNhe:
SAI (kết quả không dùng, input hằng 12345):
  BenchmarkSai_KhongDung   5.472 ns/op
  BenchmarkSai_KhongDung   5.584 ns/op
  BenchmarkSai_KhongDung   5.662 ns/op

ĐÚNG (sink + input biến thiên):
  BenchmarkDung_Sink       9.320 ns/op
  BenchmarkDung_Sink       9.394 ns/op
  BenchmarkDung_Sink       9.349 ns/op
Cùng một hàm, nhưng benchmark SAI báo ~5.5 ns còn benchmark ĐÚNG báo ~9.35 ns — SAI thiếu khoảng 41% so với chi phí thật. Lý do: với input hằng 12345, compiler tính sẵn/nâng một phần công việc ra ngoài vòng lặp, và vì kết quả không dùng nên một phần bị loại bỏ. Benchmark ĐÚNG buộc mọi lời gọi với input khác nhau đều chạy đầy đủ, phản ánh chi phí thật khi hàm được dùng trong sản xuất. Chênh ~1.7 lần — đủ để dẫn tới quyết định tối ưu sai nếu tin con số SAI.
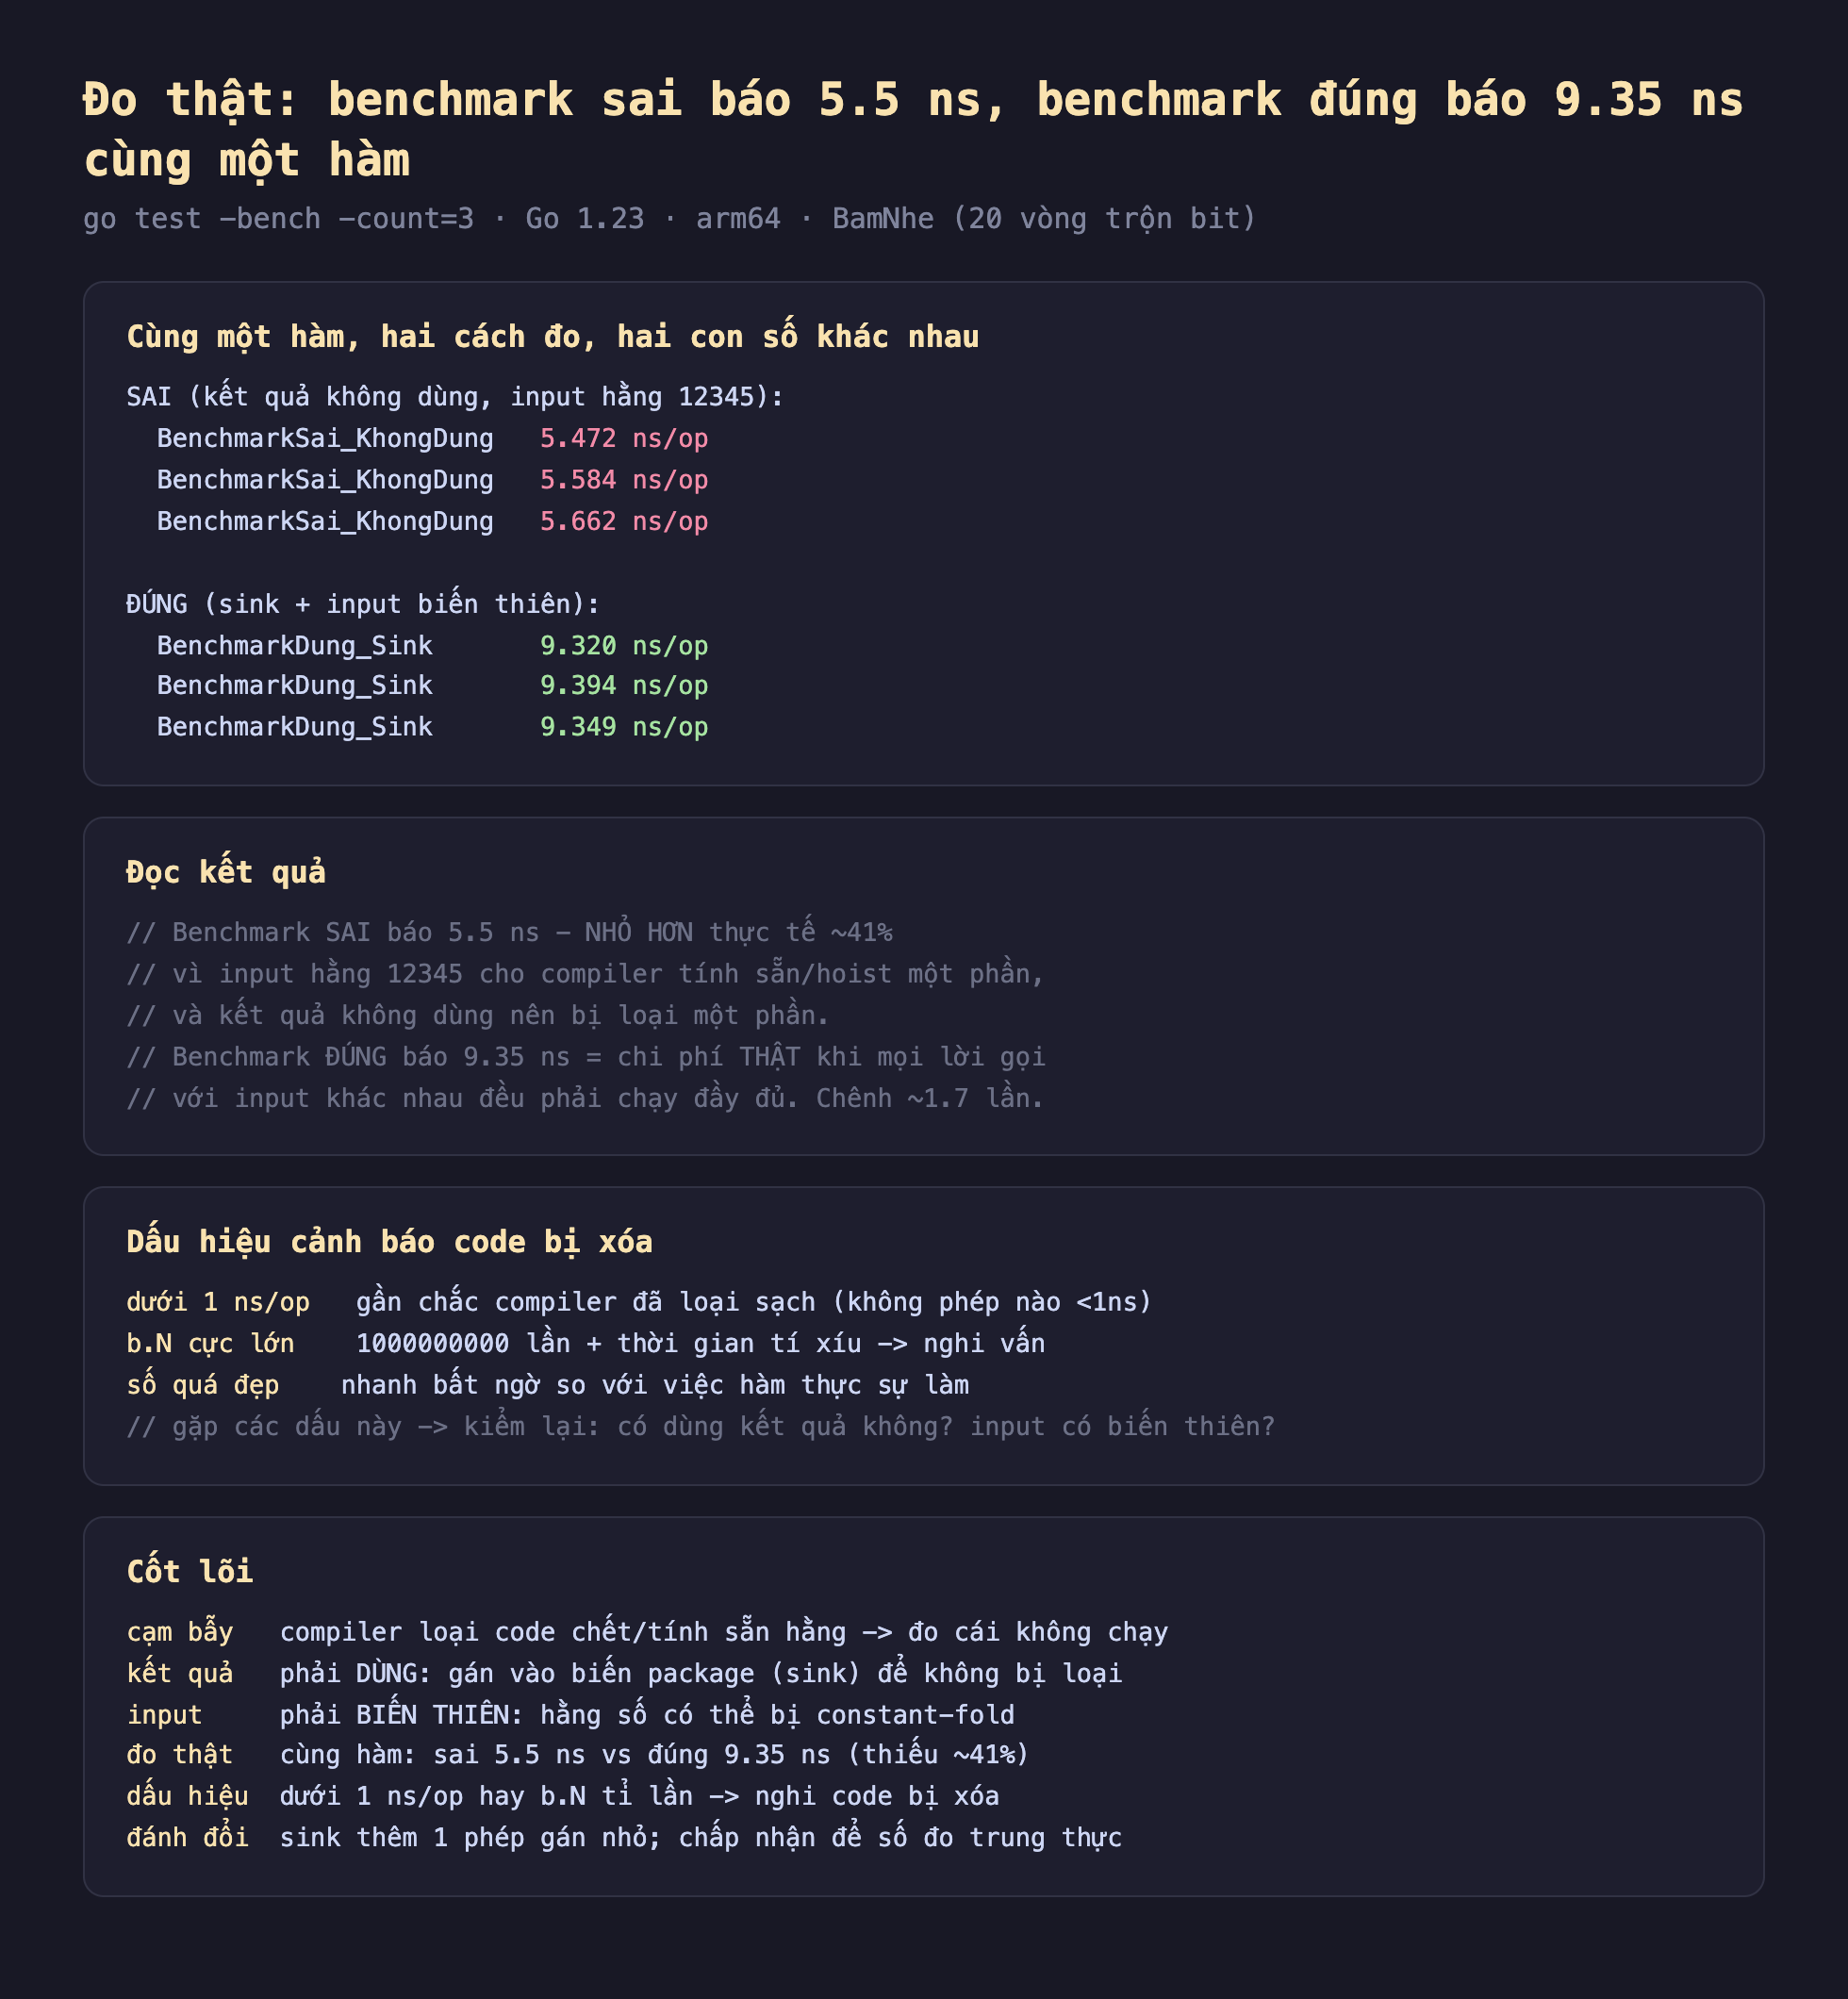
Hình 2: Đo thật cùng hàm BamNhe — benchmark SAI (kết quả không dùng, input hằng) báo ~5.5 ns, benchmark ĐÚNG (sink + input biến thiên) báo ~9.35 ns; SAI thiếu ~41% vì compiler tính sẵn/loại code, và dấu hiệu nhận biết code bị xóa (dưới 1 ns/op, b.N tỉ lần).
Dấu hiệu cảnh báo code bị xóa
Làm sao biết benchmark của bạn đã dính cạm bẫy này? Vài dấu hiệu:
- Dưới 1 ns/op: gần như chắc chắn code bị loại — không phép tính có nghĩa nào chạy dưới 1 ns trên CPU hiện đại. Thấy
0.25 ns/oplà báo động đỏ. b.Ncực lớn (1000000000) kèm thời gian tí xíu: khi benchmark chạy được tỉ lần trong tích tắc, nhiều khả năng vòng lặp gần rỗng.- Số quá đẹp: nhanh bất ngờ so với việc hàm thực sự làm. Nếu hàm duyệt một slice 1000 phần tử mà báo 2 ns, có gì đó sai.
Gặp các dấu này, kiểm lại ngay: kết quả có được dùng không? Input có biến thiên không? Đó là hai câu hỏi cứu bạn khỏi kết luận sai.
Đánh đổi cần cân nhắc
Sink thêm một chút overhead — nhưng chấp nhận được và cần thiết. Gán vào biến package thêm một phép ghi bộ nhớ mỗi vòng (hoặc mỗi benchmark nếu gán ngoài vòng như ví dụ). Với hàm có chi phí đáng kể, overhead này không đáng kể so với chính hàm. Với hàm cực nhẹ (vài ns), sink có thể chiếm tỉ lệ đáng chú ý — nhưng thà đo hơi cao còn hơn đo sai vì code bị xóa. Đừng bỏ sink để "sạch hơn".
b.Loop() của Go 1.24+ tự xử lý việc này. Từ Go 1.24, có for b.Loop() {...} thay cho for i := 0; i < b.N; i++, và nó tự động ngăn compiler loại bỏ code trong thân vòng lặp (giữ cả tham số lẫn kết quả sống). Nếu dùng Go 1.24 trở lên, đây là cách khuyến nghị — gọn hơn và an toàn hơn sink thủ công. (Bài này đo trên Go 1.23 nên minh họa kỹ thuật sink kinh điển, vẫn đúng và cần hiểu.)
Input biến thiên phải rẻ để sinh, kẻo đo nhầm chi phí sinh input. Dùng uint64(i) rẻ. Nhưng nếu bạn sinh input phức tạp trong vòng lặp benchmark (tạo slice mới, format chuỗi), bạn đang đo cả chi phí đó lẫn hàm — lại một dạng đo sai. Chuẩn bị dữ liệu trước vòng lặp (và gọi b.ResetTimer() sau khi chuẩn bị), chỉ để phép tính cần đo trong vòng lặp.
Ba ý mang về
- Trình biên dịch Go có thể xóa/tính-sẵn code bạn đang benchmark: kết quả không dùng bị loại (dead-code elimination), input hằng số bị tính sẵn (constant folding) — benchmark đo cái không chạy và báo số nhỏ hơn thực tế.
- Sửa bằng sink + input biến thiên: gán kết quả vào biến package (
Sink) để compiler không loại, và cho input biến thiên (uint64(i)) để không constant-fold — đo thật, cùng hàm cho 5.5 ns (sai, thiếu ~41%) so với 9.35 ns (đúng); từ Go 1.24 dùngb.Loop()tự xử lý. - Nhận biết cạm bẫy qua dấu hiệu: dưới 1 ns/op,
b.Ntỉ lần với thời gian tí xíu, hay số nhanh phi lý — đều là cờ đỏ; và nhớ chuẩn bị input trước vòng lặp (dùngb.ResetTimer()) để không đo nhầm chi phí sinh dữ liệu.
Phần sau ta xét đo độ phủ test sâu hơn: coverage nâng cao và phân tích trong Go — đo phủ theo nhánh, phủ tích hợp từ binary thật, và vì sao 100% phủ dòng không đồng nghĩa test tốt.
