Suốt sê-ri này ta đã dùng go test -bench để đo hiệu năng, và nó tuyệt vời. Nhưng có một cạm bẫy nếu chỉ chạy một lần: con số bạn nhận là một mẫu duy nhất từ một hệ thống đầy nhiễu — tải nền, chu kỳ GC, tần số CPU thay đổi (turbo boost, throttling nhiệt), tranh chấp cache. Cùng một benchmark chạy hai lần cho hai con số khác nhau. Nếu bạn so "bản cũ 100ns" với "bản mới 95ns" và kết luận "nhanh hơn 5%", rất có thể 5% đó chỉ là nhiễu — chạy lại có khi bản cũ lại nhanh hơn.
benchstat (công cụ chính thức từ golang.org/x/perf) giải bằng thống kê: chạy benchmark nhiều lần, tính trung bình và độ lệch, và khi so hai phiên bản, tính p-value để cho biết khác biệt là thật hay chỉ nhiễu. Bài này đo thật quy trình đúng để benchmark có ý nghĩa.
Vì sao một lần đo không đủ
// Chạy go test -bench MỘT lần cho MỘT con số - nhưng máy có nhiễu:
// tải nền, GC, tần số CPU đổi, cache... Con số đó dao động mỗi lần.
// So hai phiên bản bằng 1 con số mỗi bên -> kết luận có thể do nhiễu.
// benchstat: chạy NHIỀU lần, tính trung bình + độ lệch + p-value.
Bước 1: chạy -count nhiều lần, lưu ra tệp
$ go test -bench=. -benchmem -run=^$ -count=10 > bench.txt
Cờ -count=10 chạy mỗi benchmark 10 lần, cho 10 mẫu mỗi hàm. Lưu ra tệp để benchstat đọc và phân tích.
Bước 2: benchstat tính trung bình ± độ lệch
$ benchstat bench.txt
GhepCong-10      19.81µ ± 1%   // trung bình 10 lần, dao động ±1%
GhepBuilder-10   1.081µ ± 3%   // ±% cho biết đo có ỔN ĐỊNH không
Thay vì một con số, benchstat cho trung bình ± phần trăm dao động. Con số ±% cực kỳ quan trọng: ±1% nghĩa là phép đo rất ổn định, kết luận đáng tin; ±20% nghĩa là đo nhiễu, cần chạy lại hoặc tắt tải nền trước khi tin bất kỳ con số nào.
Bước 3: so hai phiên bản với p-value
Đây là giá trị lớn nhất của benchstat — so before/after một cách có ý nghĩa thống kê:
$ go test -bench=Ghep -count=10 > old.txt   # bản cũ
# ... sửa code ...
$ go test -bench=Ghep -count=10 > new.txt   # bản mới
$ benchstat old.txt new.txt
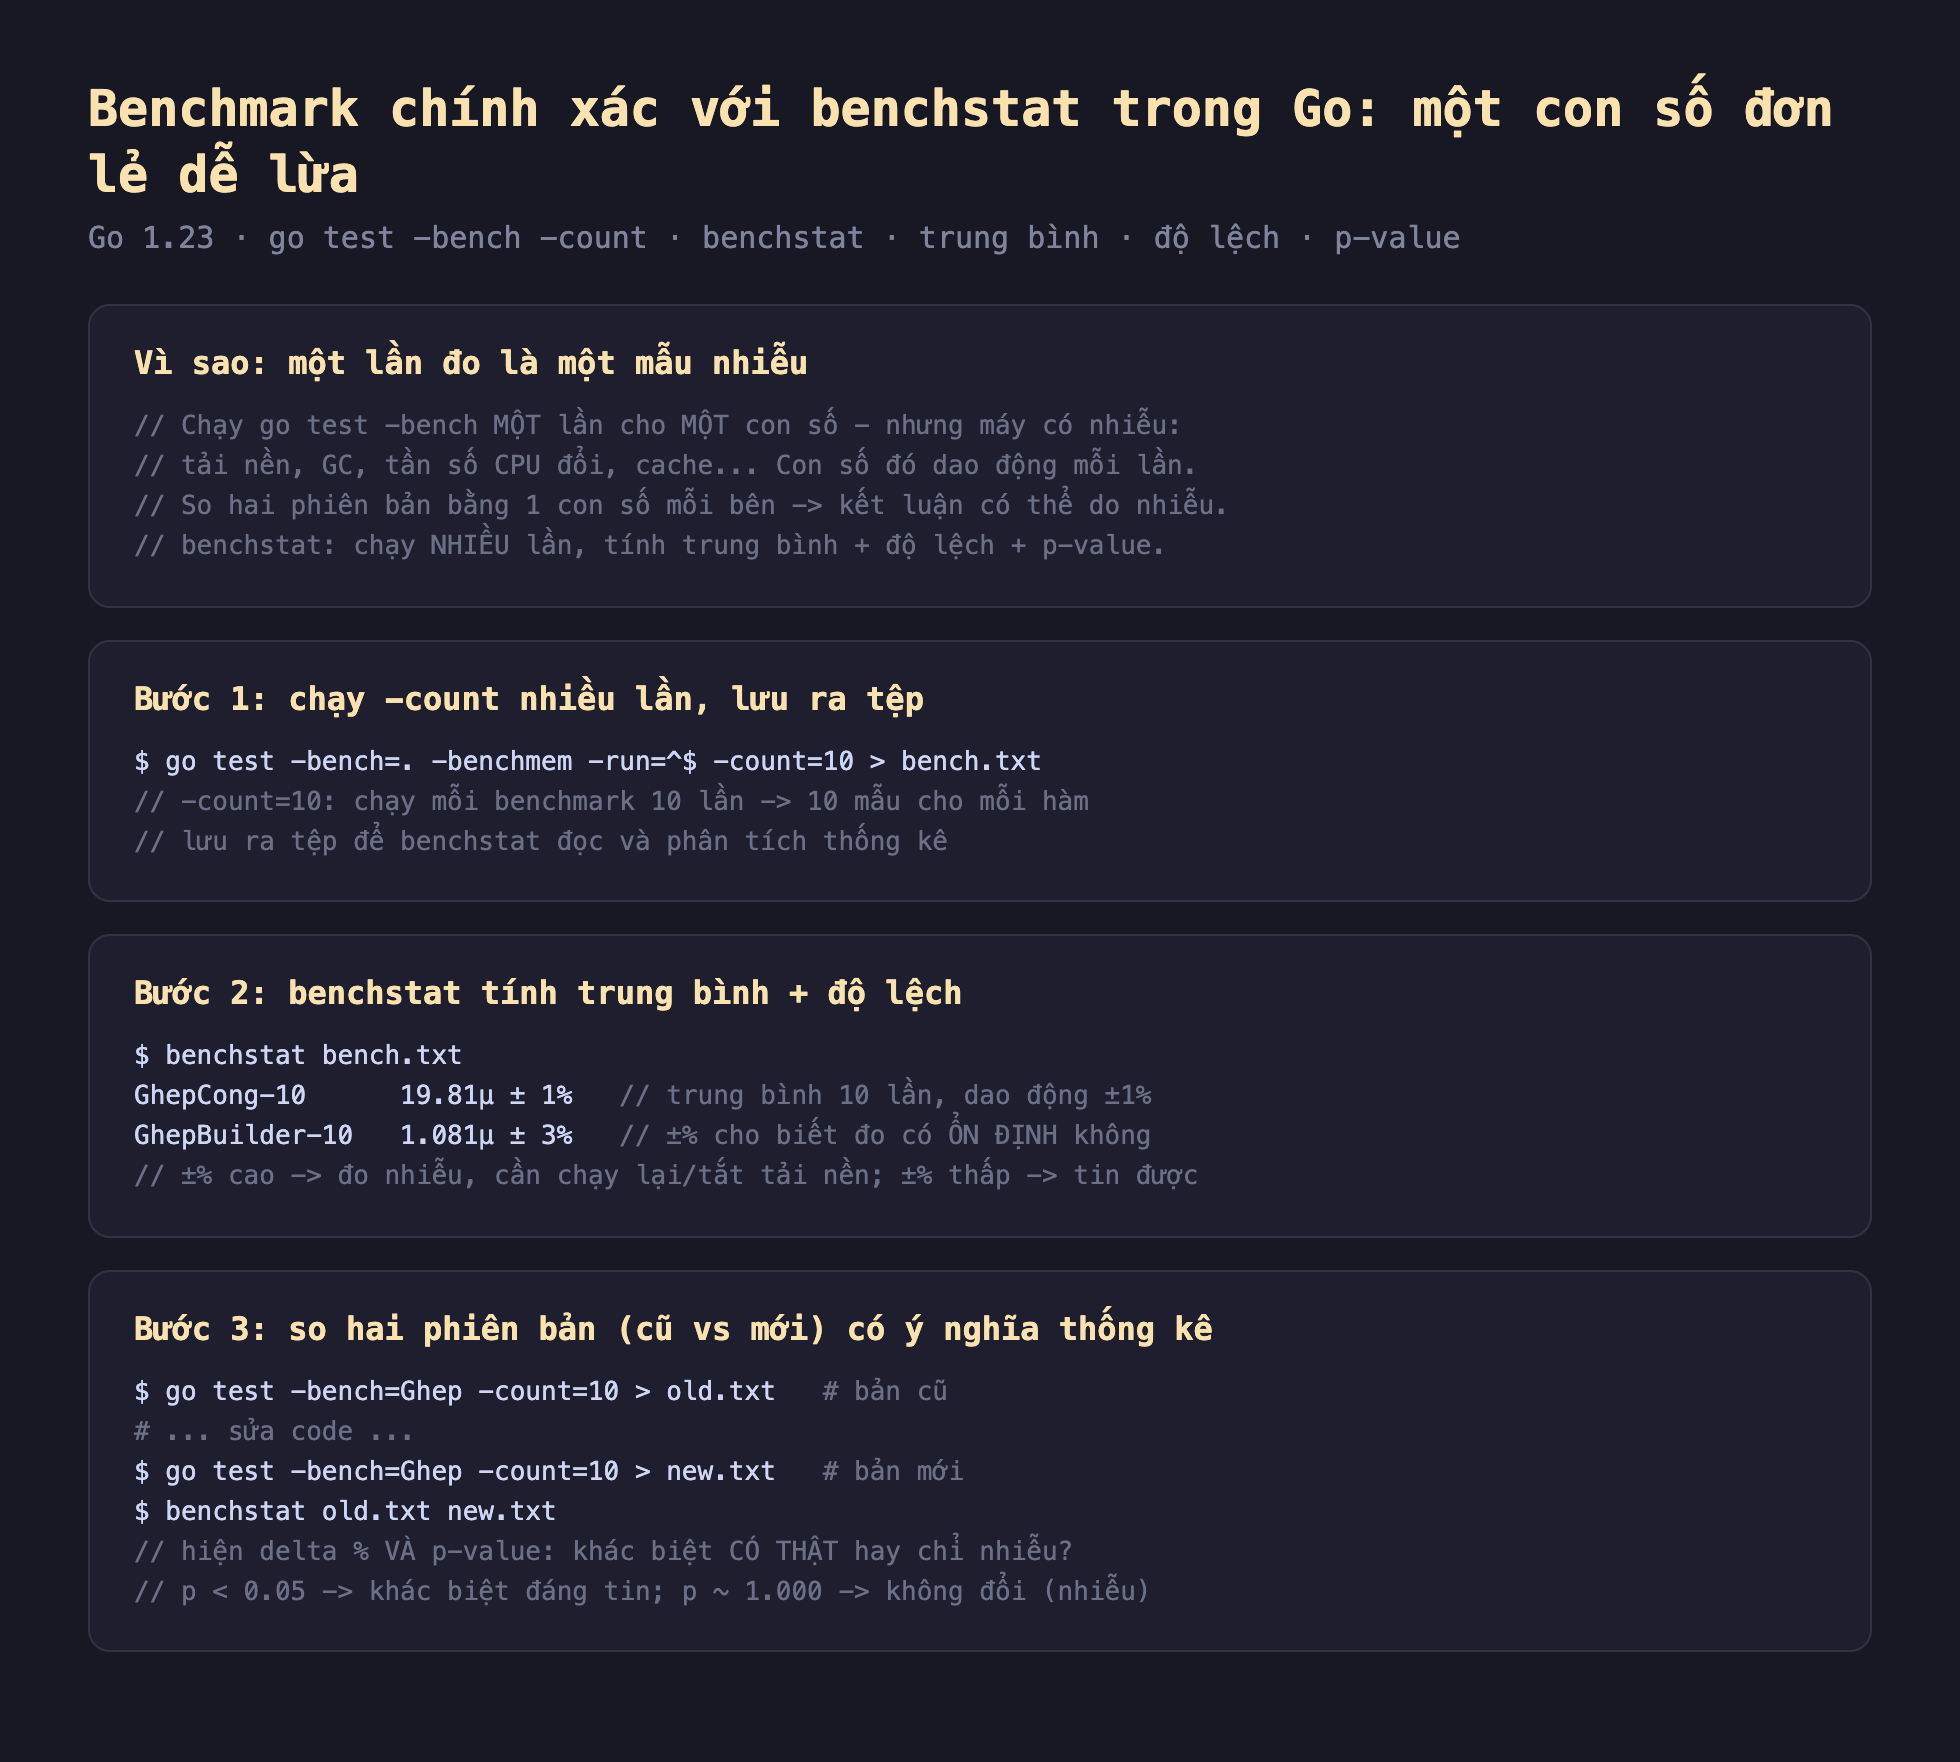
Hình 1: benchstat trong Go — một lần đo là một mẫu nhiễu nên phải chạy -count=N lấy nhiều mẫu; benchstat tính trung bình ± độ lệch, và so hai bản bằng p-value để biết khác biệt là thật hay nhiễu.
Đo thật: trung bình, độ lệch, và p-value
So hai cách nối 200 chuỗi — += (tạo chuỗi mới mỗi lần) và strings.Builder (buffer lớn dần).
Một lần đo cho hai con số trần: GhepCong 18696 ns/op, GhepBuilder 1001 ns/op. Nhưng ta không biết chúng dao động bao nhiêu qua các lần chạy.
benchstat với -count=10 cho trung bình kèm độ lệch: GhepCong 19.81µ ± 1%, GhepBuilder 1.081µ ± 3%. Cả hai ±% nhỏ nên phép đo ổn định, đáng tin.
So bản cũ vs mới (cùng benchmark Ghep, đổi cài đặt bên trong):
               │   old.txt    │            new.txt            │
               │    sec/op    │  sec/op    vs base            │
Ghep-10          19.964µ ± 3%   1.030µ ± 2%  -94.84% (p=0.000 n=10)

               │     B/op      │
Ghep-10          170.039Ki ± 0%  5.242Ki ± 0%  -96.92% (p=0.000)
Bản mới nhanh hơn 94.84% và tốn ít bộ nhớ hơn 96.92%, với p=0.000 — nghĩa là khác biệt chắc chắn thật, không phải nhiễu. Đây là kết luận có căn cứ thống kê, không phải "tôi thấy nó nhanh hơn".
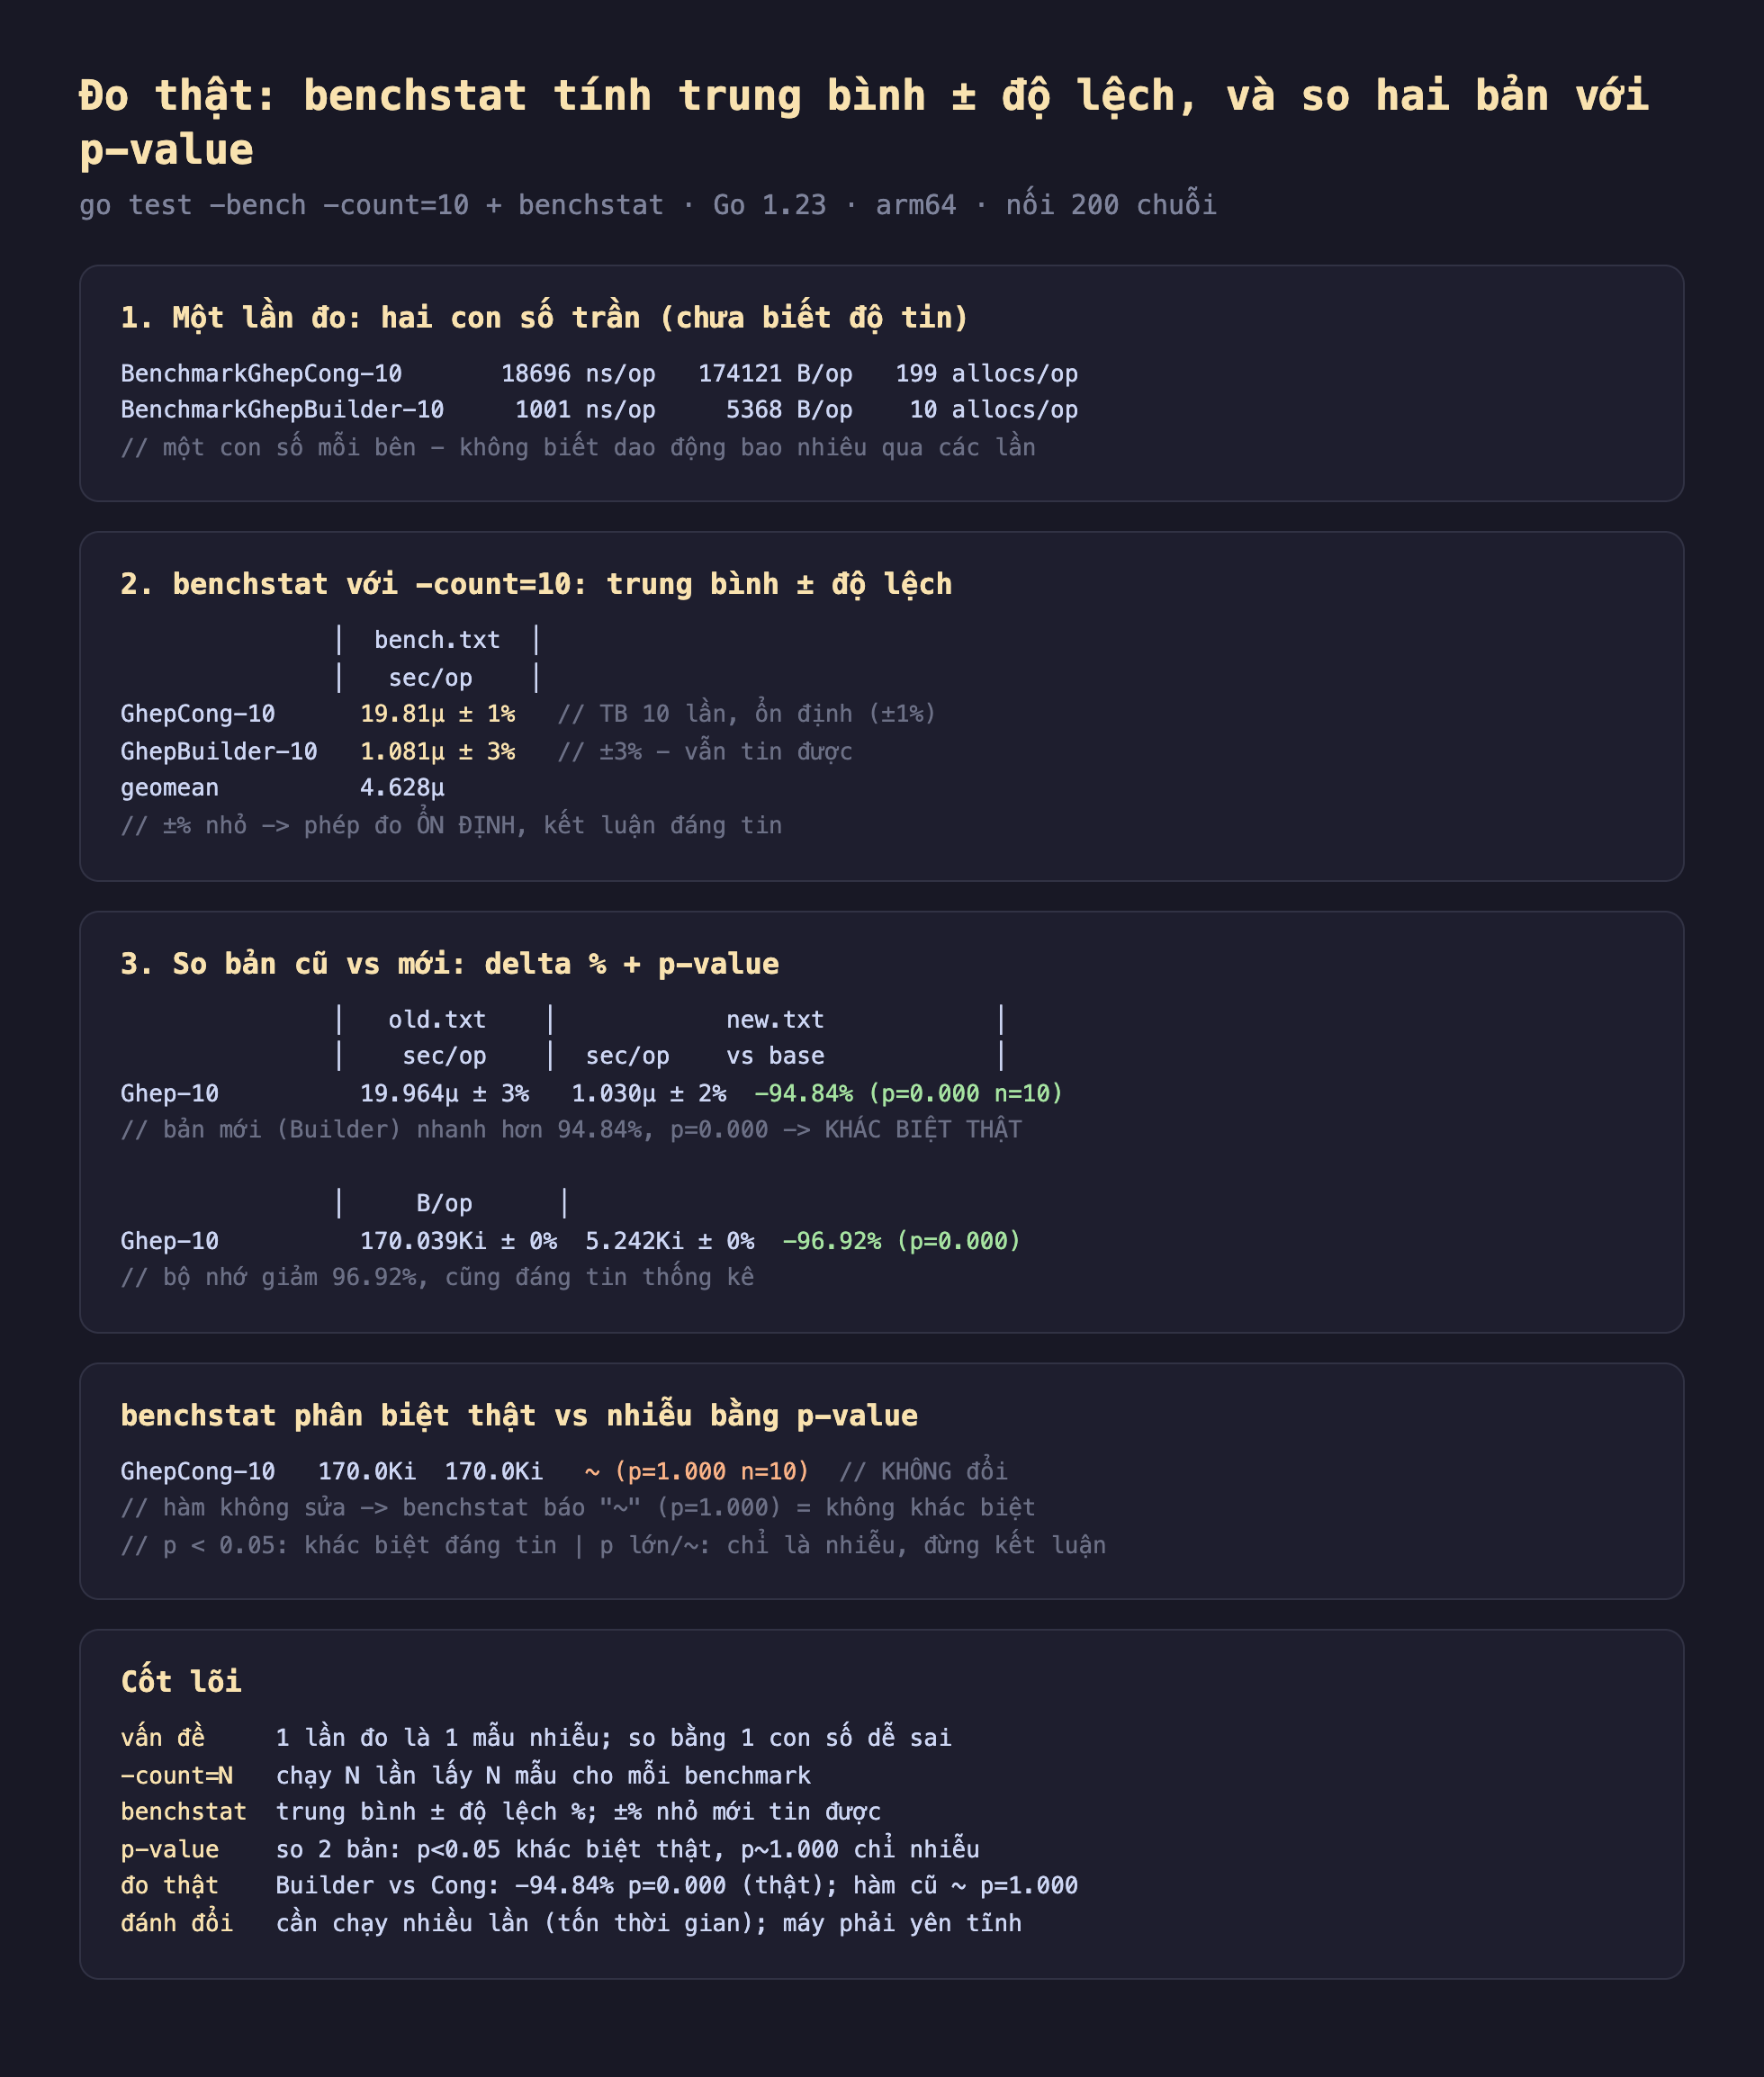
Hình 2: Đo thật — một lần đo cho con số trần; benchstat với -count=10 cho trung bình ± độ lệch (19.81µ ±1%); so bản cũ/mới cho -94.84% (p=0.000 n=10) (khác biệt thật) trong khi hàm không đổi báo ~ (p=1.000).
benchstat phân biệt thật vs nhiễu bằng p-value
Điểm tinh tế nhất: benchstat cho bạn biết khi nào không có khác biệt. Với hàm không sửa:
GhepCong-10 170.0Ki 170.0Ki ~ (p=1.000 n=10) // KHÔNG đổi
benchstat báo ~ (p=1.000) nghĩa là "không có khác biệt đáng tin" — đúng, vì hàm này không đổi. Quy tắc đọc: p < 0.05 → khác biệt đáng tin (thật); p lớn hoặc ~ → chỉ là nhiễu, đừng kết luận có cải thiện/thoái lui. Đây chính là cái mà so một-con-số không bao giờ cho bạn: sự phân biệt giữa tín hiệu và nhiễu.
Đánh đổi cần cân nhắc
Cần chạy nhiều lần — tốn thời gian. -count=10 mất gấp 10 lần một lần chạy; benchmark chậm hoặc bộ nhiều benchmark có thể mất phút đến hàng chục phút. Với vòng lặp phát triển nhanh, có thể dùng -count nhỏ hơn (5) để định hướng, và -count lớn (10-20) khi cần kết luận cuối cùng. Đừng bỏ hẳn -count chỉ vì vội — một con số vội vàng dễ dẫn tới kết luận sai còn tốn thời gian hơn.
Máy phải yên tĩnh để đo đáng tin. ±% cao thường không phải lỗi benchstat mà là máy nhiễu: trình duyệt, IDE, cập nhật nền, laptop chạy pin (throttle). Trước khi tin số, đóng ứng dụng nặng, cắm điện, và nếu nghiêm túc thì tắt turbo boost / cố định tần số CPU. benchstat trung thực báo ±% cao để bạn biết phép đo không đáng tin — đừng lờ nó đi rồi kết luận từ dữ liệu nhiễu.
p-value không phải phép màu, và khác biệt "đáng tin thống kê" chưa chắc "đáng quan tâm". Với đủ mẫu, benchstat có thể báo một khác biệt 0.5% là p<0.05 (thật về mặt thống kê) — nhưng 0.5% thường chẳng đáng để đánh đổi độ phức tạp code. Luôn nhìn cả delta % (độ lớn) lẫn p-value (độ tin): cải tiến phải vừa thật vừa đủ lớn để đáng làm.
Ba ý mang về
- Một lần đo benchmark là một mẫu nhiễu — máy dao động vì tải nền, GC, tần số CPU; so hai phiên bản bằng một con số mỗi bên dễ kết luận sai từ nhiễu, nên phải chạy
-count=Nlấy nhiều mẫu. - benchstat cho trung bình ± độ lệch và p-value: đo thật,
-count=10cho19.81µ ± 1%(ổn định), và so bản cũ/mới cho-94.84% (p=0.000)— cải tiến chắc chắn thật, trong khi hàm không đổi báo~ (p=1.000); đọc±%để biết đo có tin được không, đọc p-value để phân biệt thật vs nhiễu. - Nêu rõ đánh đổi: chạy nhiều lần tốn thời gian (cân
-counttheo giai đoạn), máy phải yên tĩnh để±%thấp (đừng tin dữ liệu nhiễu), và khác biệt đáng tin thống kê (p<0.05) chưa chắc đủ lớn để đáng làm — luôn nhìn cả độ lớn lẫn độ tin.
Bài tập làm thử
Bài 1 (đọc hiểu). Cho kết quả benchstat sau khi so hai phiên bản của cùng benchmark Ghep:
Ghep-10 19.964µ ± 3% 1.030µ ± 2% -94.84% (p=0.000 n=10)
Con số ± 3% và ± 2% nói lên điều gì về độ tin cậy của phép đo? Và vì sao p=0.000 cho phép kết luận "bản mới nhanh hơn thật" chứ không phải chỉ là nhiễu?
Đáp án
± 3% và ± 2% là độ dao động giữa các lần chạy (10 mẫu mỗi bên) — cả hai đều nhỏ nên phép đo ổn định, đáng tin (không cần nghi ngờ do máy nhiễu). p=0.000 (tức p < 0.05) là ngưỡng thống kê cho biết chênh lệch -94.84% gần như chắc chắn không phải do ngẫu nhiên/nhiễu — nếu p lớn hoặc benchstat báo ~ thì mới phải nghi là nhiễu, không được kết luận có cải thiện.
Bài 2 (sửa lỗi). Một đồng nghiệp đo hiệu năng bằng cách chạy benchmark đúng một lần cho mỗi phiên bản rồi so sánh trực tiếp hai con số ns/op. Quy trình này sai ở đâu, và cần sửa lại các bước chạy lệnh như thế nào để dùng được benchstat?
Đáp án
Sai vì một lần chạy chỉ là một mẫu duy nhất từ hệ thống có nhiễu (tải nền, GC, tần số CPU thay đổi...), nên hai con số khác nhau có thể chỉ do nhiễu chứ không phải do code thay đổi. Cần sửa: chạy go test -bench=. -benchmem -run=^$ -count=10 > old.txt với bản cũ, sửa code, chạy lại -count=10 > new.txt với bản mới, rồi benchstat old.txt new.txt để có trung bình ± độ lệch và p-value thay vì so một con số trần mỗi bên.
Bài 3 (vận dụng thực tế). Bạn đo một hàm và benchstat báo ± 20% cho cả hai phiên bản. Bạn có nên tin ngay kết luận "cải thiện 8%" mà benchstat đưa ra không? Nên làm gì trước khi tin số liệu?
Đáp án
Không nên tin ngay. ±20% là dấu hiệu phép đo đang nhiễu (máy có tải nền, trình duyệt/IDE chạy, laptop chạy pin bị throttle...), nên kết luận "cải thiện 8%" không đáng tin cậy dù p-value có thể vẫn nhỏ. Cần đóng ứng dụng nặng, cắm điện, cân nhắc tắt turbo boost/cố định tần số CPU, rồi chạy lại -count=10 (hoặc nhiều hơn) để ±% nhỏ lại trước khi rút kết luận.
Bài 4 (đọc hiểu / bẫy). Với hàm hoàn toàn không đổi giữa hai bản, benchstat báo:
GhepCong-10 170.0Ki 170.0Ki ~ (p=1.000 n=10)
Giải thích ký hiệu ~ và p=1.000. Nếu một khác biệt 0.5% có p=0.03 (< 0.05), điều đó có tự động nghĩa là đáng để đổi code không?
Đáp án
~ cùng p=1.000 nghĩa là benchstat không tìm thấy khác biệt đáng tin giữa hai bản — đúng như kỳ vọng vì hàm không đổi, đây là bằng chứng benchstat phân biệt được tín hiệu thật với nhiễu. Còn khác biệt 0.5% với p=0.03 tuy "đáng tin về mặt thống kê" (thật, không phải nhiễu) nhưng chưa chắc "đáng làm" — phải nhìn cả độ lớn delta (0.5% thường quá nhỏ để đánh đổi lấy độ phức tạp code tăng thêm) lẫn p-value, không chỉ dựa vào p-value một mình.
Bài 5 (vận dụng thực tế). Nhóm bạn đang trong giai đoạn phát triển nhanh, cần định hướng nhanh xem một thay đổi có khả năng cải thiện hiệu năng hay không, trước khi dành thời gian đo chính xác. Nên chọn -count bao nhiêu ở giai đoạn này, và khi nào nên tăng lên 10-20?
Đáp án
Ở giai đoạn định hướng nhanh có thể dùng -count nhỏ (ví dụ 5) để tiết kiệm thời gian trong vòng lặp phát triển. Khi cần đưa ra kết luận cuối cùng (ví dụ quyết định merge một tối ưu hoặc báo cáo hiệu năng chính thức), nên tăng -count lên 10-20 để có đủ mẫu, độ lệch nhỏ và p-value đáng tin — không nên bỏ hẳn -count (tức chạy 1 lần) chỉ vì vội, vì kết luận sai từ một mẫu có thể tốn thời gian sửa lại nhiều hơn.
Phần sau ta đào sâu chính những cạm bẫy khiến benchmark cho số sai: cạm bẫy microbenchmark trong Go — trình biên dịch loại bỏ code chết, hằng số hóa, và cách dùng đúng để số đo phản ánh thực tế.
